

Chtěl bych se s vámi podělit o svou první úspěšnou zkušenost s obnovením plné funkčnosti databáze Postgres. Se systémem Postgres jsem se seznámil před půl rokem, předtím jsem neměl žádné zkušenosti s administrací databází.
Pracuji jako polo-DevOps inženýr ve velké IT firmě. Naše společnost se zabývá vývojem softwaru pro vysoce zatížené služby, já odpovídám za funkčnost, údržbu a nasazení. Byla mi zadána standardní úloha: aktualizovat aplikaci na jednom serveru. Aplikace je napsána na Django, při aktualizaci se provádějí migrace (změna struktury databáze) a před tímto procesem děláme úplný dump databáze pomocí standardního programu pg_dump pro všechny případy.
Při provádění dumpu došlo k nečekané chybě (verze Postgres – 9.5):
pg_dump: Omlouvám se, obsah tabulky „ws_log_smevlog“ se nepodařilo načíst: PQgetResult() selhalo.
pg_dump: Chybová zpráva ze serveru: CHYBA: neplatná stránka v bloku 4123007 relace základny/16490/21396989
pg_dump: Příkaz byl: COPY public.ws_log_smevlog [...]
pg_dump: [paralelní archivace] pracovní proces selhal nečekaně
Chyba „neplatná stránka v bloku“ naznačuje problémy na úrovni souborového systému, což je velmi špatné. Na různých fórech bylo doporučeno udělat FULL VACUUM s volbou zero_damaged_pages k vyřešení tohoto problému. Tak co, zkusíme…
Příprava na obnovení
POZOR! Ověřte, že máte zálohu Postgres před jakýmikoli pokusy o obnovení databáze. Pokud máte virtuální stroj, zastavte databázi a udělejte snímek. Pokud nemáte možnost udělat snapshot, zastavte databázi a zkopírujte obsah adresáře Postgres (včetně wal-souborů) na bezpečné místo. Hlavní je, abychom neudělali ještě větší nepořádek. Přečtěte si .
Protože databáze obecně fungovala, omezil jsem se na běžný dump databáze, ale vyloučil jsem tabulku s poškozenými daty (volba -T, —exclude-table=TABLE v pg_dump).
Server byl fyzický, udělat snímek nebylo možné. Záloha byla udělána, pokračujeme dál.
Kontrola souborového systému
Před pokusem o obnovu databáze je nutné se ujistit, že je vše v pořádku se samotným souborovým systémem. A v případě chyb je opravit, protože jinak si můžeme jen uškodit.
V mém případě byl souborový systém s databází připojen k «/srv» a typ byl ext4.
Zastavujeme databázi: systemctl stop postgresql@9.5-main.service a kontrolujeme, že souborový systém není používán a může být odpojen pomocí příkazu lsof:
lsof +D /srv
Musel jsem také zastavit databázi redis, protože také používala «/srv». Poté jsem odpojil /srv (umount).
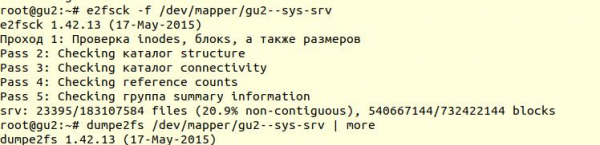
Kontrola souborového systému byla provedena pomocí nástroje e2fsck s přepínačem -f (Nucená kontrola i když je souborový systém označen jako čistý):
Poté pomocí nástroje dumpe2fs (sudo dumpe2fs /dev/mapper/gu2—sys-srv | grep checked) si můžete být jisti, že kontrola byla skutečně provedena:
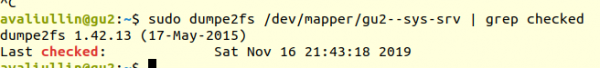
e2fsck říká, že nebyly nalezeny žádné problémy na úrovni souborového systému ext4, což znamená, že můžeme pokračovat pokusy o obnovení databáze, konkrétně se vrátit k vacuum full (samozřejmě, je nutné znovu připojit souborový systém a spustit databázi).
Pokud máte fyzický server, nezapomeňte zkontrolovat stav disků (přes smartctl -a /dev/XXX) nebo RAIDový řadič, abyste se ujistili, že problém není na hardwarové úrovni. V mém případě byl RAID ‚hardwarový‘, takže jsem požádal místního administrátora, aby zkontroloval stav RAID (server byl několik stovek kilometrů ode mě). Řekl, že nejsou žádné chyby, což znamená, že opravdu můžeme zahájit obnovu.
PokAttempt 1: zero_damaged_pages
Připojujeme se k databázi přes psql účtem s právy superuživatele. Potřebujeme opravdu superuživatele, protože volbu zero_damaged_pages může měnit pouze on. V mém případě je to postgres:
psql -h 127.0.0.1 -U postgres -s [database_name]
Volba zero_damaged_pages je potřebná k tomu, aby ignorovala chyby čtení (z webu postgrespro):
Při zjištění poškozené hlavičky stránky Postgres Pro obvykle hlásí chybu a přeruší aktuální transakci. Pokud je parametr zero_damaged_pages zapnutý, místo toho systém vydá varování, vymaže poškozenou stránku v paměti a pokračuje ve zpracování. Toto chování ničí data, konkrétně všechny řádky v poškozené stránce.
Zapneme volbu a zkusíme provést full vacuum tabulky:
VACUUM FULL VERBOSE 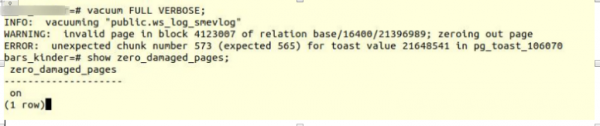
Bohužel, neúspěch.
Narazili jsme na podobnou chybu:
INFO: vacuuming "“public.ws_log_smevlog”
WARNING: neplatná stránka v bloku 4123007 vztahu base/16400/21396989; vymazání stránky
ERROR: neočekávané číslo bloku 573 (očekávané 565) pro toast hodnotu 21648541 v pg_toast_106070– mechanismus ukládání „dlouhých dat“ v PostgreSQL, pokud se nevejdou na jednu stránku (výchozí 8kB).
PokAttempt 2: reindex
První rada z Googlu nepomohla. Po několika minutách hledání jsem našel druhou radu – provést reindexaci poškozené tabulky. Tato rada se objevovala na mnoha místech, ale příliš mi nedůvěřovala. Pojďme provést reindexaci:
reindex table ws_log_smevlog 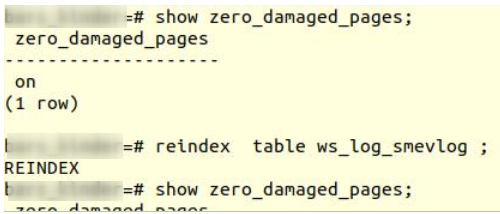
reindexaci ukončila se bez problémů.
Ale to nepomohlo, VACUUM FULL nůzovém ukončení s podobnou chybou. Protože jsem zvyklý na neúspěchy, začal jsem hledat další rady na internetu a narazil jsem na docela zajímavý .
PokAttempt 3: SELECT, LIMIT, OFFSET
V předchozím článku doporučovali podívat se na tabulku po řádcích a odstranit problematická data. Nejprve bylo nutné zkontrolovat všechny řádky:
for ((i=0; i/dev/null || echo $i; doneV mém případě tabulka obsahovala 1 628 991 řádků! Oprávněně bylo potřeba postarat se o , ale to je téma na jinou diskusi. Byla sobota, spustil jsem tento příkaz v tmux a šel spát:
for ((i=0; i/dev/null || echo $i; doneK ránu jsem se rozhodl zkontrolovat, jak to vypadá. K mému překvapení jsem zjistil, že za 20 hodin bylo proscanováno pouze 2 % dat! Nechtěl jsem čekat 50 dní. Další úplný neúspěch.
Ale nevzdal jsem se. Zajímalo mě, proč skenování trvalo tak dlouho. Z dokumentace (opět na postgrespro) jsem se dozvěděl:
OFFSET určuje, kolik řádků má být přeskočeno, než začne systém vracet řádky.
Pokud jsou uvedeny jak OFFSET, tak LIMIT, nejprve systém přeskočí řádky OFFSET a poté začne počítat řádky pro omezení LIMIT.Při používání LIMIT je důležité také použít příkaz ORDER BY, aby byly výsledné řádky vraceny v určitém pořadí. Jinak budou vraceny nepředvídatelné podmnožiny řádků.
Je zřejmé, že výše uvedený příkaz byl chybný: za prvé, chybělo order by, výsledek mohl být chybný. Za druhé, Postgres musel nejprve proskenovat a přeskočit řádky OFFSET, a s rostoucím OFFSET by výkon klesal stále více.
PokAttempt 4: udělat dump v textové podobě
Poté mě napadla, zdánlivě geniální myšlenka: udělat dump v textové podobě a analyzovat poslední zapsaný řádek.
Ale nejprve se podívejme na strukturu tabulky ws_log_smevlog:
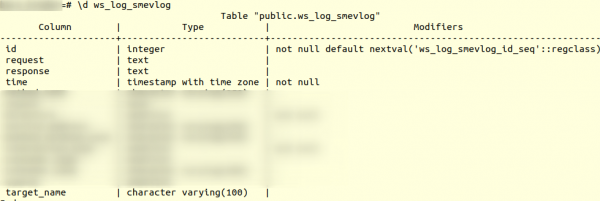
V našem případě máme sloupec „id“, který obsahoval jedinečný identifikátor (počet) řádku. Plán byl následující:
- Začínáme s vytvářením výpisu v textovém formátu (ve formě SQL příkazů)
- V určitém okamžiku vytvoření výpisu by se přerušilo kvůli chybě, ale textový soubor by se přesto uložil na disk
- Podíváme se na konec textového souboru, tím zjistíme identifikátor (id) posledního úspěšně vytvořeného řádku
Začal jsem vytvářet výpis v textovém formátu:
pg_dump -U my_user -d my_database -F p -t ws_log_smevlog -f ./my_dump.dumpVytvoření výpisu se, jak se očekávalo, přerušilo stejnou chybou:
pg_dump: Chybová zpráva ze serveru: ERROR: neplatná stránka v bloku 4123007 tabulky base/16490/21396989 Dále jsem přes tail zkontroloval konec výpisu (tail -5 ./my_dump.dump) zjistil, že výpis se přerušil na řádku s id 186 525. "To znamená, že problém je v řádku s id 186 526, je poškozený, ten je třeba odstranit!" – pomyslel jsem si. Ale po provedení dotazu na databázi:
«select * from ws_log_smevlog where id=186529se ukázalo, že s tímto řádkem je vše v pořádku… Řádky s indexy 186 530 – 186 540 také fungovaly bez problémů. Další "geniální nápad" selhal. Později jsem pochopil, proč se to stalo: při odstraňování nebo změně dat z tabulky se fyzicky neodstraňují, ale označují jako "mrtvé tuple", takže přijde autovacuum a označuje tyto řádky jako odstraněné a umožňuje jejich opětovné použití. Aby bylo jasné, když se data v tabulce mění a je povolen autovacuum, pak nejsou uložena sekvenčně.
Pokud 5: SELECT, FROM, WHERE id=
Neúspěchy nás zesilují. Nikdy se neseme vzdávat, je třeba jít až do konce a věřit v sebe a své možnosti. Proto jsem se rozhodl zkusit ještě jednu variantu: jednoduše projít všechny záznamy v databázi jedno po druhém. Vědoma struktury mé tabulky (viz výše), máme pole id, které je jedinečné (primární klíč). V tabulce máme 1 628 991 řádků a id jsou seřazeny podle pořadí, což znamená, že je můžeme jednoduše procházet jedno po druhém:
for ((i=1; i/dev/null || echo $i; donePokud někdo nechápe, příkaz funguje následujícím způsobem: prochází tabulku po řádcích a odesílá stdout do /dev/null, ale pokud příkaz SELECT selže, zobrazí se chybový text (stderr se odesílá do konzole) a zobrazí se řádek obsahující chybu (díky ||, což znamená, že při selectu byly problémy (návratový kód příkazu není 0)).
Měl jsem štěstí, měl jsem vytvořeny indexy podle pole id:
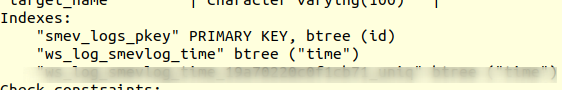
To znamená, že nalezení řetězce s požadovaným id by nemělo zabrat mnoho času. Teoreticky by to mělo fungovat. Tak jo, spouštíme příkaz v tmux a jdeme spát.
Ráno jsem zjistil, že bylo prozkoumáno zhruba 90 000 záznamů, což představuje něco málo přes 5 %. Skvělý výsledek, pokud to porovnáme s předchozím způsobem (2 %)! Ale 20 dní čekat se mi nechtělo…
Pok attempt 6: SELECT, FROM, WHERE id >= and id <
Pro zákazníka byl pro databázi vyhrazen skvělý server: dvouprocesorový Intel Xeon E5-2697 v2, v naší dispozici bylo celých 48 vláken! Zátěž na serveru byla průměrná, bez větších problémů jsme mohli vzít přibližně 20 vláken. Operační paměti bylo také více než dostatek: rovnou 384 gigabajtů!
Proto bylo potřeba rozdělit příkaz na paralelní zpracování:
for ((i=1; i/dev/null || echo $i; doneZde by bylo možné napsat krásný a elegantní skript, ale zvolil jsem nejrychlejší způsob paralelizace: ručně rozdělit rozsah 0-1628991 na intervaly po 100 000 záznamů a spustit zvlášť 16 příkazů ve formátu:
for ((i=N; i/dev/null || echo $i; doneAle to není všechno. Teoreticky také připojení k databázi zabírá nějaký čas a systémové zdroje. Připojovat 1 628 991 by nebylo příliš rozumné, souhlasíte? Proto při jednom připojení vytáhněme 1000 řádků místo jednoho. Nakonec se příkaz změnil na toto:
for ((i=N; i=$i and id/dev/null || echo $i; doneOtevíráme 16 oken v relaci tmux a spouštíme příkazy:
1) for ((i=0; i=$i and id/dev/null || echo $i; done
2) for ((i=100000; i=$i and id/dev/null || echo $i; done
…
15) for ((i=1400000; i=$i and id/dev/null || echo $i; done
16) for ((i=1500000; i=$i and id/dev/null || echo $i; done
Po dni jsem obdržel první výsledky! A to konkrétně (hodnoty XXX a ZZZ už se nezachovaly):
ERROR:  missing chunk number 0 for toast value 37837571 in pg_toast_106070
829000
ERROR:  missing chunk number 0 for toast value XXX in pg_toast_106070
829000
ERROR:  missing chunk number 0 for toast value ZZZ in pg_toast_106070
146000
To znamená, že máme tři řádky, které obsahují chybu. ID prvního a druhého problematického záznamu spadalo mezi 829 000 a 830 000, ID třetího – mezi 146 000 a 147 000. Nyní jsme museli jednoduše najít přesnou hodnotu ID problematických záznamů. K tomu procházejíme náš rozsah s problematickými záznamy krokem 1 a identifikujeme ID:
for ((i=829000; i/dev/null || echo $i; done
829417
ERROR: unexpected chunk number 2 (expected 0) for toast value 37837843 in pg_toast_106070
829449
for ((i=146000; i/dev/null || echo $i; done
829417
ERROR: unexpected chunk number ZZZ (expected 0) for toast value XXX in pg_toast_106070
146911
Šťastný konec
Našli jsme problematické řádky. Připojujeme se k databázi přes psql a zkoušíme je smazat:
my_database=# delete from ws_log_smevlog where id=829417;
DELETE 1
my_database=# delete from ws_log_smevlog where id=829449;
DELETE 1
my_database=# delete from ws_log_smevlog where id=146911;
DELETE 1
Moje překvapení, záznamy byly odstraněny bez jakýchkoliv problémů i bez volby zero_damaged_pages.
Pak jsem se připojil k databázi, udělal jsem VACUUM FULL (myslím, že to nebylo nutné), a nakonec jsem úspěšně udělal zálohu pomocí pg_dump. Záloha proběhla bez jakýchkoliv chyb! Problém se podařilo vyřešit takovýmto nejprostším způsobem. Radost byla nesmírná, po tolika neúspěších se podařilo najít řešení!
Poděkování a závěr
Toto byl můj první zážitek s obnovením reálné databáze Postgres. Tento zážitek si budu dlouho pamatovat.
A nakonec bych chtěl poděkovat společnosti PostgresPro za přeloženou dokumentaci do ruštiny a za , které velmi pomohly během analýzy problému.
Zdroj: habr.com
