

Před pár lety se Kubernetes na oficiálním blogu GitHub. Od té doby se stal standardní technologií pro nasazení služeb. Nyní Kubernetes spravuje značnou část vnitřních a veřejných služeb. Jak naše clustery rostly a nároky na výkon se staly přísnějšími, začali jsme si v některých službách na Kubernetes sporadicky všímat zpoždění, které nelze vysvětlit zatížením samotné aplikace.
Ve skutečnosti dochází v aplikacích ke zdánlivě náhodnému síťovému zpoždění až 100 ms a více, což vede k timeoutům nebo opakovaným pokusům. Očekávalo se, že služby budou schopny odpovídat na dotazy mnohem rychleji než 100 ms. Ale to není možné, pokud samotné spojení zabírá tolik času. Zároveň jsme pozorovali velmi rychlé dotazy na MySQL, které měly trvat milisekundy, a MySQL skutečně zvládala milisekundy, ale z pohledu aplikace, která požadovala odpověď, to trvalo 100 ms nebo více.
Okamžitě bylo jasné, že problém nastává pouze při připojení k uzlu Kubernetes, i když výzva přicházela zvenčí Kubernetes. Nejjednodušší způsob, jak problém reprodukovat, je test , který je spuštěn z libovolného interního hostitele, testuje službu Kubernetes na určitém portu a sporadicky zaznamenává velké zpoždění. V tomto článku se podíváme na to, jak se nám podařilo vystopovat příčinu tohoto problému.
Odstraňujeme zbytečnou složitost v řetězci k selhání
Reprodukováním stejného příkladu jsme chtěli zúžit zaměření problému a odstranit zbytečné vrstvy složitosti. Původně bylo v toku mezi Vegeta a podíky na Kubernetes příliš mnoho prvků. Abychom určili hlubší síťový problém, musíme některé z nich vyloučit.
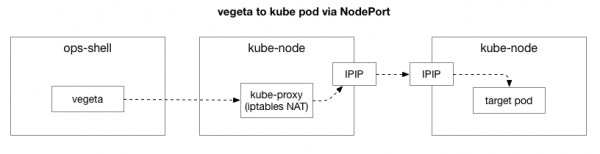
Klient (Vegeta) vytváří TCP spojení s libovolným uzlem v clusteru. Kubernetes funguje jako překryvná síť (nad existující sítí datového centra), která používá , tedy inkapsuluje IP pakety překryvné sítě uvnitř IP paketů datového centra. Při připojení k prvnímu uzlu dochází k překladu síťových adres. (NAT) s sledováním stavu pro převod IP adresy a portu uzlu Kubernetes na IP adresu a port v overlay síti (zejména podu s aplikací). Pro přijaté pakety se provádí opačná posloupnost akcí. Jedná se o složitý systém s mnoha stavy a prvky, které se neustále aktualizují a mění během nasazení a přesunu služeb.
Nástroj tcpdump v testu Vegeta ukazuje zpoždění během TCP handshake (mezi SYN a SYN-ACK). Aby se odstranila tato zbytečná složitost, lze použít hping3 pro jednoduché "pingy" pomocí SYN paketů. Ověřujeme, zda existuje zpoždění v odpovědním paketu, a poté ukončujeme spojení. Můžeme filtrovat data tak, že zahrneme pouze pakety s více než 100 ms, a získat jednodušší variantu pro reprodukci problému než kompletní test na úrovni 7 v Vegeta. Tady jsou "pingy" uzlu Kubernetes s použitím TCP SYN/SYN-ACK na "uzlovém portu" služby (30927) s intervalem 10 ms, vyfiltrované podle nejpomalejších odpovědí:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -S -p 30927 -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1485 win=29200 rtt=127.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1486 win=29200 rtt=117.0 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1487 win=29200 rtt=106.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=1488 win=29200 rtt=104.1 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5024 win=29200 rtt=109.2 ms
len=46 ip=172.16.47.27 ttl=59 DF id=0 sport=30927 flags=SA seq=5231 win=29200 rtt=109.2 ms
Ihned můžeme udělat první pozorování. Podle pořadových čísel a časování je vidět, že se nejedná o jednorázové zácpy. Zpoždění se často hromadí a nakonec se zpracovává.
Dále chceme zjistit, které komponenty mohou být zapojené do vzniku zácpy. Mohou to být některá z mnoha pravidel iptables v NAT? Nebo nějaké problémy s tunelováním IPIP v síti? Jeden ze způsobů, jak to prověřit, je prozkoumat každý krok systému a vyloučit ho. Co se stane, pokud odstraníme NAT a logiku firewalu, a ponecháme pouze část IPIP:
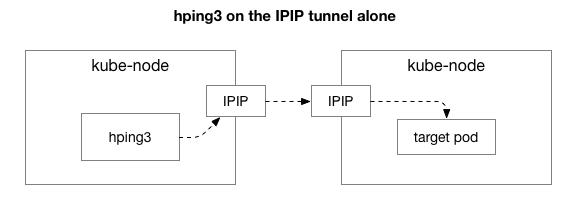
Naštěstí Linux umožňuje snadný přístup přímo k overlay vrstvě IP, pokud je stroj ve stejné síti:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7346 win=0 rtt=127.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7347 win=0 rtt=117.3 ms
len=40 ip=10.125.20.64 ttl=64 DF id=0 sport=0 flags=RA seq=7348 win=0 rtt=107.2 ms
Podle výsledků problém stále přetrvává! To vylučuje iptables a NAT. Znamená to, že problém je v TCP? Podíváme se, jak probíhá běžný ICMP ping:
theojulienne@kube-node-client ~ $ sudo hping3 10.125.20.64 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=28 ip=10.125.20.64 ttl=64 id=42594 icmp_seq=104 rtt=110.0 ms
len=28 ip=10.125.20.64 ttl=64 id=49448 icmp_seq=4022 rtt=141.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49449 icmp_seq=4023 rtt=131.3 ms
len=28 ip=10.125.20.64 ttl=64 id=49450 icmp_seq=4024 rtt=121.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49451 icmp_seq=4025 rtt=111.2 ms
len=28 ip=10.125.20.64 ttl=64 id=49452 icmp_seq=4026 rtt=101.1 ms
len=28 ip=10.125.20.64 ttl=64 id=50023 icmp_seq=4343 rtt=126.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50024 icmp_seq=4344 rtt=116.8 ms
len=28 ip=10.125.20.64 ttl=64 id=50025 icmp_seq=4345 rtt=106.8 ms
len=28 ip=10.125.20.64 ttl=64 id=59727 icmp_seq=9836 rtt=106.1 ms
Výsledky ukazují, že problém nezmizel. Možná je to tunel IPIP? Pojďme ještě zjednodušit test:
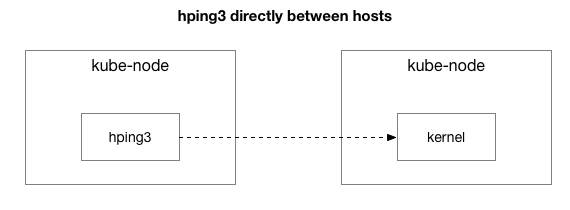
Všechny pakety jsou odesílány mezi těmito dvěma hostiteli?
theojulienne@kube-node-client ~ $ sudo hping3 172.16.47.27 --icmp -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 id=41127 icmp_seq=12564 rtt=140.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41128 icmp_seq=12565 rtt=130.9 ms
len=46 ip=172.16.47.27 ttl=61 id=41129 icmp_seq=12566 rtt=120.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41130 icmp_seq=12567 rtt=110.8 ms
len=46 ip=172.16.47.27 ttl=61 id=41131 icmp_seq=12568 rtt=100.7 ms
len=46 ip=172.16.47.27 ttl=61 id=9062 icmp_seq=31443 rtt=134.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9063 icmp_seq=31444 rtt=124.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9064 icmp_seq=31445 rtt=114.2 ms
len=46 ip=172.16.47.27 ttl=61 id=9065 icmp_seq=31446 rtt=104.2 ms
Zjednodušili jsme situaci na dva uzly Kubernetes, které si posílají jakýkoli paket, dokonce i ICMP ping. I tak vidí zpoždění, pokud je cílový host 'špatný' (některé hůře než jiné).
Teď poslední otázka: proč se zpoždění objevuje pouze na serverech kube-node? A nastává, když je kube-node odesílatelem nebo příjemcem? Naštěstí to lze také snadno zjistit odesláním paketu z hostitele mimo Kubernetes, ale se stejným 'známým špatným' příjemcem. Jak vidíme, problém nezmizel:
theojulienne@shell ~ $ sudo hping3 172.16.47.27 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=312 win=0 rtt=108.5 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=5903 win=0 rtt=119.4 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=6227 win=0 rtt=139.9 ms
len=46 ip=172.16.47.27 ttl=61 DF id=0 sport=9876 flags=RA seq=7929 win=0 rtt=131.2 ms
Poté provedeme stejné dotazy z předchozího výchozího kube-node k externímu hostiteli (což vylučuje výchozí host, protože ping zahrnuje jako prvek RX, tak TX):
theojulienne@kube-node-client ~ $ sudo hping3 172.16.33.44 -p 9876 -S -i u10000 | egrep --line-buffered 'rtt=[0-9]{3}.'
 ^C
 --- 172.16.33.44 hping statistika ---
 22352 pakety odeslány, 22350 pakety přijaty, 1% ztráta paketů
 round-trip min/avg/max = 0.2/7.6/1010.6 ms
Zkoumáním zachycení paketů se zpožděním jsme získali další informace. Konkrétně to, že odesílatel (níže) vidí tento timeout, zatímco příjemce (nahoře) ho nevidí — viz sloupec Delta (v sekundách):
Navíc, pokud se podíváme na rozdíl v pořadí TCP a ICMP paketů (podle čísel pořadí) na straně příjemce, pak ICMP pakety vždy přicházejí ve stejném pořadí, v jakém byly odeslány, ale s různým časováním. Zatímco TCP pakety se někdy mísí, a některé z nich se zaseknou. Konkrétně, pokud prozkoumáme porty SYN paketů, na straně odesílatele jdou v pořadí, ale na straně příjemce tomu tak není.
Existuje jemný rozdíl v tom, jak moderních serverů (jako v našem datovém centru) zpracovávají pakety obsahující TCP nebo ICMP. Když paket dorazí, síťový adaptér ho 'hashuje podle spojení', tedy se snaží rozdělit spojení do front a odeslat každou frontu na pomocné procesorové jádro. Pro TCP tento hash zahrnuje jak zdrojovou, tak cílovou IP adresu a port. Jinými slovy, každé spojení je (potenciálně) hashováno různě. Pro ICMP se hashují pouze IP adresy, protože porty nejsou.
Další nová pozorování: během tohoto období vidíme zpoždění ICMP ve všech komunikacích mezi dvěma hostiteli, zatímco TCP žádná. To nám říká, že příčina je pravděpodobně spojena s hashováním RX front: téměř jistě se zácpa vyskytuje v zpracování RX paketů, nikoli v odesílání odpovědí.
To eliminuje zasílání paketů jako možnou příčinu. Nyní víme, že problém se zpracováním paketů je na straně příjmu na některých servers kube-node.
Analyzujeme zpracování paketů v jádru Linux
Abychom pochopili, proč se problém vyskytuje u příjemce na některých servers kube-node, podívejme se, jak jádro Linux zpracovává pakety.
Vracíme se k nejjednodušší tradiční implementaci, síťová karta přijme paket a odešle jádru Linux, což je signál, že existuje paket, který je třeba zpracovat. Jádro zastaví další práci, přepne kontext na obsluhu přerušení, zpracovává paket a poté se vrátí k aktuálním úlohám.
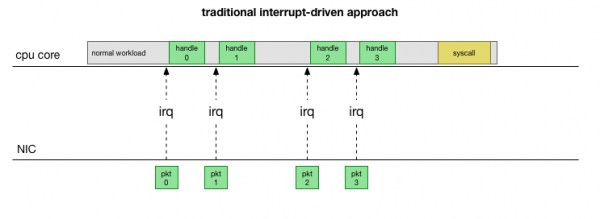
Toto přepínání kontextu probíhá pomalu: možná, že zpoždění bylo v 90. letech nezřetelné na 10megabitových síťových kartách, ale na moderních 10G kartách s maximální propustností 15 milionů paketů za sekundu může každé jádro malého osmijádrového serveru přerušovat milionkrát za sekundu.
Aby se vyhnulo neustálému zpracovávání přerušení, bylo do Linuxu přidáno před mnoha lety : síťové API, které využívají všechny moderní ovladače pro zlepšení výkonu při vysokých rychlostech. Při nízkých rychlostech jádro stále přijímá přerušení ze síťové karty starým způsobem. Jakmile dorazí dostatečný počet paketů, který překročí určitou mez, jádro přeruší přerušení a místo toho začne dotazovat síťový adaptér a přebírat pakety po dávkách. Zpracování probíhá v softirq, tedy v po systémových voláních a hardwarových přerušeních, když je jádro (na rozdíl od uživatelského prostoru) již spuštěno.
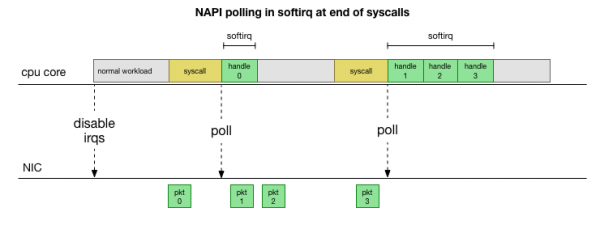
To je mnohem rychlejší, ale vyvolává jiný problém. Pokud je paketů příliš mnoho, veškerý čas jde na zpracování paketů ze síťové karty, a procesy uživatelského prostoru nemají čas tyto fronty skutečně vyčistit (čtení z TCP spojení atd.). Nakonec se fronty zaplní a začneme odesílat pakety zpět. Snažící se najít rovnováhu, jádro stanoví rozpočet pro maximální počet paketů zpracovaných v kontextu softirq. Jakmile je tento rozpočet překročen, probudí se samostatný proces ksoftirqd (jeden z nich uvidíte v ps pro každé jádro), který zpracovává tyto softirq mimo běžnou cestu syscall/přerušení. Tento proces je plánován pomocí standardního plánovače procesů, který se snaží spravedlivě rozdělovat zdroje.
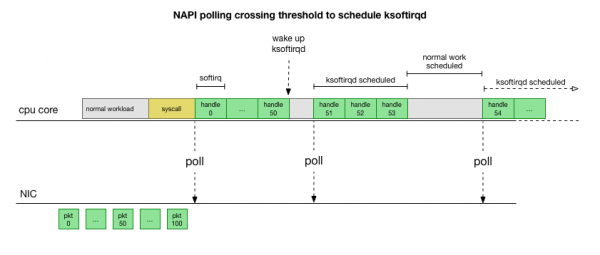
Při zkoumání, jak jádro zpracovává pakety, je možné si všimnout, že zde existuje určitá pravděpodobnost vzniku zácpy. Pokud jsou volání softirq méně častá, pak budou pakety muset nějakou dobu čekat na zpracování v frontě RX na síťové kartě. Možná k tomu dochází kvůli nějakému úkolu, který blokuje jádro procesoru, nebo něco jiného brání jádru spouštět softirq.
Úzký záběr zpracování na jádro nebo metodu
Zpoždění softirq jsou zatím pouze hypotézou. Ale dává to smysl, a víme, že máme něco velmi podobného. Proto je dalším krokem potvrdit tuto teorii. A pokud se potvrdí, nalézt příčinu zpoždění.
Vraťme se k našim pomalým paketům:
len=46 ip=172.16.53.32 ttl=61 id=29573 icmp_seq=1953 rtt=99.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29574 icmp_seq=1954 rtt=89.3 ms
len=46 ip=172.16.53.32 ttl=61 id=29575 icmp_seq=1955 rtt=79.2 ms
len=46 ip=172.16.53.32 ttl=61 id=29576 icmp_seq=1956 rtt=69.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29577 icmp_seq=1957 rtt=59.1 ms
len=46 ip=172.16.53.32 ttl=61 id=29790 icmp_seq=2070 rtt=75.7 ms
len=46 ip=172.16.53.32 ttl=61 id=29791 icmp_seq=2071 rtt=65.6 ms
len=46 ip=172.16.53.32 ttl=61 id=29792 icmp_seq=2072 rtt=55.5 ms
Jak bylo již zmíněno, tyto pakety ICMP jsou hashovány do jedné fronty NIC RX a zpracovávány jedním CPU jádrem. Pokud chceme pochopit fungování Linuxu, je užitečné vědět, kde (na kterém CPU jádru) a jak (softirq, ksoftirqd) jsou tyto pakety zpracovány, abychom mohli sledovat proces.
Nyní je čas použít nástroje, které umožňují sledovat činnost jádra Linuxu v reálném čase. Zde jsme použili . Tato sada nástrojů umožňuje psát malé programy v C, které přichytí libovolné funkce v jádře a bufferují události do programu Python v uživatelském prostoru, který je může zpracovat a vrátit vám výsledek. Hooky pro libovolné funkce v jádře jsou složitou záležitostí, ale nástroj je navržen pro maximální bezpečnost a určen pro sledování právě takových problémů v provozu, které se obtížně reprodukují v testovacím nebo vývojovém prostředí.
Plán je jednoduchý: víme, že jádro zpracovává tyto ICMP pings, proto nasadíme hook na funkci jádra , která přijímá příchozí ICMP paket „echo request“ a iniciuje odeslání ICMP odpovědi „echo response“. Můžeme identifikovat pakety podle zvyšujícího se čísla icmp_seq, které ukazuje hping3 výše.
Kód vypadá složitě, ale není tak děsivý, jak se zdá. Funkce icmp_echo předává struct sk_buff *skb: to je paket s požadavkem „echo request“. Můžeme ho sledovat, vytáhnout sekvenci echo.sequence která odpovídá icmp_seq z hping3 přístupu.), a poslat ji do uživatelského prostoru. Také je užitečné zachytit aktuální název procesu/identifikátor. Níže jsou uvedeny výsledky, které vidíme přímo při zpracování paketů jádrem:
TGID    PID     NÁZEV PROCESU    ICMP_SEQ
0       0       swapper/11      770
0       0       swapper/11      771
0       0       swapper/11      772
0       0       swapper/11      773
0       0       swapper/11      774
20041   20086   prometheus      775
0       0       swapper/11      776
0       0       swapper/11      777
0       0       swapper/11      778
4512    4542   spokes-report-s  779
Je nutné si uvědomit, že v kontextu softirq procesy, které provedly systémové volání, se zobrazí jako „procesy“, i když ve skutečnosti jádro bezpečně zpracovává pakety v kontextu jádra.
S tímto nástrojem můžeme navázat spojení konkrétních procesů s konkrétními pakety, které vykazují zpoždění v hping3. Děláme jednoduchý grep na tomto záznamu pro určité hodnoty icmp_seq. Pakety odpovídající výše zmíněným hodnotám icmp_seq byly označeny spolu s jejich RTT, které jsme sledovali výše (v závorce jsou uvedeny očekávané hodnoty RTT pakety, které jsme filtrali kvůli hodnotám RTT menším než 50 ms):
TGID    PID     NÁZEV PROCESU    ICMP_SEQ ** RTT
--
10137   10436   cadvisor        1951
10137   10436   cadvisor        1952
76      76      ksoftirqd/11    1953 ** 99ms
76      76      ksoftirqd/11    1954 ** 89ms
76      76      ksoftirqd/11    1955 ** 79ms
76      76      ksoftirqd/11    1956 ** 69ms
76      76      ksoftirqd/11    1957 ** 59ms
76      76      ksoftirqd/11    1958 ** (49ms)
76      76      ksoftirqd/11    1959 ** (39ms)
76      76      ksoftirqd/11    1960 ** (29ms)
76      76      ksoftirqd/11    1961 ** (19ms)
76      76      ksoftirqd/11    1962 ** (9ms)
--
10137   10436   cadvisor        2068
10137   10436   cadvisor        2069
76      76      ksoftirqd/11    2070 ** 75ms
76      76      ksoftirqd/11    2071 ** 65ms
76      76      ksoftirqd/11    2072 ** 55ms
76      76      ksoftirqd/11    2073 ** (45ms)
76      76      ksoftirqd/11    2074 ** (35ms)
76      76      ksoftirqd/11    2075 ** (25ms)
76      76      ksoftirqd/11    2076 ** (15ms)
76      76      ksoftirqd/11    2077 ** (5ms)
Výsledky nám říkají několik věcí. Za prvé, všechny tyto pakety zpracovává kontext ksoftirqd/11. To znamená, že pro tuto konkrétní dvojici strojů se ICMP pakety hashovaly na jádro 11 na přijímající straně. Také vidíme, že při každém přetížení se objevují pakety, které jsou zpracovány v kontextu systémového volání cadvisor. Pak ksoftirqd se ujme úkolu a zpracovává nahromaděný frontu: přesně tolik paketů, kolik se nahromadilo po cadvisor.
Skutečnost, že přímo před tím vždy pracuje cadvisor, naznačuje jeho zapojení do problému. Ironií je, že účel je „analyzovat využití zdrojů a výkonnostní charakteristiky spuštěných kontejnerů“, nikoli vyvolávat tento problém s výkonností.
Tak jako u ostatních aspektů práce s kontejnery, i zde se jedná o vysoce pokročilé nástroje, od nichž lze při některých nepředvídatelných okolnostech očekávat problémy s výkonem.
Co přesně dělá cadvisor, že zpomaluje frontu paketů?
Nyní máme poměrně dobré pochopení toho, jak k selhání dochází, jaký proces jej vyvolává a na kterém CPU. Vidíme, že kvůli přísné blokaci jádro Linuxu nestíhá včas naplánovat ksoftirqd. A vidíme, že pakety jsou zpracovávány v kontextu cadvisor. Logicky lze předpokládat, že cadvisor spouští pomalý syscall, po kterém jsou zpracovány všechny pakety, které se za tu dobu nahromadily:
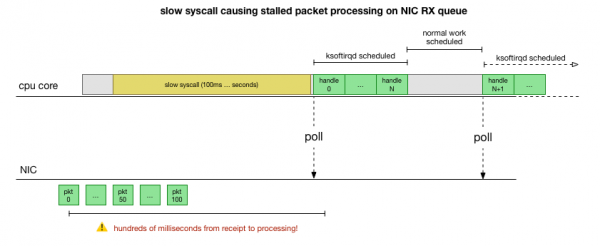
To je teorie, ale jak ji ověřit? Co můžeme udělat, je sledovat práci jádra CPU po celou dobu tohoto procesu, najít bod, kdy dojde k překročení rozpočtu na počet paketů a kdy je vyvolán ksoftirqd, a pak se podívat chvíli předtím – co přesně pracovalo na jádru CPU těsně před tímto okamžikem. Je to jako rentgen CPU každé několik milisekund. Bude vypadat přibližně takto:
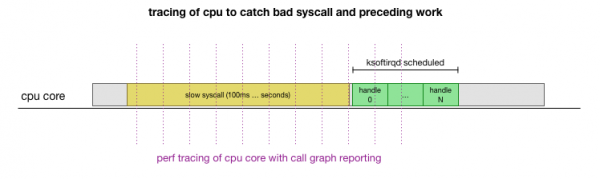
Naštěstí to vše lze udělat stávajícími nástroji. Například, v určených intervalech kontroluje zadané jádro CPU a může generovat graf volání běžícího systému, včetně jak uživatelského prostoru, tak jádra Linuxu. Můžeme tuto nahrávku vzít a zpracovat ji pomocí malého fork programu od Brendana Gregga, který uchovává pořadí sledování zásobníku. Můžeme uchovávat jednorázové sledování zásobníku každou 1 ms a poté vybrat a uložit vzorek za 100 milisekund předtím, než do sledování vstoupí ksoftirqd:
# record 999 times a second, or every 1ms with some offset so not to align exactly with timers
 sudo perf record -C 11 -g -F 999
 # take that recording and make a simpler stack trace.
 sudo perf script 2>/dev/null | ./FlameGraph/stackcollapse-perf-ordered.pl | grep ksoftir -B 100
Zde jsou výsledky:
(desítky stop, které vypadají podobně)
cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_iter cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages cadvisor;[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];[cadvisor];entry_SYSCALL_64_after_swapgs;do_syscall_64;sys_read;vfs_read;seq_read;memcg_stat_show;mem_cgroup_nr_lru_pages;mem_cgroup_node_nr_lru_pages ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;ixgbe_poll;ixgbe_clean_rx_irq;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;bond_handle_frame;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;ipip_tunnel_xmit;ip_tunnel_xmit;iptunnel_xmit;ip_local_out;dst_output;__ip_local_out;nf_hook_slow;nf_iterate;nf_conntrack_in;generic_packet;ipt_do_table;set_match_v4;ip_set_test;hash_net4_kadt;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;hash_net4_test ksoftirqd/11;ret_from_fork;kthread;kthread;smpboot_thread_fn;smpboot_thread_fn;run_ksoftirqd;__do_softirq;net_rx_action;gro_cell_poll;napi_gro_receive;netif_receive_skb_internal;inet_gro_receive;__netif_receive_skb_core;ip_rcv_finish;ip_rcv;ip_forward_finish;ip_forward;ip_finish_output;nf_iterate;ip_output;ip_finish_output2;__dev_queue_xmit;dev_hard_start_xmit;dev_queue_xmit_nit;packet_rcv;tpacket_rcv;sch_direct_xmit;validate_xmit_skb_list;validate_xmit_skb;netif_skb_features;ixgbe_xmit_frame_ring;swiotlb_dma_mapping_error;__dev_queue_xmit;dev_hard_start_xmit;__bpf_prog_run;__bpf_prog_run
Tady je spousta informací, ale hlavní je, že nacházíme vzor „cadvisor před ksoftirqd“, který jsme dříve viděli v ICMP trasování. Co to znamená?
Každý řádek je trasování CPU v určitém okamžiku. Každý pokles v zásobníku ve řádku je oddělen středníkem. Uprostřed řádků vidíme volaný syscall: read(): .... ;do_syscall_64;sys_read; .... Takže cadvisor tráví hodně času na systémovém volání read(), které se týká funkcí mem_cgroup_* (horní část zásobníku volání/konec řádku).
V trasování volání je obtížné vidět, co přesně se čte, takže spustíme strace a podíváme se, co dělá cadvisor, a najdeme systémová volání trvající déle než 100 ms:
theojulienne@kube-node-bad ~ $ sudo strace -p 10137 -T -ff 2>&1 | egrep '<0.[1-9]'
 [pid 10436]  ) = 0
 [pid 10432]  ) = 0
 [pid 10137]  ) = 0
 [pid 10384]  ) = 0
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 658
 [pid 10384]  ) = 0
 [pid 10436]  ) = 0
 [pid 10436]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10427]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 577
 [pid 10411]  ) = 0
 [pid 10382]  ) = 0 (Timeout)
 [pid 10436]  "cache 154234880nrss 507904nrss_h"..., 4096) = 660
 [pid 10417]  ) = 0
 [pid 10436]  ) = 0
 [pid 10417]  ) = 0
 [pid 10417]  "cache 0nrss 0nrss_huge 0nmapped_"..., 4096) = 576
Jak se dalo očekávat, zde vidíme pomalé volání read(). Z obsahu operací čtení a kontextu mem_cgroup je vidět, že tyto volání read() se vztahují k souboru memory.stat, který ukazuje využití paměti a omezení cgroup (technologie izolace zdrojů v Dockeru). Nástroj cadvisor dotazuje tento soubor, aby získal informace o využití zdrojů pro kontejnery. Pojďme zjistit, zda jádro nebo cadvisor dělá něco neobyčejného:
theojulienne@kube-node-bad ~ $ time cat /sys/fs/cgroup/memory/memory.stat >/dev/null
real 0m0.153s
user 0m0.000s
sys 0m0.152s
theojulienne@kube-node-bad ~ $
Nyní můžeme reprodukovat chybu a chápat, že jádro Linuxu se potýká s patologií.
Co způsobuje, že operace čtení je tak pomalá?
V tomto bodě je mnohem snazší najít zprávy od ostatních uživatelů o podobných problémech. Jak se ukázalo, v trackeru cadvisor byla o této chybě zmínka jako o , prostě si nikdo nevšiml, že zpoždění se také náhodně odráží v síťovém zásobníku. Opravu bylo skutečně pozorováno, že cadvisor spotřebovává více procesorového času, než se očekávalo, ale nedalo se tomu velké významy, protože naše servery mají spoustu procesorových zdrojů, takže se problém podrobněji nezkoumal.
Problém spočívá v tom, že kontrolní skupiny (cgroups) zahrnují využití paměti uvnitř jmenného prostoru (kontejneru). Když všechny procesy v této cgroup skončí, Docker uvolní kontrolní skupinu paměti. Nicméně 'paměť' není jen paměť procesu. Ačkoli paměť procesů už není používána, ukazuje se, že jádro přiděluje také kešovaný obsah, jako jsou dentries a inodes (metadata adresářů a souborů), které jsou kešovány v memory cgroup. Z popisu problému:
cgroups-zombí: kontrolní skupiny, ve kterých nejsou žádné procesy a byly odstraněny, ale pro které je stále přidělena paměť (v mém případě z cache dentry, ale také může být přidělena z cache stránek nebo tmpfs).
Kontrola jádrem všech stránek v keši při uvolňování cgroup může být velmi pomalá, proto byl vybrán lenivý proces: čekat, dokud nebudou tyto stránky znovu požadovány, a až tehdy, když paměť skutečně potřebujeme, konečně vyčistit cgroup. Do té doby je cgroup stále započítávána při shromažďování statistik.
Z hlediska výkonu obětovali paměť pro rychlost: zrychlení počátečního čištění díky tomu, že zbývá kousek vyrovnávací paměti. To je v pořádku. Když jádro používá poslední kousek vyrovnávací paměti, cgroup se nakonec vyčistí, takže to nelze nazvat "únikem". Bohužel, konkrétní implementace mechanismu vyhledávání memory.stat v této verzi jádra (4.9), spolu s obrovským množstvím paměti na našich serverech, vede k tomu, že obnova posledních vyrovnaných dat a vyčištění cgroup zombie trvá mnohem déle.
Ukázalo se, že na některých našich uzlech bylo tolik cgroup zombie, že čtení a zpoždění překročily sekundu.
Jednoduchým obcházením problému cadvisor je okamžitě uvolnit cache dentries/inodes po celém systému, což ihned eliminuje zpoždění čtení a také síťové zpoždění na hostiteli, protože odstranění cache zahrnuje vyrovnací paměť cgroup zombie, která se také uvolňuje. To není řešení, ale potvrzuje příčinu problému.
Ukázalo se, že ve novějších verzích jádra (4.19+) se zlepšil výkon systémových volání memory.stat, takže přechod na toto jádro problém vyřešil. Současně jsme měli nástroje pro identifikaci problémových uzlů v clusterech Kubernetes, jejich elegantní vypouštění a restartování. Prošli jsme všechny clustery, našli uzly s dostatečně vysokým zpožděním a restartovali je. To nám dalo čas na aktualizaci OS na ostatních serverech.
Shrnutí
Jelikož tento bug zastavoval zpracování front NIC RX na stovky milisekund, současně způsoboval jak velké zpoždění na krátkých spojeních, tak zpoždění ve středních spojeních, například mezi dotazy MySQL a odpovědními pakety.
Pochopení a podpora výkonu nejzákladnějších systémů, jako je Kubernetes, je klíčové pro spolehlivost a rychlost všech služeb na jejich základě. Všechny spuštěné systémy těží z vylepšení výkonu Kubernetes.
Zdroj: habr.com
