

Průmyslový vývoj softwarových systémů vyžaduje velkou pozornost k odolnosti konečného produktu, stejně jako rychlou reakci na selhání a poruchy, pokud k nim přece jen dojde. Monitorování samozřejmě pomáhá reagovat na poruchy a selhání efektivněji a rychleji, ale nestačí to. Za prvé, velmi obtížné je sledovat velký počet serverů – je potřeba značné množství lidí. Za druhé, je důležité dobře porozumět tomu, jak je aplikace konstruována, abychom mohli předpovědět její stav. To znamená, že potřebujeme mnoho lidí, kteří dobře rozumějí systémům, které vyvíjíme, jejich ukazatelům a vlastnostem. Předpokládejme, že i kdyby se našlo dostatečné množství lidí, ochotných se tímto zabývat, vyžaduje také spoustu času jejich školení.
A co teď? Na pomoc nám spěchá umělá inteligence. Tato článek se bude zabývat (predictive maintenance). Tento přístup aktivně získává na popularitě. Bylo napsáno velké množství článků, včetně těch na Habr. Velké firmy ho intenzivně využívají k podpoře funkčnosti svých serverů. Po prostudování velkého množství článků jsme se rozhodli tento přístup vyzkoušet. Co z toho vzešlo?
Úvod
Vyvinutý softwarový systém se dříve nebo později dostává do provozu. Pro uživatele je důležité, aby systém fungoval bez výpadků. Pokud k mimořádné situaci přece jen dojde, měla by být odstraněna s minimálními zpožděními.
Pro zjednodušení technické podpory softwarového systému, zejména pokud je serverů mnoho, se obvykle používají monitorovací programy, které sbírají metriky z běžícího softwarového systému, umožňují diagnostikovat jeho stav a pomáhají určit, co konkrétně způsobilo selhání. Tento proces se nazývá monitorování softwarového systému.
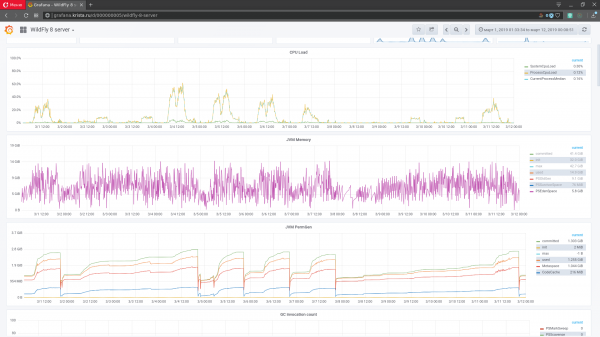
Obrázek 1. Rozhraní pro monitorování grafana
Metriky jsou různé ukazatele programového systému, prostředí jeho spuštění nebo fyzického výpočetního stroje, pod kterým je systém spuštěn s časovým razítkem, které udává okamžik, kdy byly metriky získány. V statické analýze jsou data metrik nazývána časovými řady. Pro sledování stavu programového systému se metriky zobrazují ve formě grafů: na ose X je čas a na ose Y jsou hodnoty (obrázek 1). Z funkčního programového systému lze zaznamenávat několik tisíc metrik (z každého uzlu). Ty tvoří prostor metrik (vícerozměrné časové řady).
Vzhledem k tomu, že u složitých programových systémů je zaznamenáváno velké množství metrik, ruční monitorování se stává složitým úkolem. Pro zmenšení objemu dat analyzovaných správcem obsahují monitorovací nástroje nástroje pro automatické zjištění možných problémů. Například lze nastavit spouštěč, který se aktivuje v případě poklesu volného místa na disku pod určitou úroveň. Také je možné automaticky diagnostikovat zastavení serveru nebo kritické zpomalení obsluhy. V praxi monitorovací nástroje dobře zvládají detekci již vzniklých poruch nebo odhalení jednoduchých příznaků budoucích poruch, ale celkově zůstává predikce možného selhání pro ně tvrdým oříškem. Predikce prostřednictvím ruční analýzy metrik vyžaduje zapojení kvalifikovaných specialistů. Je neefektivní. Většina potenciálních poruch může zůstat nepovšimnuta.
V poslední době mezi velkými IT společnostmi zabývajícími se vývojem softwaru roste oblíbenost takzvaného prediktivního údržby programových systémů. Podstata tohoto přístupu spočívá v hledání závad, které vedou k degradaci systému v raných fázích, před jeho selháním, s využitím umělé inteligence. Tento přístup zcela nevylučuje ruční monitorování systému. Slouží jako doplněk k procesu monitorování jako celku.
Hlavním nástrojem realizace prediktivní údržby je úloha hledání anomálií v časových řadách, protože při vzniku anomálie v datech je velká pravděpodobnost, že po nějaké době dojde k chybě nebo selhání. Anomálie je určité odchýlení od ukazatelů softwarového systému, jako je identifikace degradace rychlosti vykonávání dotazu určitého typu nebo pokles průměrného počtu obsluhovaných požadavků při konstantní úrovni zákaznických relací.
Úkol hledání anomálií v softwarových systémech má svou speciální povahu. V podstatě je potřeba vyvinout nebo upravit existující metody pro každý softwarový systém, protože hledání anomálií velmi závisí na datech, ve kterých je prováděno, a data softwarových systémů se velmi liší v závislosti na nástrojích implementace systému až po to, na jakém výpočetním stroji je spuštěn.
Metody hledání anomálií při předpovídání selhání softwarových systémů
Především je třeba říci, že myšlenka předpovídání selhání byla inspirována článkem . Pro ověření účinnosti přístupu s automatickým hledáním anomálií byl vybrán softwarový systém „Web-Konsolidace“, který je jedním z projektů společnosti NPO „Krista“. Pro něj byl dříve prováděn ruční monitoring podle získaných metrik. Protože je systém poměrně složitý, je sledováno velké množství metrik: ukazatele JVM (zatížení garbage collectoru), ukazatele OS, na které se kód vykonává (virtuální paměť, % zatížení CPU OS), ukazatele sítě (zatížení sítě), samotného serveru (zatížení CPU, paměti), metriky wildfly a vlastní metriky aplikace pro všechny kritické subsystémy.
Všechny metriky jsou získávány ze systému pomocí graphite. Původně byla použita databáze whisper jako standardní řešení pro grafanu, ale s růstem zákaznické základny graphite přestala stíhat, vyčerpávajíc propustnost diskového subsystému DC. Poté bylo rozhodnuto hledat efektivnější řešení. Výběr padl na , což umožnilo výrazně snížit zátěž na diskový subsystém a pět až šestkrát zmenšit zabraný diskový prostor. Níže je uvedena schéma mechanismu sběru metrik pomocí graphite+clickhouse (obrázek 2).
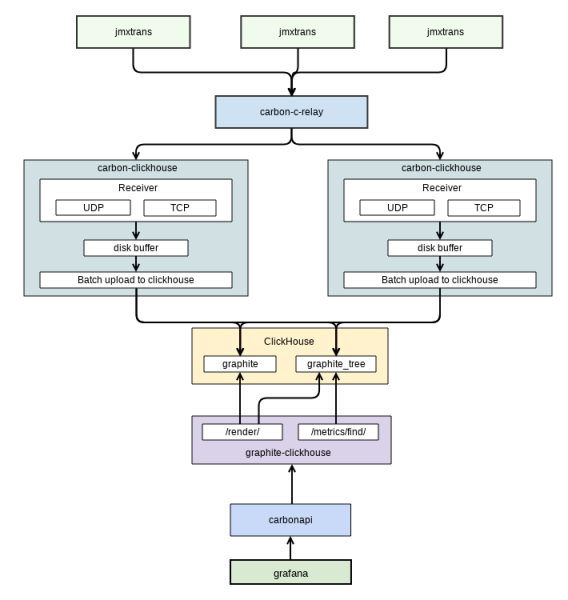
Obrázek 2. Schéma sběru metrik
Schéma je převzata z interní dokumentace. Zobrazuje výměnu dat mezi grafana (uživatelským rozhraním pro monitorování, které používáme) a graphite. Snímání metrik z aplikace provádí samostatný software – . Ten je také ukládá do graphite.
Systém „Web-Konsolidace“ má řadu vlastností, které vytvářejí problémy pro předpovídání selhání:
- často dochází ke změně trendu. Pro tento softwarový systém vycházejí různé verze. Každá z nich přináší změny v softwarové části systému. Tímto způsobem vývojáři přímo ovlivňují metriky tohoto systému a mohou vyvolat změnu trendu;
- povaha implementace a také cíle použití zákazníky tohoto systému často vyžadují anomálie bez předchozí degradace;
- procento anomálií vůči celému souboru dat je malé (< 5%);
- mohou nastávat mezery v získávání ukazatelů ze systému. V některých krátkých intervalech času se monitorovacímu systému nedaří získat metriky. Například, pokud je server přetížen. Pro učení neuronové sítě je to kritické. Je nutné synteticky vyplnit mezery;
- Případy s anomáliemi často platí pouze pro konkrétní číslo/měsíc/čas (sezónnost). Tento systém má jasně stanovená pravidla pro používání jeho uživateli. Metriky jsou tedy relevantní pouze pro konkrétní čas. Systém se může používat nepravidelně, pouze v některých měsících: selektivně podle roku. Vznikají situace, kdy stejné chování metrik v jednom případě může vést k selhání softwarového systému, zatímco ve druhém ne.
Nejprve byly analyzovány metody detekce anomálií v datech sledování softwarových systémů. V článcích na toto téma se při malých procentech anomálií ve vztahu k ostatním datovým souborům nejčastěji doporučuje použít neuronové sítě.
Hlavní logika pro vyhledávání anomálií pomocí dat neuronových sítí je znázorněna na obrázku 3:
Obrázek 3. Vyhledávání anomálií pomocí neuronové sítě
Na výsledku předpovědi nebo obnovení okna aktuálního toku metrik se vypočítává odchylka od získaného s fungujícím softwarovým systémem. V případě velkého rozdílu mezi získanými metrikami od softwarového systému a neuronové sítě lze usoudit na anomálii aktuálního segmentu dat. Vzniká následující řada problémů pro využití neuronových sítí:
- pro správnou práci v streamovacím režimu musí data pro trénink modelů neuronových sítí zahrnovat pouze „normální“ data;
- je nutné mít aktuální model pro správné odhalení. Změna trendu a sezónnosti v metrikách může vyvolat velké množství falešných poplachů modelu. Pro jeho aktualizaci je třeba přesně určit okamžik, kdy je model zastaralý. Pokud se model aktualizuje později nebo dříve, pravděpodobně dojde k velkému počtu falešných poplachů.
Nelze také zapomenout na hledání a prevenci častého výskytu falešných poplachů. Předpokládá se, že tyto budou nejčastěji vznikat v nestandardních situacích. Mohou však být také důsledkem chyby neuronové sítě z důvodu nedostatečného trénování. Je nutné minimalizovat počet falešných poplachů modelu. Jinak falešné předpovědi zaberou hodně času administrátora, který je určen k ověření systému. Dříve nebo později to skončí tím, že administrátor přestane reagovat na "paranoidu" monitorovacího systému.
Rekurentní neuronová síť
Pro odhalování anomálií v časových řadách lze použít s pamětí LSTM. Problém je pouze v tom, že ji lze použít pouze pro předpovídané časové řady. V našem případě nejsou všechny metriky předvídatelné. Pokus aplikovat RNN LSTM na časovou řadu je znázorněn na obrázku 4.
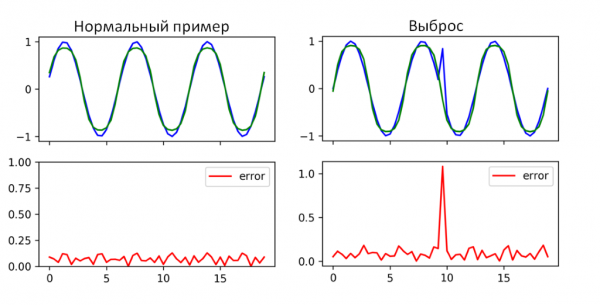
Obrázek 4. Příklad činnosti rekurentní neuronové sítě s buňkami paměti LSTM
Jak je vidět na obrázku 4, RNN LSTM se podařilo zvládnout detekci anomálií v tomto časovém úseku. Tam, kde má výsledek vysokou chybu předpovědi (průměrná chyba), došlo skutečně k anomálii podle ukazatelů. Použití pouze jedné RNN LSTM bude zjevně nedostačující, protože je aplikovatelné na malé množství metrik. Můžeme použít jako doplňkovou metodu k hledání anomálií.
Autoenkodér pro predikci poruch
– v podstatě umělá neuronová síť. Vstupní vrstva – encoder, výstupní vrstva – decoder. Nevýhodou všech neuronových sítí tohoto typu je špatná lokalizace anomálií. Byla vybrána architektura synchronního autoenkodéru.
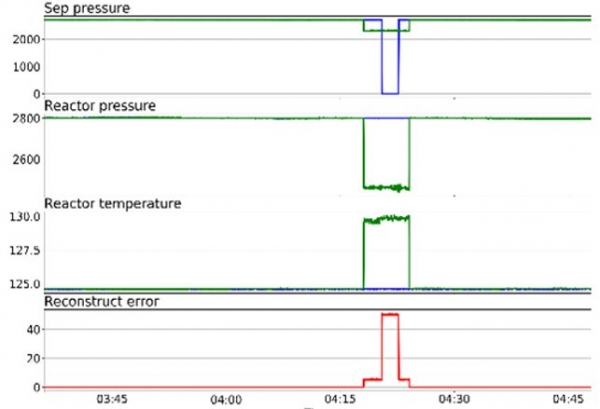
Obrázek 5. Příklad činnosti autoenkodéru
Autoenkodéry se trénují na normálních datech a poté hledají něco anomálního v datech podávaných do modelu. Přesně to, co je pro tento úkol potřeba. Zůstává jen vybrat, který autoenkodér se hodí pro tento úkol. Architektonicky nejjednodušší forma autoenkodéru je přímá, jednosměrná neuronová síť, která velmi připomíná (multilayer perceptron, MLP), s vstupní, výstupní vrstvou a jedním nebo několika skrytými vrstvami, které je propojují.
Rozdíly mezi autoenkodéry a MLP spočívají však v tom, že v automatickém kodéru má výstupní vrstva stejný počet uzlů jako vstupní, a že místo učení se predikovat cílovou hodnotu Y při daném vstupu X se autoenkodér učí rekonstruovat své vlastní X. Proto jsou autoenkodéry modely pro neregulované učení.
Úloha autoenkodéru spočívá v nalezení časových indexů r0 … rn, odpovídajících anomálním elementům ve vstupním vektoru X. Tento efekt je dosažen hledáním kvadratické chyby.
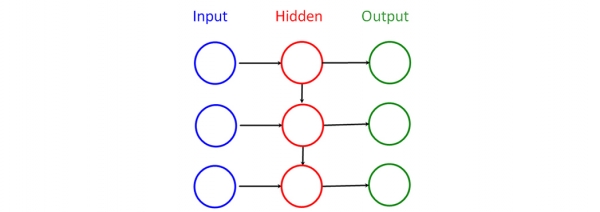
Obrázek 6. Synchronní autoenkodér
Pro autoenkodér byla vybrána . Její výhody: možnost použití streamového zpracování a relativně menší počet parametrů neuronové sítě ve srovnání s jinými architekturami.
Mechanismus minimalizace falešných poplachů
Vzhledem k různým mimořádným situacím a možnosti nedostatečného školení neuronové sítě bylo rozhodnuto o nezbytnosti vyvinout mechanismus pro minimalizaci falešných poplachů pro vyvíjený model detekce anomálií. Tento mechanismus se zakládá na základě šablon, kterou klasifikuje administrátor.
(algoritmus DTW, z anglického dynamic time warping) umožňuje nalézt optimální shodu mezi časovými sekvencemi. Poprvé byl použit v rozpoznávání řeči: sloužil k určení, jak dva řečové signály představují stejnou původně vyslovenou frázi. V pozdějších letech byl také aplikován v dalších oborech.
Hlavním principem minimalizace falešných poplachů je shromažďování databáze vzorů pomocí operátora, který klasifikuje podezřelé případy, které byly detekovány pomocí neuronových sítí. Následně probíhá porovnání zkategorizovaného vzoru s případem, který systém detekoval, a posuzuje se, zda se jedná o falešný poplach nebo situaci vedoucí k selhání. Pro porovnání dvou časových řad se používá algoritmus DTW. Hlavním nástrojem minimalizace zůstává klasifikace. Předpokládá se, že po shromáždění velkého množství vzorových případů systém přestane často vyžadovat zásah operátora z důvodu podobnosti většiny případů a vzniku podobných.
Na základě výše uvedených metod neuronových sítí byla vytvořena experimentální aplikace pro predikci selhání systému „Web-Konsolidace“. Cílem této aplikace bylo, za použití existujícího archivu dat monitorování a informací o již proběhlých selháních, posoudit účinnost této metody pro naše softwarové systémy. Schéma práce aplikace je znázorněno níže, na obrázku 7.
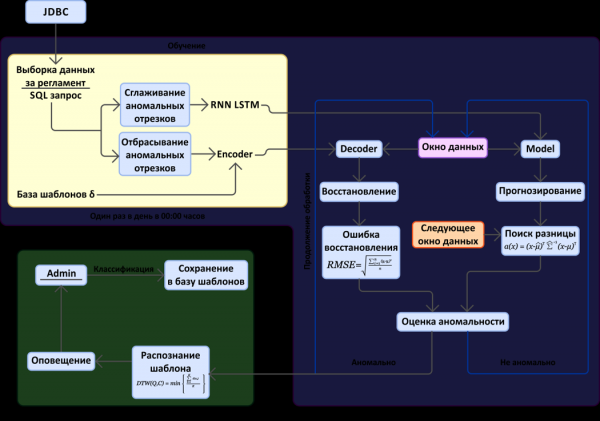
Obrázek 7. Schéma predikce selhání na základě analýzy prostotu metrik
Na schématu lze vyčlenit dvě hlavní oblasti: vyhledávání anomálních časových úseků v toku monitorovacích dat (metriku) a mechanismus minimalizace falešných poplachů. Poznámka: pro experimentální účely jsou data získávána prostřednictvím JDBC připojení z databáze, do které jsou ukládána s pomocí graphite.
Následuje rozhraní výsledného systému monitorování (obrázek 8).
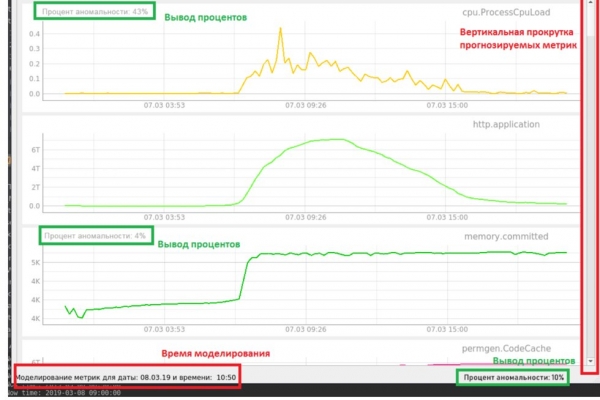
Obrázek 8. Rozhraní experimentálního systému monitorování
Na rozhraní se zobrazuje procento anomálnosti podle získaných metrik. V našem případě je výstup simulován. Již máme všechna data za několik týdnů a postupně je nahráváme pro ověření případu anomálie vedoucí k selhání. V dolním stavovém řádku se zobrazuje celkové procento anomálnosti dat v daném okamžiku, které je určeno pomocí autoenkodéru. Také pro předpovídané metriky se zobrazuje zvláštní procento, které vypočítává RNN LSTM.
Příklad detekce anomálie ukazatelů CPU pomocí neuronové sítě RNN LSTM (obrázek 9).
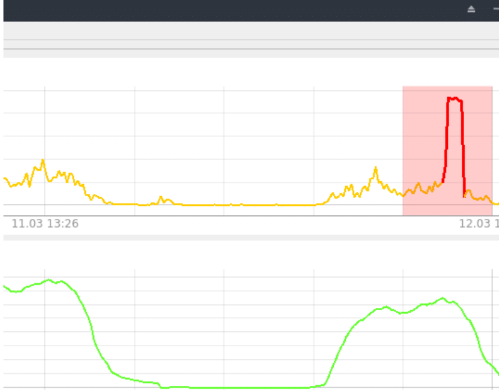
Obrázek 9. Detekce RNN LSTM
Poměrně jednoduchý případ, v podstatě běžný výkyv, který však vedl k selhání systému, byl úspěšně identifikován pomocí RNN LSTM. Ukazatel anomálnosti v tomto časovém úseku se rovná 85 – 95 %, vše nad 80 % (práh určený experimentálně) se považuje za anomálii.
Příklad detekce anomálie, kdy se systém nedařilo spustit po aktualizaci. Tuto situaci detekuje autoenkodér (obrázek 10).
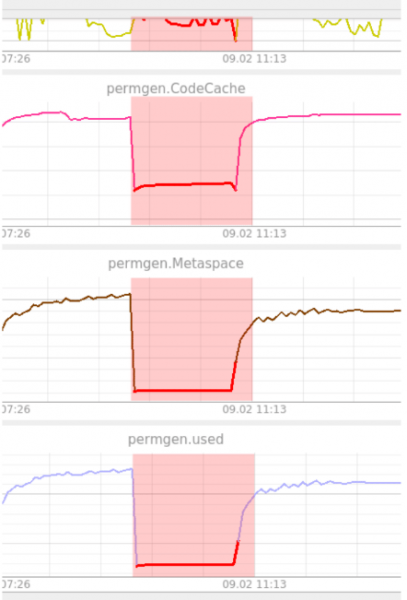
Obrázek 10. Příklad detekce pomocí autoenkodéru
Jak je vidět na obrázku, PermGen zůstal na jedné úrovni. Autoenkodér to považoval za zvláštní, protože dříve nic podobného neviděl. Anomálnost zde setrvává na 100 % do doby, než se systém vrátí do funkčního stavu. Anomálnost se zobrazuje ve všech metrikách. Jak již bylo uvedeno, autoenkodér nedokáže lokalizovat anomálie. Operátor má tuto funkci plnit v těchto situacích.
Závěr
PC "Web-Konsolidace" se vyvíjí již několik let. Systém je v poměrně stabilním stavu a počet registrovaných incidentů není příliš velký. I přesto se podařilo nalézt anomálie, které vedly k selhání 5 – 10 minut před jeho vznikem. V řadě případů by oznámení o selhání včas pomohlo ušetřit plánovaný čas vyčleněný na provádění "opravných" prací.
Z experimentů, které se podařilo provést, je ještě brzy na definitivní závěry. V současnosti jsou výsledky rozporuplné. Na jedné straně je patrné, že algoritmy založené na neurálních sítích jsou schopny nacházet "užitečné" anomálie. Na druhé straně zůstává vysoké procento falešných zjištění a ne všechny anomálie, které kvalifikovaný specialista identifikuje, se daří neurální síti zachytit. Mezi nevýhody patří i to, že současná neurální síť vyžaduje učení pod dohledem pro normální fungování.
Pro další rozvoj systému predikce selhání a jeho doladění do uspokojivého stavu lze zvážit několik cest. To zahrnuje podrobnější analýzu případů s anomáliemi, které vedou k selhání, což by vedlo k doplnění seznamu důležitých metrik, které mají velký vliv na stav systému, a k vyloučení těch, které nemají vliv. Pokud se budeme ubírat tímto směrem, mohli bychom také učinit pokusy o specializaci algoritmů konkrétně pro naše případy anomálií, které vedou k selhání. Existuje i jiná cesta. To je zdokonalení architektur neurálních sítí a tím zvýšení přesnosti detekce při zkrácení času učení.
Vyjadřuji poděkování kolegům, kteří mi pomohli s psaním a udržováním aktuálnosti tohoto článku: a Sergeji Finogenovovi.
Zdroj: habr.com
