

V článku se zvažuje několik způsobů, jak určit matematickou rovnici přímky jednoduché (párové) regrese.
Všechny zde zvažované metody řešení rovnice jsou založeny na metodě nejmenších čtverců. Označme způsoby následujícím způsobem:
- Analytické řešení
- Gradientní spád
- Stochastický gradientní spád
Pro každou z metod řešení rovnice přímky článek uvádí různé funkce, které se většinou dělí na ty, které jsou napsány bez použití knihovny NumPy a na ty, které pro výpočty používají NumPy. Považuje se, že dovedné využití NumPy umožní snížit náklady na výpočty.
Všechna uvedená kód v článku je napsána v jazyce python 2.7 s využitím Jupyter Notebook. Zdrojový kód a soubor s daty vzorku jsou uvedeny na
Článek je především zaměřen na začátečníky, ale také na ty, kteří již začali studovat velkou oblast umělé inteligence — strojové učení.
Pro ilustraci materiálu použijeme velmi jednoduchý příklad.
Podmínky příkladu
Máme pět hodnot, které charakterizují závislost Y od X (Tabulka č. 1):
Tabulka č. 1 „Podmínky příkladu“
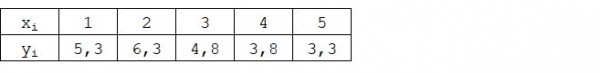
Předpokládejme, že hodnoty  — to je měsíc roku, a
 — výnos v tomto měsíci. Jinými slovy, výnos závisí na měsíci roku, a
 — to je jediný atribut, od kterého výnos závisí.
Příklad není zrovna ideální, jak z pohledu podmínkové závislosti výnosu na měsíci roku, tak z pohledu počtu hodnot — je jich velmi málo. Avšak toto zjednodušení umožní, jak se říká, na prstech vysvětlit, ne vždy snadno osvojený materiál pro začátečníky. A také jednoduchost čísel umožní bez značných pracovních nákladů těm, kteří chtějí, řešit příklad na „papíře“.
Předpokládejme, že uvedená v příkladu závislost může být dostatečně dobře aproximována matematickou rovnicí přímky jednoduché (párové) regrese ve tvaru:

kde  — to je měsíc, v němž byl výnos získán,
 — výnos odpovídající měsíci,
 a
 — koeficienty regrese odhadované přímky.
Poznamenejme, že koeficient  se často nazývá sklon nebo gradient odhadované přímky; představuje množství, o které se změní
 při změně
 .
Je zřejmé, že naším úkolem v tomto příkladu je nalézt v rovnici takové koeficienty  a
 , při kterých budou odchylky našich vypočtených hodnot výnosů za měsíce od skutečných odpovědí, tj. hodnot uvedených ve vzorku, minimální.
Metoda nejmenších čtverců
Podle metody nejmenších čtverců je třeba odchylku vypočítat jako její čtverec. Takový přístup umožňuje vyhnout se vzájemnému vyrovnání odchylek, pokud mají opačné znaménko. Například, pokud v jednom případě činí odchylka +5 (plus pět) a v druhém -5 (mínus pět), pak součet odchylek se vzájemně vyrovná a bude nulový. Můžeme a také nemusíme vzdychat odchylku do čtverce, ale využít vlastnosti modulu, a pak budou všechny odchylky kladné a budou se hromadit. Na tomto bodě se nezastavíme podrobně, ale prostě označíme, že pro usnadnění výpočtů je obvyklé odchylku umocnit na druhou.
Takto vypadá vzorec, pomocí kterého určujeme nejmenší součet čtverců odchylek (chyb):

kde  — to je funkce aproximace skutečných odpovědí (tj. námi vypočtený výnos),
 — to jsou skutečné odpovědi (poskytnutý ve vzorku výnos),
 — to je index vzorku (číslo měsíce, ve kterém se určuje odchylka)
Proderivujeme funkci, určíme rovnice parciálních derivací a budeme připraveni přejít k analytickému řešení. Ale nejprve provedeme krátký exkurs o tom, co je to diferenciace a připomeneme si geometrický význam derivace.
Diferenciace
Diferenciací nazýváme operaci nalezení derivace funkce.
K čemu je derivace? Derivace funkce charakterizuje rychlost změny funkce a ukazuje nám její směrování. Pokud je derivace v daném bodě kladná, funkce roste; v opačném případě funkce klesá. A čím větší je hodnota derivace v absolutní hodnotě, tím vyšší je rychlost změny hodnot funkce, a také strmější úhel sklonu grafu funkce.
Například, v podmínkách dekartovské soustavy souřadnic, hodnota derivace v bodě M(0,0) rovna +25 znamená, že v daném bodě, při posunutí hodnoty  vpravo o jednotkovou vzdálenost, hodnota
 zvyšuje se o 25 obvyklých jednotek. Na grafu to vypadá jako dost strmý úhel vzestupu hodnot
 od daného bodu.
Další příklad. Hodnota derivace rovná -0,1 znamená, že při posunu  o jednu obvyklou jednotku se hodnota
 snižuje pouze o 0,1 obvyklé jednotky. Na grafu funkce tak můžeme pozorovat jen mírný sklon dolů. Když uděláme analogii s horou, je to jako bychom velmi pomalu sestupovali po mírném svahu hory, na rozdíl od předchozího příkladu, kde jsme museli řešit velmi strmé vrcholy:)
Takže, po provedení diferenciace funkce  podle koeficientů
 a
 , určíme rovnice parciálních derivací 1. řádu. Po určení rovnic získáme systém dvou rovnic, jejichž řešením budeme moci najít hodnoty koeficientů
 a
 , pro které se hodnoty příslušných derivací v daných bodech mění na velmi malou velikost, a v případě analytického řešení se nezmění vůbec. Jinými slovy, funkce chyby při nalezených koeficientech dosáhne minima, protože hodnoty parciálních derivací v těchto bodech budou rovny nule.
Takže podle pravidel diferenciace má rovnice parciální derivace 1. řádu podle koeficientu  bude mít tvar:

rovnice parciální derivace 1. řádu podle  bude mít tvar:

Nakonec jsme dostali systém rovnic, který má dost jednoduché analytické řešení:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Než začneme řešit rovnici, nejprve načteme, ověříme správnost načtení a naformátujeme data.
Načítání a formátování dat
Je třeba poznamenat, že vzhledem k tomu, že pro analytické řešení, a poté pro gradientní a stochastický gradientní spád, budeme používat kód ve dvou variantách: s využitím knihovny NumPy a bez jejího využití, potřebujeme příslušné formátování dat (viz kód).
Kód pro načítání a zpracování dat
# импортируем все нужные нам библиотеки
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import math
import pylab as pl
import random

# графики отобразим в Jupyter
%matplotlib inline

# укажем размер графиков
from pylab import rcParams
rcParams['figure.figsize'] = 12, 6

# отключим предупреждения Anaconda
import warnings
warnings.simplefilter('ignore')

# загрузим значения
table_zero = pd.read_csv('data_example.txt', header=0, sep='t')

# посмотрим информацию о таблице и на саму таблицу
print table_zero.info()
print '********************************************'
print table_zero
print '********************************************'

# подготовим данные без использования NumPy

x_us = []
[x_us.append(float(i)) for i in table_zero['x']]
print x_us
print type(x_us)
print '********************************************'

y_us = []
[y_us.append(float(i)) for i in table_zero['y']]
print y_us
print type(y_us)
print '********************************************'

# подготовим данные с использованием NumPy

x_np = table_zero[['x']].values
print x_np
print type(x_np)
print x_np.shape
print '********************************************'

y_np = table_zero[['y']].values
print y_np
print type(y_np)
print y_np.shape
print '********************************************'
Vizualizace
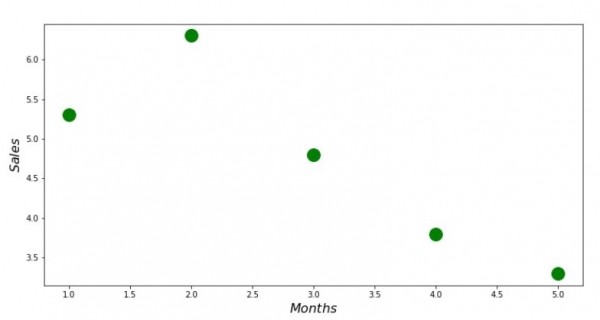
Nyní, poté co jsme nejprve načetli data, za druhé ověřili správnost načtení a konečně naformátovali data, provedeme první vizualizaci. Často se k tomu používá metoda pairplot knihovny Seaborn. V našem příkladu, vzhledem k omezenosti čísel, nemá smysl použít knihovnu. Seaborn. Použijeme obyčejnou knihovnu. Matplotlib A podíváme se pouze na diagram rozptylu.
Kód diagramu rozptylu.
print 'Graf č. 1 "Závislost tržeb na měsíci roku"'

plt.plot(x_us,y_us,'o',color='green',markersize=16)
plt.xlabel('$Měsíce$', size=16)
plt.ylabel('$Tržby$', size=16)
plt.show()
Graf č. 1 «Závislost tržeb na měsíci roku»
Analytické řešení
Využijeme ty nejběžnější nástroje v python A vyřešíme soustavu rovnic:
begin{equation*}
begin{cases}
na + bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i = 0
sumlimits_{i=1}^nx_i(a +bsumlimits_{i=1}^nx_i — sumlimits_{i=1}^ny_i) = 0
end{cases}
end{equation*}
Podle Cramerova pravidla najdeme obecný determinant, a také determinanti podle  A podle
 , po kterém, dělením determinantu podle
 obecnému determinantovi — najdeme koeficient
 , analogicky najdeme koeficient
 .
Kód analytického řešení.
# определим функцию для расчета коэффициентов a и b по правилу Крамера
def Kramer_method (x,y):
        # сумма значений (все месяца)
    sx = sum(x)
        # сумма истинных ответов (выручка за весь период)
    sy = sum(y)
        # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x[i]*y[i]) for i in range(len(x))]
    sxy = sum(list_xy)
        # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x[i]**2) for i in range(len(x))]
    sx_sq = sum(list_x_sq)
        # количество значений
    n = len(x)
        # общий определитель
    det = sx_sq*n - sx*sx
        # определитель по a
    det_a = sx_sq*sy - sx*sxy
        # искомый параметр a
    a = (det_a / det)
        # определитель по b
    det_b = sxy*n - sy*sx
        # искомый параметр b
    b = (det_b / det)
        # контрольные значения (прооверка)
    check1 = (n*b + a*sx - sy)
    check2 = (b*sx + a*sx_sq - sxy)
    return [round(a,4), round(b,4)]

# запустим функцию и запишем правильные ответы
ab_us = Kramer_method(x_us,y_us)
a_us = ab_us[0]
b_us = ab_us[1]
print ' 33[1m' + ' 33[4m' + "Оптимальные значения коэффициентов a и b:"  + ' 33[0m'
print 'a =', a_us
print 'b =', b_us
print

# определим функцию для подсчета суммы квадратов ошибок
def errors_sq_Kramer_method(answers,x,y):
    list_errors_sq = []
    for i in range(len(x)):
        err = (answers[0] + answers[1]*x[i] - y[i])**2
        list_errors_sq.append(err)
    return sum(list_errors_sq)

# запустим функцию и запишем значение ошибки
error_sq = errors_sq_Kramer_method(ab_us,x_us,y_us)
print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений" + ' 33[0m'
print error_sq
print

# замерим время расчета
# print ' 33[1m' + ' 33[4m' + "Время выполнения расчета суммы квадратов отклонений:" + ' 33[0m'
# % timeit error_sq = errors_sq_Kramer_method(ab,x_us,y_us)
Tady je, co jsme dostali:
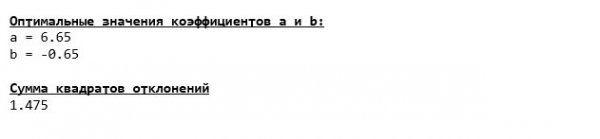
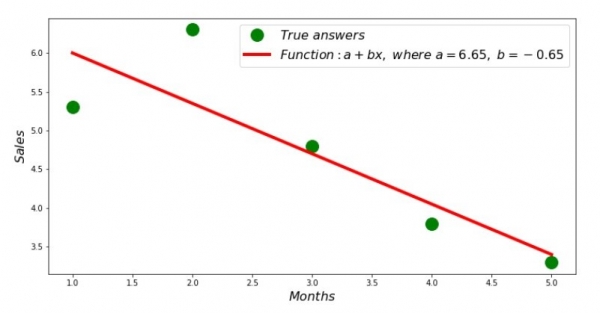
Takže hodnoty koeficientů byly nalezeny, součet čtverců odchylek byl stanoven. Nakreslíme na histogramu rozptylu přímku v souladu se nalezenými koeficienty.
Kód regrese.
# определим функцию для формирования массива рассчетных значений выручки
def sales_count(ab,x,y):
    line_answers = []
    [line_answers.append(ab[0]+ab[1]*x[i]) for i in range(len(x))]
    return line_answers

# построим графики
print 'Грфик№2 "Правильные и расчетные ответы"'
plt.plot(x_us,y_us,'o',color='green',markersize=16, label = '$True$ $answers$')
plt.plot(x_us, sales_count(ab_us,x_us,y_us), color='red',lw=4,
         label='$Function: a + bx,$ $where$ $a='+str(round(ab_us[0],2))+',$ $b='+str(round(ab_us[1],2))+'$')
plt.xlabel('$Months$', size=16)
plt.ylabel('$Sales$', size=16)
plt.legend(loc=1, prop={'size': 16})
plt.show()
Graf č. 2 «Správné a vypočtené odpovědi»
Můžeme se podívat na graf odchylek za každý měsíc. V našem případě z toho nevytáhneme žádnou významnou praktickou hodnotu, ale uspokojíme zvědavost na to, jak dobře rovnice jednoduché lineární regrese charakterizuje závislost tržeb na měsíci roku.
Kód grafu odchylek.
# определим функцию для формирования массива отклонений в процентах
def error_per_month(ab,x,y):
    sales_c = sales_count(ab,x,y)
    errors_percent = []
    for i in range(len(x)):
        errors_percent.append(100*(sales_c[i]-y[i])/y[i])
    return errors_percent

# построим график
print 'График№3 "Отклонения по-месячно, %"'
plt.gca().bar(x_us, error_per_month(ab_us,x_us,y_us), color='brown')
plt.xlabel('Months', size=16)
plt.ylabel('Calculation error, %', size=16)
plt.show()
Graf č. 3 «Odchylky, %»
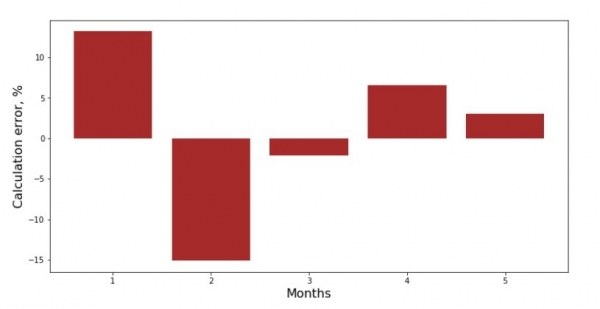
Není to dokonalé, ale úkol jsme splnili.
Napíšeme funkci, která pro určení koeficientů  a
 využívá knihovnu NumPy, přesněji — napíšeme dvě funkce: jednu s použitím pseudo-inverzní matice (nedoporučuje se v praxi, protože proces je výpočetně složitý a nestabilní), druhou s použitím maticové rovnice.
Kód analytického řešení (NumPy).
# для начала добавим столбец с не изменяющимся значением в 1.
# Данный столбец нужен для того, чтобы не обрабатывать отдельно коэффицент a
vector_1 = np.ones((x_np.shape[0],1))
x_np = table_zero[['x']].values # на всякий случай приведем в первичный формат вектор x_np
x_np = np.hstack((vector_1,x_np))

# проверим то, что все сделали правильно
print vector_1[0:3]
print x_np[0:3]
print '***************************************'
print

# напишем функцию, которая определяет значения коэффициентов a и b с использованием псевдообратной матрицы
def pseudoinverse_matrix(X, y):
    # задаем явный формат матрицы признаков
    X = np.matrix(X)
    # определяем транспонированную матрицу
    XT = X.T
    # определяем квадратную матрицу
    XTX = XT*X
    # определяем псевдообратную матрицу
    inv = np.linalg.pinv(XTX)
    # задаем явный формат матрицы ответов
    y = np.matrix(y)
    # находим вектор весов
    return (inv*XT)*y

# запустим функцию
ab_np = pseudoinverse_matrix(x_np, y_np)
print ab_np
print '***************************************'
print

# напишем функцию, которая использует для решения матричное уравнение
def matrix_equation(X,y):
    a = np.dot(X.T, X)
    b = np.dot(X.T, y)
    return np.linalg.solve(a, b)

# запустим функцию
ab_np = matrix_equation(x_np,y_np)
print ab_np
Porovnáme čas, který byl vynaložen na určení koeficientů  a
 , podle 3 prezentovaných metod.
Kód pro výpočet času výpočtů.
print ' 33[1m' + ' 33[4m' + "Čas provádění výpočtu koeficientů bez použití knihovny NumPy:" + ' 33[0m'
% timeit ab_us = Kramer_method(x_us,y_us)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Čas provádění výpočtu koeficientů s použitím pseudo-inverzní matice:" + ' 33[0m'
%timeit ab_np = pseudoinverse_matrix(x_np, y_np)
print '***************************************'
print
print ' 33[1m' + ' 33[4m' + "Čas provádění výpočtu koeficientů s použitím maticové rovnice:" + ' 33[0m'
%timeit ab_np = matrix_equation(x_np, y_np)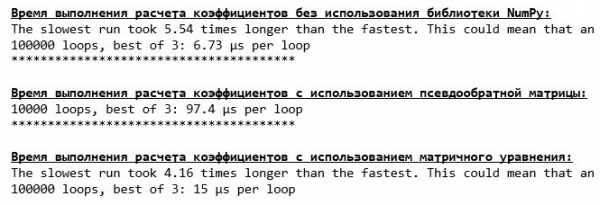
Na menším množství dat se vpředu objevuje "vlastní" funkce, která nachází koeficienty Kramer's metodu.
Teď se můžeme přejít k jiným metodám pro nalezení koeficientů.  a
 .
Gradientní spád
Nejprve si definujme, co to je gradient. Zjednodušeně, gradient je úsečka, která ukazuje směrem maximálního růstu funkce. Podobně jako při stoupání do kopce, kam se dívá gradient, tam je nejstrmější stoupání k vrcholu hory. Kdybychom se drželi příkladu s horou, vzpomněli bychom, že vlastně potřebujeme nejstrmější sestup, abychom co nejrychleji dosáhli údolí, tedy minima — místa, kde funkce neroste a neklesá. Na tomto místě bude derivace rovna nule. Tedy, potřebujeme ne gradient, ale antigradient. K nalezení antigradientu stačí gradient vynásobit -1 (mínus jedna).
Všimněme si, že funkce může mít více minim, a když se dostaneme do jednoho z nich podle níže uvedeného algoritmu, nemůžeme najít jiné minimum, které by mohlo být nižší než právě nalezené. Uklidněme se, nás to neohrožuje! V našem případě máme co do činění s jedním jediným minimem, protože naše funkce  na grafu představuje běžnou parabolu. A jak všichni víme ze školy — parabol má pouze jedno minimum.
Po zjištění, k čemu jsme potřebovali gradient, a také toho, že gradient je úsečka, tedy vektor se zadanými souřadnicemi, které jsou právě těmi koeficienty  a
 můžeme realizovat gradientní sestup.
Před spuštěním doporučuji přečíst si doslova několik vět o algoritmu sestupu:
- Určujeme pseudonáhodně souřadnice koeficientů
 a . V našem příkladu budeme určovat koeficienty blízko nuly. To je běžná praxe, avšak pro každý případ může být vyžadována vlastní praxe.
- Od souřadnice odčítáme hodnotu parciální derivace 1. řádu v bodě. Takže pokud bude derivace kladná, funkce roste. Tím pádem, když odečteme hodnotu derivace, budeme se pohybovat zpět proti růstu, tedy směrem dolů. Pokud je derivace záporná, znamená to, že funkce v tomto bodě klesá a odečtením hodnoty derivace se posouváme dolů.
- Provádíme podobnou operaci s koordinátou : odečítáme hodnotu parciální derivace v bodě .
- Abychom nepřeskočili minimum a neodletěli do vzdáleného vesmíru, je nutné nastavit velikost kroku směrem dolů. Obecně lze napsat celý článek o tom, jak správně nastavit krok a jak jej měnit během klesání, aby se snížily náklady na výpočty. Ale teď máme poněkud jiný úkol a vědeckou metodou „zkoušení“ nebo jak říkají lidé, empiricky, určíme velikost kroku.
- Po tom, co jsme z daných koordinátů a odečetli hodnoty derivací, získáváme nové souřadnice a . Děláme další krok (odečítání), již z vypočítaných souřadnic. A tak se cyklus znovu a znovu spouští, dokud nedosáhneme požadované konvergence.
 a
 . V našem příkladu budeme určovat koeficienty blízko nuly. To je běžná praxe, avšak pro každý případ může být vyžadována vlastní praxe.
 odčítáme hodnotu parciální derivace 1. řádu v bodě.
 Takže pokud bude derivace kladná, funkce roste. Tím pádem, když odečteme hodnotu derivace, budeme se pohybovat zpět proti růstu, tedy směrem dolů. Pokud je derivace záporná, znamená to, že funkce v tomto bodě klesá a odečtením hodnoty derivace se posouváme dolů.
 : odečítáme hodnotu parciální derivace v bodě
 .
 a
 odečetli hodnoty derivací, získáváme nové souřadnice
 a
 . Děláme další krok (odečítání), již z vypočítaných souřadnic. A tak se cyklus znovu a znovu spouští, dokud nedosáhneme požadované konvergence.
Všechno! Nyní jsme připraveni vyrazit na hledání nejhlubšího údolí Mariánského příkopu. Začínáme.
Kód pro gradientní klesání
# напишем функцию градиентного спуска без использования библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = sum(x_us)
    # сумма истинных ответов (выручка за весь период)
    sy = sum(y_us)
    # сумма произведения значений на истинные ответы
    list_xy = []
    [list_xy.append(x_us[i]*y_us[i]) for i in range(len(x_us))]
    sxy = sum(list_xy)
    # сумма квадратов значений
    list_x_sq = []
    [list_x_sq.append(x_us[i]**2) for i in range(len(x_us))]
    sx_sq = sum(list_x_sq)
    # количество значений
    num = len(x_us)
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = [a,b]
        errors.append(errors_sq_Kramer_method(ab,x_us,y_us))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)


print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print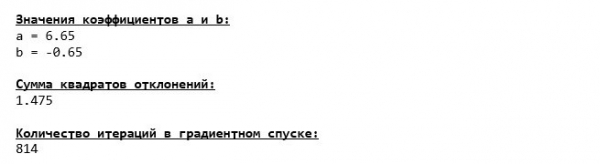
Sestoupili jsme na samotné dno Mariánského příkopu a tam jsme objevili ty samé hodnoty koeficientů  a
 , co jsme vlastně očekávali.
Podnikneme ještě jeden ponor, jen tentokrát výplň našeho hlubinného aparátu budou jiné technologie, konkrétně knihovna NumPy.
Kód pro gradientní klesání (NumPy)
# перед тем определить функцию для градиентного спуска с использованием библиотеки NumPy,
# напишем функцию определения суммы квадратов отклонений также с использованием NumPy
def error_square_numpy(ab,x_np,y_np):
    y_pred = np.dot(x_np,ab)
    error = y_pred - y_np
    return sum((error)**2)

# напишем функцию градиентного спуска с использованием библиотеки NumPy.
# Функция на вход принимает диапазоны значений x,y, длину шага (по умолчанию=0,1), допустимую погрешность(tolerance)
def gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001):
    # сумма значений (все месяца)
    sx = float(sum(x_np[:,1]))
    # сумма истинных ответов (выручка за весь период)
    sy = float(sum(y_np))
    # сумма произведения значений на истинные ответы
    sxy = x_np*y_np
    sxy = float(sum(sxy[:,1]))
    # сумма квадратов значений
    sx_sq = float(sum(x_np[:,1]**2))
    # количество значений
    num = float(x_np.shape[0])
    # начальные значения коэффициентов, определенные псевдослучайным образом
    a = float(random.uniform(-0.5, 0.5))
    b = float(random.uniform(-0.5, 0.5))
    # создаем массив с ошибками, для старта используем значения 1 и 0
    # после завершения спуска стартовые значения удалим
    errors = [1,0]
    # запускаем цикл спуска
    # цикл работает до тех пор, пока отклонение последней ошибки суммы квадратов от предыдущей, не будет меньше tolerance
    while abs(errors[-1]-errors[-2]) > tolerance:
        a_step = a - l*(num*a + b*sx - sy)/num
        b_step = b - l*(a*sx + b*sx_sq - sxy)/num
        a = a_step
        b = b_step
        ab = np.array([[a],[b]])
        errors.append(error_square_numpy(ab,x_np,y_np))
    return (ab),(errors[2:])

# запишем массив значений
list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_gradient_descence[0][0],3)
print 'b =', round(list_parametres_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в градиентном спуске:" + ' 33[0m'
print len(list_parametres_gradient_descence[1])
print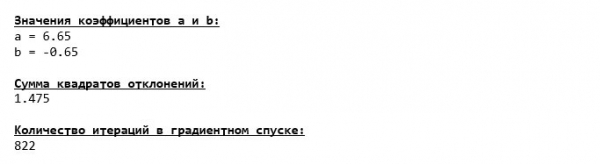
Hodnoty koeficientů  a
 zůstávají neměnné.
Podíváme se na to, jak se měnila chyba při gradientním klesání, tedy jak se měnila suma čtverců odchylek s každým krokem.
Kód pro graf součtů čtverců odchylek
print 'Graf č. 4 "Suma čtverců odchylek po krocích"'
plt.plot(range(len(list_parametres_gradient_descence[1])), list_parametres_gradient_descence[1], color='red', lw=3)
plt.xlabel('Kroky (Iterace)', size=16)
plt.ylabel('Suma čtverců odchylek', size=16)
plt.show()
Graf č. 4 «Suma čtverců odchylek při gradientním klesání»
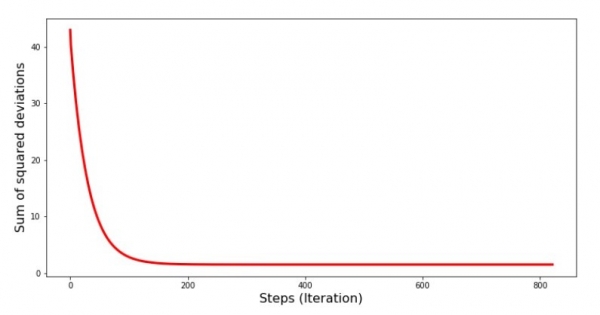
Na grafu vidíme, že s každým krokem se chyba snižuje a po určitém počtu iterací pozorujeme prakticky horizontální čáru.
Nakonec oceníme rozdíl v čase provedení kódu:
Kód pro stanovení doby výpočtu gradientního sestupu
print ' 33[1m' + ' 33[4m' + "Doba vykonání gradientního sestupu bez použití knihovny NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_usual(x_us,y_us,l=0.1,tolerance=0.000000000001)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' + "Doba vykonání gradientního sestupu s použitím knihovny NumPy:" + ' 33[0m'
%timeit list_parametres_gradient_descence = gradient_descent_numpy(x_np,y_np,l=0.1,tolerance=0.000000000001)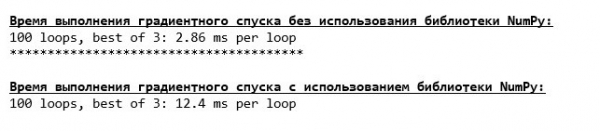
Možná děláme něco špatně, ale opět jednoduchá „vlastní“ funkce, která nepoužívá knihovnu NumPy předstihuje v čase vykonání výpočtů funkci, která využívá knihovnu NumPy.
Ale nezůstáváme na místě a posouváme se k dalšímu zajímavému způsobu řešení rovnice jednoduché lineární regrese. Představujeme!
Stochastický gradientní spád
Abychom lépe pochopili princip fungování stochastického gradientního sestupu, je dobré určit jeho rozdíly od běžného gradientního sestupu. V případě gradientního sestupu jsme v rovnicích odvozenin  a
 používali součty hodnot všech znaků a skutečných odpovědí, které máme ve vzorku (tj. součty všech
 a
 ). V stochastickém gradientním sestupu nebudeme používat všechny hodnoty, které máme ve vzorku, ale místo toho pseudonáhodně vybereme takzvaný index vzorku a použijeme jeho hodnoty.
Například, pokud se index určil jako číslo 3 (tři), vezmeme hodnoty  a
 , poté dosadíme hodnoty do rovnic odvozenin a určujeme nové souřadnice. Pak, po určení souřadnic, opět pseudonáhodně určíme index vzorku, dosadíme hodnoty odpovídající indexu do rovnic parciálních odvozenin a znovu určujeme souřadnice
 a
 atd. až k dosažení konvergence. Na první pohled se může zdát, jak to vůbec může fungovat, ale skutečně to funguje. Pravda, že ne s každým krokem se chyba snižuje, ale trend tu bezesporu je.
Jaké jsou výhody stochastického gradientního sestupu oproti běžnému? V případě, že máme velmi velkou velikost vzorku, měřenou na desítky tisíc hodnot, je mnohem snazší zpracovat například náhodnou tisícovku z nich než celý vzorek. V tomto případě se spouští stochastický gradientní sestup. V našem případě si samozřejmě žádný velký rozdíl nevšimneme.
Podívejme se na kód.
Kód pro stochastický gradientní sestup
# определим функцию стох.град.шага
def stoch_grad_step_usual(vector_init, x_us, ind, y_us, l):
#     выбираем значение икс, которое соответствует случайному значению параметра ind
# (см.ф-цию stoch_grad_descent_usual)
    x = x_us[ind]
#     рассчитывыаем значение y (выручку), которая соответствует выбранному значению x
    y_pred = vector_init[0] + vector_init[1]*x_us[ind]
#     вычисляем ошибку расчетной выручки относительно представленной в выборке
    error = y_pred - y_us[ind]
#     определяем первую координату градиента ab
    grad_a = error
#     определяем вторую координату ab
    grad_b = x_us[ind]*error
#     вычисляем новый вектор коэффициентов
    vector_new = [vector_init[0]-l*grad_a, vector_init[1]-l*grad_b]
    return vector_new


# определим функцию стох.град.спуска
def stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800):
#     для самого начала работы функции зададим начальные значения коэффициентов
    vector_init = [float(random.uniform(-0.5, 0.5)), float(random.uniform(-0.5, 0.5))]
    errors = []
#     запустим цикл спуска
# цикл расчитан на определенное количество шагов (steps)
    for i in range(steps):
        ind = random.choice(range(len(x_us)))
        new_vector = stoch_grad_step_usual(vector_init, x_us, ind, y_us, l)
        vector_init = new_vector
        errors.append(errors_sq_Kramer_method(vector_init,x_us,y_us))
    return (vector_init),(errors)


# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.1, steps = 800)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print

print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])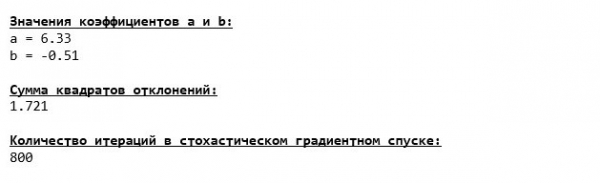
Díváme se pozorně na koeficienty a chytáme se na otázce „Jak to?“. Dostali jsme jiné hodnoty koeficientů.  a
 . Možná stochastický gradientní sestup našel optimálnější parametry rovnice? Bohužel ne. Stačí se podívat na součet čtverců odchylek a vidět, že při nových hodnotách koeficientů je chyba větší. Nespěcháme na zoufání. Vykreslíme graf změny chyby.
Kód pro graf součtu čtverců odchylek při stochastickém gradientním sestupu
print 'Graf č. 5 "Součet čtverců odchylek po krocích"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Kroky (Iterace)', size=16)
plt.ylabel('Součet čtverců odchylek', size=16)
plt.show()
Graf č. 5 «Součet čtverců odchylek při stochastickém gradientním sestupu»
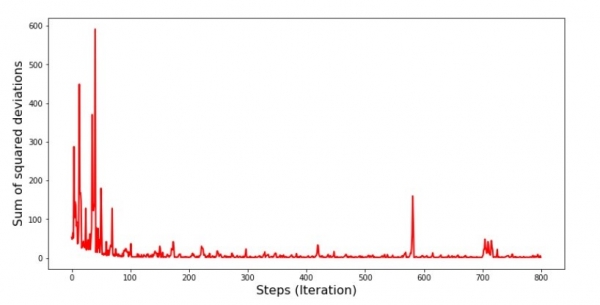
Podívaná na graf vše uspořádává a teď to všechno opravíme.
Tak co se stalo? Stalo se následující. Když náhodně vybíráme měsíc, tak právě pro vybraný měsíc se náš algoritmus snaží snížit chybu výpočtu výnosu. Poté vybíráme jiný měsíc a opakujeme výpočet, ale chybu snižujeme již pro druhý vybraný měsíc. A teď si vzpomeňme, že první dva měsíce se značně odchylují od linie rovnice jednoduché lineární regrese. To znamená, že kdykoli se vybere jakýkoli z těchto dvou měsíců, při snižování chyby každého z nich, náš algoritmus vážně zvyšuje chybu v celém vzorku. Co tedy dělat? Odpověď je jednoduchá: je třeba snížit krok sestupu. Když snížíme krok sestupu, chyba také přestane „poskakovat“ nahoru a dolů. Vlastně, chyba „poskakovat“ nepřestane, ale dělat to nebude tak vznášející se:) Otestujeme.
Kód pro spuštění SGD s menším krokem
# запустим функцию, уменьшив шаг в 100 раз и увеличив количество шагов соответсвующе
list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])

print 'График №6 "Сумма квадратов отклонений по-шагово"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1])), list_parametres_stoch_gradient_descence[1], color='red', lw=2)
plt.xlabel('Steps (Iteration)', size=16)
plt.ylabel('Sum of squared deviations', size=16)
plt.show()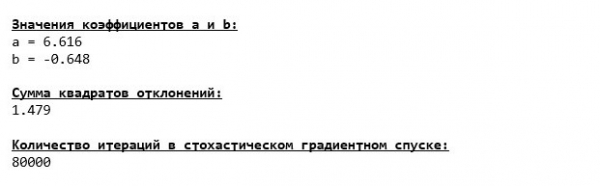
Graf č. 6 «Součet čtverců odchylek při stochastickém gradientním sestupu (80 tis. kroků)»
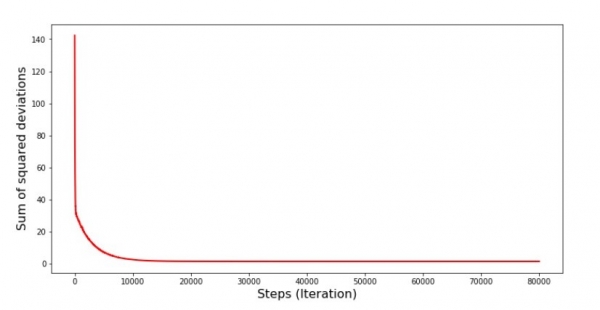
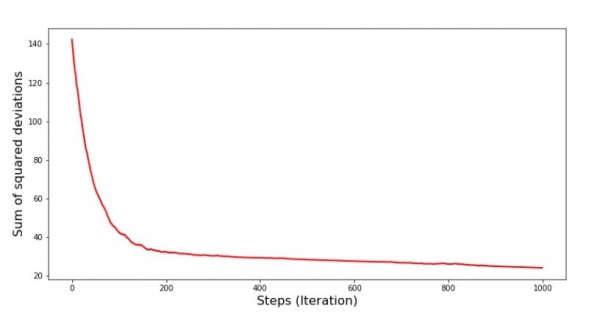
Hodnoty koeficientů se zlepšily, ale stále nejsou ideální. Teoreticky to lze napravit následujícím způsobem. Vybereme například z posledních 1000 iterací hodnoty koeficientů, u kterých byla dosažena minimální chyba. Oprávněně k tomu budeme muset zaznamenávat také samotné hodnoty koeficientů. To však nebudeme dělat, raději se zaměříme na graf. Vypadá hladce a chyba se na první pohled zdá, že se snižuje rovnoměrně. Ve skutečnosti to tak není. Podívejme se na prvních 1000 iterací a porovnejme je s posledními.
Kód pro graf SGD (prvních 1000 kroků)
print 'Graf č. 7 "Součet čtverců odchylek po krocích. Prvních 1000 iterací"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][:1000])),
         list_parametres_stoch_gradient_descence[1][:1000], color='red', lw=2)
plt.xlabel('Kroky (Iterace)', size=16)
plt.ylabel('Součet čtverců odchylek', size=16)
plt.show()

print 'Graf č. 7 "Součet čtverců odchylek po krocích. Posledních 1000 iterací"'
plt.plot(range(len(list_parametres_stoch_gradient_descence[1][-1000:])),
         list_parametres_stoch_gradient_descence[1][-1000:], color='red', lw=2)
plt.xlabel('Kroky (Iterace)', size=16)
plt.ylabel('Součet čtverců odchylek', size=16)
plt.show()
Graf č. 7 „Součet čtverců odchylek SGD (prvních 1000 kroků)“
Graf č. 8 „Součet čtverců odchylek SGD (posledních 1000 kroků)“
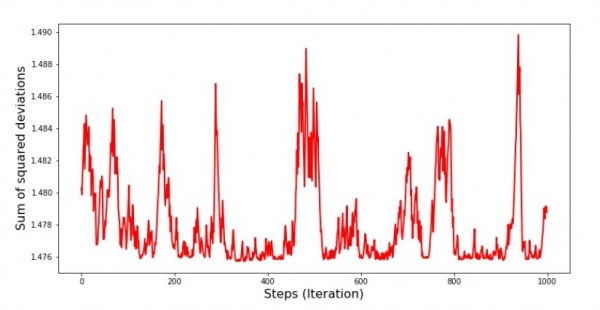
Na samém začátku sestupu pozorujeme poměrně rovnoměrné a strmé snížení chyby. Na posledních iteracích vidíme, že chyba se pohybuje kolem hodnoty 1,475 a v některých okamžicích se dokonce rovná této optimální hodnotě, ale poté se stejně vyšplhá… Opakuji, můžeme zaznamenávat hodnoty koeficientů  a
 , a pak vybrat ty, při kterých je chyba minimální. Nicméně máme vážnější problém: museli jsme udělat 80 tisíc kroků (viz kód), abychom získali hodnoty blízké optimálním. A to už odporuje myšlence úspory času výpočtů při stochastickém gradientním spadu oproti gradientnímu. Co můžeme opravit a zlepšit? Není těžké si všimnout, že na prvních iteracích jdeme rozhodně dolů a proto bychom měli na prvních iteracích ponechat velký krok a postupně ho snižovat. To však nebudeme dělat v tomto článku — je už tak dost dlouhý. Zájemci mohou sami přemýšlet, jak to udělat, není to složité 🙂
Nyní provedeme stochastický gradientní spad s použitím knihovny NumPy (a nebudeme zakopávat o kameny, které jsme odhalili dříve)
Kód pro stochastický gradientní sestup (NumPy)
# для начала напишем функцию градиентного шага
def stoch_grad_step_numpy(vector_init, X, ind, y, l):
    x = X[ind]
    y_pred = np.dot(x,vector_init)
    err = y_pred - y[ind]
    grad_a = err
    grad_b = x[1]*err
    return vector_init - l*np.array([grad_a, grad_b])

# определим функцию стохастического градиентного спуска
def stoch_grad_descent_numpy(X, y, l=0.1, steps = 800):
    vector_init = np.array([[np.random.randint(X.shape[0])], [np.random.randint(X.shape[0])]])
    errors = []
    for i in range(steps):
        ind = np.random.randint(X.shape[0])
        new_vector = stoch_grad_step_numpy(vector_init, X, ind, y, l)
        vector_init = new_vector
        errors.append(error_square_numpy(vector_init,X,y))
    return (vector_init), (errors)

# запишем массив значений
list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)

print ' 33[1m' + ' 33[4m' + "Значения коэффициентов a и b:" + ' 33[0m'
print 'a =', round(list_parametres_stoch_gradient_descence[0][0],3)
print 'b =', round(list_parametres_stoch_gradient_descence[0][1],3)
print


print ' 33[1m' + ' 33[4m' + "Сумма квадратов отклонений:" + ' 33[0m'
print round(list_parametres_stoch_gradient_descence[1][-1],3)
print


print ' 33[1m' + ' 33[4m' + "Количество итераций в стохастическом градиентном спуске:" + ' 33[0m'
print len(list_parametres_stoch_gradient_descence[1])
print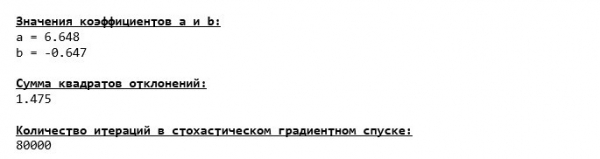
Hodnoty se téměř shodovaly s těmi, které jsme získali při sestupu bez použití NumPy. To je přitom logické.
Zjistíme, kolik času nám stochastické gradientní sestupy zabraly.
Kód pro určení výpočtového času SGD (80 tisíc kroků)
print ' 33[1m' + ' 33[4m' +
"Doba vykonávání stochastického gradientního sestupu bez použití knihovny NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_usual(x_us, y_us, l=0.001, steps = 80000)
print '***************************************'
print

print ' 33[1m' + ' 33[4m' +
"Doba vykonávání stochastického gradientního sestupu s použitím knihovny NumPy:"
+ ' 33[0m'
%timeit list_parametres_stoch_gradient_descence = stoch_grad_descent_numpy(x_np, y_np, l=0.001, steps = 80000)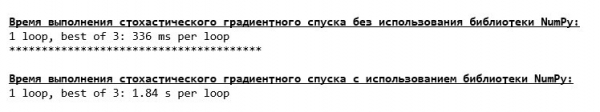
Čím dál do lesa, tím temnější mraky: opět "vlastní" vzorec ukazuje lepší výsledek. To vše vzbuzuje úvahy o tom, že by měly existovat ještě jemnější způsoby využití knihovny NumPy, které skutečně urychlují výpočtové operace. O těchto se v tomto článku již nedozvíme. Bude o čem přemýšlet ve volných chvílích :)
Shrňme to
Než shrneme, rád bych odpověděl na otázku, která určitě vznikla v mysli našeho drahého čtenáře. Proč tedy takové "trýznění" se sestupy, proč chodit po hoře nahoru a dolů (převážně dolů), abychom našli vytouženou nížinu, když máme v rukou tak mocný a jednoduchý nástroj v podobě analytického řešení, které nás okamžitě teleportuje na správné místo?
Odpověď na tuto otázku leží na povrchu. Právě jsme rozebírali velmi jednoduchý příklad, ve kterém je pravá odpověď  závislá na jednom atributu
 . V životě se s takovým často nesetkáme, a proto si představme, že máme 2, 30, 50 nebo více atributů. Přidáme k tomu tisíce, ne-li desítky tisíc hodnot pro každý atribut. V takovém případě může analytické řešení selhat a vyhodit chybu. Naopak gradientní sestup a jeho varianty nás budou pomalu, ale jistě přibližovat k cíli — minimu funkce. A co se týče rychlosti, nebojte se — jistě se ještě zabýváme metodami, které nám umožní nastavovat a regulovat délku kroku (tedy rychlost).
A nyní stručné shrnutí.
Za prvé, doufám, že materiály uvedené v článku pomohou začínajícím „datovým vědcům“ porozumět tomu, jak řešit rovnice jednoduché (a nejen) lineární regrese.
Za druhé jsme si přehledli několik způsobů, jak vyřešit rovnici. Nyní, v závislosti na situaci, si můžeme vybrat ten, který nejlépe vyhovuje k vyřešení daného úkolu.
Za třetí jsme viděli sílu dalších nastavení, konkrétně délky kroku gradientního sestupu. Tento parametr není možné zanedbat. Jak bylo zmíněno výše, s cílem snížit náklady na provádění výpočtů, je vhodné měnit délku kroku během sestupu.
Za čtvrté, v našem případě „vlastní“ funkce vykázaly lepší časové výsledky výpočtů. Pravděpodobně to souvisí s ne zcela profesionálním využitím možností knihovny. NumPy. Ale ať už to bylo jak chce, vyplývá závěr, že na jedné straně je občas dobré zpochybnit ustálené názory, na druhé straně však není vždy vhodné vše zbytečně komplikovat – naopak, někdy se ukazuje, že účinnější je prostší způsob řešení úkolu. A protože naším cílem bylo rozebrat tři přístupy k řešení rovnice jednoduché lineární regrese, bylo nám zcela dostatečné využití „vlastních“ funkcí.
Literatura (nebo něco podobného)
1. Lineární regrese
2. Metoda nejmenších čtverců
3. Derivace
4. Gradient
5. Gradientní sestup
6. Knihovna NumPy
Zdroj: habr.com
