

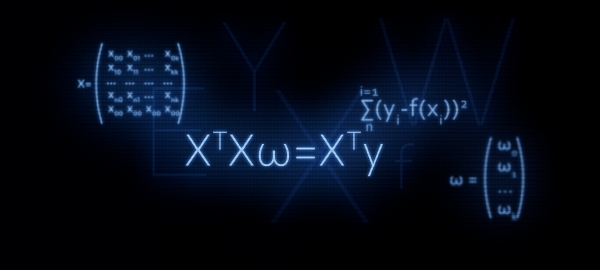
Cílem článku je poskytnout podporu začínajícím datovým vědcům. V těchto příkladech jsme si ukázali tři způsoby řešení rovnice lineární regrese: analytické řešení, gradientní sestup a stochastický gradientní sestup. Pro analytické řešení jsme použili vzorec  . V tomto článku, jak napovídá název, zdůvodníme použití tohoto vzorce, jinými slovy, odvodíme si ho sami.
Proč má smysl věnovat zvýšenou pozornost vzorci  ?
Právě z maticové rovnice většinou začíná seznámení s lineární regresí. Přitom se podrobné výpočty toho, jak byl vzorec odvozen, objevují zřídka.
Například na kurzech strojového učení od Yandexu, když se posluchači seznamují s regularizací, se doporučuje využít funkce z knihovny sklearn, přičemž se nezmiňuje ani slovo o maticovém zobrazení algoritmu. V tuto chvíli může část posluchačů dostat chuť se v této problematice podívat podrobněji — napsat kód bez použití předem připravených funkcí. A k tomu je potřeba nejprve představit rovnici s regularizátorem v maticové podobě. Tento článek právě umožní těm, kteří chtějí získat takové dovednosti. Pojďme na to.
Počáteční podmínky
Cílové ukazatele
Máme řadu hodnot cílového ukazatele. Například cílovým ukazatelem může být cena nějakého aktiva: ropa, zlato, pšenice, dolar atd. Přičemž pod řadou hodnot cílového ukazatele rozumíme počet pozorování. Takovými pozorováními mohou být například měsíční ceny ropy za rok, tedy budeme mít 12 hodnot cílového ukazatele. Začněme zavádět označení. Označme každou hodnotu cílového ukazatele jako  . Celkem máme
 pozorování, takže naše pozorování lze představit jako
 .
Regresory
Budeme považovat, že existují faktory, které do určité míry vysvětlují hodnoty cílového ukazatele. Například na kurz páru dolar/rubl má silný vliv cena ropy, sazba FRS a další. Takové faktory se nazývají regresory. Každé hodnotě cílového ukazatele by mělo odpovídat hodnota regresoru, což znamená, že pokud máme 12 cílových ukazatelů za každý měsíc v roce 2018, pak také musíme mít 12 hodnot regresorů za stejné období. Označíme hodnoty každého regresoru jako  . Předpokládejme, že v našem případě máme
 regresorů (tj.
 faktorů, které mají vliv na hodnoty cílového ukazatele). Naše regresory tedy můžeme představit následujícím způsobem: pro 1. regresor (například cena ropy):
 , pro 2. regresor (například sazba FRS):
 , pro "
 -tý" regresor:

Závislost cílových ukazatelů na regresorech
Předpokládejme, že závislost cílového ukazatele  na regresorech "
 -tého" pozorování může být vyjádřena prostřednictvím rovnice lineární regrese ve tvaru:

, kde  — «
 -té" hodnota regresoru od 1 do
 ,
 — počet regresorů od 1 do

 — úhlové koeficienty, které představují velikost, o kterou se průměrně změní vypočítávaný cílový ukazatel při změně regresoru.
Jinými slovy, pro každý (s výjimkou  ) regresor určíme "svůj" koeficient
 , poté násobíme koeficienty hodnotami regresorů "
 -tého" pozorování, čímž získáme určité přiblížení "
 -tého" cílového ukazatele.
Proto potřebujeme nalézt takové koeficienty  , při kterých budou hodnoty naší aproximační funkce
 umístěny co nejblíže hodnotám cílových ukazatelů.
Hodnocení kvality aproximační funkce
Určíme hodnocení kvality aproximační funkce metodou nejmenších čtverců. Funkce hodnocení kvality v tomto případě nabude následujícího tvaru:

Potřebujeme nalézt takové hodnoty koeficientů $w$, při kterých bude hodnota  co nejmenší.
Převedeme rovnici do maticového tvaru
Vektorové zobrazení
Nejdříve, abychom si usnadnili práci, je třeba se zaměřit na rovnici lineární regrese a všimnout si, že první koeficient  není násobena žádným regresorem. Přitom, když data převedeme do maticové podoby, výše uvedená okolnost značně zkomplikuje výpočty. V této souvislosti navrhujeme zavést ještě jeden regresor pro první koeficient
 a přiradit mu hodnotu jedna. Přesněji, každou "
 -tou" hodnotu tohoto regresoru přiradit jedné — vždyť při násobení jedničkou se nám z hlediska výsledku výpočtů nic nezmění, zatímco z pohledu pravidel maticového násobení, významně zjednoduší naše mučení.
Nyní, na nějaký čas, s cílem zjednodušit materiál, předpokládejme, že máme pouze jedno " -té" pozorování. Poté si představme hodnoty regresorů "
 -tého" pozorování jako vektor
 . Vektor
 má rozměrnost
 , to znamená
 řádků a 1 sloupec:

Hledané koeficienty si představme ve formě vektoru  , který má rozměrnost
 :

Rovnice lineární regrese pro " -té" pozorování nabude tvaru:

Funkce hodnocení kvality lineárního modelu nabude tvaru:

Všimněte si, že v souladu s pravidly maticového násobení, bylo nutné transponovat vektor  .
Maticová reprezentace
V důsledku násobení vektorů získáme číslo:  , což jsme očekávali. Toto číslo je aproximací "
 -tého" cílového ukazatele. Ale my potřebujeme aproximaci nikoliv jednoho hodnoty cílového ukazatele, ale všech. K tomu zapíšeme všechny "
 -té" regresory ve formátu matice
 . Získaná matice má rozměrnost
 :

Nyní rovnice lineární regrese nabude tvaru:

Označme hodnoty cílových ukazatelů (všechny  ) za vektor
 o rozměrnosti
 :

Nyní můžeme napsat v maticovém formátu rovnici hodnocení kvality lineárního modelu:

Vlastně, z tohoto vzorce dále získáváme nám známý vzorec 
Jak to děláme? Rozvíjejí se závorky, provádí se diferenciace, transformují se získané výrazy atd., a tím se nyní budeme zabývat.
Maticové transformace
Rozvineme závorky


Připravíme rovnici pro diferenciaci
K tomu provedeme některé transformace. V následujících výpočtech bude pohodlnější, pokud bude vektor  představován na začátku každého součinu v rovnici.
Transformace 1

Jak se to stalo? Abychom na tuto otázku odpověděli, stačí se podívat na rozměry násobených matic a vidět, že na výstupu dostáváme číslo, nebo jinak,  .
Zapíšeme rozměry maticových výrazů.


Transformace 2

Zapišme obdobně jako u transformace 1


Na výstupu dostáváme rovnici, kterou budeme muset diferencovat:

Diferencujeme funkci hodnocení kvality modelu
Diferencujeme podle vektoru  :


Otázek proč  by nemělo být, ale operace při určování derivací ve dvou dalších výrazech podrobněji prozkoumáme.
Diferencování 1
Otevřeme diferencování: 
Abychom určili derivaci matice nebo vektoru, musíme se podívat, co je uvnitř. Díváme se:


Označme součin matic  přes matici
 . Matice
 je čtvercová a navíc symetrická. Tyto vlastnosti se nám budou hodit dále, zapamatujme si je. Matice
 má rozměrnost
 :

Nyní je naším úkolem správně násobit vektory s maticí a nezískat "dva krát dva pět", takže se soustředíme a budeme maximálně opatrní.


Nicméně, máme složitý výraz! Ve skutečnosti jsme dostali číslo — skalár. A teď přecházíme k diferenciaci. Musíme najít derivaci získaného výrazu podle každého koeficientu  a na výstupu dostat vektor s rozměrem
 . Pro jistotu popíšu postupy po jednotlivých krocích:
1) diferencujeme podle  , dostaneme:

2) diferencujeme podle  , dostaneme:

3) diferencujeme podle  , dostaneme:

Na výstupu — slíbený vektor o velikosti  :

Pokud se na vektor podíváte pozorněji, můžete si všimnout, že levé a odpovídající pravé prvky vektoru lze uspořádat tak, že nakonec z předloženého vektoru můžeme vyčlenit vektor  velikosti
 . Například,
 (levý prvek horního řádku vektoru)
 (pravý prvek horního řádku vektoru) lze představit jako
 , a
 — jako
 atd. pro každý řádek. Uskupíme:

Vyneseme vektor  a na výstupu dostaneme:

Nyní se podívejme na získanou matici. Matice je součtem dvou matic  :

Vzpomněli jsme si, že jsme před chvílí zmínili jednu důležitou vlastnost matice  — je symetrická. Na základě této vlastnosti můžeme s jistotou prohlásit, že výraz
 se rovná
 . To lze snadno ověřit, když otevřeme prvek po prvku součin matic.
 Nebudeme to zde dělat, ti, kdo chtějí, mohou provést kontrolu sami.
Vrátíme se k našemu výrazu. Po našich transformacích vypadá tak, jak jsme chtěli, aby vypadal:

Takže prvního diferenciování jsme se úspěšně zhostili. Přecházíme k druhému výrazu.
Diferencování 2

Půjdeme po vyšlapané cestě. Bude mnohem kratší než ta předchozí, takže se nedávejte příliš daleko od obrazovky.
Rozložíme po jednotlivých prvcích vektory a matici:


Na chvíli odstraníme ze výpočtů dvojku — ta zde nehraje žádnou roli, pak ji vrátíme na místo. Vynásobíme vektory maticí. Nejdříve vynásobíme matici  vektorem
 , zde nemáme žádná omezení. Dostaneme vektor velikosti
 :

Provedeme další akci — vynásobíme vektor  přijatým vektorem. Na výstupu nás čeká číslo:

To je to, co budeme diferencovat. Na výstupu získáme vektor dimenze  :

Něco vám to připomíná? Správně! To je součin matice  vektorem
 .
Tímto způsobem jsme úspěšně dokončili druhé diferenciování.
Na závěr
Nyní víme, jak vzniklo rovnost  .
Nakonec popíšeme rychlou cestu transformací základních vzorců.
Odhadneme kvalitu modelu podle metody nejmenších čtverců:


Diferencujeme získaný výraz:


Literatura
Internetové zdroje:
1)
2)
3)
4)
Učebnice, sborníky úloh:
1) Konspekt přednášek z vyšší matematiky: kompletní kurz / D.T. Písmený – 4. vyd. – M.: Iris-press, 2006
2) Aplikovaná regrese / N. Draper, G. Smith – 2. vyd. – M.: Finance a statistika, 1986 (překlad z angličtiny)
3) Úlohy na řešení maticových rovnic:
Zdroj: habr.com
