

Tento článek je druhý v sérii o rychlé kompresi dat. V prvním článku byl popsán kompresor pracující rychlostí 10 GB/s na jedno procesorové jádro (minimální komprese, RTT-Min).
Tento kompresor byl již implementován do zařízení kriminalistických duplikátorů pro rychlou kompresi dumpingů informačních médií a posílení odolnosti kriptografie; může být také použit pro kompresi obrazů virtuálních strojů a swapových souborů operační paměti při jejich ukládání na vysoce výkonných SSD discích.
V prvním článku byla také oznámena vývoj algoritmu komprese pro kompresi záloh HDD a SSD disků (střední komprese, RTT-Mid) s podstatně vylepšenými parametry komprese. V současnosti je tento kompresor plně připraven a tento článek se na něj zaměřuje.
Kompresor, který implementuje algoritmus RTT-Mid, zajišťuje míru komprese srovnatelnou se standardními archivátory jako WinRar, 7-Zip, které pracují v rychlém režimu. Přitom jeho rychlost práce je minimálně o pořádek vyšší.
Rychlost balení/rozbalování dat je kritickým parametrem určujícím oblast použití technologií komprese. Nevím, kdo by měl na mysli komprimovat terabajt dat rychlostí 10-15 megabajtů za sekundu (právě tato rychlost archivačních programů v standardním režimu komprese), neboť to by trvalo téměř dvacet hodin při plném využití procesoru…
Na druhé straně může být stejný terabajt zkopírován rychlostmi okolo 2-3 gigabajtů za sekundu za deset minut.
Proto je komprese velkého objemu informací relevantní, pokud se provádí rychlostí, která není nižší než rychlost reálného vstupu/výstupu. Pro moderní systémy to znamená alespoň 100 megabajtů za sekundu.
Takové rychlosti mohou moderní kompresory dosahovat pouze v režimu „fast“. V tomto aktuálním režimu budeme porovnávat algoritmus RTT-Mid s tradičními kompresory.
Srovnávací testování nového algoritmu komprese
Kompresor RTT-Mid fungoval v rámci testovacího programu. V reálné „pracovní“ aplikaci pracuje výrazně rychleji, neboť je zde zdatně využívána vícevláknová architektura a používá se „normální“ kompilátor, nikoliv C#.
Jelikož srovnávané kompresory fungují na různých principech a různých typech dat se komprimuje různě, pro objektivitu testu byla použita metoda měření „průměrné teploty po nemocnici“…
Byl vytvořen soubor se sektorovým dumpem logického disku s operačním systémem Windows 10, což je nejpřirozenější směs různých datových struktur, která se vyskytuje na každém počítači. Komprese tohoto souboru umožní porovnání rychlosti a míry komprese nového algoritmu s nejpokročilejšími kompresory používanými v moderních archivačních nástrojích.
Toto je soubor dumpu:
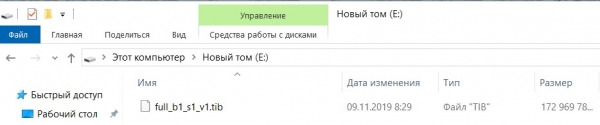
Soubor dumpu byl komprimován kompresory RTT-Mid, 7-zip a WinRar. Kompresor WinRar a 7-zip byly nastaveny na maximální pracovní rychlost.
Kompresor pracuje 7-zip:
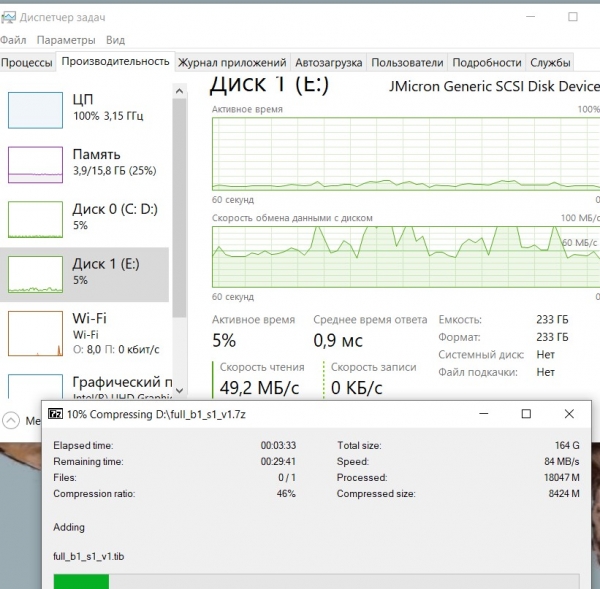
Zatěžuje procesor na 100 %, přičemž průměrná rychlost čtení zdrojového dumpu je přibližně 60 MegaBajtů/sec.
Kompresor pracuje WinRar:
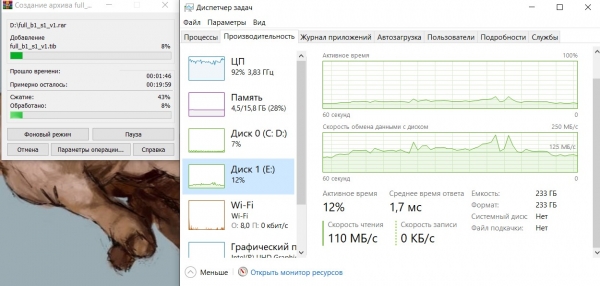
Situace je obdobná, zatížení procesoru téměř 100 %, průměrná rychlost čtení dumpu přibližně 125 MegaBajtů/sec.
Stejně jako v předchozím případě je rychlost práce archivačního nástroje omezena možnostmi procesoru.
Nyní pracuje testovací program kompresoru RTT-Mid:
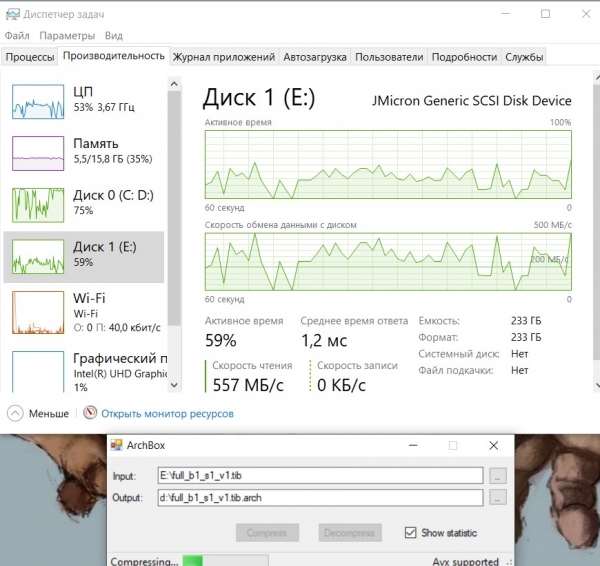
Screenshot ukazuje, že procesor je zatížen na 50 % a zbytek času je nečinný, protože nemá kam uvolnit komprimovaná data. Disk pro uvolnění dat (Disk 0) je téměř plně zatížen. Rychlost čtení dat (Disk 1) silně kolísá, ale v průměru je přes 200 MegaBajtů/sec.
Rychlost práce kompresoru je v tomto případě omezena možností zápisu komprimovaných dat na Disk 0.
Nyní míra komprese získaných archivů:
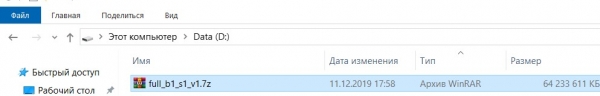
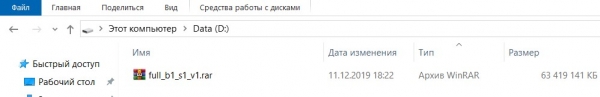
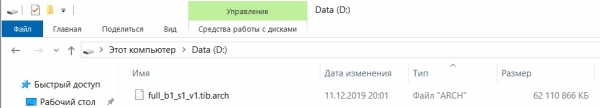
Je zřejmé, že kompresor RTT-Mid si vedl nejlépe v kompresi, archív, který vytvořil, je o 1,3 GigaBajtu menší než archív WinRar a o 2,1 GigaBajtu menší než archív 7z.
Čas potřebný na vytvoření archivu:
- 7-zip – 26 minut 10 sekund;
- WinRar – 17 minut 40 sekund;
- RTT-Mid – 7 minut 30 sekund.
Takže i testovací, neoptimalizovaný program, používající algoritmus RTT-Mid, dokázal vytvořit archív více než dvakrát a půlkrát rychleji, přičemž archív byl výrazně menší než u konkurentů…
Ti, kdo nevěří screenshotům, si mohou ověřit jejich pravost sami. Testovací program je k dispozici na , stáhněte si jej a ověřte.
Ale pouze na procesorech s podporou AVX-2, bez podpory těchto instrukcí kompresor nefunguje a netestujte algoritmus na starších procesorech AMD, těch je pomalé v části provádění příkazů AVX…
Použitá metoda komprese
V algoritmu se používá metoda indexace opakujících se fragmentů textu v bajtové granulaci. Tento způsob komprese je známý již dlouho, ale nebyl používán, protože operace vyhledávání shod byla velmi nákladná na potřebné zdroje a vyžadovala mnohem více času než vytváření slovníku. Takže algoritmus RTT-Mid je klasickým příkladem pohybu "zpátky do budoucnosti"…
V kompresoru RTT se používá unikátní rychlostní skener pro vyhledávání shod, který umožnil urychlit proces komprese. Skener vyrobený na zakázku, to je "moje vzácnost…", "cena je nemalá, protože je zcela ruční výroba" (napsaný v assembleru).
Skener pro vyhledávání shod funguje na základě dvoustupňového pravděpodobnostního schématu, nejprve se skenuje přítomnost "znaku" shody, a teprve po zjištění "znaku" na tomto místě se spouští procedura detekce skutečné shody.
Okno pro hledání shod má nepředvídatelnou velikost, která závisí na míře entropie v zpracovávaném bloku dat. Pro zcela náhodná (nekomprimovatelná) data má velikost megabajtu, pro data s opakováními má vždy velikost větší než megabajt.
Ale mnohé moderní datové formáty jsou nekomprimovatelné a "pouštět" skrze ně zdroje náročný skener je zbytečné a plýtvání, proto se ve skeneru používají dva režimy práce. Nejprve se hledají části původního textu s možnými opakováními, tato operace se provádí také pravděpodobnostním způsobem a provádí se velmi rychle (při rychlosti 4-6 Gigabajtů/s). Poté se části s možnými shodami zpracovávají hlavním skenerem.
Indexové komprese není příliš efektivní, musíme nahrazovat opakující se fragmenty indexy, a indexová matice výrazně snižuje koeficient komprese.
Pro zvýšení stupně komprese se indexují nejen úplné shody bajtových řetězců, ale i částečné, kdy v řetězci jsou jak shodné, tak i neshodné bajty. Pro tento účel je do formátu indexu zahráno pole masky shod, které ukazuje na shodné bajty dvou bloků. Pro ještě větší kompresi se používá indexace s překrýváním několika částečně shodných bloků na aktuální blok.
To vše umožnilo v kompresoru RTT-Mid dosáhnout stupně komprese srovnatelného s kompresory pracujícími na základě slovníkové metody, avšak fungujícího mnohem rychleji.
Rychlost nového algoritmu komprese
Pokud kompresor pracuje s monopolním využitím paměti cache (na jeden proud je potřeba 4 MegaBajty), rychlost práce se pohybuje v rozmezí 700-2000 MegaBajtů/s na jedno procesorové jádro v závislosti na typu komprimovaných dat a málo závisí na pracovních frekvencích procesoru.
Při vícestupňové implementaci kompresoru se efektivní škálovatelnost určuje objemem mezipaměti třetí úrovně. Například při 9 MegaBajtech mezipaměti nemá smysl spouštět více než dva proudy komprese, rychlost od toho vzrůstat nebude. Avšak při mezipaměti o velikosti 20 MegaBajtů lze již spouštět pět proudů komprese.
Také významným parametrem určujícím rychlost práce kompresoru se stává latence operační paměti. Algoritmus používá náhodné přístupy k operační paměti, část z nichž se nedostává do mezipaměti (asi 10%) a musí čekat na data z operační paměti, což snižuje rychlost práce.
Významně ovlivňuje rychlost kompresoru také práce systému vstupu/výstupu dat. Požadavky na operační paměť ze vstupu/výstupu blokují přístupy k datům ze strany CPU, což také snižuje rychlost komprese. Problém je významný pro notebooky a desktope. servery Pro ně je to méně významné díky pokročilejšímu řídicímu bloku přístupu k systémové sběrnici a víc kanálové operační paměti.
V celém textu článku se hovoří o kompresi, dekomprese zůstává mimo rámec tohoto článku, protože tam „je všechno v pořádku“. Dekomprese probíhá výrazně rychleji a je omezena rychlostí vstupu/výstupu. Jedno fyzické jádro v jednom vlákně může bez problémů zajistit rychlosti rozbalování na úrovni 3-4 gigabajtů/s.
To souvisí s absencí v procesu rozbalování operace vyhledávání shod, která „spotřebovává“ hlavní zdroje procesoru a cache paměti při kompresi.
Spolehlivost uchovávání komprimovaných dat
Jak vyplývá z názvu celé třídy softwarových prostředků využívajících kompresi dat (archivátory), jsou určeny pro dlouhodobé uchovávání informací, ne na roky, ale na století a tisíciletí…
Během doby uchovávání nosiče informace ztrácejí část dat, tady je příklad:
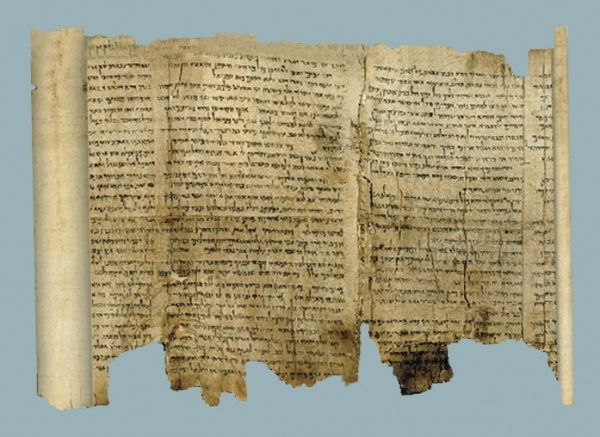
Tomuto „analogovému“ nosiči informace je tisíc let, některé fragmenty jsou ztraceny, ale celkově je informace „čitelná“…
Žádný z odpovědně hospodařících výrobců moderních digitálních systémů pro uchovávání dat a digitálních nosičů k nim neposkytuje záruky úplného zachování dat déle než 75 let.
A to je problém, ale problém odložený, řešit ho budou naši potomci…
Systémy uchovávání digitálních dat mohou ztrácet data nejen po 75 letech, chyby v datech se mohou objevit kdykoli, dokonce i během jejich zápisu, tyto zkreslení se snaží minimalizovat pomocí redundantnosti a opravnými systémy. Redundantnost a opravné systémy mohou ztracené informace obnovit ne vždy, a pokud je obnoví, není zaručeno, že operace obnovy proběhla správně.
A to je také velký problém, ale ne odložený, ale aktuální.
Moderní kompresory používané pro archivaci digitálních dat jsou postaveny na různých modifikacích slovníkové metody a pro takové archivy ztráta fragmentu informace bude fatální událostí, existuje dokonce ustálený termín pro takovou situaci — „poškozený“ archiv…
Nízká spolehlivost ukládání informací v archivech se slovníkovým kompresním algoritmem souvisí se strukturou komprimovaných dat. Informace v takovém archivu neobsahují původní text, uchovávají se tam čísla záznamů ve slovníku, který se dynamicky modifikuje aktuálně komprimovaným textem. Při ztrátě nebo poškození fragmentu archivu není možné identifikovat žádné další záznamy archivu ani podle obsahu, ani podle délky záznamu ve slovníku, protože není jasné, co odpovídá číslu záznamu ve slovníku.
Obnovit informace z takového „poškozeného“ archivu není možné.
Algoritmus RTT je postaven na základě spolehlivější metody ukládání komprimovaných dat. Používá indexovou metodu pro sledování opakujících se fragmentů. Tento přístup k kompresi minimalizuje důsledky poškození informací na médiu a v mnoha případech automaticky opravuje poškození vzniklá během ukládání informací.
To je dáno tím, že archivní soubor v případě indexové komprese obsahuje dvě pole:
- pole původního textu s odstraněnými částmi opakování;
- pole indexů.
Kriticky důležité pro obnovu informací, pole indexů, není velké co do velikosti a lze je duplikovat pro zvýšení spolehlivosti ukládání dat. Proto, i když dojde ke ztrátě fragmentu původního textu nebo indexového pole, všechny ostatní informace budou obnovitelné bez problémů, jako na obrázku s „analogovým“ nosičem informací.
Nevýhody algoritmu
Žádné výhody nejsou bez nevýhod. Indexová metoda komprese nekomprimuje opakující se sekvence malé délky. To souvisí s omezeními indexové metody. Indexy mají velikost nejméně 3 bajty a mohou mít velikost až 12 bajtů. Pokud se objeví opakování s menší velikostí, než jakou popisuje jeho index, nebude zohledněno, bez ohledu na to, jak často se taková opakování v komprimovaném souboru vyskytují.
Tradiční, slovní metoda komprese účinně zmenšuje opakování krátkých sekvencí a dosahuje tak vyššího stupně komprese než indexová komprese. Toho je však dosaženo za cenu vysokého zatížení centrálního procesoru; aby slovní metoda začala efektivněji komprimovat data než indexová metoda, musí zpomalit zpracování dat na 10-20 megabajtů za sekundu na reálných výpočetních instalacích při plném zatížení CPU.
Takto nízké rychlosti jsou nepřijatelné pro moderní systémy ukládání dat a představují spíše "akademický" zájem než praktický.
Stupeň komprese informací bude v následující modifikaci algoritmu RTT (RTT-Max) podstatně zvýšen, je již ve fázi vývoje.
Takže, jak je vždy zvykem, pokračování následuje…
Zdroj: habr.com
