

Ahoj všem. Níže je uveden přehled .
– systém monitorování různých systémů a služeb, pomocí kterého mohou systémoví administrátoři shromažďovat informace o aktuálních parametrech systémů a nastavovat upozornění na odchylky v jejich fungování.
V prezentaci bude srovnání a — projektů pro dlouhodobé ukládání metrik Prometheus.
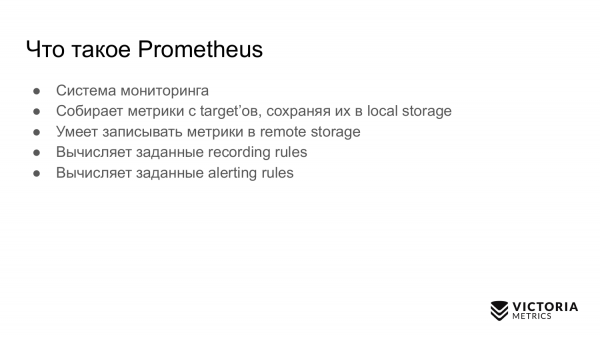
Nejprve se zmíním o Prometheus. Je to systém monitorování, který shromažďuje metriky z daných targetů a ukládá je do místního úložiště. Prometheus umí zapisovat metriky do vzdáleného úložiště, generuje alerty a recording rules.
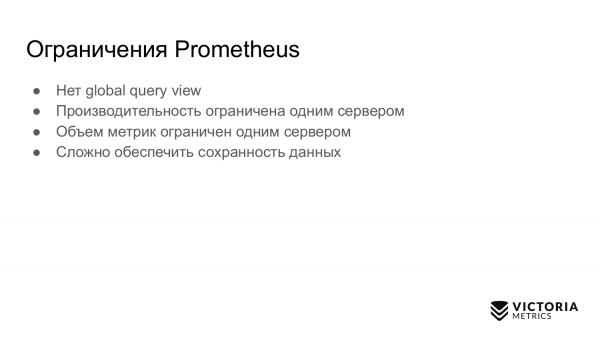
Omezení Prometheus:
- Nemá globální pohled na dotazy. To je situace, kdy máte několik nezávislých instancí Prometheus. Ty shromažďují metriky a vy chcete provést dotaz nad všemi těmito metrikami shromážděnými z různých instancí. Prometheus to neumožňuje.
- U Prometheus je výkon omezen pouze jedním serverem. Prometheus se automaticky nemůže škálovat na více serverů. Můžete pouze ručně rozdělit své targety mezi několik instancí Prometheus.
- Objem metrik v Prometheus je omezen pouze jedním serverem ze stejného důvodu, proč se automaticky nemůže škálovat na více serverů.
- V Prometheus není jednoduše možné zajistit ochranu dat.
Jaké jsou řešení těchto problémů/úkolů?
Řešení jsou následující:
Všechny tyto řešení jsou určena pro vzdálené ukládání dat shromážděných Prometheus. Řeší problém vzdáleného ukládání z předchozího slidu různými způsoby. V této prezentaci se zmíním pouze o prvních dvou řešeních: a .
Poprvé se informace o objevila na . Tam je popsána architektura a jak funguje.
Thanos bere data, která Prometheus uložil na místní disk, a kopíruje je do S3, do nebo do jiného objektového úložiště.
Tímto způsobem Thanos zajišťuje globální pohled na dotazy. Můžete dotazovat data uložená v objektovém úložišti z několika instancí Prometheus.
Thanos podporuje PromQL a .
Thanos používá kód Prometheus pro ukládání dat.
Thanos vyvíjejí stejní vývojáři, kteří vyvinuli Prometheus.
O . Tady , kde jsme poprvé hovořili o .
VictoriaMetrics přijímá data z několika Prometheus pomocí protokolu, který podporuje Prometheus.
VictoriaMetrics poskytuje globální přehled dotazů, protože více instancí Promethea může zapisovat data do jedné instance VictoriaMetrics. Můžete tedy provádět dotazy na všechna tato data.

VictoriaMetrics také podporuje PromQL a Prometheus querying API, stejně jako Thanos.
Na rozdíl od Thanosu byl zdrojový kód VictoriaMetrics napsán od nuly a optimalizován na rychlost a spotřebu zdrojů.
VictoriaMetrics se na rozdíl od Thanosu škáluje jak vertikálně, tak horizontálně. Existuje která se škáluje vertikálně. Můžete začít s jedním procesorem a 1 GB paměti a postupně růst až na stovky procesorů a 1 TB paměti. VictoriaMetrics umí využít všechny tyto zdroje. Její výkon vzroste přibližně 100x ve srovnání s 1-jádrovým systémem.
Příběh Thanosu začal v listopadu 2017, kdy byl vydán první veřejný commit. Předtím byl Thanos vyvíjen uvnitř společnosti .
V červnu 2019 došlo k významnému vydání 0.5.0, ve kterém protokol. Tento protokol byl odstraněn z Thanosu, protože se neosvědčil. Často klastr Thanos nefungoval správně a uzly se k němu nesprávně připojovaly kvůli gossip protokolu. Proto bylo rozhodnuto jej odstranit. Považuji to za správné rozhodnutí.
Téhož června 2019 jsme podali žádost číslo v .
A o pár měsíců později byl Thanos přijat do , do které patří Prometheus, Kubernetes a další populární projekty.
V lednu 2018 začal vývoj VictoriaMetrics.
V září 2018 jsem poprvé veřejně zmínil VictoriaMetrics.
V prosinci 2018 byla zveřejněna verze Single-node.
V květnu 2019 zdrojové kódy jak verze Single-node, tak klustrové verze.
V červnu 2019 jsme, stejně jako Thanos, podali žádost do CNCF foundation pod číslem . Podali jsme žádost o den dříve než Thanos.
Bohužel nás však dosud nepřijali. Potřebujeme pomoc komunity.
Podívejme se na nejdůležitější slajdy ukazující architekturu Thanos a VictoriaMetrics.
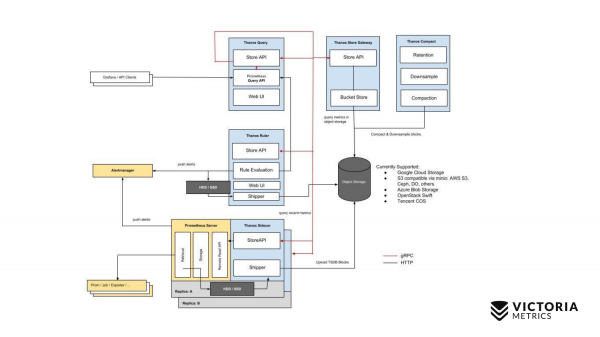
Začněme s Thanos. Žluté komponenty jsou komponenty Promethea. Vše ostatní jsou komponenty Thanos. Začneme s nejdůležitější komponentou. Thanos Sidecar je komponenta, která je nainstalována vedle každého Promethea. Zajišťuje, že přenáší data Promethea z lokálního úložiště do S3 nebo do jiného objektového úložiště.
Existuje také komponent jako Thanos Store Gateway, který dokáže číst tato data z Object Storage při příchozích požadavcích od Thanos Query. Thanos Query implementuje PromQL a Prometheus API. To znamená, že z vnějšího pohledu vypadá jako Prometheus. Přijímá požadavky PromQL, posílá je do Thanos Store Gateway, která získává potřebná data z Object Storage a posílá je zpět.
Ale máme v Object Storage uložena data bez posledních dvou hodin vzhledem k povaze implementace Thanos Sidecar, který nemůže nahrát poslední dvě hodiny do Object Storage S3, protože pro tyto dvě hodiny Prometheus ještě nevytvořil soubory v místním úložišti.
Jak se to tedy podařilo obejít? Thanos Query kromě požadavků do Thanos Store Gateway zároveň posílá požadavky do každého Thanos Sidecar, který se nachází poblíž Prometheus.
A Thanos Sidecar zase směruje požadavky dál do Prometheus a získává data za poslední dvě hodiny.
Kromě těchto komponent existuje také volitelný komponent, bez kterého se Thanos nebude cítit dobře. Je to Thanos Compact, který se zabývá slučováním malých souborů v Object Storage do větších souborů, které byly nahrány Thanos Sidecar. Thanos Sidecar nahrává soubory s daty za dvě hodiny. Pokud se tyto soubory neslučují do větších souborů, jejich počet může výrazně vzrůst. Čím více takových souborů, tím více paměti potřebuje Thanos Store Gateway, tím více zdrojů je potřeba pro přenos dat v síti, metadat. Práce Thanos Store Gateway se stává neefektivní. Proto je nezbytné spustit Thanos Compact, který slučuje malé soubory do větších, aby bylo méně takových souborů a aby se snížil overhead na Thanos Store Gateway.
Existuje také komponent jako Thanos Ruler. Provádí pravidla upozornění Prometheus a může vypočítávat pravidla nahrávání Prometheus, aby opět zapisoval data do Object Storage. Ale tato komponenta se nedoporučuje používat, protože .
Toto je jednoduchá schéma Thanos.
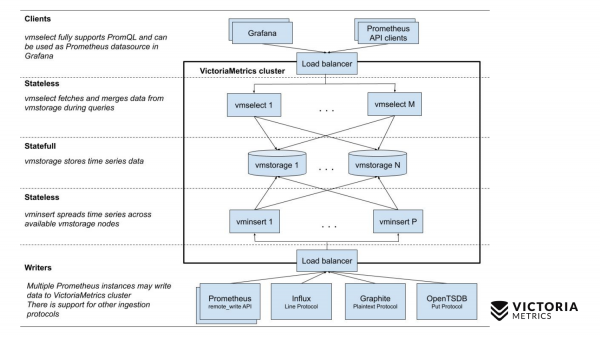
Nyní porovnejme s diagramem VictoriaMetrics.
VictoriaMetrics má 2 verze: Single-node a clusterovou verzi. Single-node běží na jednom počítači. V Single-node nejsou tyto komponenty, pouze jeden binární soubor. Tento binární soubor na snímku vypadá jako tento čtverec. Vše, co je uvnitř čtverce, je obsah binárního souboru pro Single-node verzi. Není nutné o něm vědět. Jednoduše spustíte binární soubor — a všechno funguje.
Klastr verze je složitější. Uvnitř ní jsou tři různé komponenty: vmselect, vminsert a vmstorage. Z jejich názvů by mělo být jasné, co každá z nich dělá. Komponenta Insert přijímá data v různých formátech: z Prometheus remote write API, protokolu Influx line, protokolu Graphite a z protokolu OpenTSDB. Komponenta Insert je přijímá, parsuje a rozděluje mezi existující storage komponenty, kde jsou data ukládána. , a také Prometheus querying API, a může být použita jako náhrada Prometheus v Grafana nebo jiných klientech Prometheus API. Select přijímá promql dotazy, parsuje je, načítá potřebná data pro provedení tohoto dotazu z storage uzlů, zpracovává tato data a vrací odpověď.
Porovnejme složitost instalace Thanos a VictoriaMetrics.
Začneme s Thanos. Než začnete pracovat s Thanos, musíte vytvořit bucket v Object Storage, jako je S3 nebo GCS, aby Thanos Sidecar mohl tam zapisovat data.
Poté je pro každý Prometheus potřeba nainstalovat Thanos Sidecar. Předtím nezapomeňte deaktivovat data compaction v Prometheus. Data compaction pravidelně komprimuje data v lokálním úložišti Prometheus, aby se snížila spotřeba zdrojů.
Když instalujete Thanos Sidecar k vašim Prometheusům, musíte tuto data compaction deaktivovat, protože Thanos Sidecar nedokáže správně pracovat při aktivní data compaction. To znamená, že váš Prometheus začne ukládat data po dvou hodinách v blocích a přestane tyto bloky sloučit do větších. Pokud tedy provádíte dotazy, které překračují dobu posledních dvou hodin, nebudou fungovat tak efektivně, jako by mohly, kdyby byla data compaction zapnuta.
Proto Thanos doporučuje zkrátit dobu uchovávání dat (data retention) v místním úložišti na 6-8 hodin, aby se snížil overhead velkého množství malých bloků.
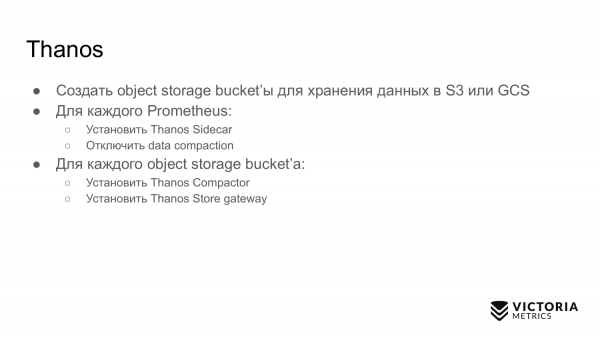
Poté, co nainstalujete Thanos Sidecar, musíte pro každý Object Storage Bucket nainstalovat dva komponenty. To jsou Thanos Compactor a Thanos Store Gateway.
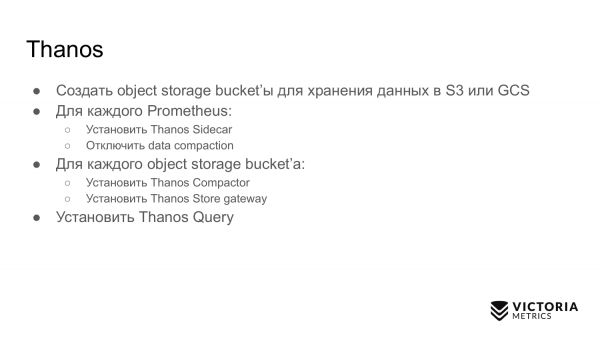
Po této instalaci je třeba nainstalovat Thanos Query a nastavit jej tak, aby mohl připojit ke všem Thanos Store Gateway, které máte, a také se mohl připojit ke všem Thanos Sidecar.
Zde může být malý problém.
Musíte nastavit spolehlivé a bezpečné připojení od Thanos Query k těmto komponentům. A pokud máte Prometheusy v různých datových centrech nebo v různých VPC, je připojení zvenčí na ně zakázáno. Ale pro fungování Thanos Query musíte nějak nastavit připojení tam a musíte vymyslet způsob.
Pokud máte takových datových center hodně, snižuje se tím spolehlivost celého systému. Protože Thanos Query musí neustále udržovat připojení ke všem Thanos Sidecar, které se nachází v různých datových centrech. Při každém příchozím dotazu bude směřovat dotazy na všechny Thanos Sidecar. Pokud se spojení přeruší, obdržíte buď neúplný soubor dat, nebo odpověď "klaster nefunguje".
Ve VictoriaMetrics je to trochu jednodušší. Pro variantu s jedním uzlem stačí spustit jeden binární soubor a všechno funguje.
V klustrové verzi stačí spustit všechny výše zmíněné tři typy komponentů v jakémkoli potřebném množství, nebo použít pro automatizaci spuštění komponentů v Kubernetes. Ještě plánujeme vytvoření operátora pro Kubernetes. Helm chart nepokrývá některé případy a může vám způsobit problémy. Například umožňuje snížit počet storage node, což povede ke ztrátě dat.
Poté, co spustíte jeden binární soubor nebo klustrovou verzi, stačí přidat do konfigurace Prometheus , aby začal zapisovat data paralelně do lokálního úložiště a do vzdáleného úložiště. Jak jste si všimli, taková konfigurace by měla fungovat mnohem spolehlivěji ve srovnání s konfigurací Thanos. Není potřeba udržovat připojení od VictoriaMetrics ke všem Prometheům, protože Prometheové se sami připojují k VictoriaMetrics a předávají data.
Zvažme údržbu Thanos a VictoriaMetrics.
Thanos musí sledovat Sidecar, aby nezastavil nahrávání dat do Object Storage. Může se stát, že nahrávání dat se zastaví kvůli chybám nahrávání, například pokud dojde k dočasnému přerušení síťového spojení s Object Storage, nebo pokud je Object Storage dočasně nedostupný. Thanos Sidecar si toho v tomto okamžiku všimne, nahlásí chybu, může spadnout a poté přestat fungovat. Pokud ho nebudete monitorovat, přestanou se vám data přenášet do Object Storage. Pokud uplyne doba retention (doporučených 6-8 hodin), začnete ztrácet data, která se nedostala do Object Storage.
Thanos compactor-y mohou přestat fungovat kvůli . Compactor-y berou data z Object Storage a spojí je do větších bloků dat. Protože compactor-y nejsou synchronizovány se Sidecar-y, může se stát toto: Sidecar ještě nestačil dopsat blok, Compactor se rozhodne, že tento blok je plně zapsán. Compactor začne blok číst. Čte blok neúplně a přestane fungovat. Viz podrobnosti. .
Store Gateway může podávat nekonzistentní data kvůli race'ům mezi Compactor-em a Sidecar-y. Situace je podobná, protože Store Gateway není nijak synchronizován s Compactor-y a Sidecar-y. Tím pádem mohou nastávat stavy závodění, kdy Store Gateway nevidí část dat nebo vidí nadbytečná data.
Query komponent v Thanos výchozí nastavení vrací částečný výsledek, pokud některé Sidecar-y nebo Store Gateway momentálně nejsou dostupné. Získáte část dat a ani nebudete vědět, že nemáte všechna data. Takto funguje ve výchozím nastavení. V podobné situaci VictoriaMetrics vrací označená data jako částečná.
Na rozdíl od Thanos, VictoriaMetrics zřídka ztrácí data. I když dojde k přerušení připojení z Prometheus k VictoriaMetrics, není to problém, protože Prometheus pokračuje v zapisování nových příchozích dat do Write Ahead Logu, jehož velikost je 2 hodiny. Pokud během dvou hodin obnovíte připojení k VictoriaMetrics, data se neztratí. Prometheus .
Na rozdíl od Thanosu, který zapisuje data do objektového úložiště až po dvou hodinách, Prometheus automaticky replikovat data prostřednictvím protokolu remote write do vzdáleného úložiště, jako je VictoriaMetrics. Ztráta lokálního úložiště v Prometheu vás nemusí děsit. Pokud by náhle ztratil lokální úložiště, v nejhorším případě přijdete o poslední sekundy dat, která se nestihla zapsat do vzdáleného úložiště.
Kubernetes automaticky spravuje cluster na rozdíl od Thanosu. Všechny komponenty Thanosu je obtížné umístit do jednoho Kubernetes clusteru, na rozdíl od clusterových komponent VictoriaMetrics.
Aktualizace na novou verzi VictoriaMetrics je velmi jednoduchá. Stačí zastavit VictoriaMetrics, aktualizovat binární soubory a znovu spustit. Při zastavení signálem SIGINT všechny binární soubory VictoriaMetrics provádějí graceful shutdown. Správně ukládají potřebná data a správně uzavírají příchozí připojení, aby nic neztratili. Proto při aktualizaci o nic nepřijdete.
VictoriaMetrics usnadňuje rozšiřování clusteru. Stačí přidat potřebné komponenty a pokračovat v práci.
O úskalích v Thanosu a VictoriaMetrics.
Thanos má následující úskalí. Prometheus musí uchovávat data za poslední dvě hodiny. Pokud se ztratí, přijdete o ně, protože se ještě nestihla zapsat do objektového úložiště, jako je S3.
Komponent Store Gateway a komponent compactor mohou vyžadovat hodně paměti pro práci s velkým objektovým úložištěm, pokud je tam uchováváno mnoho malých souborů. Čím více souborů a jejich objem, tím více operační paměti Store Gateway a compactor potřebují pro ukládání metainformací. Thanos má mnoho problémů týkajících se toho, že .
Thanos se propaguje, že může neomezeně škálovat počet vašich Prometheů. Ve skutečnosti to není pravda. Všechny dotazy procházejí přes komponent Query, který musí paralelně dotázat všechny komponenty Store Gateway a všechny komponenty Sidecar, získat odtud data a následně je předzpracovat. Je zřejmé, že rychlost dotazů je omezena nejpomalejším slabým článkem, nejpomalejší komponentou Store Gateway nebo nejpomalejším Sidecarem.
Tyto komponenty mohou být zatíženy nerovnoměrně. Například máte Prometheus, který shromažďuje miliony metrik za sekundu. A pak je zde Prometheus, kterému se shromažďují tisíce metrik za sekundu. Prometheus, který shromažďuje miliony metrik za sekundu, výrazně zatěžuje server, na kterém běží. Proto Sidecar tam pracuje pomaleji. A vůbec vše tam funguje pomalu. A Query komponent bude velmi pomalu získávat data. Proto výkonnost celého vašeho clusteru bude omezena tímto pomalým Sidecarem.
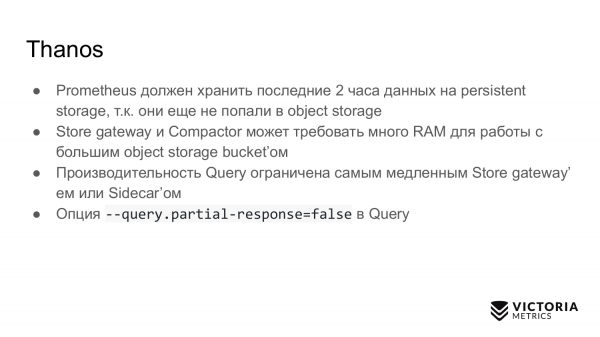
Ve výchozím nastavení Thanos vrací částečná data, pokud jsou některé Sidecary nebo Store Gateway nedostupné. Například pokud máte Sidecary rozeseté po celém světě v různých datových centrech, pravděpodobnost přerušení spojení a nedostupnosti komponent značně roste. Proto v mnoha případech budete získávat částečná data, aniž byste o tom věděli.
VictoriaMetrics má také své úskalí. Prvním úskalím je možnost, která omezuje objem operační paměti používané pro cache u VictoriaMetrics. Ve výchozím nastavení je to 60 % operační paměti na stroji, na kterém je VictoriaMetrics spuštěna, nebo 60 % RAM podu VictoriaMetrics v Kubernetes.
Pokud toto nastavení nesprávně změníte, můžete výrazně zhoršit výkon VictoriaMetrics. Například pokud nastavíte příliš nízkou hodnotu, data se mohou přestat vejdou do cache VictoriaMetrics. To znamená, že bude muset vykonávat zbytečné úkoly a zatěžovat procesor s diskem. Pokud tuto možnost nastavíte příliš vysoko, zvyšuje to jednak pravděpodobnost, že VictoriaMetrics způsobí chybu „out of memory“, a jednak to povede k tomu, že v operačním systému bude zbývat velmi málo operační paměti pro souborovou cache. A VictoriaMetrics se spoléhá na souborovou cache pro svůj výkon. Pokud je jí málo, může výrazně vzrůst zátěž na disk. Proto doporučení: neměňte tuto hodnotu bez naléhavé potřeby.
Druhá možnost. Toto retentionPeriod — období, které je ve výchozím nastavení nastaveno na 1 měsíc. Toto je doba, po kterou VictoriaMetrics uchovává data. Po uplynutí této doby VictoriaMetrics data maže.
Mnozí spouštějí VictoriaMetrics bez tohoto parametru, zaznamenávají data po dobu jednoho měsíce. A pak se ptají: proč data zmizela za předchozí měsíc? Protože retentionPeriod je ve výchozím nastavení nastaven na 1 měsíc. Proto je třeba znát a nastavit správný retentionPeriod.
Projdeme si unikátní možnosti.
Thanos má funkci zvanou downsampling: 5minutové a hodinové intervaly, které často . Pokud to vyhledáte a podíváte se na jejich problémy na githubu, je tam spousta problémů souvisejících s tímto downsamplingem, což někdy nefunguje správně nebo nefunguje tak, jak uživatelé očekávají.
Thanos má deduplikaci dat pro páry Prometheus HA. Když dva Prometheové sbírají stejné metriky ze stejných targetů a Thanos je ukládá do Object Storage. Thanos dokáže správně deduplikovat tato data, na rozdíl od VictoriaMetrics.
Thanos má komponentu alert, která byla na schématu Thanos. Ale .
Thanos má výhodu, že kód Thanos a Prometheus je společný. Thanos a Prometheus jsou vyvinuty těmi samými vývojáři. Při vylepšeních v Thanosu nebo Prometheovi vyhrává druhá strana.
Hlavní funkcí VictoriaMetrics je MetricsQL. To je rozšíření VictoriaMetrics pro PromQL, o kterém jsem mluvil na předchozím big monitoring meetupu.
VictoriaMetrics podporuje upload dat podle mnoha různých protokolů. VictoriaMetrics může nejen přijímat data od Prometheus, ale také podle protokolů Influx, OpenTSDB a Graphite.
Data ve VictoriaMetrics zabírají obvykle mnohem méně místa ve srovnání s Thanos a Prometheus.
Pokud zapisujete skutečná data, uživatelé hovoří o 2-5násobném zmenšení velikosti dat na disku ve srovnání s Prometheus a Thanos.
Další výhodou VictoriaMetrics je, že je optimalizována pro rychlost.
Projdeme si náklady infrastruktury.
Jednou z výhod Thanos je, že ukládá data do object storage, které je relativně levné.
Při ukládání dat do object storage musíte platit za operace zápisu a čtení dat (10 $ za milion operací). Když zapisujete data do object storage, platíte náklady svého hostingu na nahrávání dat do internetu, pokud váš cluster není v AWS — tam je to zdarma. Když čtete data, platíte od 10 do 230 $ za 1 TB. To může být významné, pokud často vyžadujete historická data z Thanos clusteru.
Pro Thanos klastr je třeba platit servery pro komponenty Compact, Store Gateway a Query, které vyžadují hodně paměti a CPU pro zpracování velkých objemů dat.
Náklady pro VictoriaMetrics jsou následující. Pokud uchováváte data na HDD discích GCE, vyjde to na 40 $ za 1TB. Pro VictoriaMetrics stačí běžné HDD disky, nepotřebujete žádné SSD, které jsou alespoň pětkrát dražší. VictoriaMetrics je optimalizována pro HDD.
Pro VictoriaMetrics potřebujete servery pro komponenty: buď Single-node nebo pro clusterové komponenty, které na rozdíl od Thanos komponentů vyžadují mnohem méně CPU a RAM — což tedy znamená nižší náklady.
Příklady implementací.
Příkladem implementace pro Thanos je Gitlab. Gitlab plně běží na Thanos. Ale není to zcela bez problémů. Když se podíváte na jejich , můžete vidět, že mají neustále nějaké : nedostatek paměti pro Store Gateway nebo Query komponenty. Neustále musí zvyšovat objem paměti.
Tím se zvyšují náklady na řešení těchto problémů.
Druhá implementace, která by mohla být úspěšnější — je společnost Improbable, která začala vývoj Thanos. Publikovali zdrojové kódy Thanosu. Improbable je společnost, která se zabývá vývojem herních enginů.
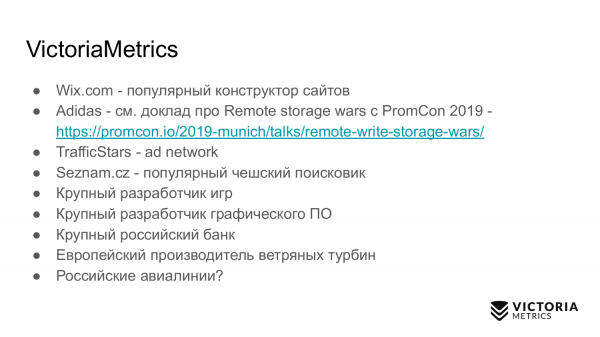
Veřejné příklady implementace pro VictoriaMetrics jsou:
- wix.com, tvůrce webových stránek
- Adidas implementuje VictoriaMetrics a dokonce na posledním PromCon 2019 prezentovali.
- TrafficStars — reklamní síť
- Seznam.cz — populární český vyhledávač.
A pak jsou tu společnosti bez jména, které nyní nemohu nazvat. Nedali souhlas.
- Jedno velké herní studio. Větší než Improbable.
- Velký vývojář grafického softwaru.
- Velká ruská banka.
- Evropský výrobce větrných turbín, který úspěšně otestoval VictoriaMetrics. Tento výrobce implementuje VictoriaMetrics pro monitorování dat z větrných turbín s frekvencí 50 vzorků za sekundu na každý senzor. Každá větrná turbína má několik set senzorů. Mají několik set větrných turbín.
- Ruské aerolinky, které chtějí implementovat VictoriaMetrics, ale stále to nemohou dotáhnout do konce. Jsme ve fázi smlouvy.
 Závěry.
VictoriaMetrics a Thanos řeší podobné úkoly, ale různými způsoby:
- Globální pohled na dotazy
- horizontální škálování
- libovolná doba uchovávání
Děkuji.
Těšíme se na vás na našem .
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Co používáte jako long term storage pro Prometheus?
35,3%Thanos6
0,0%Cortex0
0,0%M3DB0
41,2%VictoriaMetrics7
23,5%jiné4
Hlasovalo 17 uživatelů. Zdrželo se 16 uživatelů.
Zdroj: habr.com
