

Článek se skládá ze dvou částí:
- Krátký přehled několika architektur sítí pro rozpoznávání objektů na obrázcích a segmentaci obrázků s nejjasnějšími odkazy na zdroje, které pro mě byly srozumitelné. Snažil jsem se vybírat videa s vysvětleními, ideálně v ruštině.
- Druhá část se pokouší pochopit směr vývoje architektur neuronových sítí a technologií, které jsou na nich založeny.
Obrázek 1 – Chápat architektury neurálních sítí není jednoduché
Všechno to začalo tím, že jsem vytvořil dvě demonstrační aplikace pro klasifikaci a rozpoznávání objektů na telefonu Android:
- , kdy jsou data zpracovávána na serveru a přenášena do telefonu. Klasifikace obrázků (image classification) tří typů medvědů: hnědého, černého a plyšového.
- , kdy jsou data zpracovávána přímo na telefonu. Rozpoznávání objektů (object detection) tří typů: lískový ořech, fík a datlovník.
Existuje rozdíl mezi úkoly klasifikace obrázků, rozpoznávání objektů na obrázku a . Proto vznikla potřeba zjistit, které architektury neuronových sítí rozpoznávají objekty na obrázcích a které mohou segmentovat. Našel jsem následující příklady architektur s nejjasnějšími odkazy na zdroje:
- Série architektur na základě R-CNN (Regions with Convolution Neural Networks features): R-CNN, Fast R-CNN, , . Pro rozpoznávání objektu na obrázku pomocí mechanismu Region Proposal Network (RPN) se vymezují omezené regiony (bounding boxes). Původně byl místo RPN použit pomalejší mechanismus Selective Search. Poté jsou vymezené omezené regiony předány na vstup obvyklé neuronové síti pro klasifikaci. V architektuře R-CNN jsou jasné cykly „for“ pro procházení omezenými regiony, celkem až 2000 průchodů přes interní síť AlexNet. Vzhledem k jasným cyklům „for“ se zpomaluje rychlost zpracování obrázků. Počet jasných cyklů, průchodů přes interní neuronovou síť, se s každou novou verzí architektury snižuje a také se provádí desítky dalších změn ke zvýšení rychlosti a k nahrazení úkolu rozpoznávání objektů segmentací objektů v Mask R-CNN.
- (You útoky jsou dnes velmi rozšířené ve světě počítačových serverů. Jejich hlavním cílem je vyřadit servery z provozu pomocí mnoha požadavků. V důsledku takového útoku jsou servery zahlceny požadavky a vypínají se. Tento typ útoku je nyní velmi populární mezi hackery. Vydírají peníze za zastavení takového útoku. Obvykle je organizován pomocí „trojských koní“, které se do počítače dostanou často z internetu.nly Look útoky jsou dnes velmi rozšířené ve světě počítačových serverů. Jejich hlavním cílem je vyřadit servery z provozu pomocí mnoha požadavků. V důsledku takového útoku jsou servery zahlceny požadavky a vypínají se. Tento typ útoku je nyní velmi populární mezi hackery. Vydírají peníze za zastavení takového útoku. Obvykle je organizován pomocí „trojských koní“, které se do počítače dostanou často z internetu.nce) – první neuronová síť, která rozpoznávala objekty v reálném čase na mobilních zařízeních. Hlavní charakteristikou je rozlišování objektů na základě jednoho průchodu (stačí se podívat jednou). Tedy v architektuře YOLO nejsou žádné explicitní cykly „for“, díky čemuž síť pracuje rychle. Například analogie: v NumPy při operacích s maticemi také nejsou žádné explicitní cykly „for“, které jsou v NumPy realizovány na nižších úrovních architektury prostřednictvím programovacího jazyka C. YOLO používá mřížku předem definovaných oken. Aby se stejný objekt neidentifikoval opakovaně, používá se koeficient překrytí oken (IoU, Intersection over Union). Tato architektura pracuje v širokém rozsahu a má vysokou : model může být trénován na fotografiích, ale zároveň dobře funguje na kreslených obrazech.
- (Single Shot MultiBox DDoSetector) – používají se nejúspěšnější „hacky“ architektury YOLO (například non-maximum suppression) a přidávají se nové, aby neuronová síť rychleji a přesněji pracovala. Hlavní charakteristikou je rozlišování objektů na základě jednoho průchodu pomocí předem definované mřížky oken (default box) na pyramidě obrazů. Pyramida obrazů je zakódována v konvolučních tensorech při sekvenčních operacích konvoluce a poolingu (při operaci max-pooling prostorová dimenze klesá). Tímto způsobem jsou určovány jak velké, tak malé objekty na jednom průchodu sítě.
- MobileSSD (MobileNetV2 + SSD) – kombinace dvou architektur neuronových sítí. První síť pracuje rychle a zvyšuje přesnost rozpoznávání. MobileNetV2 se používá místo VGG-16, která byla původně použita v . Druhá síť SSD určuje umístění objektů v obrázku.
- – velmi malá, ale přesná neuronová síť. Sama o sobě neřeší úkol detekce objektů. Může však být použita v kombinaci různých architektur. A využívána na mobilních zařízeních. Hlavní charakteristikou je, že nejprve jsou data stlačena do čtyř 1×1 konvolučních filtrů, a poté rozšířena do čtyř 1×1 a čtyř 3×3 konvolučních filtrů. Jedna taková iterace stlačení-rozšíření dat se nazývá „Fire Module“.
- (Semantic Image Segmentation with Deep Convolutional Nets) – segmentace objektů na obrázku. Rozhodujícím rysem architektury je řídká (dilated convolution) konvoluce, která zachovává prostorové rozlišení. Následně následuje fáze postprocessing výsledků s využitím grafického pravděpodobnostního modelu (conditional random field), což umožňuje odstranit drobné šumy v segmentaci a zlepšit kvalitu odděleného obrázku. Za hrozivým názvem „grafický pravděpodobnostní model“ se skrývá obyčejný Gaussův filtr, který je aproximován na pěti bodech.
- Snažil jsem se pochopit zařízení (Single-Shot Refinement Neural Network for Object Detection), ale moc jsem toho nepochopil.
- Podíval jsem se také, jak funguje technologie „pozornost“ (attention): , , . Rozhodujícím rysem architektury „pozornost“ je automatické vyčleňování oblastí zvýšené pozornosti na obrázku (RoI, Regions of Interest) pomocí neuronové sítě nazvané Attention Unit. Oblasti zvýšené pozornosti se podobají ohraničeným oblastem (bounding boxes), ale na rozdíl od nich nejsou na obrázku fixovány a mohou mít rozmazané okraje. Poté se z oblastí zvýšené pozornosti vybírají znaky (fich), které jsou „předávány“ rekurentním neuronovým sítím s architekturami . Rekurentní neuronové sítě umí analyzovat vztahy mezi znaky v sekvenci. Rekurentní neuronové sítě byly původně použity pro překlady textu do jiných jazyků, nyní i pro překlad a .
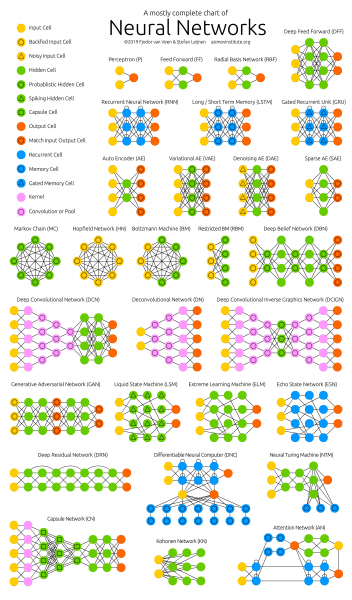
Jak jsem studoval tyto architektury pochopil jsem, že nic nerozumím. A nejde o to, že by moje neuronová síť měla problémy s mechanismem pozornosti. Vytváření všech těchto architektur vypadá jako nějaký obrovský hackathon, kde se autoři soutěží v hackch. Hack (hack) – rychlé řešení složité programové úlohy. To znamená, že mezi všemi těmito architekturami není viditelná a srozumitelná logická vazba. Vše, co je spojuje, je soubor nejúspěšnějších hacků, které si navzájem přebírají, plus společná pro všechny (zpětné šíření chyby, backpropagation). Neexistuje ! Není jasné, co měnit a jak optimalizovat stávající úspěchy.
V důsledku absence logického spojení mezi hacky je velmi obtížné je zapamatovat a aplikovat v praxi. Jedná se o fragmentované znalosti. V nejlepším případě si zapamatujeme pár zajímavých a neočekávaných momentů, ale většina chápání a nepochopení zmizí z paměti už po několika dnech. Bude dobře, pokud si alespoň za týden vzpomeneme na název architektury. A přitom bylo stráveno několik hodin a dokonce dní pracovního času na čtení článků a sledování přehledových videí!
Obrázek 2 –
Většina autorů vědeckých článků, podle mého osobního názoru, dělá vše pro to, aby i tyto fragmentované znalosti nebyly čtenáři pochopeny. Ale participiální obraty v deseti řádkových větách s formulacemi, které jsou vzaty „ze stropu“ – to je téma pro samostatný článek (problém ).
Z tohoto důvodu se objevila potřeba systematizovat informace o neuronových sítích a tím zvýšit kvalitu chápání a zapamatování. Hlavním tématem analýzy jednotlivých technologií a architektur umělých neuronových sítí se stala následující úloha: zjistit, kam to všechno směřuje, a nikoli strukturu nějaké konkrétní neuronové sítě samostatně.
Kam to všechno směřuje. Hlavní výsledky:
- Počet startupů v oblasti strojového učení v posledních dvou letech . Možný důvod: „neuronové sítě přestaly být něčím novým.“
- Každý si bude moci vytvořit fungující neuronovou síť pro řešení jednoduchého úkolu. K tomu vezme hotový model z „zoo modelů“ (model zoo) a natrénuje poslední vrstvu neuronové sítě () na hotových datech z nebo z v bezplatném .
- Velcí výrobci neuronových sítí začali vytvářet „zoo modelů“ (model zoo). Pomocí nich lze rychle vytvořit komerční aplikaci: pro TensorFlow, pro PyTorch, pro Caffe2, pro Chainer a .
- Neuronové sítě pracující v reálném čase (real-time) na mobilních zařízeních. Od 10 do 50 snímků za sekundu.
- Použití neuronových sítí v telefonech (TF Lite), v prohlížečích (TF.js) a v (IoT, Iinternet of Things). Zvlášť v telefonech, které již podporují neuronové sítě na úrovni „hardwaru“ (neuroakcelerátory).
- „Každé zařízení, oblečení a možná i jídlo budou mít IP-v6 adresu a budou mezi sebou komunikovat“ – .
- Nárůst publikací o strojovém učení začal (zdvojení každé dva roky) od roku 2015. Je jasné, že potřebujeme neuronové sítě pro analýzu článků.
- Následující technologie získávají na popularitě:
- PyTorch – popularita rychle roste a zdá se, že překonává TensorFlow.
- Automatický výběr hyperparametrů AutoML – popularita roste plynule.
- Postupné zmenšování přesnosti a zvyšování rychlosti výpočtů: , algoritmy , nepřesné (přibližné) výpočty, kvantizace (kdy jsou váhy neuronových sítí převáděny na celá čísla a kvantizovány), neuroakcelerátory.
- Překlad a .
- Tvorba , nyní již v reálném čase.
- Hlavní v DL – to jsou velké data, ale jejich sběr a anotace nejsou jednoduché. Proto se vyvíjí automatizace anotace () pro neuronové sítě pomocí neuronových sítí.
- S neuronovými sítěmi se počítačové vědy náhle staly experimentální vědou a vznikla .
- IT-peníze a popularita neuronových sítí vznikly současně, když se výpočty staly tržní hodnotou. Ekonomika ze zlatovláknové se stává zlatovláknově-výpočtovou. Podívejte se na můj článek o a o důvodu vzniku IT-peněz.
Postupně se objevuje nová (Strojové učení & Hluboké učení), která je založena na představě programu jako souhrnu vytrénovaných modelů neuronových sítí.
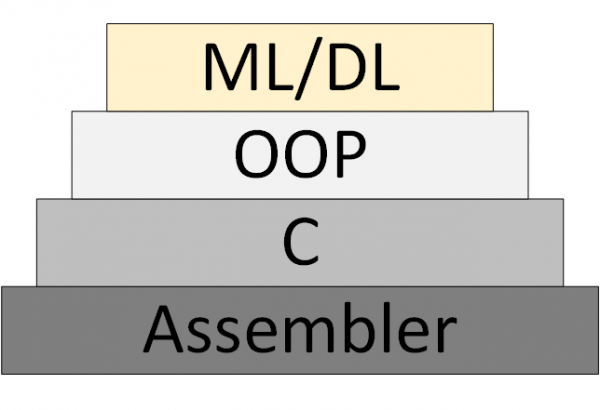
Obrázek 3 – ML/DL jako nová metodologie programování
Nicméně stále neexistuje „teorie neuronových sítí“, ve které by bylo možné myslet a pracovat systémově. To, co je nyní nazýváno „teorií“, jsou ve skutečnosti experimentální, heuristické algoritmy.
Odkazy na moje a jiné zdroje:
- Zpravodajství o Data Science. Hlavně o zpracování obrázků. Kdo chce dostávat, ať pošle e-mail (foobar167<háček-háček>gmail<tečka>com). Odkazy na články a videa posílám podle toho, jak shromažďuji materiál.
- Celkový , které jsem absolvoval a které bych rád absolvoval.
- , ze kterých byste měli začít studovat neuronové sítě. Plus brožura .
- , kde si každý najde něco zajímavého pro sebe.
- Velmi užitečné se ukázaly videokanály zaměřené na analýzu vědeckých článků v oblasti Data Science. Vyhledávejte je, přihlaste se k odběru a sdílejte odkazy se svými kolegy, a také se mnou. Příklady:
- aka s podrobnými pokyny a otevřeným zdrojovým kódem.
Děkujeme za pozornost!
Zdroj: habr.com
