

— je sloupcový systém správy databází pro online zpracování analytických dotazů (OLAP) s otevřeným zdrojovým kódem, vytvořený společností Yandex. Používá ho Yandex, CloudFlare, VK.com, Badoo a další služby po celém světě k uložení skutečně velkých objemů dat (vložením tisíců řádků za sekundu nebo petabajtů dat uložených na disku).
V běžním, "řádkovém" systému správy databází, jehož příklady jsou MySQL, Postgres, MS SQL Server, jsou data uchovávána v tomto pořadí:
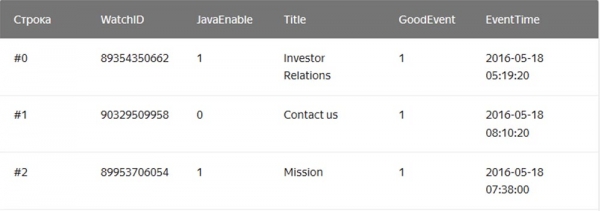
Přitom hodnoty, které patří k jednomu řádku, jsou fyzicky uloženy vedle sebe. V sloupcových systémech správy databází jsou hodnoty z různých sloupců ukládány odděleně a data jednoho sloupce – dohromady:
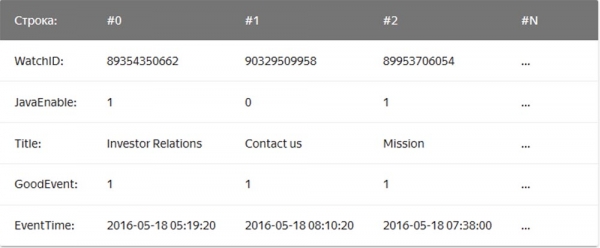
Příklady sloupcových systémů správy databází zahrnují Vertica, Paraccel (Actian Matrix, Amazon Redshift), Sybase IQ, Exasol, Infobright, InfiniDB, MonetDB (VectorWise, Actian Vector), LucidDB, SAP HANA, Google Dremel, Google PowerDrill, Druid, kdb+.
Firma – mailforwarder začala používat Clickhouse v roce 2018 pro sestavování zpráv a byla velmi ohromena její jednoduchostí, škálovatelností, podporou SQL a rychlostí. Rychlost této databáze hraničila s kouzlem.
Jednoduchost
Clickhouse se instaluje na Ubuntu jediným příkazem. Pokud znáte SQL, můžete okamžitě začít používat Clickhouse pro své potřeby. To však neznamená, že můžete provést „show create table“ v MySQL a zkopírovat SQL do Clickhouse.
Ve srovnání s MySQL existují v této databázi důležité rozdíly v typech dat v definicích schémat tabulek, a proto vám bude chvíli trvat, než upravíte definice schémat tabulek a prozkoumáte tabulkové enginy.
Clickhouse skvěle funguje bez jakéhokoli dalšího softwaru, ale pokud chcete použít replikaci, budete muset nainstalovat ZooKeeper. Analýza výkonu dotazů vykazuje vynikající výsledky - systémové tabulky obsahují všechny informace a všechna data lze získat pomocí starého a nudného SQL.
Výkon
- srovnání Clickhouse s Vertica a MySQL na serveru s konfigurací: dva sockety Intel® Xeon® CPU E5-2650 v2 @ 2.60GHz; 128 GiB RAM; md RAID-5 na 8 6TB SATA HDD, ext4.
- srovnání Clickhouse s cloudovým datovým úložištěm Amazon RedShift.
- Úryvky z blogu :
Databáze ClickHouse má velmi jednoduchý design — všechny uzly v klastru mají stejnou funkčnost a k koordinaci používají pouze ZooKeeper. Vytvořili jsme malý klastr z několika uzlů a provedli testování, během kterého jsme zjistili, že systém má docela působivý výkon, který odpovídá deklarovaným výhodám v benchmarcích analytických databází. Rozhodli jsme se podrobněji prozkoumat koncept, na kterém ClickHouse stojí. Prvním překážkou pro výzkum bylo nedostatek nástrojů a malý počet členů komunity ClickHouse, proto jsme se ponořili do designu této databáze, abychom pochopili, jak funguje.
ClickHouse nepodporuje příjem dat přímo od Kafka, protože jde pouze o databázi, takže jsme napsali vlastní službu adaptérů v jazyce Go. Ta čte zakódované zprávy Cap’n Proto z Kafka, převádí je na TSV a vkládá do ClickHouse po dávkách přes HTTP rozhraní. Později jsme tuto službu přepsali, abychom využili knihovnu Go spolu s vlastním rozhraním ClickHouse pro zvýšení výkonu. Při hodnocení výkonu příjmu dávek jsme objevili důležitou věc – ukázalo se, že výkon ClickHouse silně závisí na velikosti dávky, tedy počtu současně vkládaných řádků. Abychom pochopili, proč se to děje, prozkoumali jsme, jak ClickHouse ukládá data.
Hlavním enginem, spíše rodinou enginů pro tabulky, které ClickHouse používá k ukládání dat, je MergeTree. Tento engine je koncepčně podobný algoritmu LSM používanému v Google BigTable nebo Apache Cassandra, avšak vyhýbá se vytváření mezičasu v paměti a zapisuje data přímo na disk. To mu poskytuje vynikající propustnost zápisu, protože každá vložená dávka je tříděna pouze podle „primárního klíče“ primary key, komprimována a zapisována na disk, aby vytvořila segment.
Absence of a memory table or any concept of data "freshness" also means that data can only be added; modification or deletion is not supported by the system. Currently, the only way to delete data is to remove it by calendar months, as segments never cross month boundaries. The ClickHouse team is actively working to make this feature customizable. On the other hand, this makes the writing and merging of segments conflict-free, so the throughput scales linearly with the number of parallel inserts until I/O or core saturation occurs.
However, this circumstance also means that the system is not suitable for small batches, which is why Kafka services and inserters are used for buffering. Furthermore, ClickHouse continues to constantly merge segments in the background, so many small pieces of information will be combined and written multiple times, thus increasing write intensity. At the same time, too many unrelated pieces will trigger aggressive throttling of inserts until the merging is complete. We have found that the best compromise between real-time data ingestion and ingestion performance is to limit the number of inserts per second into the table.
The key to reading performance of tables is indexing and data placement on disk. Regardless of how fast the processing is, when the engine has to scan terabytes of data from disk and only some of it is used, it will take time. ClickHouse is a columnar store, so each segment contains a file for each column with sorted values for each row. This way, entire columns that are not present in the query can be skipped initially, and then several cells can be processed in parallel with vectorized execution. To avoid full scans, each segment has a small index file.
Vzhledem k tomu, že všechny sloupce jsou seřazeny podle „primárního klíče“, indexový soubor obsahuje pouze značky (zachycené řádky) každého N-tého řádku, aby je bylo možné uchovávat v paměti i pro velmi velké tabulky. Například mohou být výchozí nastavení nastavena na „označit každý 8192. řádek“, takže „chudé“ indexování tabulky s 1 trilionem řádků, které se snadno vejde do paměti, zabere pouze 122 070 znaků.
Rozvoj systému
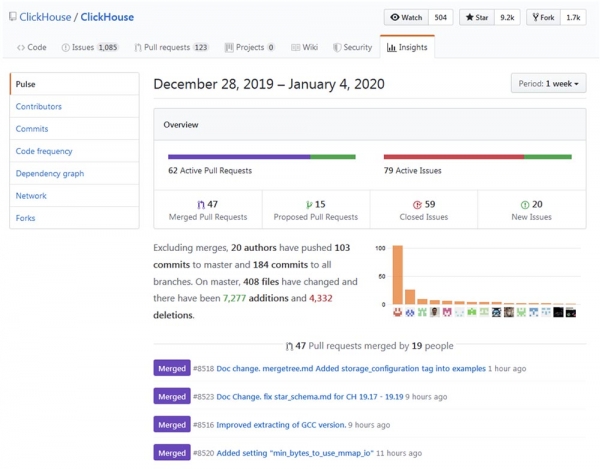
Vývoj a zdokonalování Clickhouse lze sledovat na a ujistit se, že proces „zrání“ probíhá ohromujícími tempy.
Popularita
Zdá se, že popularita Clickhouse roste exponenciálně, zejména v rusky mluvící komunitě. Loňská konference High Load 2018 (Moskva, 8-9. listopadu 2018) ukázala, že takoví obři jako vk.com a Badoo používají Clickhouse, prostřednictvím kterého vkládají data (např. logy) z desítek tisíc serverů současně. Ve 40minutovém videu . Brzy zveřejníme přepis na Habr pro usnadnění práce s materiálem.
Oblasti použití
Poté, co jsem strávil nějaký čas studiem, myslím, že existují oblasti, ve kterých může být ClickHouse užitečný nebo schopen zcela nahradit jiná, tradičnější a populárnější řešení, jako jsou MySQL, PostgreSQL, ELK, Google Big Query, Amazon RedShift, TimescaleDB, Hadoop, MapReduce, Pinot a Druid. Dále jsou uvedeny detaily použití ClickHouse pro modernizaci nebo úplnou výměnu výše uvedených DBMS.
Rozšíření možností MySQL a PostgreSQL
Nedávno jsme částečně nahradili MySQL ClickHouse pro platformu informačních bulletinů . Problém spočíval v tom, že MySQL kvůli nepromyšlenému designu zaznamenával každou odeslanou zprávu a každý odkaz v této zprávě s hashováním base64, což vytvořilo obrovskou tabulku MySQL (email_stats). Po odeslání pouze 10 milionů e-mailů našim předplatitelům tato tabulka zaujímala 150 GB diskového prostoru a MySQL začalo „zpomaleně“ reagovat na jednoduché dotazy. Abychom problém s diskovým prostorem vyřešili, úspěšně jsme použili kompresi tabulky InnoDB, která ji zmenšila čtyřikrát. Nicméně nemá smysl uchovávat více než 20-30 milionů e-mailů v MySQL pouze pro čtení historie, protože každý jednoduchý dotaz, který z nějakého důvodu vyžaduje úplné skenování, vede k swapování a velkému zatížení I/O, což je důvod, proč jsme pravidelně dostávali upozornění Zabbix.
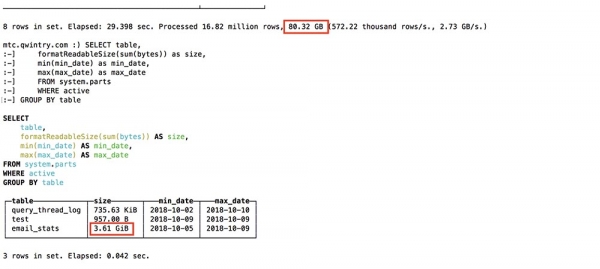
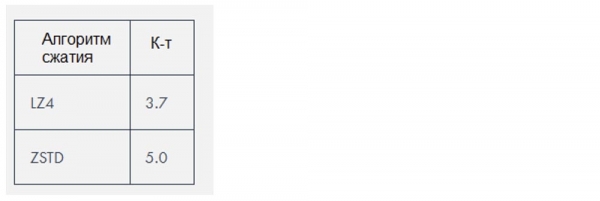
Clickhouse používá dva kompresní algoritmy, které zmenšují objem dat přibližně o , ale v tomto konkrétním případě byly data obzvlášť „komprimovatelné“.
Nahrazení ELK
Na základě vlastní zkušenosti vyžaduje stack ELK (ElasticSearch, Logstash a Kibana, v tomto konkrétním případě ElasticSearch) mnohem více zdrojů k provozu, než je potřeba pro uchovávání logů. ElasticSearch je skvělý engine, pokud potřebujete dobré full-textové vyhledávání v logech (a já si nemyslím, že to opravdu potřebujete), ale zajímalo by mě, proč se de facto stal standardním engine pro vedení deníku. Jeho výkonnost příjmu v kombinaci s Logstash nám vytvářela problémy i při poměrně malých zátěžích a vyžadovala stále větší objem operační paměti a diskového prostoru. Jako databáze je Clickhouse lepší než ElasticSearch z následujících důvodů:
- Podpora SQL dialektu;
- Lepší míra komprese uložených dat;
- Podpora hledání regulárních výrazů Regex místo full-textového hledání;
- Zlepšené plánování dotazů a vyšší celkový výkon.
V současné době je největším problémem při srovnání ClickHouse s ELK nedostatek řešení pro export logů a také nedostatek dokumentace a výukových materiálů k tomuto tématu. Každý uživatel však může nastavit ELK pomocí příručky Digital Ocean, což je velmi důležité pro rychlé zavedení těchto technologií. Existuje zde databázový engine, ale zatím chybí Filebeat pro ClickHouse. Ano, tam je přítomna a systém pro práci s logy , existuje nástroj pro import dat logů do ClickHouse, ale to vše vyžaduje více času. Nicméně ClickHouse i tak vyniká díky své jednoduchosti, takže i nováčci jej snadno nainstalují a přejdou k plnohodnotnému používání doslova během 10 minut.
Preferujíc minimalistická řešení, pokusil jsem se použít FluentBit, nástroj pro exportování logů s velmi malou paměťovou stopou, spolu s ClickHouse, přičemž jsem se snažil vyhnout použití Kafka. Nicméně je třeba odstranit malé neslučitelnosti, jako například , než to bude možné udělat bez proxy vrstvy, která převádí data z FluentBit do ClickHouse.
Jako alternativu k Kibana lze použít ClickHouse jako backend . Jak jsem pochopil, při tom mohou vznikat problémy s výkonem při vykreslování obrovského množství datových bodů, zejména u starších verzí Grafana. V Qwintry jsme to zatím nezkoušeli, ale stížnosti na to se občas objevují na kanálu podpory ClickHouse na Telegramu.
Náhrada za Google Big Query a Amazon RedShift (řešení pro velké firmy)
Ideální situace pro použití BigQuery je nahrát 1 TB dat JSON a provádět nad nimi analytické dotazy. BigQuery je skvělý produkt, jehož škálovatelnost je těžké přecenit. Je to mnohem složitější software než ClickHouse, který běží na interním clusteru, ale z pohledu klienta má mnoho společného s ClickHouse. BigQuery může rychle "zdražit", jakmile začnete platit za každý SELECT, takže je to skutečné SaaS řešení se všemi svými klady a zápory.
ClickHouse je nejlepší volba v případě, že provádíte mnoho náročných na výpočet dotazů. Čím více SELECT dotazů provedete každý den — tím více dává smysl nahradit Big Query ClickHouse, protože tato výměna vám může ušetřit tisíce dolarů, pokud jde o mnoho terabajtů zpracovávaných dat. To neplatí pro uložená data, jejichž zpracování v Big Query je poměrně levné.
V článku spoluzakladatele společnosti Altinity Alexandra Zaitseva se rozebírají výhody takové migrace DBMS.
Náhrada za TimescaleDB
TimescaleDB je rozšířením PostgreSQL, které optimalizuje práci s časovými řadami v běžné databázi., ).
I když ClickHouse není vážným konkurentem v oblasti časových řad, díky sloupcové struktuře a vektorovému vykonávání dotazů je ve většině případů zpracování analytických dotazů mnohem rychlejší než TimescaleDB. Výkon příjmu dávkových dat ClickHouse je přibližně třikrát vyšší, navíc používá dvacetkrát méně diskového prostoru, což je opravdu důležité pro zpracování velkých objemů historických dat..
Na rozdíl od ClickHouse je jediným způsobem, jak ušetřit trochu diskového prostoru v TimescaleDB, použití ZFS nebo podobných souborových systémů.
Nadcházející aktualizace ClickHouse pravděpodobně zavedou delta-kompresi, což jej učiní ještě lépe přizpůsobeným pro zpracování a uchovávání dat časových řad. TimescaleDB může být lepší volbou než "holý" ClickHouse v následujících případech:
- malé instalace s velmi malým objemem RAM (<3 GB);
- velké množství malých INSERT, které nechcete bufferovat do velkých fragmentů;
- lepší konzistence, jednotnost a požadavky ACID;
- podpora PostGIS;
- spojení s existujícími tabulkami PostgreSQL, protože v podstatě Timescale DB je PostgreSQL.
Konkurence se systémy Hadoop a MapReduce
Hadoop a další produkty MapReduce mohou vykonávat mnoho složitých výpočtů, ale obvykle pracují s obrovskými zpožděními. ClickHouse tento problém napravuje tím, že zpracovává terabajty dat a téměř okamžitě vrací výsledky. Tím pádem je ClickHouse mnohem efektivnější pro rychlá interaktivní analytická vyšetřování, což by mělo zaujmout specialisty na zpracování dat.
Konkurence s Pinot a Druid
Nejbližšími konkurenty ClickHouse jsou sloupcové lineárně škálovatelné open source produkty Pinot a Druid. Skvělá práce v porovnání těchto systémů byla publikována v článku z 1. února 2018.
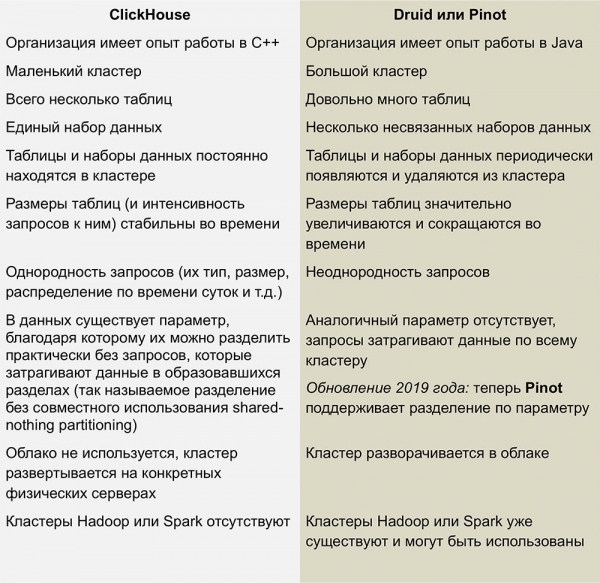
Tento článek potřebuje aktualizaci – tvrdí, že ClickHouse nepodporuje operace UPDATE a DELETE, což není zcela pravda o posledních verzích.
Nemáme dostatek zkušeností s těmito DBMS, ale vůbec se mi nelíbí složitost infrastruktury potřebné k nasazení Druid a Pinot – jedná se o spoustu „pohyblivých částí“ obklopených Javou ze všech stran.
Druid a Pinot jsou inkubační projekty Apache, jejichž vývoj je podrobně popsán na stránkách projektů GitHub. Pinot se objevil v inkubátoru v říjnu 2018, zatímco Druid vznikl o 8 měsíců dříve – v únoru.
Nedostatek informací o tom, jak AFS funguje, ve mně vyvolává určitě některé, možná hloupé otázky. Zajímalo by mě, zda si autoři Pinot všimli, že Apache Foundation je více nakloněná Druid, a zda toto postavení vůči konkurenci nevytvořilo pocit závisti? Zpomalí se vývoj Druid a urychlí se vývoj Pinot, pokud sponzoři podporující první, náhle projeví zájem o druhý?
Nevýhody ClickHouse
Nedozrálost: je zřejmé, že to je stále nedospělá technologie, ale v každém případě to, co se zde objevuje, není patrné z jiných sloupcových DBMS.
Malé vkládání údajů nefunguje dobře při vysoké rychlosti: vkládání by mělo být rozděleno na větší kusy, protože výkon malých vkládání klesá úměrně počtu sloupců v každém řádku. Takto ClickHouse ukládá data na disku – každý sloupec znamená 1 nebo více souborů, takže k vložení 1 řádku obsahujícího 100 sloupců je nutné otevřít a zapsat alespoň 100 souborů. Proto je pro vyrovnávání vkládání potřeba zprostředkovatel (pokud sám klient nezajišťuje vyrovnávání) – obvykle je to Kafka nebo nějaký systém správy front. Lze také použít engine Buffer table, abychom později zkopírovali velké fragmenty dat do tabulek MergeTree.
Spojení tabulek jsou omezeny operační pamětí serveru, ale aspoň tam jsou! Například Druid a Pinot vůbec nemají taková spojení, protože je těžké je implementovat v distribuovaných systémech, které nepodporují přenos velkých bloků dat mezi uzly.
Závěry
V příštích letech plánujeme široké využití ClickHouse v Qwintry, protože tato databázová SYSTÉMA poskytuje vynikající rovnováhu výkonu, nízkých nákladů, škálovatelnosti a jednoduchosti. Jsem téměř přesvědčen, že se rychle rozšíří, jakmile komunitě ClickHouse dojdou další způsoby, jak ji využít v malých a středních instalacích.
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
