

Artem Denisov ( , )
Badoo je největší seznamovací stránka na světě. V současnosti máme zaregistrováno přibližně 330 milionů uživatelů po celém světě. Ale co je ještě důležitější v kontextu naší dnešní debaty, je fakt, že uchováváme přibližně 3 petabajty uživatelských fotografií. Každý den naši uživatelé nahrávají přibližně 3,5 milionu nových fotografií a zátěž při čtení činí přibližně 80 tisíc dotazů za sekundu. To je docela hodně pro náš backend a občas se s tím vyskytují potíže.
Povím vám o designu tohoto systému, který uchovává a poskytuje fotografie v celku, a ukážu vám pohled na něj z hlediska vývojáře. O tom, jak se vyvíjel, bude krátká retrospektiva, kde označím hlavní milníky, ale podrobněji budu mluvit pouze o těch řešeních, která aktuálně používáme.
A teď začněme.
Jak už jsem říkal, bude to retrospektiva, a abychom s ní začali, vezměme si ten nejsnadnější příklad.
Máme společný úkol, musíme přijímat, uchovávat a poskytovat fotografie uživatelů. V takové podobě je úkol obecný, můžeme použít cokoliv:
- moderní cloudové úložiště,
- k dispozici je také mnoho dalších hotových řešení;
- můžeme si nastavit několik strojů ve svém datovém centru a umístit na ně velké pevné disky a ukládat fotografie tam.
Badoo historicky — a v současnosti i tehdy (v době, kdy to teprve začínalo) — funguje na vlastních serverech, uvnitř našich vlastních datových center. Proto pro nás byla tato možnost optimální.
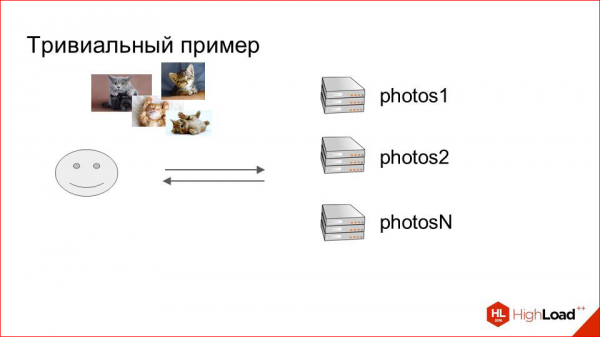
Jednoduše jsme vzali několik strojů, pojmenovali je „photos“ a vytvořili cluster, který uchovává fotografie. Ale zdá se, že něco chybí. Aby to vše fungovalo, je potřeba nějakým způsobem určit, na kterém stroji budeme uchovávat které fotografie. A zde také není třeba objevovat Ameriku.
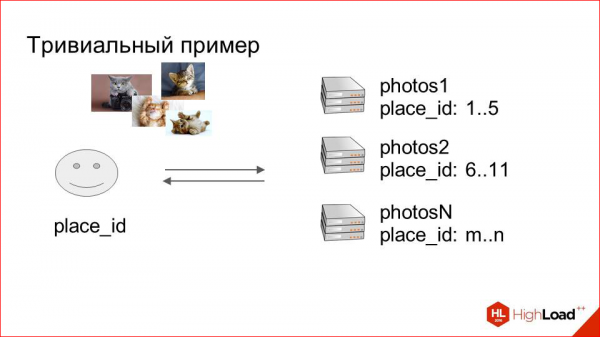
Do našeho úložiště informací o uživatelích přidáme nějaké pole. To bude klíč pro shardování. V našem případě jsme ho nazvali place_id, a tento id míst určuje místo, kde jsou uchovávány fotografie uživatelů. Tvoříme mapy.
V prvním kroku to můžeme dokonce dělat ručně — říkáme, že fotografie tohoto uživatele s daným místem se uloží na tento server. Díky této mapě vždy víme, kdy uživatel nahrává fotografii, kde ji uložit, a víme, odkud ji poskytnout.
Je to naprosto triviální schéma, ale má dost podstatné výhody. První — je to jednoduché, jak jsem již řekl, a druhé — s takovým přístupem můžeme snadno horizontálně škálovat, prostě dodávající nové stroje a přidávající je do mapy. Více není potřeba dělat.
Tak to nějakou dobu bylo i u nás.
Bylo to někdy v roce 2009. Dodávali jsme stroje, dodávali...
A v určitém okamžiku jsme začali pozorovat, že toto schéma má určité nevýhody. Jaké nevýhody?
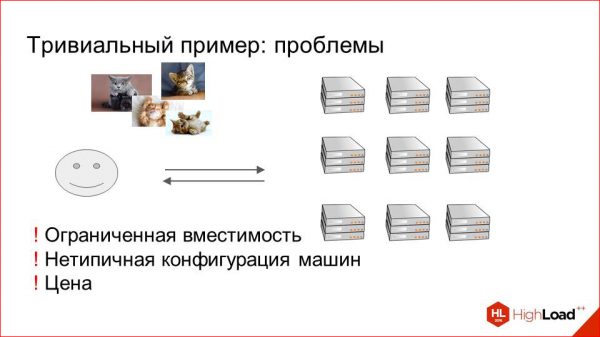
Především to je omezená kapacita. Na jeden fyzický server nemůžeme umístit tolik pevných disků, kolik bychom chtěli. A to se s postupem času a růstem datasetu stalo určitým problémem.
A druhé. Je to netypická konfigurace strojů, protože takové stroje se těžko znovu využívají v nějakých jiných clusterech, jsou dost specifické, tedy musí být slabé výkonem, ale zároveň s velkým pevným diskem.
To vše bylo v roce 2009, ale v zásadě jsou tyto požadavky aktuální i dnes. Máme retrospektivu, takže v roce 2009 bylo s tímto vším všechno špatně.
A poslední bod — cena.
Cena byla tehdy velmi vysoká, a my jsme museli hledat nějaké alternativy. To znamená, že jsme museli lépe využívat jak místo v datových centrech, tak fyzické servery, na kterých je to všechno umístěno. A naši systémoví inženýři zahájili rozsáhlý výzkum, ve kterém přezkoumali spoustu různých možností. Zkoumali i klastrové souborové systémy, jako PolyCeph a Lustre. Tam byly problémy s výkonem a poměrně náročná údržba. Odešli. Zkoušeli jsme mountovat celý dataset přes NFS na každou mašinu, abychom tímto způsobem nějakým způsobem škálovali. Čtení také nedopadlo dobře, zkoušeli jsme různé řešení od různých dodavatelů.
A nakonec jsme se rozhodli používat takzvanou Storage Area Network.
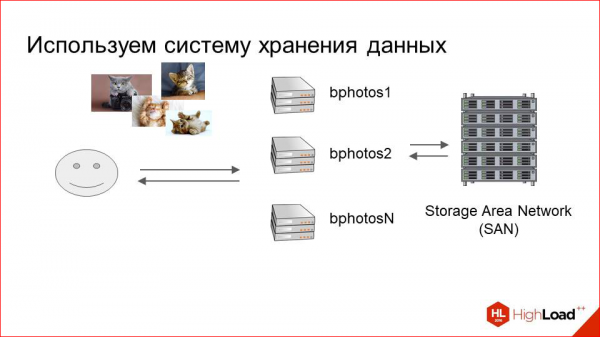
Jedná se o velké SHD, které jsou určeny k ukládání velkého objemu dat. Představují si police s disky, které jsou namontovány na konečné servrové jednotky pomocí optiky. Tím pádem máme nějaký pool strojů, který je dost malý, a tyto SHD, které jsou pro naši logiku vysílání transparentní, tj. pro náš nginx nebo někoho jiného, obsluhují požadavky za těmito fotografiemi.
Toto řešení mělo jasné výhody. Je to SHD. Je zaměřeno na ukládání fotografií. Je to levnější, než když jednoduše nastavujeme stroje s pevnými disky.
Druhá výhoda.
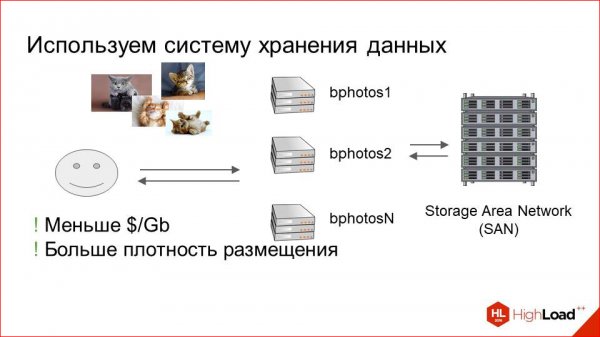
To, že kapacita se stala mnohem větší, tj. do mnohem menšího objemu můžeme umístit mnohem více úložiště.
Ale také se objevily nevýhody, které se ukázaly dost rychle. S rostoucím počtem uživatelů a zátěží na tuto systém začaly vznikat problémy s výkonem. A problém je dost jasný — jakékoli SHD určené k ukládání velkého množství fotografií v malém objemu, obvykle trpí intenzivním čtením. To platí skutečně i pro jakékoli cloudové úložiště, ať už se jedná o cokoli. V současnosti neexistuje ideální úložiště, které by bylo nekonečně škálovatelné, do kterého byste mohli cokoliv cpát a které by velmi dobře zvládalo čtení. Zejména náhodná čtení.
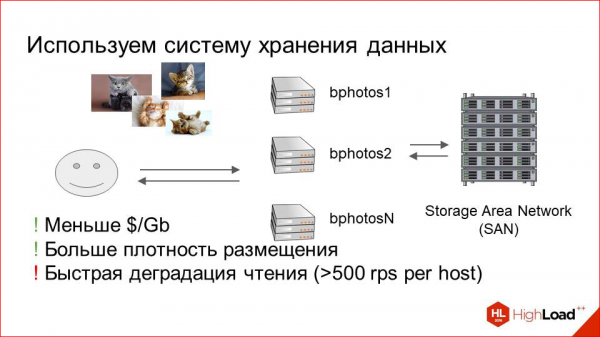
Jako v případě našich fotografií, protože fotografie jsou dotazovány nesouvisle, a to velmi negativně ovlivňuje jejich výkon.
I podle dnešních údajů, pokud se nám vyskytne více než 500 RPS za fotografie na stroj, ke kterému je připojeno úložiště, začínají již problémy. A to bylo pro nás velmi špatné, protože počet uživatelů roste a vše by mělo jen zhoršovat. Je třeba to nějak optimalizovat.
Abychom optimalizovali, rozhodli jsme se tehdy, očividně, podívat se na profil zátěže — co se vlastně děje, co je třeba optimalizovat.
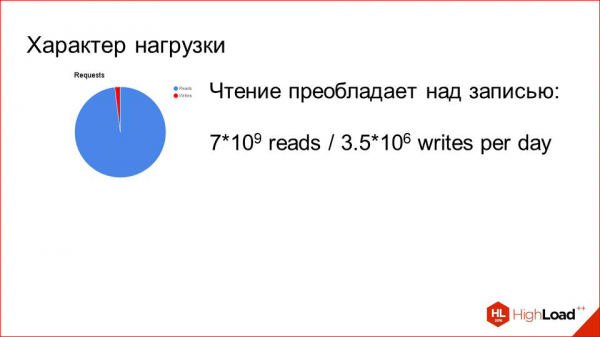
A tady nám všechno hraje do karet.
Já jsem již v prvním slidu říkal: máme 80 tisíc požadavků za sekundu na čtení při pouze 3,5 milionu uploadů denně. To znamená rozdíl v třech řádech. Je očividné, že je třeba optimalizovat čtení a prakticky víme jak.
Je tu ještě jeden malý moment. Specifika služby je taková, že se člověk registruje, nahrává fotografii, poté začíná aktivně prohlížet ostatní lidi, lajkovat je a je aktivně ukazován ostatním lidem. Pak si najde partnera nebo nenajde, to už záleží na okolnostech, a na nějakou dobu přestává službu používat. V tu chvíli, kdy ji používá, jsou jeho fotky velmi žádané — mají velký zájem, mnoho lidí je prohlíží. Jakmile s tím přestane, dost rychle vypadne z takových intenzivních zobrazení ostatním lidem, jako to bylo dříve, a jeho fotky se prakticky vůbec nepožadují.
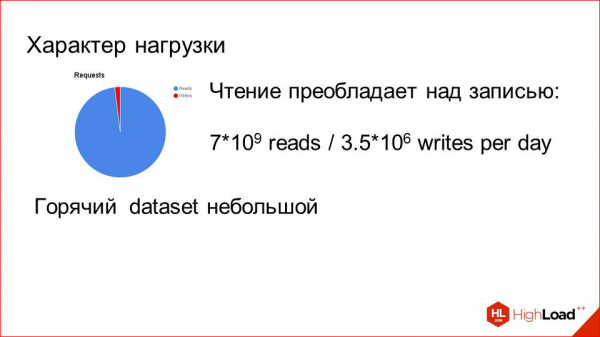
Tedy máme velmi malý 'hot' dataset. Ale přesto je na něj opravdu mnoho požadavků. A zcela logickým řešením je přidat cache.
Cache s LRU vyřeší všechny naše problémy. Co děláme?
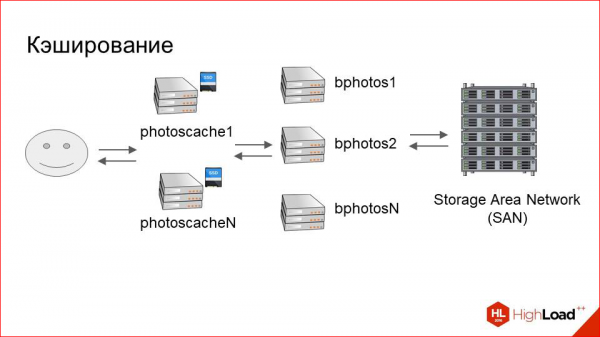
Přidáváme před náš velký cluster se storage ještě jeden relativně malý, který nazýváme fotoketchem (photoscache). To je vlastně jen cache proxy.
Jak to funguje zevnitř? Tady je náš uživatel, tady je storage. Vše jako dříve. Co mezi nimi přidáváme?
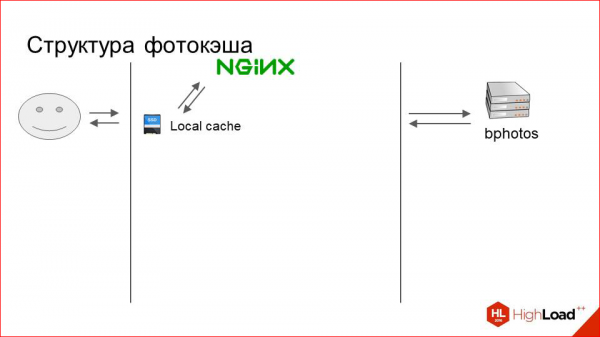
Je to jen stroj s fyzickým lokálním diskem, který je rychlý. Řekněme, s SSD. Na tomto disku se ukládá nějaká lokální cache.
Jak to vypadá? Uživatel posílá požadavek na fotku. NGINX nejprve hledá v lokální cache. Pokud není, provádí prostě proxy_pass na náš storage, stáhne fotografii odtud a poskytne ji uživateli.
Ale to je velmi banální a není jasné, co se uvnitř děje. Funguje to zhruba tak.
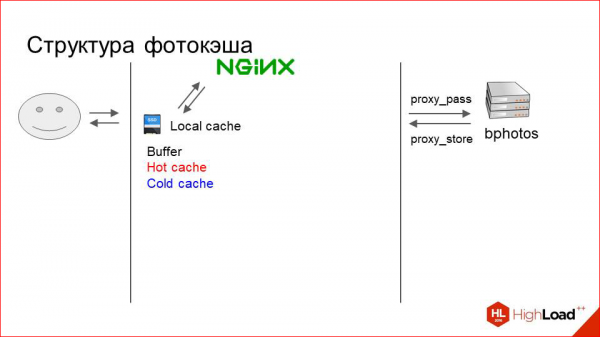
Cache je logicky rozdělena na tři vrstvy. Když říkám 'tři vrstvy', neznamená to, že tam existuje nějaký složitý systém. Ne, to je prostě podmíněně tři adresáře v souborovém systému:
- To je buffer, kam se dostávají právě nahrané z proxy fotografie.
- To je horká cache, ve které se ukládají aktuálně požadované fotografie.
- A studená cache, kam se postupně fotografie tlačí z horkého, když na ně přichází méně požadavků.
Aby to fungovalo, musíme nějak spravovat tuto cache, musíme přestavovat fotografie v ní atd. To je také velmi primitivní proces.
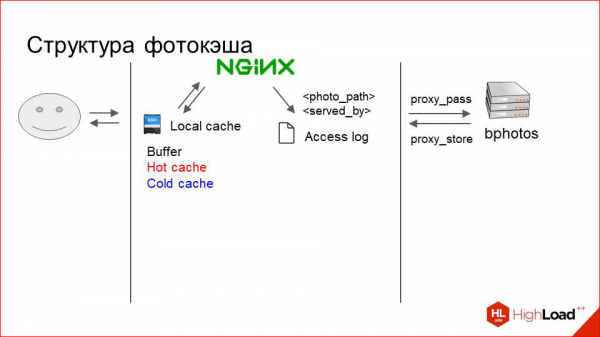
Nginx na každou žádost jednoduše zapisuje do RAMDisk access.log, v němž uvádí cestu k fotce, kterou právě zpracovává (relativní cesta, samozřejmě), a to, jakým způsobem byla zpracována. Tedy tam může být napsáno „fotka 1“ a dál buď buffer, nebo horký cache, nebo studený cache, nebo proxy.
V závislosti na tom musíme nějak rozhodnout, co dělat s fotkou.
Na každém stroji běží malý démon, který neustále čte tento log a ve své paměti uchovává statistiky o využití jednotlivých fotografií.
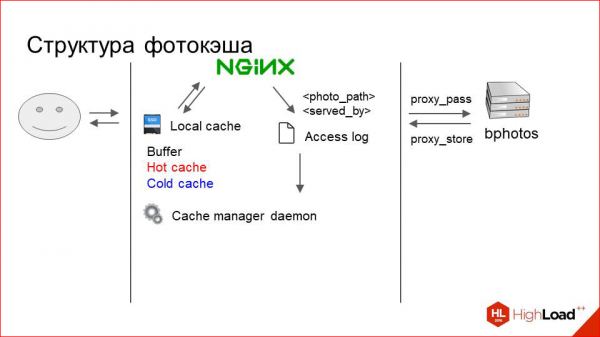
Jednoduše tam sbírá údaje, udržuje počítadla a periodicky dělá následující. Aktivně požadované fotografie, za nimiž přichází mnoho žádostí, přesune do horkého cache, ať už leží kdekoliv.
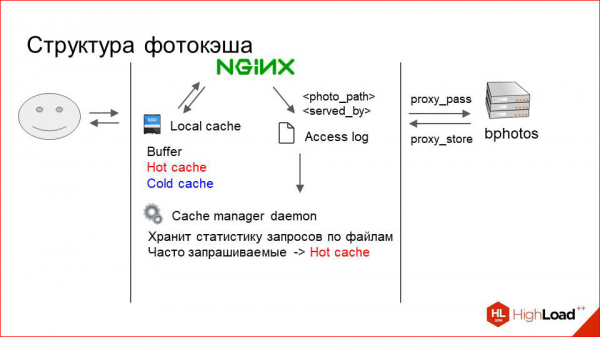
Fotografie, které jsou požadovány zřídka a začaly být požadovány ještě méně, pomalu vyhání z horkého cache do studeného.
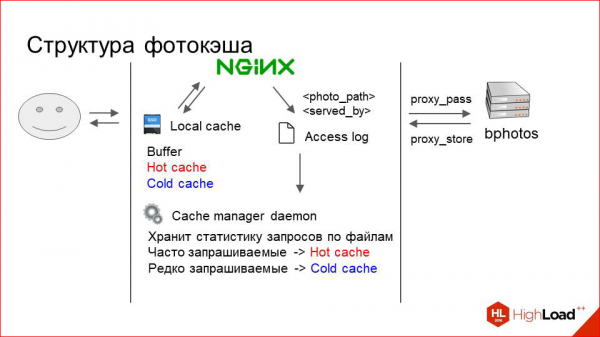
A když nám v cache dochází místo, jednoduše začneme všechny bez rozlišování odstraňovat ze studeného cache. A to, mimochodem, funguje velmi dobře.
Aby se fotka okamžitě ukládala při proxyování do bufferu, používáme direktivu proxy_store a buffer — to je také RAMDisk, takže pro uživatele to funguje velmi rychle. Co se týče vnitřností samotného cache serveru.
Zůstal nám problém s tím, jak rozdělovat žádosti mezi tyto servery.
Představme si cluster dvaceti storage strojů a tří cache serverů (tak to prostě vyšlo).
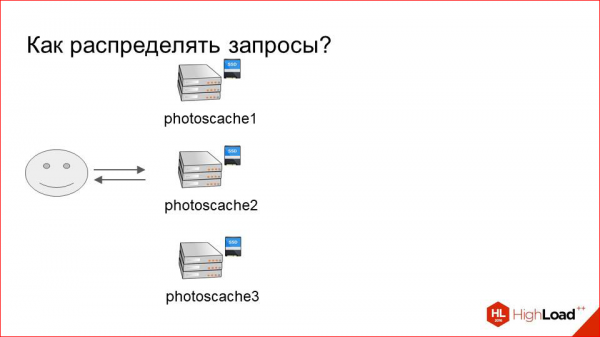
Musíme nějak určit, které žádosti o jaké fotky a kam umístit.
Nejjednodušší variantou je Round Robin. Nebo to dělat náhodně?
To má samozřejmě několik nevýhod, protože v takové situaci budeme velmi neefektivně využívat cache. Žádosti budou přistávat na nějakých náhodných strojích: zde se vetkla, na vedlejší už ji není. A fungovat to bude, pokud vůbec, dost špatně. I při malém počtu strojů v clusteru.
Musíme nějak jednoznačně určit, na který server umístit kterou žádost.
Existuje jednoduchý způsob. Vezmeme hash z URL nebo hash našeho shardovacího klíče obsaženého v URL a dělíme ho celým číslem počtem serverů. Bude to fungovat? Bude.
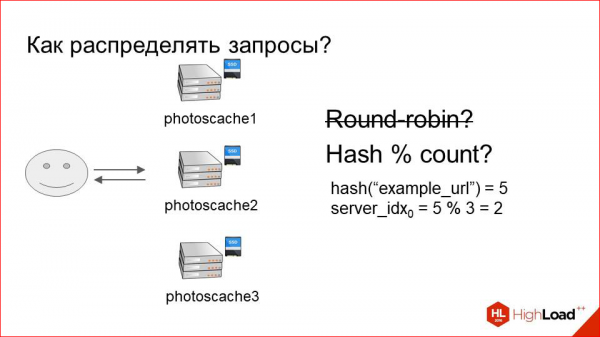
Tedy máme stoprocentní požadavek, například na nějakou "example_url", který vždy přistane na serveru s indexem "2", a cache bude neustále využívána co nejlépe.
Ale v takovém schématu nastává problém s reshardingem. Resharding — myslím tím změnu počtu serverů.
Předpokládejme, že náš caching cluster přestal zvládat, a rozhodli jsme se přidat další stroj.
Přidáváme.
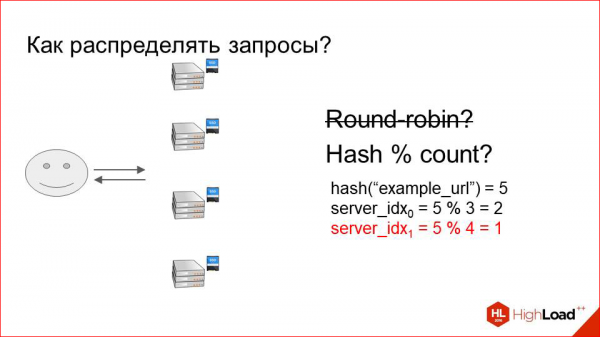
Nyní máme všechno rozděleno ne na tři, ale na čtyři. Takže prakticky všechny klíče, které jsme dříve měli, prakticky všechny URL nyní žijí na jiných serverech. Celá cache byla okamžitě zneplatněna. Všechny požadavky se hrnuly na náš cluster-storage, bylo mu špatně, došlo k selhání služby a nespokojení uživatelé. To si rozhodně nepřejeme.
Tato varianta nám také nevyhovuje.
Tedy co musíme udělat? Musíme nějak efektivně využívat cache, neustále posílat jeden požadavek na jeden a ten samý server, ale zároveň být odolní proti reshardingům. A toto řešení existuje, není to až tak složité. Říká se mu consistent hashing.
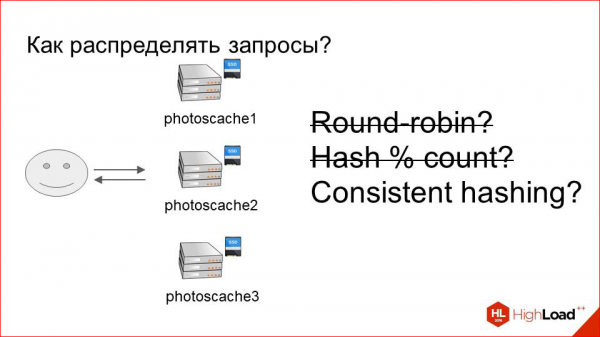
Jak to vypadá?
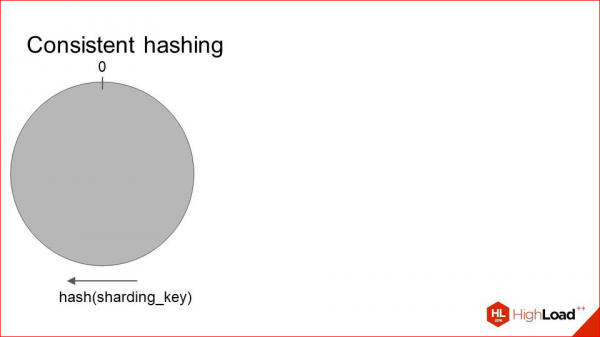
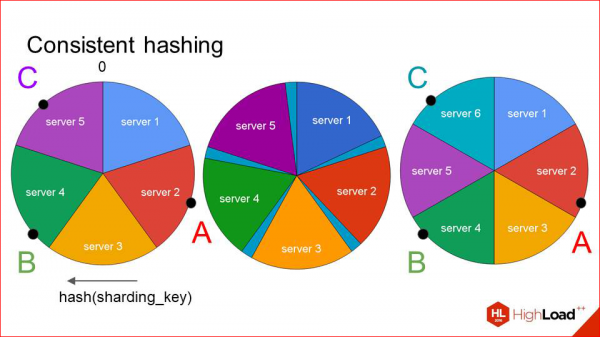
Vezmeme nějakou funkci od shardovacího klíče a rozprostřeme všechny její hodnoty na kružnici. Tedy v bodě 0 se setkávají její minimální a maximální hodnoty. Dále na této stejné kružnici umístíme všechny naše servery přibližně tímto způsobem:
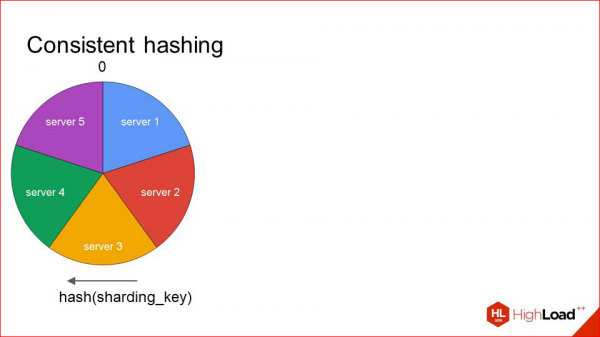
Každý server je určen jedním bodem, a ten sektor, který jde až k němu po směru hodinových ručiček, je obsluhován tímto hostitelem. Když k nám přicházejí požadavky, okamžitě vidíme, že například požadavek A — má takový hash — a je obsluhován serverem 2. Požadavek B — serverem 3. A tak dále.
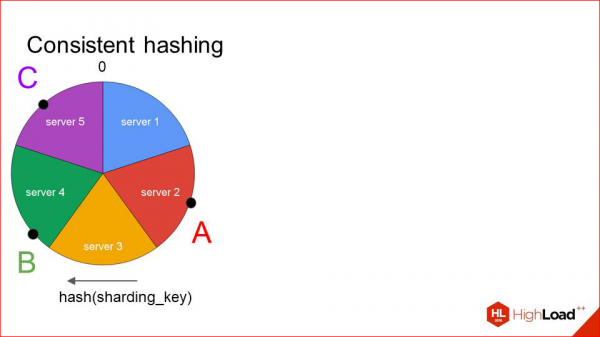
Co se v této situaci děje při resharding?
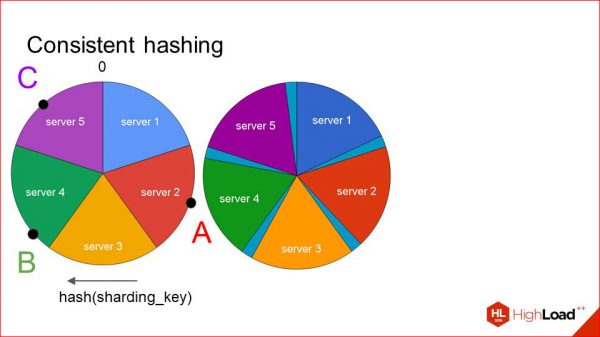
Nezplatňujeme celou cache, jako dříve, a neposouváme všechny klíče, ale posouváme každý sektor na malé vzdálenosti tak, aby se na uvolněné místo, řekněme, vešel náš šestý server, který chceme přidat, a přidáváme ho tam.
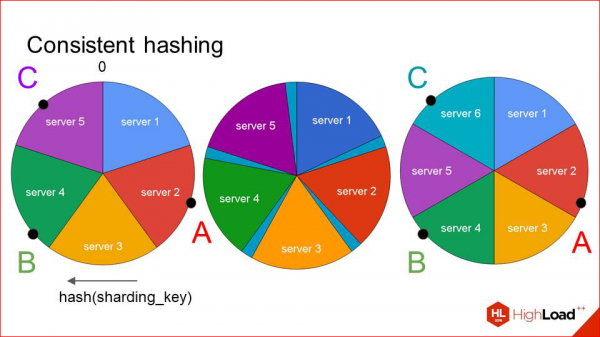
Jistě, v takové situaci klíče také selhávají. Ale selhávají mnohem méně než dříve. A vidíme, že naše dva první klíče zůstaly na svých serverech, a cachiovací server se změnil pouze pro poslední klíč. Funguje to dost efektivně, a pokud přidáváte nové hosty inkrementálně, není v tom velký problém. Po malých krocích přidáváte, čekáte, až se cache opět naplní, a všechno dobře funguje.
Jediná otázka zůstává při selháních. Předpokládejme, že nám nějaké zařízení selhalo.
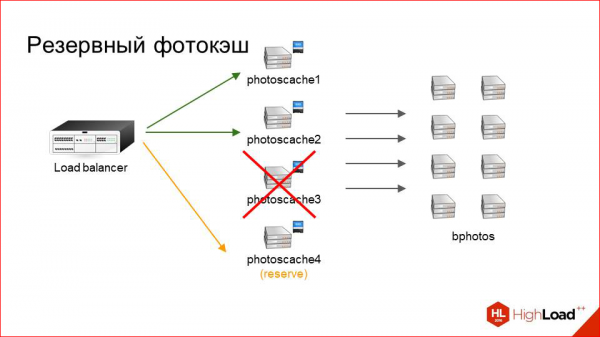
A v tu chvíli bychom nechtěli znovu generovat tuto mapu, invalidovat část cache atd., pokud se například stroj restartoval a my musíme nějak obsluhovat požadavky. Na každé lokalitě máme pouze jeden záložní fotokache, který plní roli náhrady pro kterýkoli stroj, který právě selhal. A pokud se náhodou nějaký server stal nedostupným, provoz jde tam. Samozřejmě tam v tuto chvíli nemáme žádnou cache, tj. je studená, ale minimálně požadavky uživatelů jsou zpracovávány. Pokud je to krátký interval, zvládáme to zcela běžně. Jen více zatížení na úložišti. Pokud je to delší interval, můžeme se už rozhodnout — zda ten server z mapy odstranit nebo ne, nebo třeba nahradit jiným.
To je ohledně systému cachingu. Podívejme se na výsledky.
Na první pohled se zdá, že tady není nic složitého. Ale takový způsob správy cache nám dal hit rate kolem 98 %. Tj. z těch 80 tisíc požadavků za sekundu pouze 1600 dorazí k úložištím, a to je zcela normální zátěž, kterou to v klidu zvládá, máme vždy rezervu.
Umístili jsme tyto servery do tří našich datových center a získali tři místa přítomnosti — Praha, Miami a Hongkong.
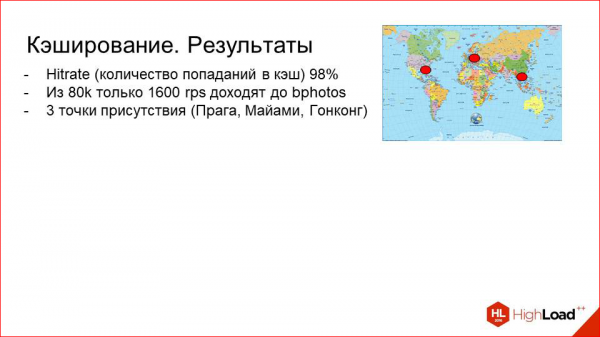
Tím pádem jsou více méně lokálně umístěny k každému z našich cílových trhů.
A jako příjemný bonus jsme získali tento cachiovací proxy, na kterém CPU vlastně nepracuje, protože pro poskytování obsahu není tolik potřeba. A tam jsme pomocí NGINX + Lua implementovali opravdu mnoho utilitární logiky.
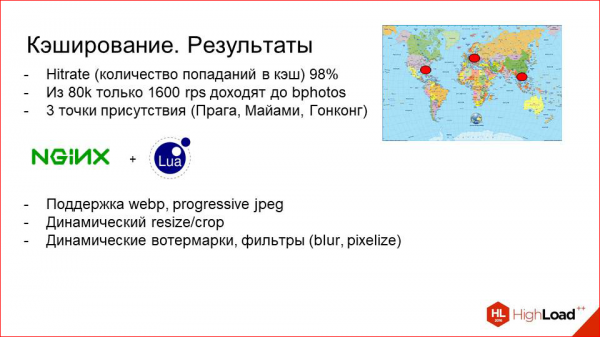
Například můžeme experimentovat s webp nebo progresivním jpeg (to jsou efektivní moderní formáty), sledovat, jak to ovlivňuje provoz, přijímat rozhodnutí, zapínat pro určité země atd.; provádět dynamické změny velikosti nebo ořezávání fotografií za běhu.
To je dobrý případ použití, kdy máte například mobilní aplikaci, která zobrazuje fotografie, a mobilní aplikace nechce zatěžovat CPU klienta tím, že by požadovala velkou fotografii a poté ji změnila na nějakou velikost, aby ji mohla umístit do zobrazení. Můžeme jednoduše dynamicky určit v URL nějaké parametry v hypotetickém UPort, a fotokontrola sama změní velikost fotografie. Obvykle vybere tu velikost, kterou máme fyzicky na disku, maximálně blízkou požadované, a zmenší ji v konkrétních již daných rozměrech.
Mimochodem, zveřejnili jsme videonahrávky z posledních pěti let konferencí pro vývojáře vysoce zatížených systémů. . Sledujte, studujte, sdílejte a přihlašte se k odběru .
Také můžeme přidávat spoustu produktové logiky. Například můžeme podle parametrů URL přidávat různé vodoznaky, můžeme rozmazávat fotografie, zamlžovat nebo pixelizovat. To je, když chceme ukázat fotografii osoby, ale nechceme ukázat její obličej, to dobře funguje, všechno je to realizováno zde.
Co jsme získali? Získali jsme tři body přítomnosti, dobrou míru hitů a zároveň nám neprostoje CPU na těchto strojích. Stal se nyní důležitějším než dřív. Musíme nasadit silnější stroje, ale stojí to za to.
Co se týče dodávání fotografií. Tady je to dost jasné a zřejmé. Myslím, že jsem neobjevil Ameriku, takto funguje prakticky každý CDN.
A pravděpodobně by si zkušený posluchač mohl položit otázku: proč prostě nevzít a nezměnit všechno na CDN? Bylo by to přibližně to stejné, všechny moderní CDN to umí. A zde je několik důvodů.
První — to jsou fotografie.
To je jeden z klíčových momentů naší infrastruktury, a potřebujeme nad nimi co největší kontrolu. Pokud jde o nějaké řešení od třetí strany a nemáte nad ním žádnou moc, bude pro vás dost obtížné s tím žít, když máte velký dataset a když máte velmi velký proud požadavků od uživatelů.
Uvádím příklad. V současnosti můžeme, například v případě nějakých problémů nebo pulsování země, vstoupit na server a ladit tam, řekněme. Můžeme přidat sběr nějakých metrik, které potřebujeme, experimentovat, sledovat, jak to ovlivní grafy atd. V současnosti sbíráme velké množství statistik o tomto cachovacím clusteru. A pravidelně se na ně díváme a dlouho zkoumáme nějaké anomálie. Kdyby to bylo na straně CDN, bylo by mnohem těžší to kontrolovat. Nebo například, když dojde k nějaké havárii, víme, co se stalo, víme, jak s tím žít a jak to překonat. To je první závěr.
Druhý závěr je spíše historický, protože systém se vyvíjí již dlouho a na různých etapách bylo mnoho různých požadavků na podnikání, a ne vždy se vejdou do koncepce CDN.
A bod, který vyplývá z předchozího –
Je to, že na fotok cache máme hodně specifické logiky, kterou není vždy možné přidat na požádání. Stěží by nějaké CDN na vaši žádost přidávalo nějaké individuální prvky. Například šifrování URL, pokud nechcete, aby klient mohl něco měnit. Chcete změnit URL na serveru a zašifrovat ji, a potom sem předat nějaké dynamické parametry.
Jaký závěr tedy vyplývá? V našem případě CDN není příliš dobrá alternativa.
Ale ve vašem případě, pokud máte nějaké specifické obchodní požadavky, můžete si bezstarostně realizovat to, co jsem vám ukázal. A při podobném zatížení to bude skvěle fungovat.
Ale pokud máte nějaké obecné řešení a úkol není příliš specifický, můžete s klidem použít CDN. Nebo pokud je pro vás mnohem důležitější čas a zdroje než kontrola.
A moderní CDN mají prakticky vše, co jsem vám právě řekl, s výjimkou +/- nějakých funkcí.
To je ohledně předávání fotografií.
Teď se posuňme trochu vpřed v našem retrospektivě a pojďme mluvit o ukládání.
Šel rok 2013.
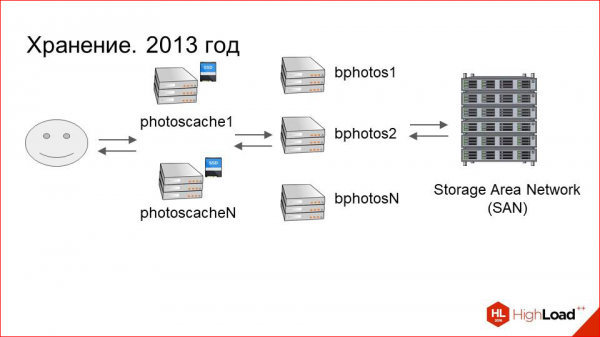
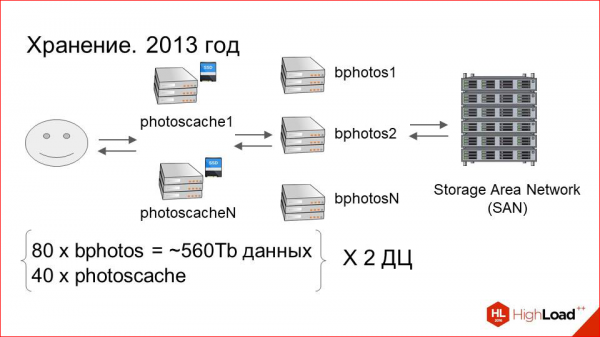
Cache servery byly přidány, problémy s výkonem zmizely. Všechno je v pořádku. Dataset roste. V roce 2013 jsme měli přibližně 80 serverů připojených k úložištím a přibližně 40 cache serverů v každém datovém centru. To je 560 terabajtů dat na každém datovém centru, což je dohromady kolem petabajtu.
A se zvýšením datasetu začaly dramaticky růst provozní náklady. V čem to spočívalo?
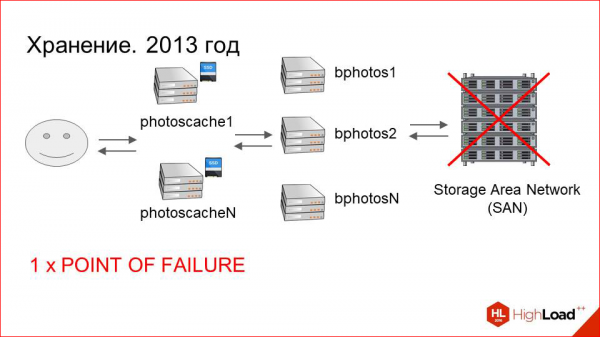
V tomto schématu, které je zobrazeno — se SANem, připojenými stroji a cache servery — existuje mnoho bodů selhání. Zatímco s výpadky cache serverů jsme se již dříve vypořádali, tam je to více méně předvídatelné a jasné, na straně úložiště to bylo mnohem horší.
Za prvé, samotná Storage Area Network (SAN) může selhat.
Za druhé, je připojena optikou k koncovým strojům. Může být problém s optickými kartami a switchemi.
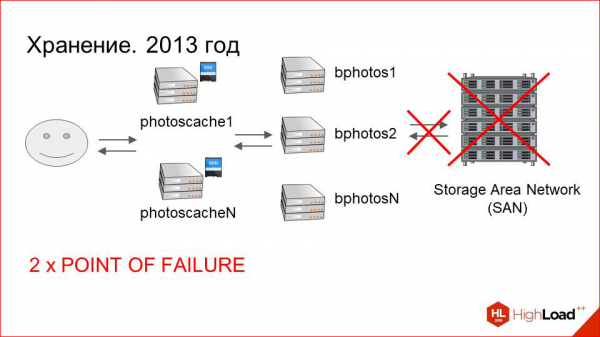
Samozřejmě, těch není tolik jako s samotným SANem, ale přesto jsou to také body selhání.
Dále samotný stroj, který je připojen k úložišti. Ten také může selhat.
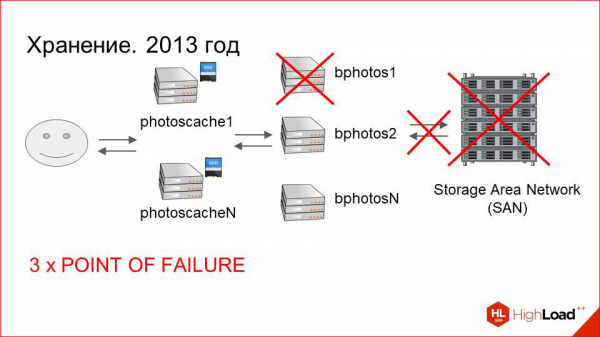
Celkem máme tři body selhání.
Kromě bodů selhání je to náročný údržbový proces samotných úložišť.
Je to složitý vícestupňový systém, a systémovým inženýrům se s ním někdy těžko pracuje.
A poslední, nejdůležitější bod. Pokud v kterékoliv z těchto tří bodů dojde k selhání, máme nějakou pravděpodobnost ztráty uživatelských dat, protože může být poškozen souborový systém.
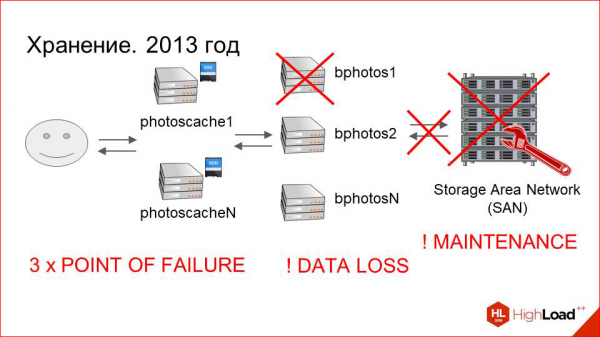
Představme si, že nám byl poškozen souborový systém. Jeho obnova trvá, za prvé, dlouho — může to trvat týden při velkém objemu dat. A za druhé, pravděpodobně nakonec získáme spoustu nejasných souborů, které bude třeba nějak přiřadit k fotografiím uživatelů. A my rizikujeme ztrátu dat. Riziko je dost vysoké. A čím častěji se takové situace vyskytují a čím více problémů se ve všech těchto vazbách objevuje, tím je toto riziko vyšší.
S tím bylo třeba něco udělat. A rozhodli jsme, že jednoduše zálohujeme data. To je vlastně zřejmé a dobré řešení. Co jsme udělali?
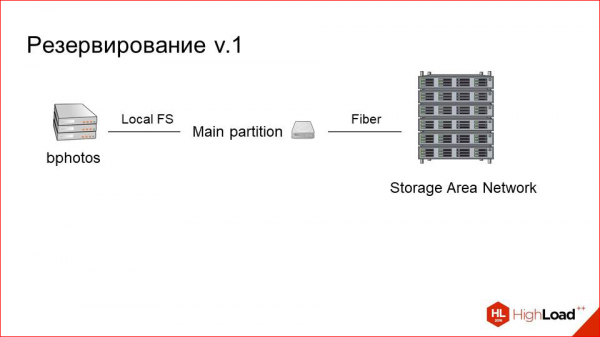
Takto vypadal náš server, který byl dříve připojen k úložišti. To je jedna hlavní partition, což je v podstatě blokové zařízení, které představuje skutečný mount na vzdálené úložiště optikou.
Jednoduše jsme přidali druhou partition.
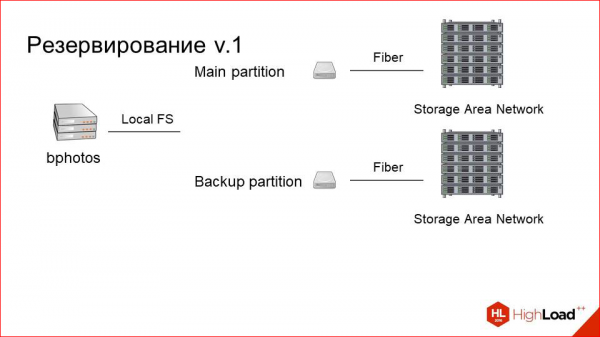
Umístili jsme druhé storage vedle (naštěstí to není tak drahé), a pojmenovali jsme ho jako záložní oddíl. Také je připojen optikou, nachází se na stejné mašině. Ale musíme nějak synchronizovat data mezi nimi.
Zde jednoduše vytváříme vedle asynchronní frontu.
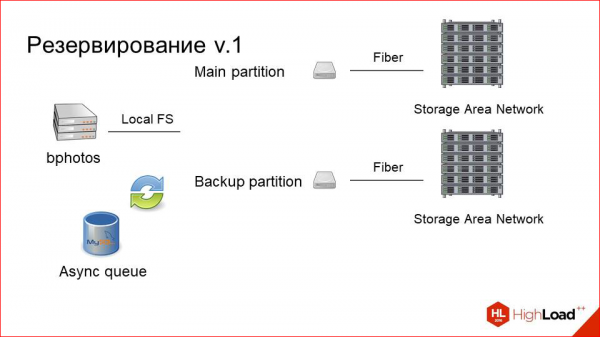
Není to příliš zatížené. Víme, že máme málo záznamů. Fronta je jednoduše tabulka v MySQL, do které se zapisují řádky typu "je třeba zálohovat tento obrázek". Při jakékoliv změně nebo uploadu kopírujeme z hlavního oddílu na záložní asynchronně nebo nějakým background workerem.
A tímto způsobem máme vždy dva konzistentní oddíly. I když jedna část tohoto systému selže, vždy můžeme vyměnit hlavní oddíl se záložním a všechno bude pokračovat v chodu.
Ale kvůli tomu výrazně narůstá zátěž na čtení, protože kromě klientů, kteří čtou z hlavního oddílu, protože si nejdříve prohlížejí obrázek tam (je tam novější), a pak hledají na záložním, pokud nenašli (ale to už dělá pouze NGINX), také naše zálohovací systém nyní čte z hlavního oddílu. Není to tak, že by to bylo úzké místo, ale nechtěli jsme zbytečně zvyšovat zátěž.
A přidali jsme třetí disk, který je malý SSD, a nazvali jsme ho bufferem.
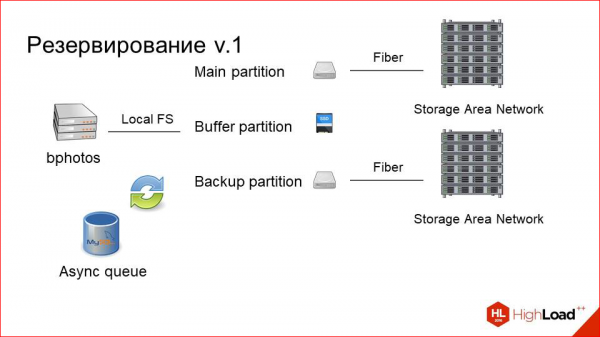
Jak to nyní funguje.
Uživatel uploaduje fotku do bufferu, poté se odešle událost do fronty o tom, že je třeba ji zkopírovat na dva oddíly. Je zkopírována a fotografie nějaký čas (řekněme jeden den) žije v bufferu, a teprve poté se odstraní. To výrazně zlepšuje uživatelskou zkušenost, protože uživatel nahrává fotografii, a obvykle se ihned začínají objevovat požadavky, nebo sám aktualizuje stránku, refreshuje. Ale to všechno závisí na aplikaci, která provádí upload.
Nebo, například, jiné lidi, kterým začal ukazovat, ihned za touto fotkou posílají požadavky. V cache ještě není, první požadavek probíhá velmi rychle. V podstatě, stejně jako s fotokashou. Pomalé storage se na tom vůbec nepodílí. A když bude po dni odstraněna, již je buď uložena v naší cache vrstvě, nebo pravděpodobně nikomu není potřeba. Tedy, uživatelská zkušenost zde výrazně vzrostla díky takovým jednoduchým manipulacím.
A co je nejdůležitější: přestali jsme ztrácet data.
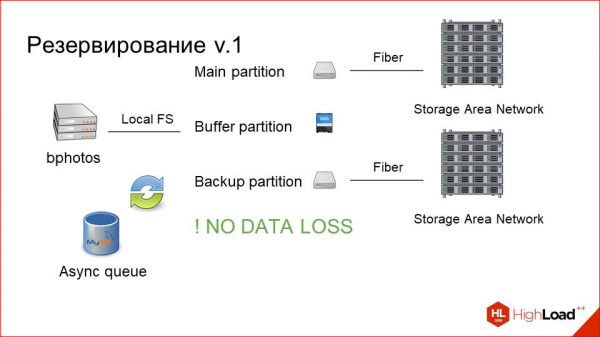
Řekněme, že jsme přestali potenciálně ztrácet data, protože jsme je vlastně příliš neztráceli. Ale nebezpečí tu bylo. Vidíme, že takové řešení je určitě dobré, ale vypadá to trochu jako zmírnění symptomů problému, místo abychom ho vyřešili do hloubky. Některé problémy zde zůstaly.
Za prvé, jde o bod selhání v podobě samotného fyzického hostitele, na němž celá tato mašinerie běží, ten nikam nezmizel.
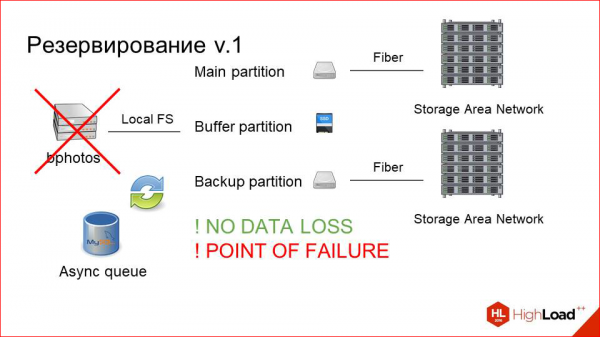
Za druhé, zůstaly problémy se SANy, zůstal jejich těžký provoz a tak dále. To nebylo kritickým faktorem, ale chtěli jsme zkusit žít bez toho.
A vytvořili jsme třetí verzi (ve skutečnosti druhou) – verzi zálohování. Jak to vypadalo?
To je to, co bylo –
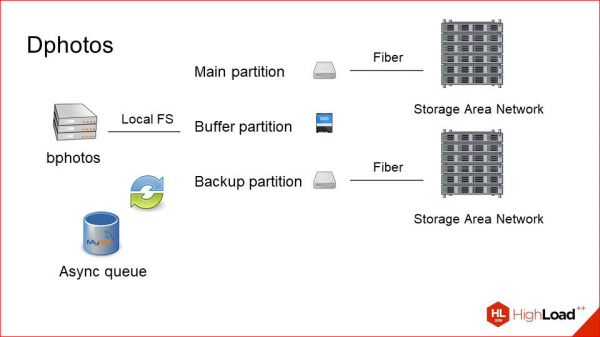
Hlavní problémy máme s tím, že je to fyzický hostitel.
Nejprve odstraňujeme SANy, protože chceme experimentovat, chceme zkusit prostě lokální pevné disky.
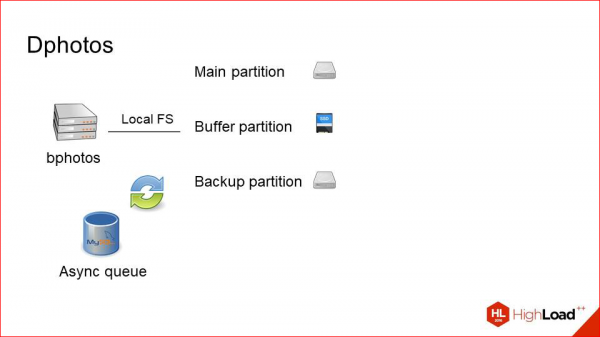
Je to už rok 2014-2015 a tehdy se situace s disky a jejich kapacitou na jeden host zlepšila. Rozhodli jsme se, proč to nevyzkoušet.
A poté jednoduše vezmeme naši zálohovací část a fyzicky ji přeneseme na samostatný stroj.
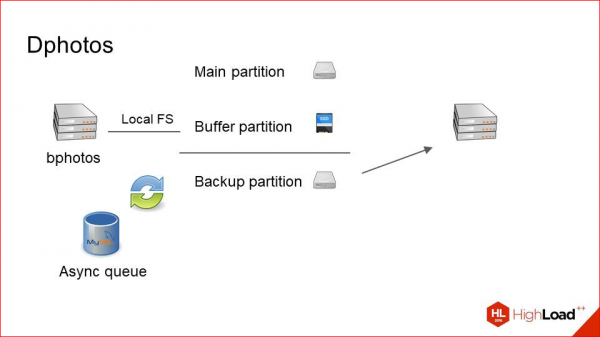
Tak dostaneme takovou schématickou strukturu. Máme dvě zařízení, která uchovávají identické datasetty. Kompletně se vzájemně zálohují a synchronizují data přes síť pomocí asynchronní fronty ve stejném MySQL.
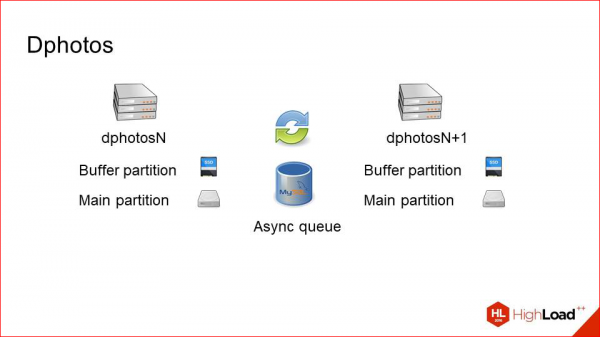
Proč to dobře funguje — protože máme málo zápisů. Tedy, kdyby byl zápis srovnatelný se čtením, možná bychom dostali nějaký síťový nadbytek a problémy. Zápis je málo, čtení hodně — tento způsob funguje dobře, tedy dost zřídka kopírujeme fotografie mezi těmito dvěma servery.
Jak to přesně funguje, pokud se na to podíváme podrobněji.
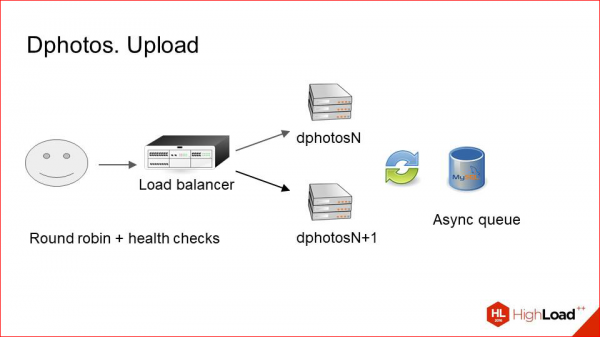
Nahrávání. Zatěžovací balancer jednoduše vybírá náhodné hostitele s párem a provádí na něj nahrávání. Přitom samozřejmě provádí zdravotní kontroly, aby zkontroloval, že stroj nevyšel. Tedy nahrává fotky pouze na živý server, a pak se to vše přes asynchronní frontu kopíruje na jeho souseda. S nahráváním je to naprosto jednoduché.
S úkolem je to o něco složitější.
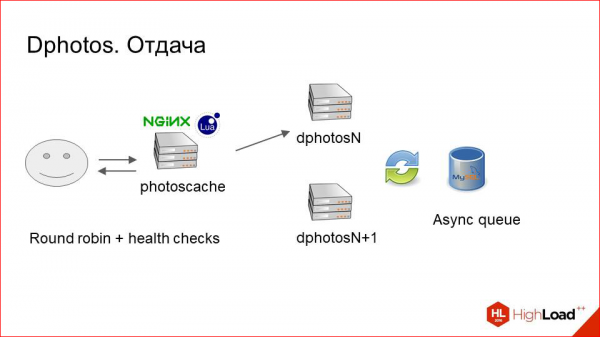
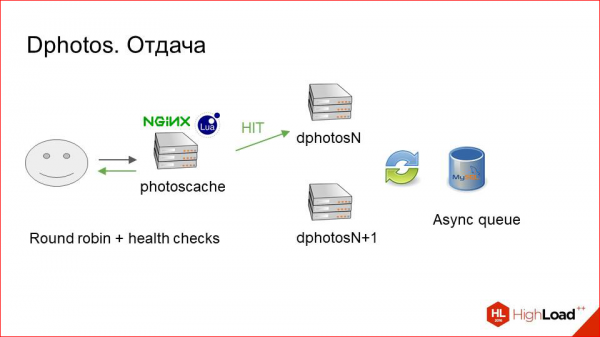
Zde nám pomohl Lua, protože na vanilkovém NGINXu je takovou logiku obtížné realizovat. Nejdříve děláme dotaz na první server, zkontrolujeme, zda tam je fotografie, protože potenciálně může být nahraná třeba na sousední server a sem se ještě nedostala. Pokud je fotografie tam, je to skvělé. Hned ji předáme klientovi a možná ji uložíme do cache.
Pokud tam není, jednoduše uděláme dotaz na souseda a odtud ji garantovaně získáme.
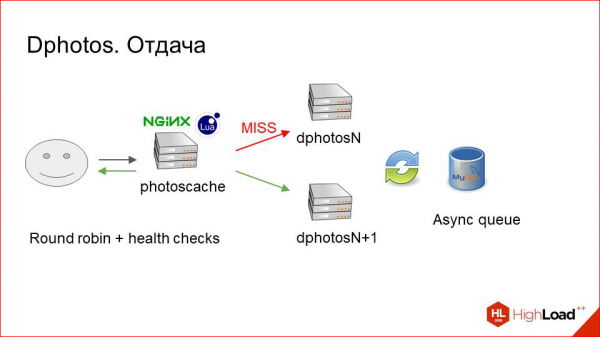
Tak můžeme opět říci: mohou být problémy s výkonem, protože neustálé round tripy – fotografii nahráli, tady ji není, děláme dva dotazy místo jednoho, to by mělo běžet pomalu.
V naší situaci to nefunguje pomalu.
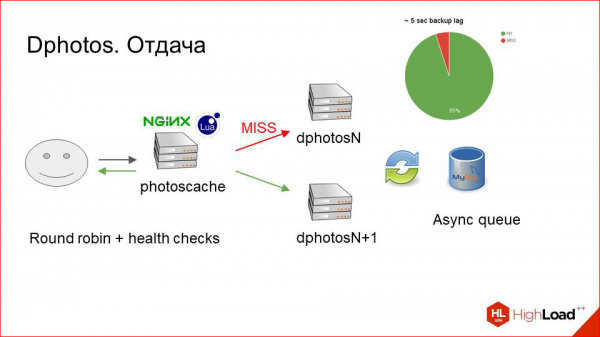
Shromažďujeme spoustu metrik podle tohoto systému a podmínkový hit rate tohoto mechanizmu činí kolem 95 %. Tedy zpoždění tohoto zálohování je malé a díky tomu prakticky garantujeme, že poté, co byla fotka nahraná, ji získáme už na první pokus a nikam dvakrát nechodíme.
Tak tedy, co jsme ještě získali, a co je opravdu skvělé?
Dříve jsme měli hlavní zálohovací oddíl a četli jsme z něj postupně. Tedy vždy jsme nejprve hledali na hlavním a pak na záložním. To byla jedna cesta.
Teď využíváme čtení ze dvou strojů najednou. Rozdělujeme dotazy Round Robinem. V malém procentu případů děláme dva dotazy. Ale celkově máme nyní dvakrát větší rezervu pro čtení, než jsme měli předtím. A zátěž se opravdu výrazně snížila jak na výstupních strojích, tak přímo na úložištích, která jsme v té době také měli.
Pokud jde o odolnost proti poruchám. O to jsme se především snažili. S odolností zde všechno dopadlo skvěle.
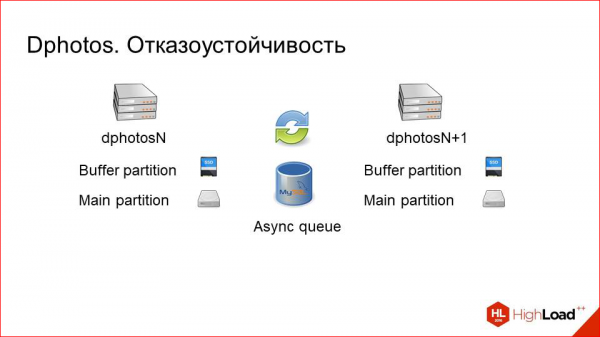
Jedna mašina selže.
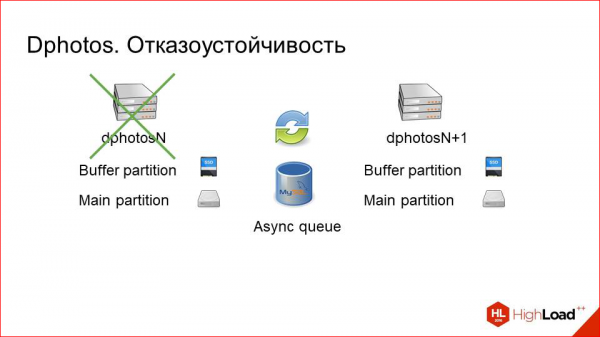
Žádné problémy! Systémový inženýr si dokonce může v noci ani nevstávat, počká do rána, nic hrozného se nestane.
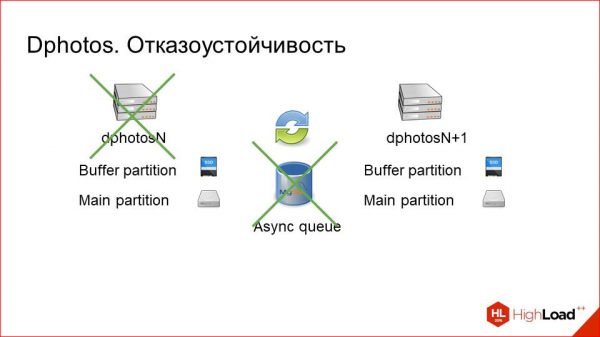
Pokud by při selhání této mašiny selhala i fronta, také žádné problémy, log se nejprve hromadí na živé mašině a pak se již dostává do fronty, a poté na tu mašinu, která se uvede do provozu po nějakém čase.
To samé platí pro údržbu. Jenom vypneme jeden ze strojů, ručně jej vyjmeme ze všech poolů, přestane k němu proudit provoz, provedeme nějakou údržbu, něco upravíme a pak ho vrátíme do provozu. A tento backup se dostihne dost rychle. Tedy, za den výpadku jednoho zařízení se dohoní v řádu několika minut. To je opravdu velmi málo. Co se týče odolnosti, opět říkám, zde je vše skvělé.
Jaké závěry můžeme učinit z této schématu zajištění redundancy?
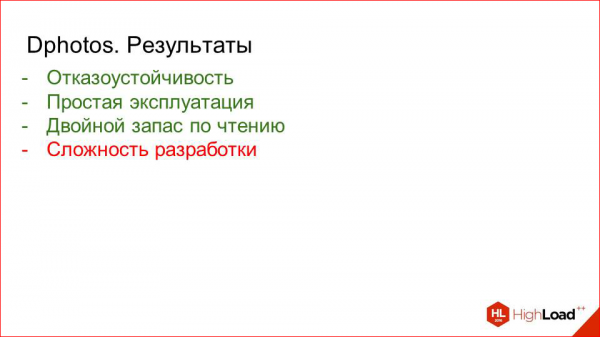
Získali jsme odolnost.
Jednoduché používání. Protože na strojích jsou lokální tvrdé disky, je to mnohem pohodlnější z pohledu provozu inženýrů, kteří s tím pracují.
Získali jsme dvojnásobnou rezervu pro čtení.
To je velmi dobrý bonus k odolnosti.
Ale jsou tu i problémy. Teď máme mnohem složitější vývoj nějakých funkcí, které s tím souvisejí, protože systém se stal na 100 % nakonec konzistentním.
Musíme říct například v nějakém background jobu neustále přemýšlet: "Na jakém serveru jsme teď spuštěni?", "Existuje zde opravdu aktuální fotka?" apod. To je samozřejmě vše zabaleno do wrapperů a pro programátora, který píše obchodní logiku, je to transparentní. Nicméně, i tak se objevil větší složitý vrstvu. Ale jsme ochotni se s tím smířit výměnou za ty bonusy, které jsme z toho získali.
A opět se objeví nějaký konflikt.
Na začátku jsem říkal, že uchovávat vše na lokálních tvrdých discích je špatné. A teď říkám, že se nám to líbí.
Ano, v průběhu času se situace výrazně změnila a nyní má tento přístup mnoho výhod. Za prvé, získáváme mnohem jednodušší použití.
Za druhé, je to výkonnější, protože nemáme tyto automatické kontrolery, připojení na diskové pole.
Tam je obrovská mašinerie, a to jsou prostě několik disků, které jsou konkrétně zde v zařízení uspořádány do RAIDu.
Ale jsou tu i nevýhody.
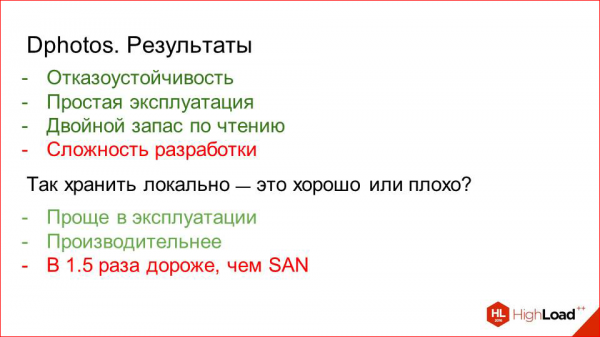
Je to přibližně 1,5krát dražší než používat SANy, i za dnešní ceny. Proto jsme se rozhodli tak směle nekonvertovat celý náš velký cluster na zařízení s lokálními tvrdými disky a rozhodli jsme se ponechat hybridní řešení.
Polovina strojů u nás pracuje s pevnými disky (no, ne polovina – asi tak 30 procent). A zbývající část tvoří staré stroje, na kterých dříve běžela první verze zálohování. Jen jsme je znovu zamontovali, protože nepotřebujeme žádná nová data ani nic jiného, prostě jsme přehodili mounty z jednoho fyzického hostitele na dva.
A máme velkou rezervu v čtení, a zjednodušili jsme to. Pokud jsme dříve montovali jeden storage na jeden stroj, nyní montujeme čtyři na jeden pár, například. A to funguje normálně.
Shrňme krátce, co jsme dosáhli, za co jsme bojovali, a zda se nám to povedlo.
Závěry
Máme uživatele – celých 33 milionů.
Máme tři místa přítomnosti – Praha, Miami, Hongkong.
V nich je umístěn cache layer, který tvoří stroje s rychlými místními disky (SSD), na kterých běží jednoduchá architektura z NGINX, jeho access.loga a démonů na Pythonu, kteří to všechno zpracovávají a spravují cache.
Pokud chcete, můžete ve svém projektu, pokud pro vás nejsou fotky tak kritické jako pro nás, nebo pokud je pro vás trade-off mezi kontrolou a rychlostí vývoje a náklady na zdroje v jiném poměru, pak můžete v klidu nahradit jeho CDN, moderní CDN to dělají dobře.
Dále následuje úložný layer, na kterém máme clustery ze strojů, které se vzájemně zálohují, asynchronně kopírují soubory z jednoho na druhý při jakékoli změně.
Přitom část těchto strojů pracuje s místními pevnými disky.
Část těchto strojů je připojena k SAN.
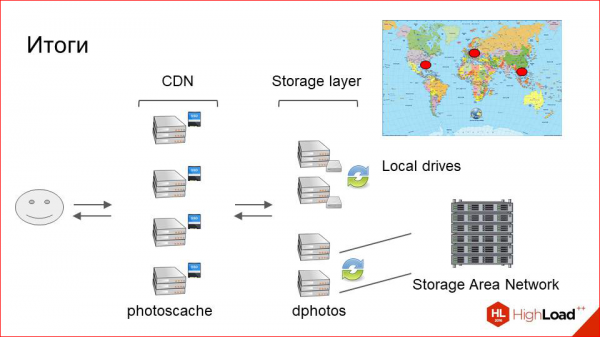
Na jedné straně je to pohodlnější při provozu a trochu více výkonné, na druhé straně je to pohodlné z hlediska hustoty umístění a ceny za gigabyte.
To je takový stručný přehled architektury toho, co jsme dosáhli a jak to všechno probíhalo.
Ještě několik jednoduchých rad od lídra.
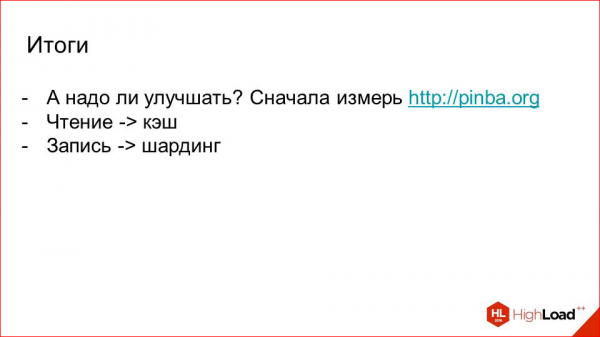
Za prvé, pokud se náhle rozhodnete, že musíte všechno zlepšit ve vaší infrastruktuře fotografií, nejprve změřte, protože možná není třeba nic zlepšovat.
Dám příklad. Máme cluster strojů, který poskytuje fotografie z příloh v chatech, a tam stále funguje schéma z roku 2009, a nikdo z toho netrpí. Všem je dobře, všichni jsou spokojeni.
Aby se měřilo, nejprve nastavte několik měřítek, podívejte se na ně a pak se rozhodněte, co vám nevyhovuje a co je třeba zlepšit. Pro měření máme skvělý nástroj, který se nazývá Pinba.
Umožňuje sbírat velmi podrobné statistiky z NGINX pro každý požadavek, kódy odpovědí a rozdělení časů - cokoliv budete potřebovat. Má vazby na různé analytické systémy, takže to můžete krásně sledovat.
Nejprve jsme změřili - pak jsme vylepšili.
Dále. Čtení optimalizujeme pomocí cache, zápis - shardingem, ale to je samozřejmý bod.
Dále. Pokud právě teď začínáte budovat svůj systém, je mnohem lepší uchovávat fotografie jako immutable soubory. Tak se vyhnete mnoha problémům s invalidací cache, jak by logika měla najít správnou verzi fotografie apod.
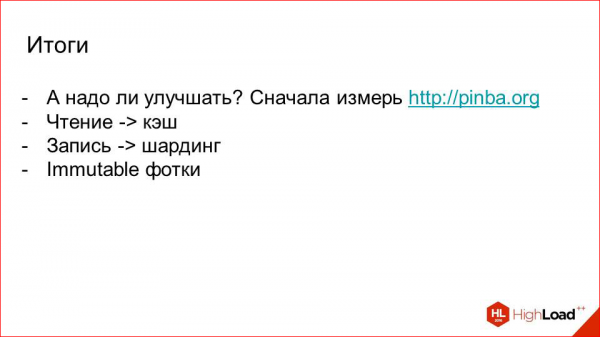
Představte si, že jste nahráli stovku, poté ji otočili, uděláte tak, aby to byl fyzicky jiný soubor. Tedy není třeba přemýšlet: teď ušetřím trochu místa, zapíšu do toho samého souboru, změním verzi. To nikdy nefunguje dobře, s tím později bude mnoho starostí.
Další bod. O resize naživo.
Dříve, když uživatelé nahrávali fotografii, ihned jsme vytvořili celou řadu velikostí na všechny možné případy pro různé klienty, a všechny tyto obrázky ležely na disku. Teď jsme od toho upustili.
Nechali jsme pouze tři základní velikosti: malé, střední a velké. Vše ostatní jednoduše zmenšujeme z velikosti, která odpovídá tomu, co bylo požadováno v Uportu, prostě provedeme downsizing a předáme uživateli.
CPU cache vrstvy je zde mnohem levnější, než kdybychom neustále znovu generovali tyto velikosti na každém úložišti. Pokud například chceme přidat novou, trvá to měsíc - spustit skript, který by to vše řádně udělal, aniž by se zhroutila cluster. Tedy pokud je to nyní možné, lépe mít co nejméně fyzických velikostí, ale aby alespoň nějaké rozložení bylo, dejme tomu tři. A všechno ostatní jednoduše resize naživo pomocí připravených modulů. To je teď velmi snadné a dostupné.
A inkrementální asynchronní záloha - to je dobré.
Jak ukázala naše praxe, takový systém skvěle funguje s odloženým kopírováním změněných souborů.
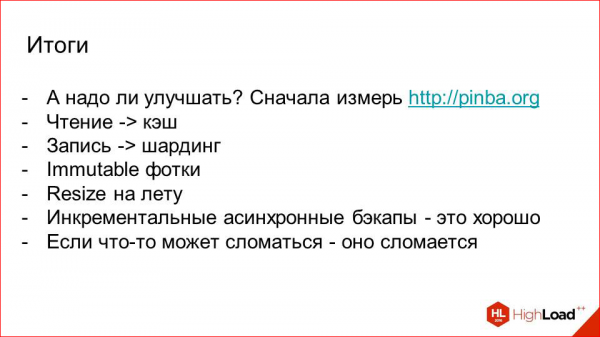
Poslední bod je také zřejmý. Pokud ve vaší infrastruktuře momentálně takové problémy nejsou, ale existuje něco, co by mohlo selhat, určitě to selže, jakmile se to mírně zhorší. Proto je lepší o tom přemýšlet předem a vyhnout se takovým problémům. To je ode mě vše.
Kontakty
»
»
Tato prezentace je přepisem jednoho z nejlepších vystoupení na konferenci o vývoji systémů s vysokou zátěží. . Do konference HighLoad++ 2017 zbývá méně než měsíc.
Máme už připraveno , aktuálně se aktivně sestavuje rozvrh.
Tento rok pokračujeme ve zkoumání tématu architektur a škálování:
- / Игорь Васильев
- / Дмитрий Егоров
- / Анатолий Пласковский
- / Роман Шеховцов, Алексей Громатчиков
- / Филипп Дельгядо
Některé z těchto materiálů používáme také v našem online kurzu o vývoji systémů s vysokou zátěží. — je to řetězec speciálně vybraných e-mailů, článků, materiálů a videí. Již nyní v našich učebnicích máme více než 30 jedinečných materiálů. Připojte se!
Zdroj: habr.com
