

Jak lze převést obchodní požadavky do konkrétních datových struktur na příkladu navrhování databáze "od nuly" pro messenger.
- Část 1: navrhujeme rámec databáze
Naše databáze nebude tak rozsáhlá a distribuovaná, nebo , ale "aby to bylo", a přitom dobře — funkčně, rychle a vešlo se na jeden server PostgreSQL — aby bylo možné nasadit samostatnou instance služby někde bokem, například.
Proto se nebudeme dotýkat otázek shardingu, replikace a geograficky distribuovaných systémů, ale zaměříme se na schématická řešení uvnitř DB.
Krok 1: Trochu obchodní specifiky
Naši zprávu budeme navrhovat nikoli abstraktně, ale integrovat ji do prostředí . To znamená, že lidé u nás ne "jen tak si píší", ale komunikují mezi sebou v kontextu řešení určitých obchodních úkolů.
Jaké obchodní úkoly existují?.. Podíváme se na příkladu Vasila — vedoucího oddělení vývoje.
- "Nikole, k této úloze je patch potřeba už dnes!"
To znamená, že diskuse může probíhat v kontextu nějakého dokumentu. - "Kolja, jdeme večer na Dota?"
To znamená, že i u jednoho páru účastníků může komunikace probíhat na různá témata. - "Petře, Nikolaje, podívejte se v příloze na ceník nového serveru."
Tak, jedno zpráva může mít více adresátů. Přičemž zpráva může obsahovat připojené soubory. - "Semyone, podívej se také."
A měla by být možnost do již existující konverzace pozvat nového účastníka.
Zatím se zastavíme na tomto seznamu "očekávaných" potřeb.
Bez porozumění aplikační specifiky úkolu a jejím omezením je prakticky nemožné navrhnout efektivní schéma DB pro její řešení.
Krok 2: Minimální logické schéma
Schématicky to zatím vypadá velmi podobně jako emailová komunikace — tradiční nástroj pro podnikání. Ano, "algoritmicky" jsou si mnohé obchodní úkoly podobné, proto budou i nástroje pro jejich řešení strukturálně podobné.
Pojďme zafixovat už získané logické schéma vztahů entit. Pro zjednodušení pochopení naší modely využijeme nejjednodušší variantu zobrazení bez zbytečných UML nebo IDEF notací:
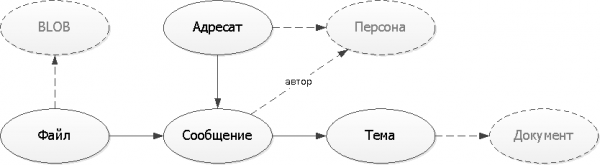
V našem příkladu jsou postava, dokument a binární "tělo" souboru "vnější" entity, které existují i bez naší služby. Proto je budeme dále vnímat jako odkazy "někam" podle UUID.
Kreslete schémata co nejjednodušeji — většina těch, kterým je budete ukazovat, nejsou experti na čtení UML/IDEF. Ale — kreslete určitě.
Krok 3: Návrh struktury tabulek
O názvech tabulek a políK "ruským" názvům polí a tabulek lze přistupovat různě, ale to už je otázka vkusu. Protože není žádný vývojář-cizinec, a PostgreSQL nám umožňuje dávat názvy i hieroglyfy, pokud jsou uzavřeny v uvozovkách, tak dáváme přednost jednoznačným názvům objektů, abychom předešli nejasnostem.
Vzhledem k tomu, že zprávy píše víc lidí najednou, někteří mohou dokonce činit tak v offline režimu, je nejjednodušší varianta — používat UUID jako identifikátory nejen pro vnější entity, ale i pro všechny objekty uvnitř naší služby. A můžete je generovat i na straně klienta — to nám pomůže uchovat odesílání zpráv během krátkodobé nedostupnosti DB, a pravděpodobnost kolize je extrémně nízká.
Návrh struktury tabulek v naší databázi přijme tento tvar:
Tabulky : RU
CREATE TABLE "Téma"(
  "Téma"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Název"
    text
);

CREATE TABLE "Zpráva"(
  "Zpráva"
    uuid
      PRIMARY KEY
, "Téma"
    uuid
, "Autor"
    uuid
, "DatumČas"
    timestamp
, "Text"
    text
);

CREATE TABLE "Adresát"(
  "Zpráva"
    uuid
, "Postava"
    uuid
, PRIMARY KEY("Zpráva", "Postava")
);

CREATE TABLE "Soubor"(
  "Soubor"
    uuid
      PRIMARY KEY
, "Zpráva"
    uuid
, "BLOB"
    uuid
, "Název"
    text
);
Tabulky : EN
CREATE TABLE theme(
  theme
    uuid
      PRIMARY KEY
, document
    uuid
, title
    text
);

CREATE TABLE message(
  message
    uuid
      PRIMARY KEY
, theme
    uuid
, author
    uuid
, dt
    timestamp
, body
    text
);

CREATE TABLE message_addressee(
  message
    uuid
, person
    uuid
, PRIMARY KEY(message, person)
);

CREATE TABLE message_file(
  file
    uuid
      PRIMARY KEY
, message
    uuid
, content
    uuid
, filename
    text
);
Nejdůležitější při popisu formátu je začít "rozkrývat" graf vazeb od tabulek, které se navzájem neodkazují samy na nikoho.
Krok 4: Zjistit nejasné potřeby
Všechno, navrhli jsme databázi, do které lze skvěle psát a nějak číst. číst.
Pojďme se vžít do role uživatele naší služby – co bychom s její pomocí chtěli dělat?
- Poslední zprávy
To je chronologicky seřazené podle různých kritérií rejstřík "mých" zpráv. Kde jsem jedním z adresátů, kde jsem autorem, kde mi bylo napsáno, ale já jsem neodpověděl, kde mi neodpověděli, … - Ú účastníci konverzace
Kdo se vůbec účastní tohoto dlouhého chatu?
Naše struktura umožňuje vyřešit oba tyto úkoly "v zásadě", ale rychle – ne. Problém spočívá v tom, že pro třídění v rámci prvního úkolu není možné vytvořit index, který by vyhovoval každému z účastníků (a bude nutné extrahovat všechny záznamy), a pro vyřešení druhého úkolu je nezbytné extrahovat všechny zprávy o tématu.
Nepředpokládané uživatelské úkoly mohou výrazně ovlivnit výkon.
Krok 5: Rozumná denormalizace
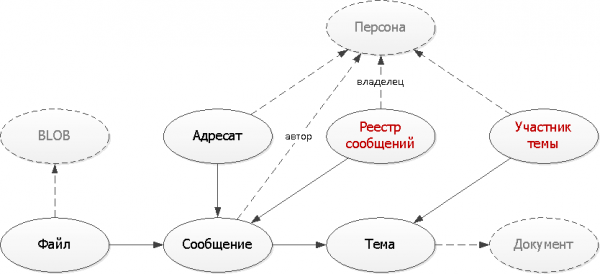
Obě naše problémy pomohou vyřešit dodatečné tabulky, do kterých budeme duplicovat část dat, potřebných pro vytváření na nich vhodných pro naše úkoly indexů.
Tabulky : RU
CREATE TABLE "RegistryZpráv"(
  "Vlastník"
    uuid
, "TypRegistru"
    smallint
, "DatumČas"
    timestamp
, "Zpráva"
    uuid
, PRIMARY KEY("Vlastník", "TypRegistru", "Zpráva")
);
CREATE INDEX ON "RegistryZpráv"("Vlastník", "TypRegistru", "DatumČas" DESC);

CREATE TABLE "ÚčastníkTématu"(
  "Téma"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Téma", "Osoba")
);
Tabulky : EN
CREATE TABLE message_registry(
  owner
    uuid
, registry
    smallint
, dt
    timestamp
, message
    uuid
, PRIMARY KEY(owner, registry, message)
);
CREATE INDEX ON message_registry(owner, registry, dt DESC);

CREATE TABLE theme_participant(
  theme
    uuid
, person
    uuid
, PRIMARY KEY(theme, person)
);
Zde jsme použili dva typické přístupy, které se uplatňují při vytváření pomocných tabulek:
- Násobení záznamů
Vytváříme z jedné základní zprávy hned několik následných záznamů v různých typech rejstříků pro různé vlastníky – jak pro odesílatele, tak pro příjemce. Každý z rejstříků nyní leží na indexu – vždyť typicky chceme vidět jen první stránku. - Unikalizace záznamů
Při každém odeslání zprávy v rámci konkrétního tématu stačí zkontrolovat, zda již takový záznam existuje. Pokud ne – přidáme jej do našeho „slovníku“.
V další části článku se budeme zabývat do struktury naší databáze.
Zdroj: habr.com
