

Úspěšně jsme navrhli strukturu naší databáze PostgreSQL pro uchovávání komunikace, uplynul rok, uživatelé ji aktivně zaplňují, a už v ní je miliony záznamů, a… něco začalo pomalu fungovat.
- Část 2: sekciujeme "naživo"
Věc se má tak, že s rostoucím objemem tabulky roste také "hloubka" indexů — i když logaritmicky. Ale časem to nutí server, aby pro provádění stejných úloh čtení/zápisu zpracovával mnohem více stránek dat, než tomu bylo na začátku.
Tady právě přichází na pomoc particionování.
Poznamenám, že se nejedná o shardování, tedy rozdělení dat mezi různé databáze nebo servery. Protože i když rozdělíte data na několik servery, nijak se nezbavíte problému "zvětšování" indexů časem. Je jasné, že pokud si můžete dovolit každý den uvést do provozu nový server, vaše problémy již nebudou ležet pouze v rovině konkrétní databáze.
My se však nebudeme zabývat konkrétními skripty pro implementaci partitioning "v hardwaru", ale samotným přístupem — co a jak by mělo být "nakrájeno na kousky", a k čemu vede taková snaha.
Koncept
Ještě jednou si vyjasníme náš cíl: chceme zajistit, aby jak dnes, tak zítra, tak i za rok zůstalo množství čitelných dat PostgreSQL při jakékoli operaci čtení/zápisu přibližně stejné.
Pro jakákoliv chronologicky shromažďovaná data (zprávy, dokumenty, logy, archivy, …) je přirozenou volbou jako klíč pro partitioning datum/čas události. V našem případě takovou událostí je moment odeslání zprávy.
Všimneme si, že uživatelé prakticky vždy pracují pouze s "nejnovějšími" těmito daty — čtou poslední zprávy, analyzují poslední logy,… Ne, samozřejmě, mohou se podívat i dál zpět v čase, ale dělají to velmi zřídka.
Z těchto omezení se stává zřejmé, že optimálním řešením pro zprávy budou "denní" sekce — vždyť téměř vždy náš uživatel čte to, co mu přišlo "dnes" nebo "včera".
Pokud během dne píšeme a čteme prakticky pouze v jedné sekci, dává nám to také efektivnější využití paměti a disku — protože všechny indexy sekce se snadno vejdou do paměti, na rozdíl od "velkých a tlustých" po celé tabulce.
postupně
Celkově to, co bylo řečeno výše, vypadá jako solidní zisk. Je to dosažitelné, ale abychom toho dosáhli, budeme se muset opravdu snažit — protože rozhodnutí sektorizovat jednu z entit vyžaduje "rozdělit" také související.
Zpráva, její vlastnosti a projekce
Pokud jsme se rozhodli rozdělit zprávy podle dat, má smysl rozdělit i závislé entity-vlastnosti (přílohy, seznam příjemců) a také podle data zprávy.
Jelikož jedním z našich standardních úkolů je právě prohlížení registrů zpráv (nepřečtené, příchozí, všechny), je logické "zapojit" je také do sektorování podle dat zpráv.
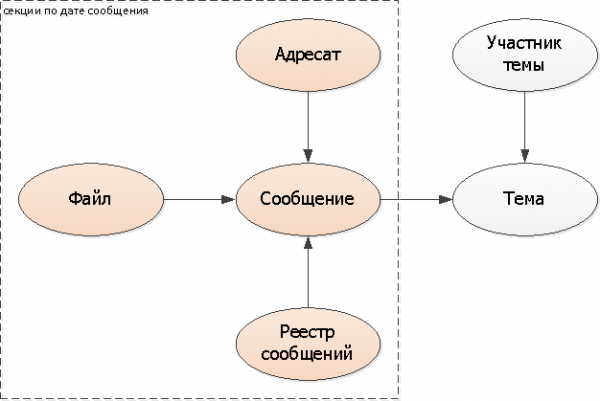
Přidáváme klíč sektorizace (datum zprávy) do všech tabulek: příjemci, soubor, registry. Do samotné zprávy jej nemusíme přidávat, můžeme použít existující DatumČas.
Témata
Jelikož je téma jedno na několik zpráv, nelze ho "rozdělit" v téže struktuře, musíme se spolehnout na něco jiného. V našem případě je ideálním řešením datum první zprávy v konverzaci — tedy moment vytvoření, vlastně, tématu.
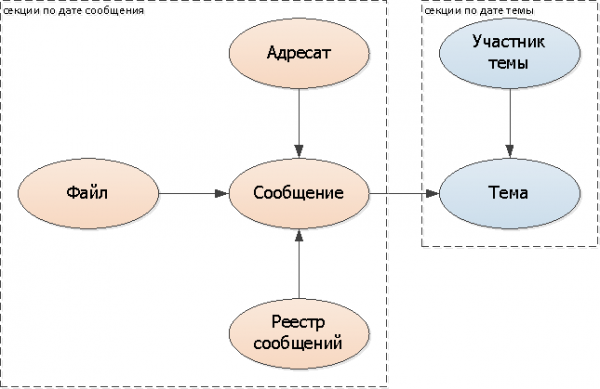
Přidáváme klíč sektorizace (datum tématu) do všech tabulek: téma, účastník.
Ale nyní se nám objevují hned dva problémy:
- ve které sekci hledat zprávy podle tématu?
- ve které sekci hledat téma od zprávy?
Samozřejmě, že můžeme pokračovat v hledání ve všech sekcích, ale to by bylo velmi smutné a anulovalo by to všechny naše zisky. Proto, abychom věděli, kde přesně hledat, vytvoříme logické odkazy/indikátory na sekce:
- do zprávy přidáme pole s datem tématu
- k tématu přidáme sadu dat zpráv této konverzace (může to být samostatná tabulka nebo pole dat)
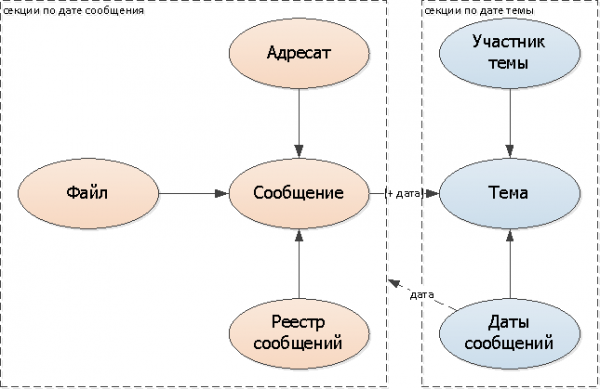
Jelikož modifikací seznamu dat zpráv pro každou jednotlivou konverzaci bude jen několik (všechny zprávy téměř obvykle spadají do 1-2 sousedních dnů), zastavím se právě na této variantě.
Ve zjednodušeném shrnutí, struktura naší databáze nyní vypadá takto, s přihlédnutím k sektorizaci:
Tabulky: RU, pokud máte averzi k cyrilici v názvech tabulek/polích, raději se na to nedívejte.
-- sekce podle data zprávy
CREATE TABLE "Zpráva_YYYYMMDD"(
  "Zpráva"
    uuid
      PRIMARY KEY
, "Téma"
    uuid
, "DatumTématu"
    date
, "Autor"
    uuid
, "DatumČasu" -- používáme jako datum
    timestamp
, "Text"
    text
);

CREATE TABLE "Adresát_YYYYMMDD"(
  "DatumZprávy"
    date
, "Zpráva"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Zpráva", "Osoba")
);

CREATE TABLE "Soubor_YYYYMMDD"(
  "DatumZprávy"
    date
, "Soubor"
    uuid
      PRIMARY KEY
, "Zpráva"
    uuid
, "BLOB"
    uuid
, "Název"
    text
);

CREATE TABLE "RejstříkZpráv_YYYYMMDD"(
  "DatumZprávy"
    date
, "Majitel"
    uuid
, "TypRejstříku"
    smallint
, "DatumČasu"
    timestamp
, "Zpráva"
    uuid
, PRIMARY KEY("Majitel", "TypRejstříku", "Zpráva")
);
CREATE INDEX ON "RejstříkZpráv_YYYYMMDD"("Majitel", "TypRejstříku", "DatumČasu" DESC);

-- sekce podle data tématu
CREATE TABLE "Téma_YYYYMMDD"(
  "DatumTématu"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Dokument"
    uuid
, "Název"
    text
);

CREATE TABLE "ÚčastníkTématu_YYYYMMDD"(
  "DatumTématu"
    date
, "Téma"
    uuid
, "Osoba"
    uuid
, PRIMARY KEY("Téma", "Osoba")
);

CREATE TABLE "DátaZprávTématu_YYYYMMDD"(
  "DatumTématu"
    date
, "Téma"
    uuid
      PRIMARY KEY
, "Datum"
    date
);
Šetříme korunu
A pokud nepoužijeme na základě rozdělení hodnot pole (přes spouštěče a dědictví nebo PARTITION BY), ale 'ručně' na úrovni aplikace, všimneme si, že hodnota klíče sekcionování je už uložena v názvu samotné tabulky.
Protože pokud jste tak hodně znepokojeni objemem ukládaných dat, můžete se těchto 'zbytečných' polí zbavit a přistupovat přímo ke konkrétním tabulkám. Pravda, všechny výběry z několika sekcí budete muset v tomto případě provést na straně aplikace.
Zdroj: habr.com
