

Čas pro reportování v Excelu rychle ubíhá — trend u pohodlných nástrojů pro prezentaci a analýzu informací je patrný ve všech oborech. Dlouho jsme diskutovali o digitalizaci reportování a vybrali jsme systém vizualizace a self-service analytiky Tableau. Alexander Bezugly, vedoucí oddělení analytických řešení a reportingu skupiny „M.Video-Eldorado“, hovořil o zkušenostech a výsledcích vytváření operativního dashboardu.
Řeknu hned, ne všechno, co bylo zamýšleno, se podařilo realizovat, ale zkušenost byla zajímavá, doufám, že bude užitečná i pro vás. A pokud někdo má nápady, jak to udělat lépe – budu velmi vděčný za rady a návrhy.
Pod katem o tom, s čím jsme se setkali a co jsme se naučili.
Jak jsme začínali
V „M.Video-Eldorado“ existuje dobře propracovaný model dat: strukturované informace s požadovanou hloubkou uložení a obrovské množství reportů fixního formátu (viz podrobněji ). Z nich analytici vytvářejí buď kontingenční tabulky nebo formátované zprávy v Excelu, nebo krásné prezentace v PowerPointu pro konečné uživatele.
Přibližně před dvěma lety jsme místo reportů fixního formátu začali vytvářet analytické reporty v SAP Analysis (rozšíření Excelu, v podstatě — kontingenční tabulka nad OLAP enginem). Tento nástroj však nedokázal pokrýt potřeby všech uživatelů, většina tak i nadále používala informace, které byly navíc zpracovány analytiky.
Naši koncoví uživatelé se dělí do tří kategorií:
Top management. Požaduje informace v dobře prezentované a vizuálně srozumitelné podobě.
Střední management, pokročilí uživatelé. Mají zájem o zkoumání dat a jsou schopni samostatně vytvářet reporty, pokud mají k dispozici nástroje. Právě oni se stali klíčovými uživateli analytických reportů v SAP Analysis.
Hromadní uživatelé. Není zájem o samostatnou analýzu dat, používají reporty s omezeným rozsahem svobody, v podobě rozesílek a kontingenčních tabulek v Excelu.
Naším cílem bylo pokrýt potřeby všech uživatelů a poskytnout jim jednotný pohodlný nástroj. Rozhodli jsme se začít s vrcholovým managementem. Potřebovali pohodlné panely pro analýzu hlavních obchodních výsledků. Tak jsme začali s Tableau a pro začátek jsme vybrali dvě oblasti: ukazatele prodeje v maloobchodu a online s omezenou hloubkou a šířkou analýzy, které by pokryly přibližně 80 % dat, která vrcholový management vyžaduje.
Jelikož uživateli dashboardů byl vrcholový management, vznikl další dodatečný KPI produktu – rychlost odezvy. Nikdo nebude čekat 20-30 sekund, než se aktualizují data. Navigace měla trvat 4-5 sekund, a ještě lépe reagovat okamžitě. Toho jsme, bohužel, dosáhnout nedokázali.
Takto vypadal návrh našeho hlavního dashboardu:
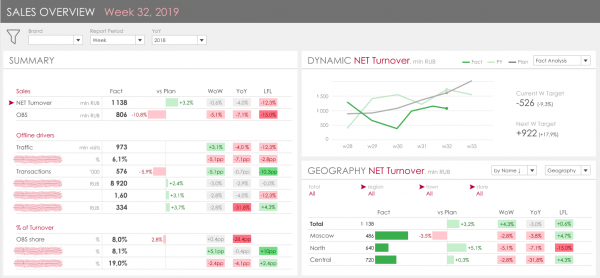
Hlavní myšlenka – spojit hlavní KPI-drivery, kterých nakonec je 19, vlevo a zobrazit jejich dynamiku a rozčlenění podle hlavních atributů vpravo. Úkol se zdá být jednoduchý, vizualizace logická a přehledná, dokud se nezačnete zabývat detaily.
Detail 1. Objem dat
Hlavní tabulka prodeje za rok tvoří přibližně 300 milionů řádků. Protože je třeba zobrazit i dynamiku ve srovnání s minulým a předminulým rokem, objem dat pouze o skutečných prodejích je kolem 1 miliardy řádků. A navíc se zvlášť uchovávají informace o plánovaných údajích a bloku internetových prodejů. I když jsme použili sloupcovou in-memory DB SAP HANA, rychlost dotazu při získání všech ukazatelů za jeden týden z aktuálních úložišť v reálném čase byla přibližně 15-20 sekund. Řešení tohoto problému je jasné – dodatečná materializace dat. Ale i v tom jsou skryté problémy, o nichž bude níže řeč.
Detail 2. Neaditivní ukazatele
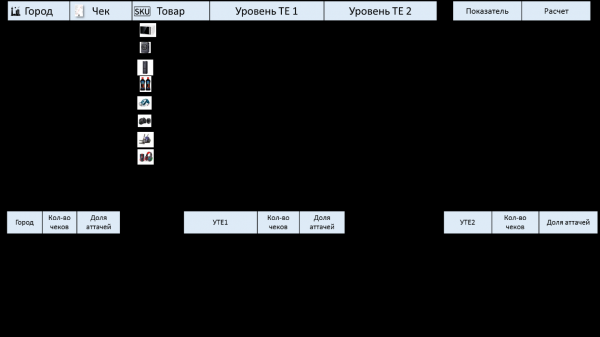
Mnoho našich KPI je závislých na počtu účtenek. Tento ukazatel je COUNT DISTINCT počtu řádků (hlaviček účtenek) a ukazuje různé částky v závislosti na vybraných atributech. Například, jak by se tento ukazatel a jeho odvozeniny měly počítat:
Pro správnost výpočtů je možné:
- Provádět výpočet podobných ukazatelů v reálném čase v úložišti;
- Provádět výpočet na celém objemu dat v Tableau, tj. na dotaz v Tableau vrátit všechna data podle vybraných filtrů v granularitě pozic účtenek;
- Vytvořte materializovanou výlohu, která bude obsahovat všechny ukazatele ve všech variantách výběrů, které dávají různé neaditivní výsledky.
Je jasné, že v příkladu UTE1 a UTE2 jsou to atributy materiálu představující hierarchii zboží. Není to statická záležitost, skrze ni probíhá řízení uvnitř společnosti, protože za různé skupiny zboží odpovídají různí manažeři. Měli jsme mnoho globálních revizí této hierarchie, kdy se měnily všechny úrovně, přehodnocovaly vzájemné vztahy, a také stálé dílčí změny, kdy jedna skupina přechází z jednoho uzlu do druhého. V běžných zprávách se to všechno počítá na počkání z atributů materiálu, v případě materializace těchto dat je nutné vyvinout mechanismus sledování podobných změn a automatického přetížení historických dat. Velmi netriviální úkol.
Detail 3. Porovnání dat
Tento bod je podobný předchozímu. Podstatou je, že ve společnosti se při analýze obvykle vytváří několik úrovní porovnání s minulým obdobím:
Porovnání s minulým obdobím (den k dni, týden k týdnu, měsíc k měsíci)
V tomto porovnání se předpokládá, že v závislosti na zvoleném období uživatelem (například 33. týden roku) bychom měli ukázat dynamiku k 32. týdnu. Pokud bychom vybrali data za měsíc, například květen, toto porovnání by ukázalo dynamiku k dubnu.
Porovnání s minulým rokem
Hlavní nuance spočívá v tom, že při porovnávání podle dnů a podle týdnů neberete stejný den minulého roku, to znamená, že nemůžete jednoduše vzít aktuální rok minus jedna. Musíte se dívat na srovnávaný den v týdnu. A při porovnávání měsíců naopak musíte brát přesně stejný kalendářní den minulého roku. Existují také nuance se přestupnými roky. V původních úložištích jsou všechny informace rozděleny podle dnů, neexistují samostatná pole pro týdny, měsíce, roky. Proto k získání kompletní analytické pružnosti v panelu je nutné počítat nejen jedno období, například týden, ale čtyři týdny, a poté tato data ještě porovnat, odrazit dynamiku, odchylky. Tuto logiku formování srovnání v dynamice lze také realizovat buď v Tableau, nebo na straně výtoku. A ano, o těchto detailech jsme samozřejmě věděli a přemýšleli již v fázi návrhu, ale jejich vliv na výkon konečného dashboardu byl těžko předvídatelný.
Při zavádění dashboardu jsme šli dlouhou cestou Agile. Naším cílem bylo co nejrychleji poskytnout k testování pracovní nástroj s potřebnými daty. Proto jsme postupovali ve sprintech a zaměřili jsme se na minimalizaci práce na straně aktuálního úložiště.
Část 1. Víra v Tableau
Pro zjednodušení IT podpory a rychlé zavedení změn jsme se rozhodli realizovat logiku výpočtu neaditivních ukazatelů a srovnání minulých období v Tableau.
Fáze 1. Všechno v Live, žádné úpravy výtoku.
V této fázi jsme připojili Tableau k aktuálním výtokům a rozhodli jsme se zjistit, jak bude počítán počet účtenek za jeden rok.
Result:
Odpověď byla zdrcující – 20 minut. Přenos dat přes síť, vysoké zatížení na Tableau. Uvědomili jsme si, že logiku s neaditivními ukazateli je nutné realizovat na HANA. To nás příliš nevyděsilo, již jsme měli podobnou zkušenost s BO a Analysis a uměli jsme stavět rychlé výtoky v HANA, které správně počítají neaditivní ukazatele. Teď zbývalo je přizpůsobit Tableau.
Fáze 2. Ladíme výtoky, žádná materializace, vše za letu.
Vytvořili jsme novou samostatnou vitrínu, která na počkání poskytovala požadovaná data pro TABLEAU. Celkově jsme dosáhli dobrého výsledku, zkrátili jsme čas potřebný na generování všech ukazatelů ze sedmi dnů na 9-10 sekund. A upřímně jsme očekávali, že v Tableau bude doba odezvy dashboardu při prvním otevření 20-30 sekund a poté díky cache od 10 do 12, což by nás uspokojilo.
Result:
První otevření dashboardů: 4-5 minut
Jakýkoliv klik: 3-4 minuty
Takový dodatečný výkon nebyl nikdo očekával.
Část 2. Hlubší ponor do Tableau
Fáze 1. Analýza výkonnosti Tableau a rychlé ladění
Začali jsme analyzovat, na co Tableau tráví nejvíce času. A k tomu je k dispozici poměrně dobrý nástroj, což je samozřejmě výhoda Tableau. Hlavním problémem, který jsme identifikovali, byly velmi složité SQL dotazy, které Tableau vytvářelo. Tyto dotazy byly především spojeny s:
— transpozicí dat. Protože Tableau nemá nástroje pro transpozici datasetů, museli jsme pro vytvoření levé části dashboardu s podrobným zobrazením všech KPI vyvinout tabulku prostřednictvím case. Velikost SQL dotazů v DB dosahovala 120 000 znaků.
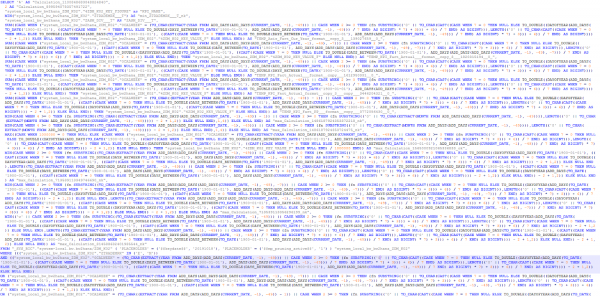
— výběrem časového období. Takový dotaz na úrovni DB trval déle na kompilaci než na vykonání:
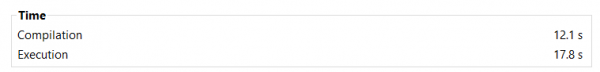
T.j. zpracování dotazu trvalo 12 sekund + 5 sekund vykonání.
Rozhodli jsme se zjednodušit logiku výpočtů na straně Tableau a přesunout další část výpočtů na vitrínu a úroveň DB. To přineslo dobré výsledky.
Nejprve jsme provedli transpozici na počkání, udělali jsme ji prostřednictvím full outer join v konečné fázi výpočtu VIEW, podle takového přístupu popsaného na wiki a .
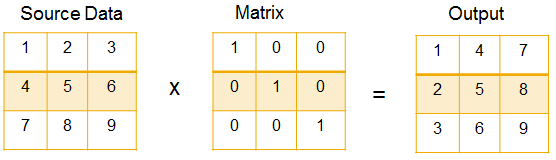
To znamená, že jsme vytvořili konfiguraci tabulku – transpoziční matici (21x21) a získali všechny ukazatele v řádkovém rozdělení.
Bylo:
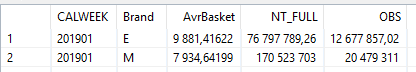
Stalo se:
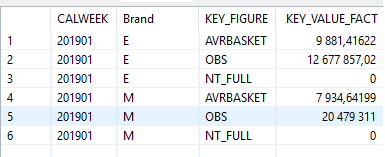
Na samotné transponování databáze se prakticky vůbec neztrácí čas. Dotaz na všechny ukazatele za týden byl zpracován stejně jako dříve přibližně za 10 sekund. Nicméně se ztratil určitý stupeň flexibility při vytváření dashboardu pro konkrétní ukazatel, tj. pro pravou část dashboardu, kde byla zobrazena dynamika a podrobná analýza konkrétního ukazatele, dříve vitrína zpracovávala za 1–3 sekundy, protože dotaz směřoval na jeden ukazatel, zatímco nyní databáze vždy vybrala všechny ukazatele a filtruje výsledek až po jeho vrácení do Tableau.
Výsledkem je, že rychlost práce dashboardu klesla téměř na třetinu.
Result:
- 5 s — parsování dashboardu, vizualizací
- 15-20 s — příprava na kompilaci dotazů s provedením předpočtů v Tableau
- 35-45 s — kompilace SQL dotazů a jejich paralelní-sekvenciální vykonání v Hana
- 5 s — zpracování výsledků, třídění, přepočet vizualizací v Tableau
- Samozřejmě, že takové výsledky nebyly pro byznys přijatelné, a my jsme pokračovali v optimalizaci.
Fáze 2. Minimální logika v Tableau, plná materializace
Uvědomovali jsme si, že není možné vytvořit dashboard s dobou odezvy několika sekund na vitríně, která funguje 10 sekund, a zvažovali jsme možnosti materializace dat na straně databáze právě pro požadovaný dashboard. Ale setkali jsme se s globálním problémem, popsaným výše – neaditivní ukazatele. Nedokázali jsme zajistit, aby se při změně filtrů nebo rozbaleních Tableau flexibilně přepínalo mezi různými vitrínami a úrovněmi, předpočítanými pro různé produktové hierarchie (v příkladu tři dotazy bez UTE, s UTE1 a UTE2 vytvářejí různé výsledky). Proto jsme se rozhodli zjednodušit dashboard, vzdát se produktové hierarchie a podívat se, jak rychlý může být v zjednodušené verzi.
Na tomto posledním kroku jsme tedy vytvořili samostatné úložiště, do kterého jsme uložili v transponované podobě všechny KPI. Na straně databáze jakýkoli dotaz na takové úložiště zpracovává za 0,1 – 0,3 sekundy. V dashboardu jsme získali následující výsledky:
První otevření: 8-10 sekund
Jakékoli kliknutí: 6-7 sekund
Čas, který Tableau potřebuje, se skládá z:
- 0,3 s — parsování dashboardu a kompilace SQL dotazů
- 1,5-3 s — vykonání SQL dotazů v Hana pro hlavní vizualizace (spouští se paralelně s bodem 1)
- 1,5-2 sekundy – rendering, přepočet vizualizací
- 1,3 sekundy – provádění dodatečných SQL dotazů pro získání relevantních hodnot filtrů (značka, divize, město, obchod), parsování výsledků
Pokud bychom měli shrnout
Nástroj Tableau nám při vizualizaci vyhovoval. V etapě návrhu jsme zvažovali různé vizualizační prvky a všechny jsme našli v knihovnách, včetně složitých vícestupňových segmentací a vícedriverových waterfallů.
Při zavádění dashboardů s hlavními ukazateli prodeje jsme narazili na problémy s výkonem, které jsme dosud nedokázali překonat. Strávili jsme více než dva měsíce a vytvořili funkčně neúplný dashboard, jehož rychlost odezvy je na hraně přijatelnosti. A udělali jsme závěry:
- Tableau neumí pracovat s velkými objemy dat. Pokud máte v původním datovém modelu více než 10 GB dat (přibližně 200 milionů x 50 řádků), tak se dashboard vážně zpomaluje – od 10 sekund až několika minut na každý klik. Experimentovali jsme s live-connectem i s extraktem. Rychlost práce je srovnatelná.
- Omezení při použití několika úložišť (datových sad). Není možné standardně uvádět vzájemné vztahy datových sad. Pokud použijete obcházející řešení pro propojení datových sad, negativně to ovlivní výkon. V našem případě jsme zvažovali možnost materializace dat v každém potřebném pohledu a na těchto materializovaných datových sadách přepínat se zachováním předchozího výběru filtrů – to se v Tableau ukázalo jako nemožné.
- V Tableau nelze vytvořit dynamické parametry. Nemůžete parametr, který se používá pro filtraci datové sady v extraktu nebo při live-connectu, naplnit výsledkem jiného výběru z datové sady nebo výsledku jiného SQL dotazu, pouze nativním vstupem uživatele nebo konstantou.
- Omezení spojená s vytvářením dashboardu s prvky OLAP|Kontingenční tabulka.
V MSTR, SAP SAC, SAP Analysis, pokud do zprávy přidáte datový soubor, jsou všechny objekty na něm navzájem propojené jako výchozí nastavení. V Tableau to neexistuje, vazbu je třeba nastavovat ručně. To je pravděpodobně flexibilnější, ale pro všechny naše dashboardy je to povinný požadavek na prvky – proto to představuje dodatečné pracovní náklady. Navíc, pokud vytváříte propojené filtry, aby například při filtrování regionu byl seznam měst omezen pouze na města tohoto regionu, okamžitě čelíte sekvenčním dotazům na databázi nebo extrakt, což výrazně zpomaluje dashboard. - Omezení v funkcích. Jak nad extraktem, tak TÍM MÉNĚ nad datovým souborem z Live-connectu nelze provádět hromadné transformace. To lze provádět prostřednictvím Tableau Prep, ale to představuje dodatečné pracovní náklady a další nástroj, který je potřeba se učit a udržovat. Například nemůžete transponovat data, provést join sama se sebou. To je uzavřeno prostřednictvím transformací jednotlivých sloupců nebo polí, které je třeba vybírat prostřednictvím case nebo if a to generuje velmi složité SQL dotazy, při kterých databáze tráví většinu času kompilací textu dotazu. Tyto neflexibility nástroje jsme museli řešit na úrovni vitríny, což vede ke složitější struktuře úložiště, dodatečným zátěžím a transformacím.
Nepoložili jsme kříž na Tableau. Ale jako nástroj, který je schopen vytvářet průmyslové dashboardy a prostředek, pomocí kterého lze nahradit a digitalizovat celý systém firemního reportingu, Tableau neplánujeme.
Nyní aktivně vyvíjíme podobný dashboard v jiném nástroji a zároveň se pokoušíme přepracovat architekturu dashboardu v Tableau, abychom ji ještě více zjednodušili. Pokud by komunitu zajímaly výsledky, rádi o nich povykládáme.
Také očekáváme vaše nápady nebo rady ohledně toho, jak v Tableau stavět rychlé dashboardy nad takovými velkými objemy dat, protože naše webové stránky obsahují mnohem více dat než maloobchod.
Zdroj: habr.com
