

Všichni mluví o procesech vývoje a testování, školení zaměstnanců, zvyšování motivace, ale tyto procesy jsou málo platné, když minuta nečinnosti služby stojí astronomické částky. Co dělat, když provádíte finanční transakce pod přísným SLA? Jak zvýšit spolehlivost a odolnost vašich systémů, pokud vynecháme vývoj a testování?
Další konference HighLoad++ se koná 6. a 7. dubna 2020 v Petrohradě. Podrobnosti a vstupenky na . 9. listopadu, 18:00. HighLoad++ Moskva 2018, sál „Dilli + Kalkata“. Abstrakty a .
Jevgenij Kuzovlev (dále – JK): – Přátelé, zdravím vás! Jmenuji se Kuzovlev Jevgenij. Jsem z firmy EcommPay, konkrétně z divize EcommPay IT, IT oddělení skupiny společností. Dnes s vámi budeme mluvit o výpadcích – jak se jim vyhnout, jak minimalizovat jejich důsledky, pokud se to nepodaří. Téma je následující: „Co dělat, když minuta nečinnosti stojí 100 000 dolarů?“ Napřed můžeme říci, že čísla jsou srovnatelná.
Čím se zabývá EcommPay IT?
Kdo jsme? Proč jsem tady před vámi? Proč mám právo vám zde něco vyprávět? A o čem si tady podrobněji promluvíme?
Skupina společností EcommPay je mezinárodní akvirovač. Zpracováváme platby po celém světě – v Rusku, Evropě, v jihovýchodní Asii (všude po světě). Máme 9 kanceláří, celkem 500 zaměstnanců, přičemž přibližně polovina z nich jsou IT specialisté. Vše, co děláme, vše, na čem vyděláváme peníze, jsme vytvořili sami.
Všechny naše produkty (a máme jich opravdu hodně – v řadě velkých IT produktů máme přibližně 16 různých komponentů) jsme napsali sami; sami programujeme, sami vyvíjíme. V současné době provádíme kolem jednoho milionu transakcí denně (miliony – to bude asi správné říct). Jsme poměrně mladá společnost – máme skoro šest let.
Před šesti lety to byl takový startup, kdy přišli kluci s podnikáním. Byli spojeni myšlenkou (nic jiného kromě myšlenky nebylo) a vyrazili jsme. Jako každý startup jsme běželi rychleji… Pro nás byla důležitější rychlost než kvalita.
V určitém okamžiku jsme se zastavili: uvědomili si, že už nemůžeme žít s tou rychlostí a kvalitou, a že musíme zakládat svůj důraz především na kvalitu. V tuto chvíli jsme se rozhodli napsat novou platformu, která bude správná, škálovatelná a spolehlivá. Tuto platformu jsme začali vytvářet (investovali jsme do vývoje, testování), ale v určitém okamžiku jsme si uvědomili, že vývoj a testování neumožňují dosáhnout nového kvalitativního úrovně služby.
Vytváříte nový produkt, uvádíte ho do produkce, ale přesto se něco někde nepovede. Dnes si povíme, jak dosáhnout nové kvalitativní úrovně (jak se nám to podařilo a o našem zkušenosti), s výjimkou vývoje a testování; budeme mluvit o tom, co je k dispozici v provozu – co může provoz sám udělat, co může nabídnout testování, aby ovlivnilo kvalitu.
Prostoje. Přikázání provozu.
Vždycky je hlavním kamenem, o čem dnes vlastně budeme mluvit – prostoje. Hrozné slovo. Když dojde k prostojům – je to špatné. Běžíme, abychom to napravili, administrátoři server drží – ať se to, jak zpívá ona píseň, nezhroutí. O tom si dnes budeme povídat.
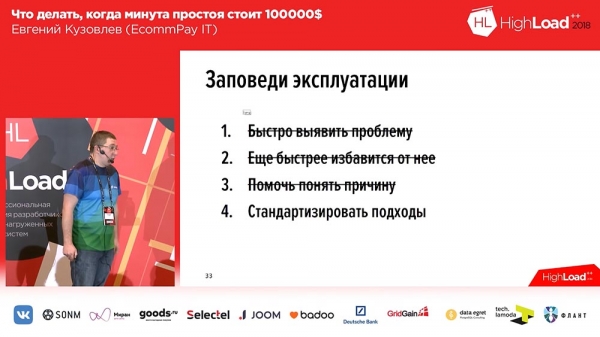
Když jsme začali měnit své přístupy, vytvořili jsme 4 přikázání. Ta jsou uvedena na slidech:
Tato přikázání jsou dost jednoduchá:
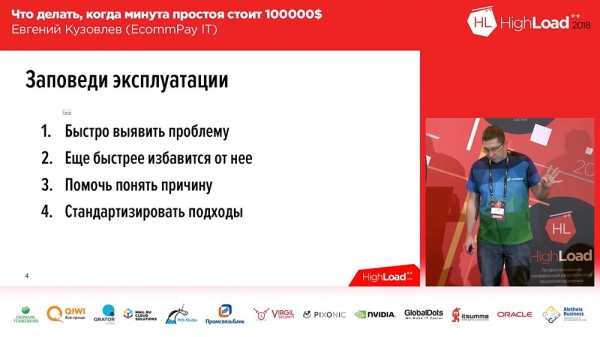
- Rychle identifikovat problém.
- Ještě rychleji se ho zbavit.
- Pomoci pochopit příčinu (poté, pro vývojáře).
- A standardizovat přístupy.
Rád bych upozornil na bod č. 2. Zbavujeme se problému, nikoliv jej řešíme. Vyřešit – to je druhotné. Pro nás je primární, že je uživatel chráněn před tímto problémem. Ten bude existovat v jakési izolované oblasti, ale tato oblast nebude s uživateli kontaktovat. Vlastně se projdeme čtyřmi skupinami problémů (některé podrobněji, některé méně podrobně), řeknu vám, co používáme, jaké máme odpovídající zkušenosti v řešeních.
Odstraňování problémů: kdy nastanou a co s nimi dělat?
Ale nezačínejme pořadím, začněme bodem č. 2 – jak rychle se zbavit problému? Je tu problém – musíme jej odstranit. „Co s tím uděláme?“ – to je základní otázka. A když jsme začali přemýšlet o tom, jak problém odstranit, stanovili jsme si některé požadavky, kterými by se odstranění problémů mělo řídit.
Abychom tyto požadavky formulovali, položili jsme si otázku: „Kdy se nám vlastně stávají problémy?“ A problémy, jak se ukázalo, se vyskytují ve čtyřech případech:
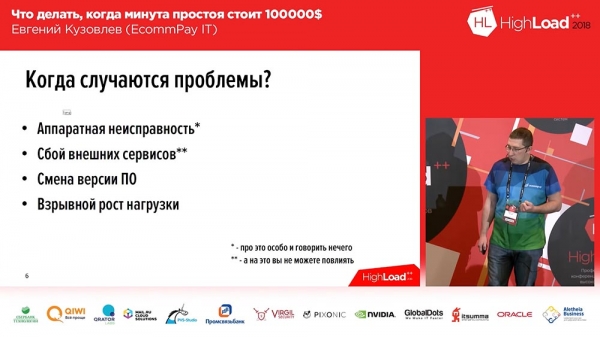
- Hardwarová závada.
- Selhání externích služeb.
- Změna verze softwaru (to známé nasazení).
- Výbuchový nárůst zátěže.
O prvních dvou nebudeme mluvit. Hardwarová závada se řeší celkem jednoduše: vše musí být duplikováno. Pokud jsou to disky – měly by být v RAIDu, pokud je to server – server musí být duplikován, pokud máte síťovou infrastrukturu – musíte mít druhou kopii síťové infrastruktury, tedy vezmete a duplikujete. A pokud něco selže, přepnete se na záložní zdroje. Tady je těžké říct něco více.
Druhá věc – to je selhání externích služeb. Pro většinu systémů to vlastně není problém, ale ne pro nás. Protože zpracováváme platby, jsme takovým agregátorem, který stojí mezi uživatelem (který zadává své platební údaje) a bankami, platebními systémy („Visa“, „MasterCard“, „Mir“ a podobně). Externím našim službám (platebním systémům, bankám) se obvykle stává, že selhávají. Ovlivnit to nemůžeme ani my, ani vy (pokud máte takovéto služby).
Co tedy dělat? Zde jsou dvě možnosti. Za prvé, pokud můžete, měli byste tento servis nějakým způsobem duplikovat. Například, pokud můžeme, přesměrováváme provoz z jednoho servisu na druhý: zpracovávali jsme například karty přes „Sberbank“, pokud má „Sberbank“ problémy, přesměrováváme provoz [podmíněně] na „Raiffeisen“. Druhá věc, kterou můžeme udělat – je velmi rychle zjistit selhání externích služeb, a proto si o rychlosti reakce promluvíme v další části prezentace.
Ve skutečnosti máme možnost ovlivnit změnu verzí softwaru – provést kroky, které zlepší situaci v kontextu nasazení a v kontextu explozivního nárůstu zátěže. To jsme také udělali. Zde, opět malá poznámka…
Některé z těchto čtyř problémů se řeší ihned, pokud máte cloud. Pokud používáte "Microsoft Azure", "Ozon", naše cloudy od "Jandy" nebo "Mail.ru", technická závada se stává jejich problémem a vy máte ihned vše v pořádku v kontextu technické závady.
Jsme poněkud netradiční společnost. Zde se všichni baví o "Kubernetes", o cloudech – my nemáme ani "Kubernetes", ani cloudy. Ale máme stojany se zařízením v mnoha datových centrech, a na tomto zařízení musíme žít, musíme nést odpovědnost za to vše. Proto se v tomto kontextu budeme bavit. Takže o problémech. První dvě jsme vyčlenili.
Změna verze softwaru. Základy
Naši vývojáři nemají přístup do produkce. Proč? Protože máme certifikaci podle PCI DSS a naši vývojáři prostě nemají právo se dostat do "proděkce". Tečka. Úplně. Proto odpovědnost vývoje končí přesně ve chvíli, kdy vývoj předal build k vydání.
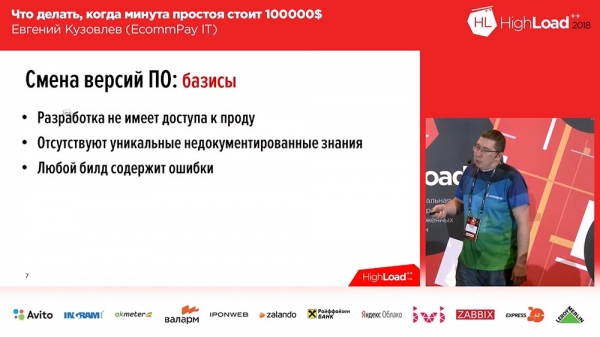
Druhý náš základ, který máme a který nám také velmi pomáhá – je absence unikátních nedokumentovaných znalostí. Doufám, že to máte také. Protože pokud ne – budete mít problémy. Problémy se objeví tehdy, když tyto unikátní nedokumentované znalosti nebudou přítomny ve správný čas na správném místě. Řekněme, že jeden člověk ví, jak nasadit konkrétní komponentu – tohoto člověka není, je na dovolené nebo je nemocný – vše, máte problémy.
A třetí základ, ke kterému jsme dospěli. Dospěli jsme k němu skrze bolest, krev a slzy – dospěli jsme k tomu, že každý náš build obsahuje chyby, i když je bez chyb. Rozhodli jsme se pro sebe: když něco nasazujeme, když něco tlačíme do produ – náš build má chyby. Vytvořili jsme požadavky, které naše systém musí splňovat.
Požadavky na změnu verze softwaru
Těchto požadavků jsou tři:
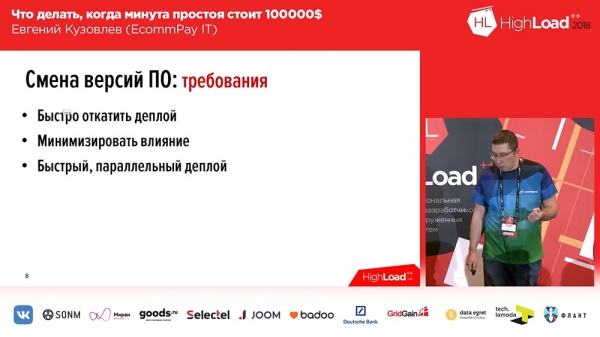
- Musíme být schopni rychle vrátit nasazení.
- Musíme minimalizovat dopad neúspěšného nasazení.
- A musíme mít možnost rychle nasadit paralelně.
Takto to funguje! Proč? Protože v první řadě není při nasazení nové verze důležitá rychlost, ale pokud něco selže, je důležité rychle se vrátit zpět a minimalizovat dopad. Pokud máte sadu verzí na produkci, ve které se ukáže, že je tam chyba (jako blesk z čistého nebe, nasazení nebylo, ale chyba je tam) – důležitá je rychlost nasazení následující. Co jsme udělali, abychom splnili tyto požadavky? Použili jsme tuto metodologii:
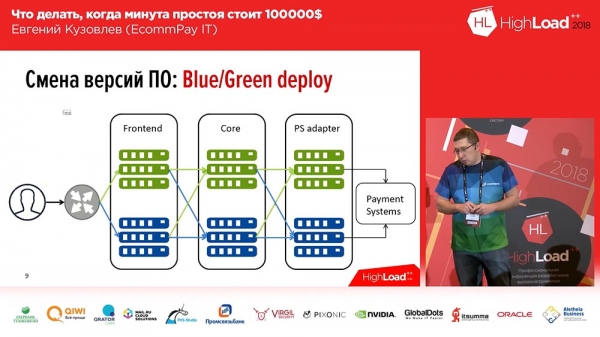
Je to dost známé, neobjevili jsme to – to je Blue/Green deploy. Co to znamená? Pro každou skupinu serverů, na kterých běží vaše aplikace, musíte mít kopii. „Teplá“ kopie: na ní není žádný provoz, ale v jakémkoli okamžiku můžete tento provoz na tuto kopii nasadit. Tato kopie obsahuje předchozí verzi. A v okamžiku nasazení nasadíte kód na neaktivní kopii. Poté přepnete část provozu (nebo celý) na novou verzi. Tímto způsobem, abyste změnili tok provozu ze staré verze na novou, potřebujete udělat jen jednu věc: musíte změnit vyvážení mezi upstreamy, změnit směr – z jednoho upstreamu na druhý. Je to velmi pohodlné a řeší problém rychlého přepínání, rychlého návratu zpět.Zde je také řešení druhé otázky – minimalizace: můžete poslat na novou linku, na linku s novým kódem, pouze část svého provozu (dejme tomu, 2 %). A těchto 2 % nejsou 100%! Pokud jste při neúspěšném nasazení ztratili 100 % provozu – to je hrozné, pokud ztratíte 2 % provozu – to je nepříjemné, ale není to tragické. Navíc si pravděpodobně uživatelé toho nevšimnou, protože v některých případech (ne ve všech) se stejný uživatel, když stiskne F5, dostane na jinou, fungující verzi.
Blue/Green deploy. Směrování
A není to tak jednoduché s „Blue/Green deployem“… Všechny naše komponenty lze rozdělit do tří skupin:
- to je frontend (platební stránky, které vidí naši zákazníci);
- jádro zpracování;
- adaptér pro práci s platebními systémy (banky, „MasterCard“, „Visa“…).
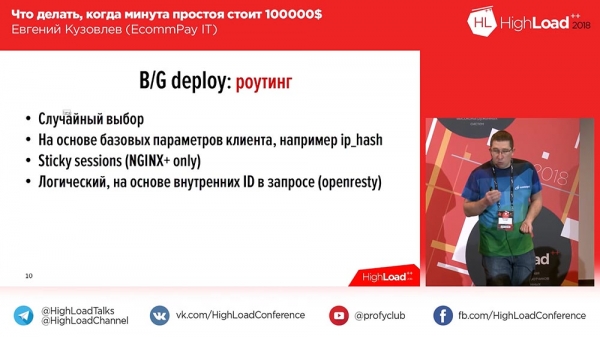
A tady je jeden nuance – nuance spočívá v routování mezi linkami. Pokud jednoduše přepnete 100 % provozu, tyto problémy nemáte. Ale pokud chcete přepnout 2 %, začínají se objevovat otázky: "Jak to udělat?" Nejjednodušší je to na rovinu: můžete nastavit náhodný výběr, Round Robin v nginxu, a máte 2 % – doleva, 98 % – doprava. Ale to ne vždy vyhovuje.
Například uživatel s naším systémem neinteraguje pouze jedním požadavkem. To je normální: 2, 3, 4, 5 požadavků – váš systém může být stejný. A pokud je pro vás důležité, aby všechny požadavky uživatele přišly na stejnou linku, na kterou přišel první požadavek, nebo (druhá věc) všechny požadavky uživatele přišly na novou linku po přepnutí (už mohl začít pracovat se systémem, před přepnutím) – pak se náhodné rozdělení nehodí. Pak jsou další možnosti:
První možnost, nejjednodušší – na základě základních parametrů klienta (IP Hash). Máte IP a podle ní rozdělujete doprava-doleva. Tím se vám vyřeší druhý popsaný případ, kdy došlo k nasazení, uživatel mohl začít pracovat s vaším systémem a od okamžiku nasazení všechny požadavky půjdou na novou linku (na tu stejnou, dejme tomu).Pokud vám to z nějakého důvodu nevyhovuje a musíte nutně posílat požadavky na tu linku, kam přišel primární, iniciální požadavek uživatele, pak máte dvě možnosti…
První možnost: můžete vzít placenou verzi nginxu+. Tam je mechanismus Sticky sessions, který při prvním požadavku uživatele nastaví uživatelskou session a přiřadí ji k tomu či onomu upstreamu. Všechny následné požadavky uživatele v rámci životnosti session budou směřovat na ten samý upstream, kam byla session nastavena.To nám nevyhovovalo, protože jsme již měli běžný nginx. Přechod na nginx+ – to není, že by to bylo drahé, jen to bylo pro nás trochu bolestivé a ne úplně správné. „Sticky sessions“ pro nás například nefungovaly ze zcela prostého důvodu, že „Sticky sessions“ neumožňují routovat podle pravidla „Anebo-anebo“. Můžete nastavit, že děláme „Sticky sessions“ například podle IP adresy nebo podle IP adresy a cookies nebo podle postparametru, ale „Anebo-anebo“ – to už je složitější.
Proto jsme se dostali k čtvrté variantě. Vzali jsme nginx na „steroidech“ (to je openresty) – je to ta samá nginx, který navíc podporuje zavádění last skriptů. Můžete napsat last skript, poskytnout ho tomuto „oprensty“ a tento last skript se vykoná, když příjde požadavek uživatele.
A my jsme vlastně napsali takový skript, nainstalovali jsme si „oprensty“ a v tomto skriptu procházíme 6 různých parametrů pomocí konkatenece „nebo“. Na základě přítomnosti určitého parametru víme, že uživatel přišel na jednu stránku nebo druhou, na jednu linii nebo druhou.
Blue/Green nasazení. Výhody a nevýhody
Samozřejmě, mohli jsme to možná udělat trochu jednodušeji (například použít „Sticky sessions“), ale máme ještě nuanci, že s námi neinteraguje jen uživatel v rámci jednoho zpracování jedné transakce... s námi interagují také platební systémy: my, poté co zpracujeme transakci (pošleme požadavek do platebního systému), dostáváme callback.
A dejme tomu, pokud můžeme uvnitř našeho okruhu posílat IP adresu uživatele ve všech požadavcích a na základě IP adres uživatelů rozlišovat, pak neřekneme téže „Vízě“: „Chlapi, my jsme taková retro firma, vypadáme jako mezinárodní (na webu a v Česku)... a prosím vás, poslat nám IP adresu uživatele navíc do dalšího pole, váš standardizovaný protokol“! Je jasné, že s tím nebudou souhlasit.
Proto nám to nevyhovovalo – udělali jsme openresty. Odpovídajícím způsobem jsme s routováním skončili takto:Blue/Green nasazení má, jak jsem řekl, své výhody a nevýhody.
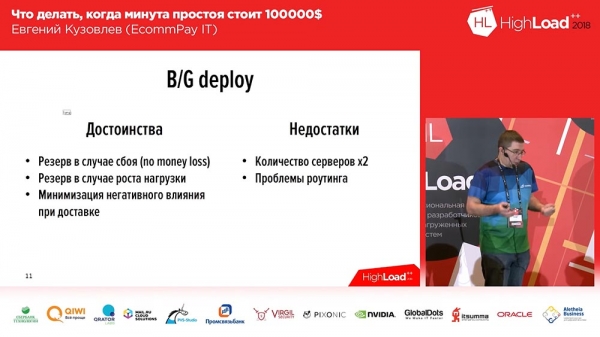
Nevýhody jsou dvě:
- musíte se starat o routování;
- druhá hlavní nevýhoda – jsou náklady.
Budete potřebovat dvakrát více serverů, budete potřebovat dvakrát více operačních zdrojů, budete muset vynaložit dvakrát více sil na udržování celého tohoto zvěřince.
Mimochodem, mezi výhodami je ještě jedna věc, o které jsem dříve nezmínil: máte rezervu pro případ zvýšení zátěže. Pokud dojde k náhlému nárůstu zátěže a máte velké množství uživatelů, jednoduše zapnete druhou linii v rozdělení 50 na 50 – a máte okamžitě dvakrát tolik serverů ve vašem clusteru, dokud nevyřešíte problém s dostupností serverů.
Jak provést rychlé nasazení?
Hovořili jsme o tom, jak vyřešit problém minimalizace a rychlého vrácení změn, ale otázka zůstává: „Jak rychle nasazovat“?
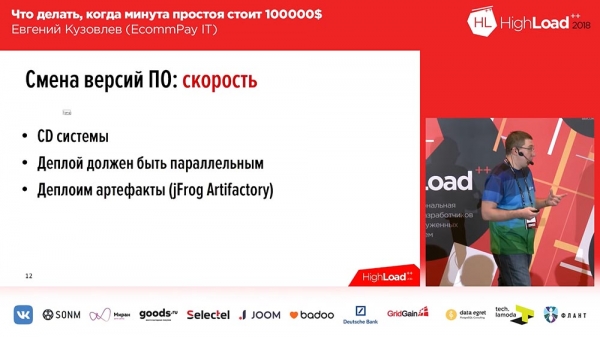
Zde je to stručné a jednoduché.- Musíte mít systém CD (Continuous Delivery) – bez toho to nejde. Pokud máte jeden server, můžete se nasadit manuálně. U nás je zhruba patnáct set serverů a manuální nasazení patnácti stovek, jak asi tušíte – můžeme mít oddělení velikosti této místnosti, jen abychom mohli nasazovat.
- Nasazení musí být paralelní. Pokud je vaše nasazení sekvenční, je to špatné. Jeden server – v pořádku, patnáct set serverů budete nasazovat celý den.
- Znovu, pro zrychlení, to už není nezbytné. Při nasazení se obvykle provádí sestavení projektu. Máte webový projekt, máte frontendovou část (děláte tam webpack, shromažďujete npm – něco takového), a tento proces není zásadně dlouhý – pět minut, ale těchto pět minut může být kritických. Proto například takto nepostupujeme: tyto 5 minut jsme odstranili, nasazujeme artefakty.
Co je artefakt? Artefakt je sestavená verze, ve které už proběhla veškerá část sestavení. Tento artefakt uchováváme ve skladu artefaktů. Takových skladů jsme v minulosti používali dva – byl to Nexus a nyní jFrog Artifactory. Nexus jsme zpočátku používali, protože jsme začali tento přístup praktikovat v java aplikacích (ten se na to dobře hodil). Poté jsme tam také umístili část aplikací, které byly napsány v PHP; a Nexus už nevyhovoval, a proto jsme si vybrali jFrog Artifactory, který dokáže zpracovat prakticky všechno. Dokonce jsme došli k tomu, že v tomto skladu artefaktů uchováváme vlastní binární balíčky, které pro servery vytváříme.
Náhlý nárůst zátěže
Mluvili jsme o změně verze softwaru. Další, co máme, je náhlý nárůst zátěže. V tomto případě pravděpodobně chápu pod náhlým nárůstem zátěže něco trochu jiného…
Napsali jsme nový systém – je to službově orientovaný, moderní a krásný, všude pracovníci, všude fronty, všude asynchronnost. A v takových systémech mohou data probíhat různými toky. Pro první transakci mohou být zapojeni 1., 3., 10. pracovník, pro druhou transakci – 2., 4., 5. A dnes, řekněme, ráno máte tok dat, který zapojuje první tři pracovníky, a večer se to náhle změní a všechno zapojuje jiné tři pracovníky.
A tady vzniká potřeba nějakým způsobem škálovat pracovníky, potřebujete nějakým způsobem škálovat své služby, ale přitom nedopustit rozšiřování zdrojů.
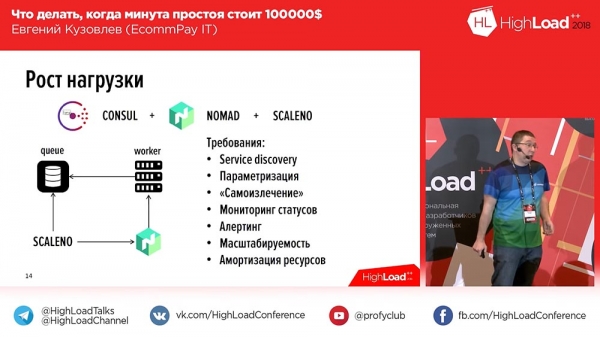
Stanovili jsme si požadavky. Tyto požadavky jsou dost jednoduché: aby tam bylo objevování služeb, parametrizace – vše standardní pro vytváření takových škálovatelných systémů, kromě jednoho bodu – to je amortizace zdrojů. Řekli jsme, že nejsme připraveni amortizovat zdroje, aby servery hřály vzduch. Vzali jsme "Consul", vzali jsme "Nomad", který řídí naše pracovníky.Proč je to pro nás problém? Pojďme se vrátit zpět. Za námi stojí nyní kolem 70 platebních systémů. Ráno provoz jde přes "Sberbank", pak "Sberbank" spadne, například, a my ho přepínáme na jiný platební systém. Měli jsme 100 pracovníků do "Sberbank", a po tom musíme náhle zvýšit 100 pracovníků pro jiný platební systém. A to vše by mělo probíhat bez lidského zásahu. Protože, pokud je požadován lidský zásah, musí tam být inženýr 24/7, který se tím má jen zabývat, protože takové havárie, když za vámi je 70 systémů, se pravidelně vyskytují.
Proto jsme se podívali na "Nomad", který má otevřenou IP adresu, a napsali jsme naši věc Scale-Nomad – ScaleNo, která dělá zhruba toto: sleduje růst fronty a snižuje nebo zvyšuje počet pracovníků v závislosti na dynamice změny fronty. Když jsme to udělali, pomysleli jsme si: „Možná to open-source?“ Poté jsme se na to podívali – je to jednoduché jako dvě haléře.
Dosud jsme to open-source neudělali, ale pokud po prezentaci, po uvědomění si, že potřebujete takovou věc, budete mít potřebu, v posledním slidu jsou mé kontakty – prosím, napište mi. Pokud se sejde alespoň 3-5 lidí – open-source to uděláme.
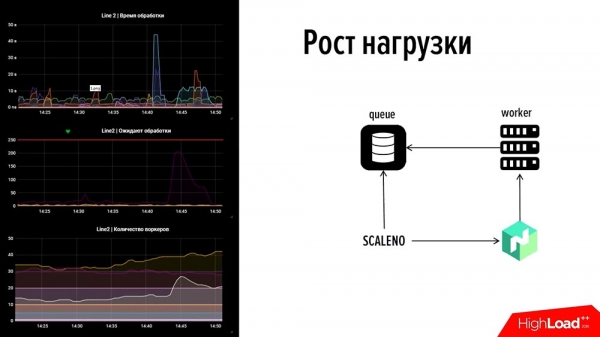
Jak to funguje? Podívejme se na to! Představíme si to: na levé straně je část našeho monitorování: to je jedna linka, nahoře – čas zpracování událostí, uprostřed – počet transakcí, dole – počet pracovníků.Pokud se podíváme, na tomto obrázku došlo k selhání. Na horním grafu jeden z grafů vypadl za 45 sekund – jeden z platebních systémů selhal. Hned byl zobrazena návštěvnost za 2 minuty a došlo k nárůstu fronty v jiném platebním systému, kde nebyli pracovníci (nevyužívali jsme zdroje – naopak, využívali jsme zdroje efektivně). Nechtěli jsme je přetěžovat – tam bylo minimální množství, asi 5-10 pracovníků, ale ti si s tím nedokázali poradit.
Na posledním grafu je vidět 'hrb', který jasně ukazuje, že 'Scale' zvýšil toto množství dvakrát. A pak, když graf trochu klesl, tak mírně snížil – počet pracovníků byl automaticky upraven. Takto to funguje. Pokryli jsme bod č. 2 – 'Jak rychle se zbavit příčin'.
Monitorování. Jak rychle odhalit problém?
Teď první bod – 'Jak rychle odhalit problém?' Monitorování! Musíme rychle pochopit určité věci. Jaké věci bychom měli rychle chápat?
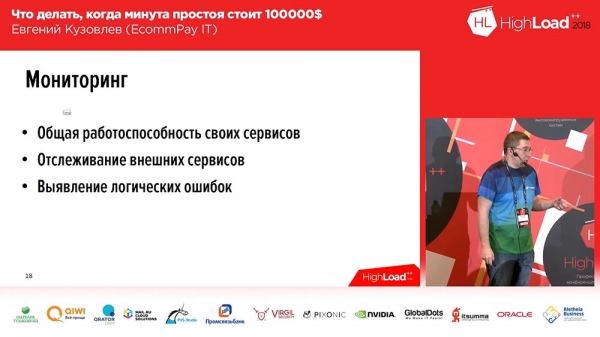
Tři věci!- Musíme rychle chápat a rychle posoudit funkčnost našich vlastních zdrojů.
- Musíme rychle chápat selhání, monitorovat funkčnost systémů, které jsou pro nás externí.
- Třetí bod – odhalení logických chyb. To je, když systém u vás funguje, všechny ukazatele jsou normální, ale dojde k něčemu, co nefunguje správně.
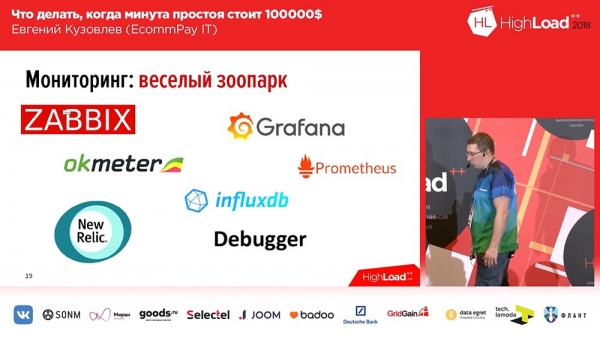
Zde asi neřeknu nic tak skvělého. Budu kapitánem Očividným. Hledali jsme, co je na trhu. Vytvořil se nám 'veselejší zoopark'. Takový zoopark máme teď:
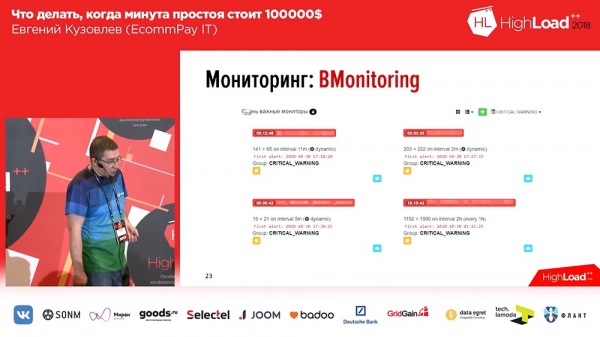
Máme 'Zabbix' pro monitorování 'hardwaru', pro sledování hlavních ukazatelů serverů. 'Okmeter' používáme pro databáze. 'Grafanu' a 'Prometheus' používáme pro všechny ostatní ukazatele, které nespadly do první dvou, přičemž některé – s 'Grafanou' a 'Prometheem', a část – 'Grafana' s 'Influxem' a Telegraf.Před rokem jsme chtěli používat New Relic. Skvělá věc, umí všechno. Ale jak moc toho zvládá, tak je to také drahé. Když jsme se dostali na objem 1,5 tisíce serverů, přišel k nám dodavatel a řekl: „Pojďme uzavřít smlouvu na příští rok.“ Podívali jsme se na cenu a řekli jsme, že to tak dělat nebudeme. Teď se od New Relicu odhlašujeme, máme asi 15 serverů stále pod monitoringem New Relicu. Cena se ukázala jako naprosto šílená.
A máme jeden nástroj, který jsme si sami implementovali – to je Debugger. Zpočátku jsme ho nazvali „Bagger“, ale pak k nám přišel učitel angličtiny, hrozně se zasmál a přejmenovali jsme ho na „Debugger“. Co to je? Je to nástroj, který vlastně za 15-30 sekund na každé komponentě, jako „černá skříňka“ systému, spouští testy na celkovou funkčnost komponenty.
Například, pokud jde o externí stránku (platící stránku) – jednoduše ji otevře a podívá se, jak by měla vypadat. Pokud je to zpracování, provede testovací „transakci“ – kontroluje, zda tato „transakce“ prošla. Pokud jde o spojení s platebními systémy – odpovídajícím způsobem posíláme testovací dotaz, kde můžeme, a sledujeme, jak máme všechno v pořádku.
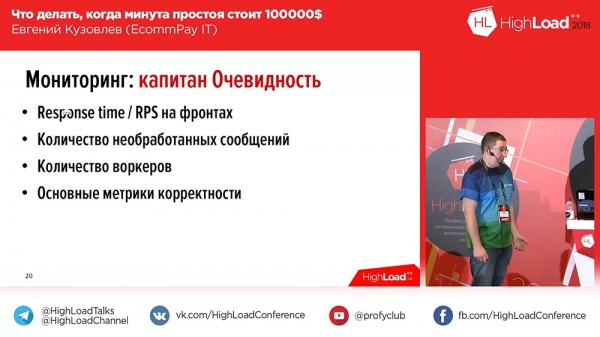
Jaké ukazatele jsou důležité pro monitoring?
Co hlavně monitorujeme? Jaké ukazatele jsou pro nás důležité?
- Doba odezvy / RPS na frontách – velmi důležitý ukazatel. Ihned naznačuje, že něco není v pořádku.
- Počet zpracovaných zpráv ve všech frontách.
- Počet pracovníků.
- Hlavní metriky správnosti.
Poslední bod – „businessový“, „businessová“ metrika. Pokud chcete monitorovat to samé, musíte určit jednu nebo dvě metriky, které pro vás jsou hlavními ukazateli. U nás je taková metrika – průchodnost (to je poměr úspěšných transakcí k celkovému objemu transakcí). Pokud se v ní něco mění v intervalu 5-10-15 minut – znamená to, že máme problémy (pokud se to radikálně změní).
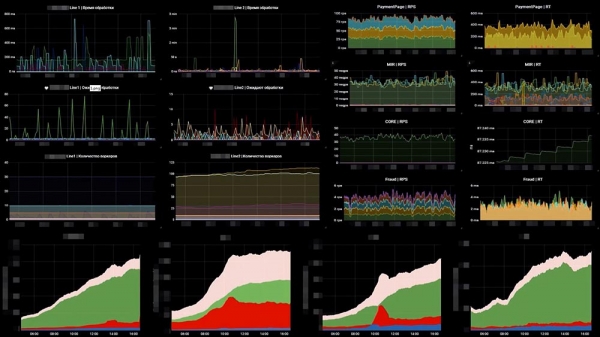
Jak to vypadá u nás – příklad jedné z našich tabulí:
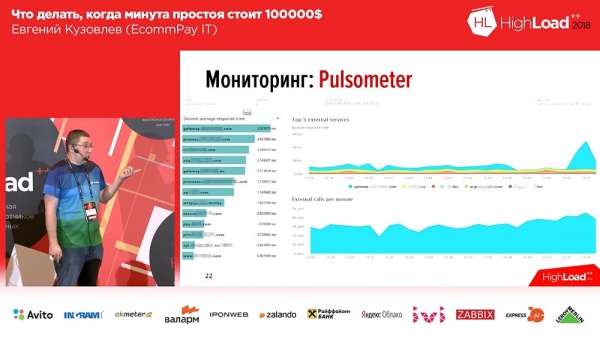
Na levé straně je 6 grafů, což odpovídá počtu pracovníků a počtu zpráv v frontách. Na pravé straně jsou RPS a RTS. Dole je ta správná metrika 'businessová'. A na 'businessové' metrice hned vidíme, že něco není v pořádku na dvou středních grafech... To je právě ten okamžik, kdy se zhroutila další systém, který nás podporuje.Druhá věc, kterou jsme museli udělat, bylo sledovat pokles externích platebních systémů. Zde jsme využili OpenTracing – mechanizmus, standard, paradigma, které umožňuje trasování distribuovaných systémů; a mírně jsme ho upravili. Standardní paradigma OpenTracing říká, že stavíme trasování každého jednotlivého požadavku. To jsme nepotřebovali, a tak jsme to zabalili do souhrnného, agregačního trasování. Vytvořili jsme nástroj, který nám umožňuje sledovat rychlost systémů, které nás podporují.
Graf nám ukazuje, že jeden z platebních systémů začal odpovídat za 3 sekundy – začali jsme mít problémy. Přitom tento systém reaguje, když problémy začínají, v intervalu 20-30 sekund.A třetí typ chyb monitoringu, které existují – to je logický monitoring.
Upřímně řečeno, nevěděl jsem, co na tomto snímku nakreslit, protože jsme dlouho hledali na trhu něco, co by nám vyhovovalo. Nic jsme nenašli, a tak jsme museli vytvořit něco vlastního.
Co myslím logickým monitoringem? No, představte si: děláte si systém (například klon 'Tinderu'); vytvořili jste ho, spustili. Úspěšný manažer Vaša Pupkin si ho nainstaloval do telefonu, vidí tam dívku, lajkuje ji... ale lajk nejde dívce – lajk jde ochránci Michalovi z tohoto stejného obchodního centra. Manažer sestupuje dolů a pak nechápe: 'Proč se mi ten ochránce Michal tak příjemně usmívá?'V takových situacích… Tato situace na nás působí trochu jinak, protože (jak jsem psal) jde o reputační ztrátu, která nepřímo vede k finančním ztrátám. My máme situaci opačnou: přímé finanční ztráty můžeme utrpět – například pokud jsme transakci vyhodnotili jako úspěšnou, ale ve skutečnosti byla neúspěšná (nebo naopak). Museli jsme napsat vlastní nástroj, který sleduje na základě obchodních ukazatelů počet úspěšných transakcí v dynamice za časový interval. Na trhu jsme nic nenašli! To byla myšlenka, kterou jsem chtěl sdělit. Na řešení takovýchto úloh na trhu nic není.
To bylo k otázce, jak rychle odhalit problém.
Jak určit příčiny nasazení
Třetí skupina úloh, které řešíme – poté, co jsme problém odhalili, a po jeho vyřešení by bylo dobré pochopit příčinu pro vývoj, pro testování a něco s tím udělat. Proto je třeba provést vyšetřování, je třeba zvednout logy.
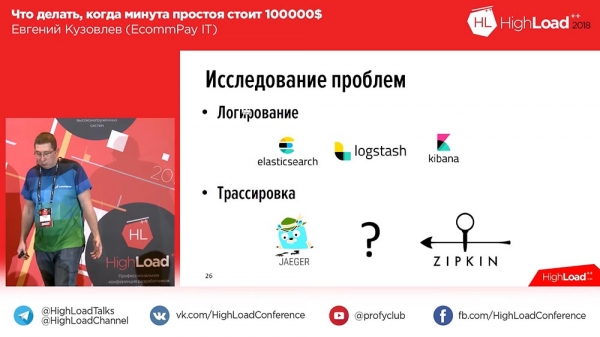
Pokud se bavíme o logách (hlavní příčina – logy), hlavní část logů máme v ELK Stacku – u prakticky všech je to tak. Někdo může mít logy někde jinde, ale pokud zapisujete logy gigabajty, dříve nebo později přejdete k ELK. My je zapisujeme terabajty.
Zde je problém. Opravená chyba pro uživatele byla opravena, začali jsme zkoumat, co se tam vlastně stalo, dostali jsme se do Kibany, zadali jsme tam ID transakce a dostali jsme takovou spoustu údajů (ukazuje hodně). A v této spoustě údajů není nic jasné. Proč? Protože není jasné, která část se vztahuje k jakému workeru, která část se vztahuje k jaké komponentě. A v tu chvíli jsme si uvědomili, že potřebujeme trasování – to je ono OpenTracing, o kterém jsem mluvil.Pomysleli jsme na to před rokem, podívali jsme se na trh a objevily se tam dva nástroje – Zipkin a Jaeger. Jaeger je v podstatě ideologickým nástupcem, ideologickým pokračovatelem Zipkinu. Zipkin má vše dobré, kromě toho, že neumí agregovat, neumí zahrnout logy do trasování, pouze trasování času. A Jaeger to podporoval.
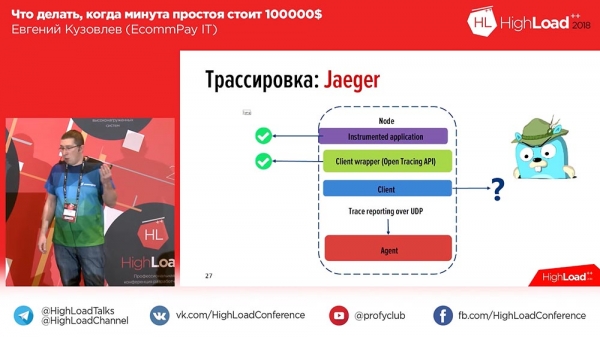
Podívali jsme se na „Eger“, kde můžeme instrumentovat aplikace a psát do API (standard API pro PHP tehdy ještě nebyl schválen – to bylo před rokem, a nyní už je potvrzen), ale vlastně nebyl žádný klient. „Dobře,“ pomysleli jsme si, a napsali jsme vlastní klient. Jak to vypadalo? Přibližně takto:
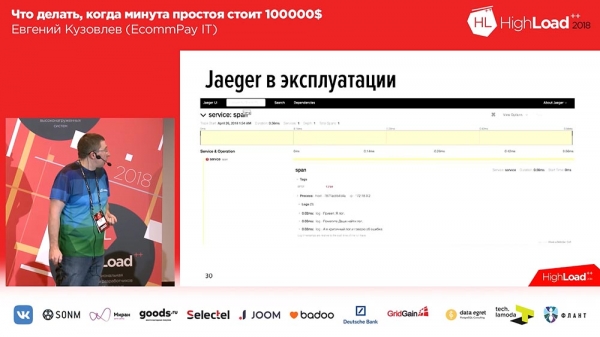
V „Egeru“ je pro každou zprávu vytvářena span. To znamená, že když uživatel otevře systém, vidí jeden nebo dva bloky na každý příchozí požadavek (1-2-3 – tolik příchozích požadavků od uživatele, kolik bloků). Abychom to uživatelům usnadnili, přidali jsme k logům a časovému sledování tagy. V případě chyby naše aplikace označí log odpovídajícím tagem Error. Můžete filtrovat podle tagu Error a zobrazí se pouze span, které obsahují tento blok s chybou. Takto to vypadá, pokud rozbalíme span:
Uvnitř spanu je sada trace. V tomto případě jsou to tři testovací trace a třetí trace nám říká, že došlo k chybě. A zde také vidíme časové sledování: nahoře máme časovou osu a vidíme, v jakém časovém intervalu byl daný log zaznamenán.Naše řešení fungovalo skvěle. Napsali jsme vlastní rozšíření a zpřístupnili jsme ho jako open source. Pokud byste chtěli pracovat s sledováním a „Egerem“ v jazyce PHP – máme naše rozšíření, vítejte k použití, jak se říká:
Naše rozšíření je klient pro práci s OpenTracing API, je vytvořen jako php-rozšíření, což znamená, že ho budete muset zkompilovat a podložení do systému. Před rokem nebylo nic jiného. Nyní se objevily i další klienty, které jsou jako komponenty. Záleží na vás: buď získáte komponenty přes Composer, nebo použijete rozšíření, je to na vás.Firemní standardy
O třech přikázáních jsme mluvili. Čtvrté přikázání – standardizovat přístupy. O čem to je? To je přibližně o tom:
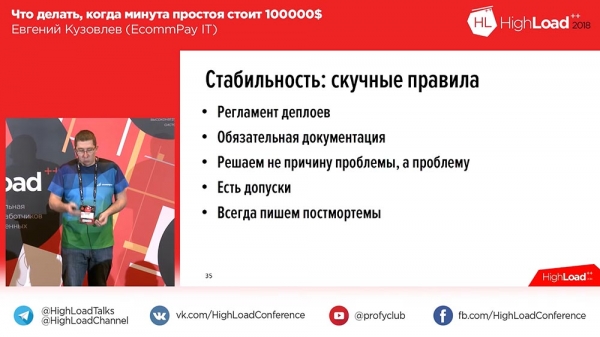
Proč zde slovo „firemní“? Ne proto, že jsme velká nebo byrokratická společnost, ne! Slovo „firemní“ jsem chtěl použít v kontextu toho, že každá společnost a každý produkt by měly mít své vlastní standardy, a vy také. Jaké standardy máme my?- Máme pravidlo pro nasazení. Bez něj se nikam neposouváme, nemůžeme. Nasazujeme asi 60krát týdně, což znamená, že nasazení probíhá prakticky neustále. Přitom máme například v pravidle nasazení tabu na nasazení v pátek – v zásadě se nenasazujeme.
- Dokumentace je u nás obligatorní. Žádná nová komponenta se k nám nedostane do produkce, pokud na ni není dokumentace, i když byla vytvořena našimi RnD odborníky. Požadujeme od nich návod na nasazení, monitorovací plán a přibližný popis (tak, jak to programátoři mohou napsat) toho, jak tato komponenta funguje, jak ji troubleshootovat.
- Řešíme problém, ne příčinu problému – to jsem již zmiňoval. Je pro nás důležité chránit uživatele před problémy.
- Máme toleranci. Například nepovažujeme za výpadek, pokud po dobu dvou minut ztratíme 2 % provozu. To v zásadě nepatří do naší statistiky. Pokud je to více v procentuálním nebo časovém vyjádření, už to považujeme.
- A vždy píšeme postmortem. Ať už se stane cokoliv, jakákoliv situace, která se chovala abnormálně v produkci, bude zaznamenána v postmortemu. Postmortem je dokument, ve kterém popíšete, co se vám stalo, podrobný časový rozpis, co jste udělali pro nápravu a (to je povinný blok!) co uděláte, abyste tomu v budoucnu předešli. To je povinné, potřebné pro následnou analýzu.
Co považujeme za výpadek?
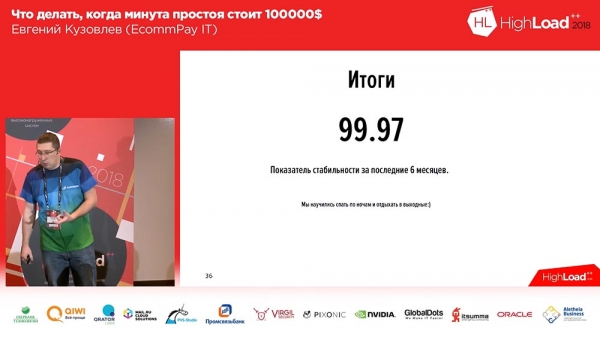
K čemu to všechno vedlo?Toto vedlo k tomu, že (měli jsme určité problémy se stabilitou, což nevyhovovalo ani klientům, ani nám) za posledních 6 měsíců náš ukazatel stability činí 99,97. Lze říci, že to není příliš mnoho. Ano, máme co zlepšovat. Z tohoto ukazatele je přibližně polovina stabilita, která není naší, ale našeho webového aplikačního firewallu, který stojí před námi a využívá se jako služba, ale klienti na to stejně nehledí.
Naučili jsme se konečně spát v noci! Před půl rokem jsme uměli. A na této notě, s výsledky, bych chtěl udělat poznámku. Včera večer byl skvělý přednes o systému řízení jaderného reaktoru. Pokud mě slyší lidé, kteří tento systém psali – prosím, zapomeňte na to, co jsem říkal o '2 % – to není výpadek'. Pro vás je 2 % výpadek, i když jen na dvě minuty!
A to všechno! Vaše dotazy.
O vyrovnávačích zátěže a migraci z databázových systémů
Dotaz z publika (dále – D): – Dobrý večer. Děkuji mnohokrát za takový správní referát! Dotaz je krátký, na téma vašich vyrovnávačů zátěže. Zmínili jste, že máte WAF, takže, jak to chápu, jako vyrovnávač zátěže používáte nějaký externí…
EK: – Ne, jako vyrovnávač zátěže používáme naše vlastní služby. V tomto případě je WAF pro nás výlučně nástrojem ochrany proti DDoS.
Otázka: – Můžete říci pár slov o vyrovnávačích zátěže?
EK: – Jak jsem již zmínil, je to skupina serverů v openresty. V současné době máme 5 skupin rezervovaných, které výhradně odpovídají… tedy server, na kterém je výhradně openresty, pouze proxy provozuje provoz. Pro pochopení, kolik toho zvládáme: máme nyní standardní tok provozu – několik stovek megabitů. Zvládají to, je to pro ně snadné, dokonce se nenamáhají.
Otázka: – Taktéž jednoduchá otázka. Existuje Blue/Green deployment. Co děláte, například, s migracemi databáze?
EK: – Dobrý dotaz! Podívejte se, v Blue/Green deployment máme samostatné fronty pro každou linii. Pokud mluvíme o frontách událostí, které se předávají od pracovníka k pracovníkovi, tam jsou samostatné fronty pro modrou linii a pro zelenou linii. Co se týče samotné databáze, úmyslně jsme ji zúžili, jak to šlo, téměř jsme všechno přenesli do front, v databázi máme pouze zásobník transakcí. A zásobník transakcí máme společný pro všechny linie. Co se týče databáze v tomto kontextu: nerozlišujeme ji na modrou a zelenou, protože oba varianty kódu musí vědět, co se děje s transakcí.
Druzí, mám ještě malou cenu, aby vás povzbudila – knihu. A tu ji musím předat za nejlepší otázku.
Otázka: – Dobrý den. Děkuji za referát. Dotaz je následující. Monitorujete platby, monitorujete služby, se kterými komunikujete… Ale jak monitorujete to, že člověk nějakým způsobem přišel na vaši platební stránku, provedl platbu a projekt mu připsal peníze? Jak monitorujete, že je merchant dostupný a přijal váš callback?
EK: – „Merchant“ pro nás v tomto případě představuje zcela stejnou externí službu, jako je platební systém. Monitorujeme rychlost odpovědi „merchanta“.
O šifrování databáze
Otázka: – Dobrý den. Mám tady menší otázku. Máte citlivá data podle PCI DSS. Chtěl jsem se zeptat, jak uchováváte PAN-y v frontách, které potřebujete procházet? Používáte nějaké šifrování? A druhý otázka, která z toho vyplývá: podle PCI DSS je nutné pravidelně znovu šifrovat databázi v případě změn (například odchod administrátorů) – jak v tomto případě probíhá dostupnost?
EK: – Skvělá otázka! Zaprvé, v frontách neuchováváme PAN-y. Nesmíme uchovávat PAN nikde v otevřené podobě, takže používáme speciální službu (nazýváme ji „Keydemon“) – je to služba, která dělá jen jedno: přijímá zprávu jako vstup a vrací ji zašifrovanou. A s touto zašifrovanou zprávou všechno uchováváme. Délka klíče je u nás pod kilobajt, aby to bylo opravdu solidní a spolehlivé.Otázka: – Teď už to musí být 2 kilobyty?
EK: – Zdálo se, že ještě včera to bylo 256… Kam ještě?!
To je první věc. A za druhé, řešení, které máme, podporuje proceduru přeshašifrování – tam jsou dvě sady „key“ (klíče), které dávají „dek“, které šifrují (key – to jsou klíče, dek – to jsou deriváty klíčů, které šifrují). A v případě iniciace procedury (probíhá pravidelně, od 3 měsíců po ± nějaké) nahráváme novou sadu „key“ a dochází k přeshašifrování dat. Máme samostatné služby, které vytáhnou všechna data, znovu je zašifrují; u těchto dat je uchováván identifikátor klíče, kterým byla zašifrována. Jakmile máme data zašifrovaná novými klíči, staré klíče odstraníme.
Někdy je třeba provádět platby ručně…
Otázka: – To znamená, že pokud dojde k vrácení nějaké operace, dešifrujete to zatím starým klíčem?
EK: – Ano.
Otázka: – Pak mám ještě jednu malou otázku. Když dojde k nějaké chybě, pádu, incidentu, je třeba prosadit transakci ručně. Stává se to.
EK: – Ano, stává se.
Otázka: – Odkud tyto údaje berete? Nebo do toho úložiště chodíte rukama vy?
EK: – Ne, ale je jasné, že máme nějaký back-office systém, který obsahuje rozhraní pro naši podporu. Pokud nevíme, v jakém stavu je transakce (například dokud platební systém neodpoví timeoutem) – ve své podstatě nevíme, tedy konečný stav stanovujeme pouze při úplné jistotě. V takovém případě transakci zařazujeme do speciálního stavu pro ruční zpracování. Ráno, následující den, jakmile podpora obdrží informace o tom, že v platebním systému zůstaly určité transakce, ručně je zpracovávají v tomto rozhraní.
Otázka: – Mám pár otázek. Jedna z nich se týká pokračování zóny PCI DSS: jak získáváte logy jejich obvodu? Tato otázka vznikla, protože vývojář mohl do logů dát cokoliv! Druhá otázka: jak nasazujete hotfixy? Ručně v databázi – to je jedna možnost, ale mohou být i free hotfixy – jaký je v tomto případě postup? A třetí otázka, pravděpodobně souvisí s RTO, RPO. Měli jste dostupnost 99,97, téměř čtyři devítky, ale jak chápu, máte i druhé datové centrum, třetí datové centrum a páté datové centrum… Jak se zabýváte jejich synchronizací, replikací, vším ostatním?EK: – Začněme prvním. První otázka byla o logách? U nás, když se zapisují logy, je zde proložení, které všechny citlivé údaje maskuje. Sleduje to podle masky a podle dalších polí. Tedy naše logy vycházejí již s maskovanými údaji a obvodem PCI DSS. To je jedna z pravidelných úloh, která byla přiřazena testovacímu oddělení. Jsou povinni každou úlohu kontrolovat rovněž na logy, které zapisují, a to je jedna z pravidelných úloh při code review, aby se kontrolovalo, že vývojář něco nezapsal. Následná kontrola se provádí pravidelně informačním zabezpečením asi jednou týdně: výběrově se berou logy za poslední den a jsou procházeny speciálním skenerem-analyzátorem z testovacích serverů, aby bylo vše ověřeno.
O hot-fixech. Je to zahrnuto v našich pravidlech nasazení. Máme zvláštní bod věnovaný hot-fixům. Považujeme za samozřejmé, že hot-fixy nasazujeme nonstop, kdykoliv je to třeba. Jakmile je verze sestavena, jakmile je otestována a jakmile máme artefakt – povoláme pohotovostního systémového administrátora na základě výzvy z podpory, který to nasadí v okamžiku, kdy je to nutné.O „čtyřech devítkách“. To číslo, které nyní máme, bylo skutečně dosaženo a usilovali jsme o něj i v jiném datovém centru. Nyní máme druhé datové centrum a začínáme rozkládat provoz mezi nimi, a otázka replikace mezi datovými centry je opravdu netriviální. Snažili jsme se tento problém vyřešit různými způsoby: pokoušeli jsme se použít „Tarantul“ – to nám hned nevyšlo. Proto jsme se rozhodli provádět objednávku „sensa“ ručně. Každá naše aplikace ve skutečnosti provádí potřebnou synchronizaci „change – done“ asynchronně mezi datovými centry.
Otázka: – Pokud máte druhé, proč nemáte třetí? Protože Split-brain zatím nikdo…
EK: – A my nemáme „Split-brain“. Kvůli tomu, že každá naše aplikace je řízena multimasterem, nezáleží nám na tom, do kterého centra přišla žádost. Jsme připraveni na to, že pokud jedno datové centrum selže (na to jsme připraveni) a během žádosti uživatele se přepne na druhé datové centrum, jsme skutečně ochotni o tohoto uživatele přijít; ale to budou jednotky, absolutní jednotky.
Otázka: – Dobrý večer. Děkuji za prezentaci. Vy jste mluvili o svém debugggeru, který v produkci provádí nějaké testovací transakce. A řekněte nám o testovacích transakcích! Jak hluboko to jde?
EK: – Prochází to plným cyklem celého komponentu. Pro komponent není rozdíl mezi testovací a reálnou transakcí. Z logického hlediska je to prostě určitý samostatný projekt v systému, na kterém probíhají pouze testovací transakce.
Otázka: – A kde ji odfiltrujete? Tady Core poslal…
EK: – V tomto případě jsme za „Core“ pro testovací transakce… Máme takový koncept, jako je routování: „Core“ ví, do jakého platebního systému to má poslat – my posíláme do fiktivního platebního systému, který pouze vrací http-odpověď a to je vše.
Otázka: – Řekněte, prosím, je vaše aplikace napsaná jako jeden obrovský monolit, nebo jste ji rozdělili na nějaké služby nebo dokonce mikroslužby?
EK: – My máme samozřejmě nesmonolit, máme aplikaci orientovanou na služby. Máme vtip, že máme službu složenou z monolitů – skutečně jsou dost velké. Mikroslužbami to nazvat opravdu nemůžu, ale skutečně se jedná o služby, uvnitř kterých pracují pracovníci distribuovaných strojů.
Pokud je služba na serveru kompromitována…
Otázka: – Tak mám další otázku. I kdyby to byl monolit, stejně jste řekli, že máte hodně těch instantních serverů, všechny v zásadě zpracovávají data, a otázka zní: „V případě kompromitace jednoho z instantních serverů nebo aplikace, jakékoli jednotlivé součásti, mají nějakou kontrolu přístupu? Kdo z nich co může dělat? Na koho se obrátit, pro jaká data?
EK: – Ano, rozhodně. Požadavky na bezpečnost jsou dost vážné. Za prvé, máme otevřená data a porty jsou jen ty, o kterých předpokládáme pohyb provozu. Pokud komponent komunikuje s databází (dejme tomu s 'MySQL') na portu 5-4-3-2, budou mu otevřeny pouze 5-4-3-2, a další porty, jiné směry pohybu provozu nebudou dostupné. Kromě toho je třeba chápat, že v produkčním prostředí existuje asi 10 různých bezpečnostních okruhů. A i když by aplikace byla nějakým způsobem kompromitována, nedej bože, útočník se nedostane k serverové konzole, protože to je jiná síťová bezpečnostní zóna.Otázka: – Mě v tomto kontextu více zajímá, že máte nějaké smlouvy se službami – co mohou dělat, přes jaké 'akce' mohou vzájemně komunikovat… A v normálním postupu určité služby žádají o nějakou řadu, seznam 'akcí' na jiné. Na jiné se normálně neobracejí, mají odlišné zóny odpovědnosti. Pokud by jedna z nich byla kompromitována, bude moci vyvolat 'akce' té služby?
EK: – Chápu. Pokud v běžné situaci s jiným serverem byla komunikace povolena, tak ano. Podle SLA smlouvy nesledujeme, že máte povoleny pouze první 3 akce, zatímco 4. akce není povolena. To je pro nás asi nadbytečné, protože máme obvykle čtyřúrovňový systém ochrany pro obvody. Preferujeme se bránit pomocí obvodů, než na úrovni interních komponent.
Jak fungují Visa, MasterCard a Sberbank
Otázka: – Chci upřesnit jednu věc ohledně přepnutí uživatele z jednoho datového centra do druhého. Jak vím, Visa a MasterCard fungují podle binárního synchronního protokolu 8583, tam jsou směsi. Chtěl jsem se zeptat, zda se teď jedná o přepnutí – zda se to týká přímo Visa a MasterCard, nebo procesorů a platebních systémů?
EK: – To se týká směsí. Směsi máme v jednom datovém centru.
Otázka: – Zjednodušeně řečeno, máte jedno připojení?
EK: – Pro Vizu a MasterCard – ano. Jen proto, že Visa a MasterCard vyžadují poměrně velké investice do infrastruktury pro uzavření jednotlivých smluv na získání druhé sady směsí, například. Jsou rezervovány v rámci jednoho datového centra, ale pokud, nedej bože, selže datové centrum, kde jsou směsi pro připojení k Vize a MasterCard, ztratíme spojení s Vízou a MasterCard...
Otázka: – Jak mohou být rezervovány? Vím, že Visa ve skutečnosti povoluje mít pouze jedno připojení!
EK: – Oni sami dodávají zařízení. Každopádně, dostali jsme zařízení, které je uvnitř železobetonově rezervováno.
Otázka: – Takže skříňka od jejich Connects Orange?..
EK: – Ano.
Otázka: – A jak to v takovém případě funguje: pokud vaše datové centrum zmizí, jak to dál používat? Nebo se prostě provoz zastaví?
EK: – Ne. V takovém případě jednoduše přepneme provoz na jiný kanál, který nám, samozřejmě, bude dražší, a dražší pro klienty. Ale provoz nepůjde naším přímým připojením k Vízě, MasterCard, ale přes hypotetického Sberbank (silně zjednodušeně).
Omlouvám se, pokud se dotknu zaměstnanců Sberbank. Ale podle naší statistiky Sberbank padá nejčastěji ze všech ruských bank. Neubehne měsíc, aby se Sberbankovi něco neporouchalo.

Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
