

Pokračujeme v sérii článků zaměřených na zkoumání málo známých způsobů, jak zlepšit výkon "na první pohled jednoduchých" dotazů na PostgreSQL:
Nemyslete si, že tak silně nemám rád JOIN… 🙂
Ale často bez něj je dotaz výrazně výkonnější, než s ním. Proto se dnes pokusíme úplně zbavit náročného JOIN — pomocí slovníku.
Od PostgreSQL 12 se část níže popsaných situací může chovat mírně jinak kvůli . Toto chování může být vráceno zpět k předchozímu pomocí nastavení klíče
MATERIALIZED.
Mnoho "faktů" o omezeném slovníku
Pojďme vzít v úvahu zcela reálný aplikační úkol — je třeba vypsat seznam nebo aktivních úkolů od odesílatelů:
25.01 | Ivanov I.I. | Připravit popis nového algoritmu.
22.01 | Ivanov I.I. | Napsat článek na Habru: život bez JOIN.
20.01 | Petrov P.P. | Pomoci optimalizovat dotaz.
18.01 | Ivanov I.I. | Napsat článek na Habru: JOIN s ohledem na rozdělení dat.
16.01 | Petrov P.P. | Pomoci optimalizovat dotaz.
Ve abstraktním světě by se autoři úkolů měli rozdělovat rovnoměrně mezi všechny zaměstnance naší organizace, ale ve skutečnosti úkoly přicházejí obvykle od dost omezeného počtu lidí — „od vedení“ nahoru po hierarchii nebo „od sousedů“ z vedlejších oddělení (analytici, designéři, marketing, …).
Předpokládejme, že v naší organizaci z 1000 lidí pouze 20 autorů (obvykle ještě méně) zadává úkoly konkrétním vykonavatelům a , abychom urychlili "tradiční" dotaz.
Generátor skriptů
-- zaměstnanci
CREATE TABLE person AS
SELECT
  id
, repeat(chr(ascii('a') + (id % 26)), (id % 32) + 1) "name"
, '2000-01-01'::date - (random() * 1e4)::integer birth_date
FROM
  generate_series(1, 1000) id;

ALTER TABLE person ADD PRIMARY KEY(id);

-- úkoly s uvedeným rozdělením
CREATE TABLE task AS
WITH aid AS (
  SELECT
    id
  , array_agg((random() * 999)::integer + 1) aids
  FROM
    generate_series(1, 1000) id
  , generate_series(1, 20)
  GROUP BY
    1
)
SELECT
  *
FROM
  (
    SELECT
      id
    , '2020-01-01'::date - (random() * 1e3)::integer task_date
    , (random() * 999)::integer + 1 owner_id
    FROM
      generate_series(1, 100000) id
  ) T
, LATERAL(
    SELECT
      aids[(random() * (array_length(aids, 1) - 1))::integer + 1] author_id
    FROM
      aid
    WHERE
      id = T.owner_id
    LIMIT 1
  ) a;

ALTER TABLE task ADD PRIMARY KEY(id);
CREATE INDEX ON task(owner_id, task_date);
CREATE INDEX ON task(author_id);
Zobrazíme posledních 100 úkolů pro konkrétního autora:
SELECT
  task.*
, person.name
FROM
  task
LEFT JOIN
  person
    ON person.id = task.author_id
WHERE
  owner_id = 777
ORDER BY
  task_date DESC
LIMIT 100; 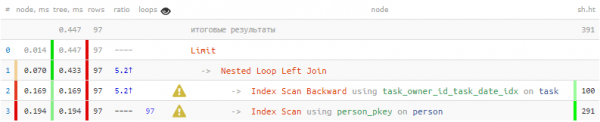
Dostáváme se k tomu, že 1/3 celkového času a 3/4 čtení datových stránek bylo provedeno jen proto, aby se sto krát hledal autor — pro každý zobrazený úkol. Ale víme, že z této stovky je celkem 20 různých — nelze využít toto poznání?
hstore-slovník
Využijeme k vytvoření „slovníku“ klíč-hodnota:
CREATE EXTENSION hstoreDo slovníku nám stačí umístit ID autora a jeho jméno, abychom později mohli extrahovat podle tohoto klíče:
-- vytváříme cílený výběr
WITH T AS (
  SELECT
    *
  FROM
    task
  WHERE
    owner_id = 777
  ORDER BY
    task_date DESC
  LIMIT 100
)
-- vytváříme slovník pro unikátní hodnoty
, dict AS (
  SELECT
    hstore( -- hstore(keys::text[], values::text[])
      array_agg(id)::text[]
    , array_agg(name)::text[]
    )
  FROM
    person
  WHERE
    id = ANY(ARRAY(
      SELECT DISTINCT
        author_id
      FROM
        T
    ))
)
-- získáváme související hodnoty slovníku
SELECT
  *
, (TABLE dict) -> author_id::text -- hstore -> klíč
FROM
T; 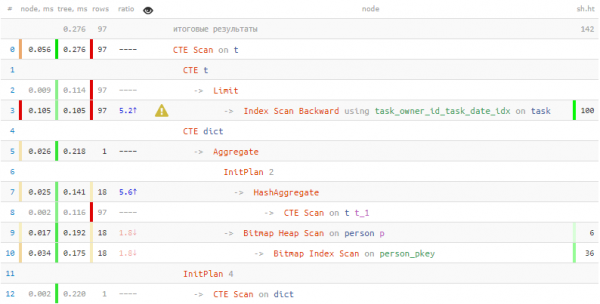
Na získání informací o osobách bylo vynaloženo dvakrát méně času a sedmkrát méně četných dat! Mimo „oslovaření“, těchto výsledků nám pomohlo dosáhnout také masové vytažení záznamů z tabulky v jednom průchodu pomocí = ANY(ARRAY(...)).
Záznamy tabulky: serializace a deserializace
Ale co dělat, pokud potřebujeme uložit do slovníku nejen jedno textové pole, ale celou položku? V tomto případě nám pomůže schopnost PostgreSQL pracovat s položkou tabulky jako s jednou hodnotou:
...
, dict AS (
  SELECT
    hstore(
      array_agg(id)::text[]
    , array_agg(p)::text[] -- magie #1
    )
  FROM
    person p
  WHERE
    ...
)
SELECT
  *
, (((TABLE dict) -> author_id::text)::person).* -- magie #2
FROM
  T;
Pojďme rozebrat, co se tu vlastně dělo:
- Vzali jsme p jako alias pro úplný záznam tabulky person a shromáždili jsme z nich pole.
- Tento pole záznamů jsme převedli na pole textových řetězců (person[]::text[]), abychom je mohli umístit do hstore slovníku jako pole hodnot.
- Při získávání souvisejícího záznamu jsme ho vytáhli ze slovníku podle klíče jako textový řetězec.
- Text musíme převést na hodnotu typu tabulky person (pro každou tabulku se automaticky vytváří odpovídající typ).
- Typizovaný záznam jsme "rozbalili" do sloupců pomocí
(...).*.
json slovníku
Ale takový trik, jaký jsme použili výše, neprojde, pokud neexistuje odpovídající tabulkový typ pro "přetypování". Stejná situace nastane, pokud se jako zdroj dat pro serializaci pokusíme použít CTE řetězec, a nikoli „skutečnou“ tabulku..
V tomto případě nám pomohou :
...
, p AS ( -- to už je CTE
  SELECT
    *
  FROM
    person
  WHERE
    ...
)
, dict AS (
  SELECT
    json_object( -- teď je to už json
      array_agg(id)::text[]
    , array_agg(row_to_json(p))::text[] -- a uvnitř json pro každý řádek
    )
  FROM
    p
)
SELECT
  *
FROM
  T
, LATERAL(
    SELECT
      *
    FROM
      json_to_record(
        ((TABLE dict) ->> author_id::text)::json -- extrahovali jsme ze slovníku jako json
      ) AS j(name text, birth_date date) -- vyplnili jsme potřebnou strukturu
  ) j;
Je třeba poznamenat, že při popisu cílové struktury můžeme uvádět pouze ta pole původního řetězce, která skutečně potřebujeme. Pokud máme "původní" tabulku, je lepší použít funkci json_populate_record.
Přístup k slovníku máme i nadále jednorázově, ale náklady na json-[de]seralizaci jsou dost vysoké,, proto je rozumné takový způsob používat pouze v některých případech, kdy "poctivý" CTE scan vykazuje horší výkon.
Testujeme výkon
Takže jsme získali dva způsoby serializace dat do slovníku — hstore / json_object.Kromě toho lze samotná pole klíčů a hodnot také generovat dvěma způsoby, s vnitřním nebo vnějším převodem na text: array_agg(i::text) / array_agg(i)::text[].
Ověříme efektivitu různých typů serializace na ryze syntetickém příkladu — serializujeme různé množství klíčů.:
WITH dict AS (
  SELECT
    hstore(
      array_agg(i::text)
    , array_agg(i::text)
    )
  FROM
    generate_series(1, ...) i
)
TABLE dict;
Odhadovací skript: serializace
S T AS (
  VYBERTE
    *
  , (
      VYBERTE
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      Z
        (
          VYBERTE
            array_agg(el) ea
          Z
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              S T AS (
                VYBERTE
                  hstore(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                Z
                  generate_series(1, $$ || (1 << v) || $$) i
              Z
              TABLE dict
            $$) T(el text)
        Z
    ) et
  Z
    generate_series(0, 19) v
  ,   LATERAL generate_series(1, 7) i
  ŘADIT
    1, 2
)
VYBERTE
  v
, avg(et)::numeric(32,3)
Z
  T
GROUP BY
  1
ŘADIT
1; 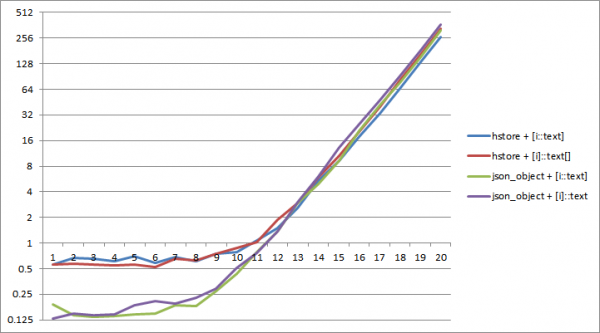
Na PostgreSQL 11 přibližně do velikosti slovníku 2^12 klíčů serializace do json vyžaduje méně času. Nejúčinnější kombinací je json_object a „interní“ převedení typů array_agg(i::text).
Teď se pokusme přečíst hodnotu každého klíče 8krát — pokud se na slovník neodkazuje, k čemu je tedy potřeba?
Hodnotící skript: čtení ze slovníku
S T AS (
  VYBERTE
    *
  , (
      VYBERTE
        regexp_replace(ea[array_length(ea, 1)], '^Execution Time: (d+.d+) ms$', '1')::real et
      Z
        (
          VYBERTE
            array_agg(el) ea
          Z
            dblink('port= ' || current_setting('port') || ' dbname=' || current_database(), $$
              explain analyze
              S T AS (
                VYBERTE
                  json_object(
                    array_agg(i::text)
                  , array_agg(i::text)
                  )
                Z
                  generate_series(1, $$ || (1 << v) || $$) i
              Z
              VYBERTE
                (TABLE dict) -> (i % ($$ || (1 << v) || $$) + 1)::text
              Z
                generate_series(1, $$ || (1 << (v + 3)) || $$) i
            $$) T(el text)
        Z
    ) et
  Z
    generate_series(0, 19) v
  , LATERAL generate_series(1, 7) i
  ŘADIT
    1, 2
)
VYBERTE
  v
, avg(et)::numeric(32,3)
Z
  T
GROUP BY
  1
ŘADIT
1; 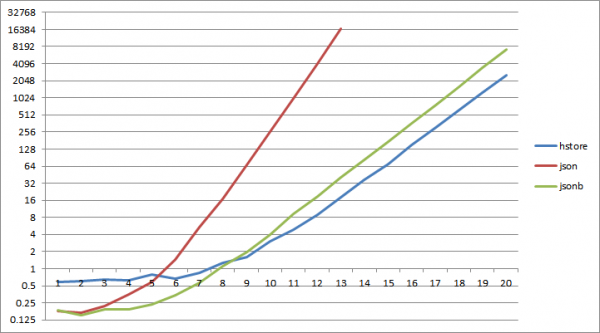
A... už přibližně při 2^6 klíčích čtení ze json slovníku začíná výrazně prohrávat čtení z hstore, pro jsonb to samé nastává při 2^9.
Závěrečné závěry:
- pokud je potřeba udělat JOIN s opakovaně se vyskytujícími záznamy je lepší použít „oslovení“ tabulky
- pokud váš slovník je očekávaně malý a číst z něj budete málo můžete použít json[b]
- ve všech ostatních případech hstore + array_agg(i::text) bude efektivnější
Zdroj: habr.com
