

Na RIT 2019 náš kolega Alexandr Korotkov mluvil o automatizaci vývoje v CIAN: abychom usnadnili život a práci, používáme naši vlastní platformu Integro. Ta sleduje životní cyklus úloh, zbavuje vývojáře rutinních operací a výrazně snižuje počet chyb v produkci. V tomto příspěvku doplníme Alexandrův referát a povíme, jak jsme přešli od jednoduchých skriptů k integraci open source produktů přes vlastní platformu a čemu se věnuje náš samostatný tým automatizace.
Nulová úroveň
„Nulová úroveň neexistuje, nevím o takové“
Mistr Shifu z m/f „Kung-Fu Panda“
Automatizace v CIAN začala 14 let po založení společnosti. Tehdy v týmu vývoje bylo 35 lidí. Těžko tomu uvěřit, že? Samozřejmě, v nějaké formě automatizace přece jen existovala, ale samostatný směr pro nepřetržitou integraci a dodávku kódu se začal formovat právě v roce 2015.
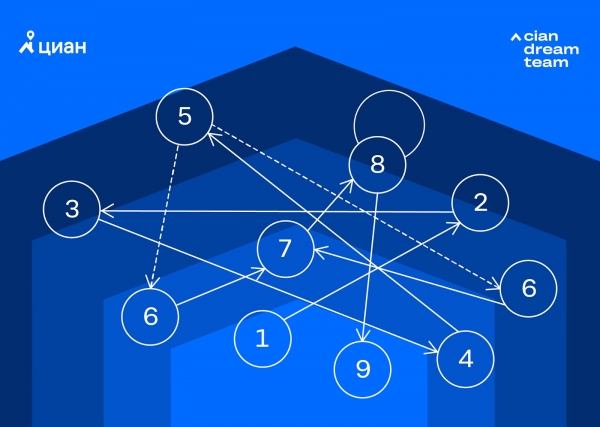
V tu dobu jsme měli obrovský monolit z Pythonu, C# a PHP, nasazený na serverech Linux/Windows. Pro nasazení tohoto monstra jsme měli sadu skriptů, které jsme spouštěli ručně. Byla také sestava monolitu, která přinášela bolest a utrpení kvůli konfliktům při sloučení větví, opravám chyb a opětovnému sestavování „s jiným souborem úloh v sestavení“. Zjednodušeně proces vypadal takto:
To nás neuspokojovalo a chtěli jsme vybudovat opakovatelný, automatizovaný a řízený proces sestavování a nasazení. K tomu jsme potřebovali CI/CD systém a vybírali jsme mezi bezplatnou verzí Teamcity a bezplatným Jenkins, protože jsme s nimi pracovali a obě nám vyhovovaly z hlediska funkcí. Vybrali jsme Teamcity jako modernější produkt. Tehdy jsme ještě nepoužívali mikroslužbovou architekturu a nepočítali jsme s velkým množstvím úloh a projektů.
Dostáváme se k myšlence vlastní systému
Zavedení Teamcity odstranilo pouze část ruční práce: zbylo ještě vytváření Pull Requestů, posouvání úkolů podle statusů v Jira, výběr úkolů pro vydání. S tím si systém Teamcity už neporadil. Bylo potřeba hledat cestu další automatizace. Zvažovali jsme možnosti práce se skripty v Teamcity nebo přechod na externí automatizační systémy. Nakonec jsme se rozhodli, že potřebujeme maximální flexibilitu, kterou poskytuje pouze vlastní řešení. Tak se objevila první verze interního automatizačního systému s názvem Integro.
Teamcity se zabývá automatizací na úrovni spuštění procesů sestavení a nasazení, zatímco Integro se zaměřila na nadřazenou automatizaci vývojových procesů. Bylo třeba spojit práci s úkoly v Jira se zpracováním souvisejícího zdrojového kódu v Bitbucket. V této fázi se v Integro začaly objevovat vlastní pracovní postupy pro práci s úkoly různých typů.
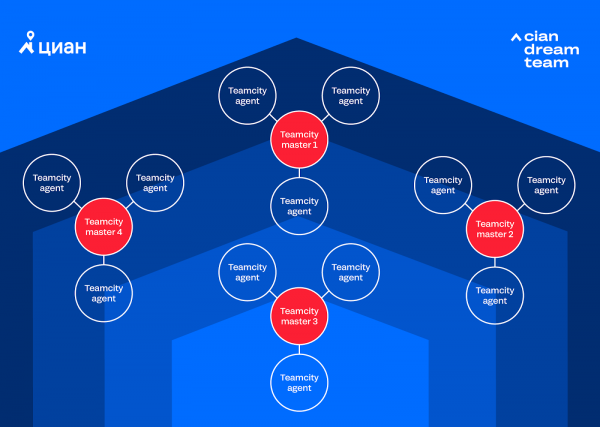
V důsledku zvýšení automatizace v obchodních procesech vzrostl počet projektů a běhů v Teamcity. To přineslo nový problém: jedno bezplatné instance Teamcity už nestačilo (3 agenty a 100 projektů), přidali jsme další instanci (další 3 agenty a 100 projektů), pak ještě jednu. Nakonec jsme získali systém několika klastrů, který bylo obtížné spravovat:
Když se naskytla otázka čtvrté instance, uvědomili jsme si, že takto dál žít nemůžeme, protože celkové náklady na podporu čtyř instancí už se nehodily do žádného rámce. Vznikla otázka, zda koupit placenou verzi Teamcity nebo zvolit bezplatný Jenkins. Provedli jsme výpočty týkající se instancí a plánů automatizace a rozhodli jsme se, že budeme pokračovat na Jenkinsu. O pár týdnů později jsme přešli na Jenkins a zbavili se části bolesti hlavy spojené s podporou několika instancí Teamcity. Díky tomu jsme se mohli soustředit na vývoj Integro a přizpůsobení Jenkinsu našim potřebám.
S rostoucí základní automatizací (ve formě automatického vytváření Pull Requestů, sběru a publikování pokrytí kódu a dalších kontrol) vznikla silná touha co nejvíce se vzdát manuálních vydání a přenechat tuto práci robotům. Kromě toho uvnitř společnosti začal přesun na mikroslužby, které vyžadovaly častá vydání, a to odděleně od sebe. Tak jsme postupně dospěli k automatickým vydáním našich mikroslužeb (monolit zatím vydáváme ručně kvůli složitosti procesu). Ale, jak to obvykle bývá, objevila se nová komplikace.
Automatizujeme testování
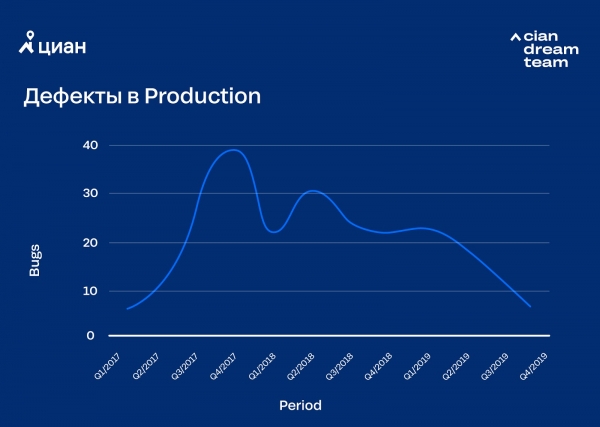
Díky automatizaci vydání se zrychlily procesy vývoje, částečně i na úkor vynechání některých fází testování. To vedlo k dočasné ztrátě kvality. Zní to banálně, ale spolu se zrychlením vydání bylo potřeba změnit i metodologii vývoje produktu. Bylo nutné přemýšlet o automatizaci testování, zavedení osobní odpovědnosti (tady jde o "přijetí myšlenky v hlavě", a ne o finanční sankce) vývojáře za vydaný kód a chyby v něm, a také o rozhodnutí o vydání/ne vydání úkolu prostřednictvím automatického nasazení.
Při řešení problémů s kvalitou jsme dospěli k dvěma důležitým rozhodnutím: začali jsme provádět kanárková testování a zavedli jsme automatické monitorování chyb na pozadí s automatickou reakcí na jeho překročení. První řešení nám umožnilo nalézt zřejmé chyby ještě před plnohodnotným nasazením kódu do produkce, druhé snížilo dobu reakce na problémy v produkci. Chyby se samozřejmě stávají, ale většinu času a úsilí neztrácíme na opravy, ale na minimalizaci.
Tým automatizace
Nyní máme 130 vývojářů a pokračujeme . Tým pro neustálou integraci a dodávání kódu (dále – tým Deploy and Integration nebo DI) se skládá ze 7 lidí a pracuje ve 2 směrech: vývoj platformy automatizace Integro a DevOps.
DevOps zajišťuje Dev/Beta prostředí webu CIAN, prostředí Integro, pomáhá vývojářům při řešení problémů a vyvíjí nové přístupy k škálování prostředí. Oddělení vývoje Integro se zabývá jak samotnou Integro, tak příbuznými službami, například pluginy pro Jenkins, Jira, Confluence, a také vyvíjí pomocné utilitky a aplikace pro týmy vývojářů.
Tým DI spolupracuje s týmem Platformy, který se zabývá vývojem architektury, knihoven a přístupů k vývoji uvnitř společnosti. Každý vývojář v CIAN může také přispět k automatizaci, například vytvořit mikroautomatizaci podle potřeb týmu nebo se podělit o skvělý nápad, jak zlepšit automatizaci.
Vrstvený koláč automatizace v CIAN
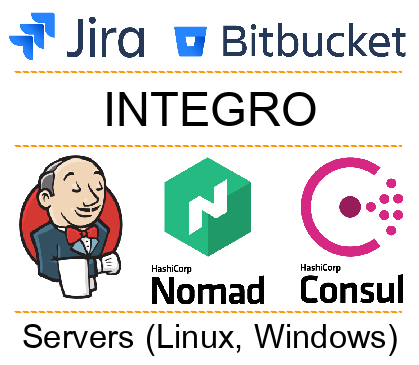
Všechny systémy zapojené do automatizace lze rozdělit do několika vrstev:
- Externí systémy (Jira, Bitbucket atd.). S těmito systémy pracují týmy vývoje.
- Platforma Integro. Nejčastěji s ní vývojáři nepracují přímo, ale právě ona podporuje fungování celé automatizace.
- Služby dodávky, orchestraci a objevování (například Jenkins, Consul, Nomad). S jejich pomocí nasazujeme kód na serverech a zajišťujeme vzájemnou spolupráci služeb.
- Fyzická úroveň (servery, OS, příbuzný software). Na této úrovni běží náš kód. Může to být jak fyzický server, tak virtuální (LXC, KVM, Docker).
Na základě této koncepce rozdělujeme zóny odpovědnosti uvnitř týmu DI. Dvě první úrovně patří pod zodpovědnost oddělení vývoje Integro, zatímco dvě poslední úrovně již spadají pod zodpovědnost DevOps. Toto rozdělení umožňuje soustředit se na úkoly a nebrání vzájemné interakci, protože jsme si navzájem blízko a neustále sdílíme znalosti a zkušenosti.
Integro
Soustředíme se na Integro a začneme technologickým stackem:
- CentOs 7
- Docker + Nomad + Consul + Vault
- Java 11 (starý monolit Integro zůstane na Java 8)
- Spring Boot 2.X + Spring Cloud Config
- PostgreSql 11
- RabbitMQ
- Apache Ignite
- Camunda (embedded)
- Grafana + Graphite + Prometheus + Jaeger + ELK
- Web UI: React (CSR) + MobX
- SSO: Keycloak
Držíme se principu mikroservisní architektury, ačkoli máme také dědictví v podobě monolitu starší verze Integro. Každá mikroservis běží ve svém Docker kontejneru, služby spolu komunikují pomocí HTTP požadavků a zpráv RabbitMQ. Mikroservisy se navzájem nacházejí prostřednictvím Consulu a k němu zasílají žádosti, přičemž procházejí autorizací přes SSO (Keycloak, OAuth 2/OpenID Connect).
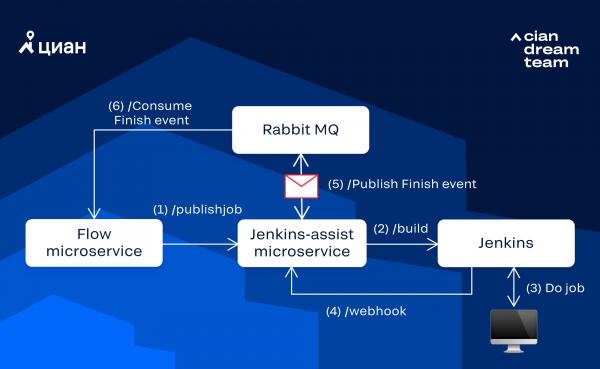
Jako konkrétní příklad si vezměme interakci s Jenkins, která se skládá z následujících kroků:
- Mikroservis pro správu workflow (dále Flow mikroservis) chce spustit sestavení v Jenkins. K tomu prostřednictvím Consulu najde IP:PORT mikroservisu pro integraci s Jenkins (dále Jenkins mikroservis) a zasílá do něj asynchronní požadavek na spuštění sestavení v Jenkins.
- Mikroservis Jenkins po obdržení požadavku vytvoří a vrátí ve své odpovědi Job ID, podle kterého bude možné identifikovat výsledek práce. Spolu s tím zahájí sestavení v Jenkins prostřednictvím volání REST API.
- Jenkins provede sestavení a po jeho dokončení odešle webhook s výsledky vykonání do Jenkins mikroservisu.
- Mikroservis Jenkins, po obdržení webhooku, vytvoří zprávu o skončení zpracování požadavku a připojí k ní výsledky vykonání. Vytvořená zpráva je odeslána do fronty RabbitMQ.
- Zpráva publikovaná prostřednictvím RabbitMQ se dostane k Flow mikroservisu, který se dozví o výsledku zpracování své úlohy, když porovná Job ID z požadavku a obdržené zprávy.
Nyní máme přibližně 30 mikroservisů, které je možné rozdělit do několika skupin:
- Správa konfigurací.
- Informování a interakce s uživateli (messengery, e-mail).
- Práce se zdrojovým kódem.
- Integrace s nasazovacími nástroji (Jenkins, Nomad, Consul atd.).
- Monitorování (verzí, chyb atd.).
- Webové nástroje (UI pro správu testovacích prostředí, shromažďování statistik atd.).
- Integrace s task trackery a podobnými systémy.
- Správa workflow pro různé úkoly.
Workflow úkolu
Integro automatizuje akce související se životním cyklem úkolu. Zjednodušeně budeme pod životním cyklem úkolu chápat workflow úkolu v Jira. V našich vývojových procesech existuje několik variant workflow v závislosti na projektu, typu úkolu a možnostech vybraných v konkrétním úkolu.
Podívejme se na workflow, které používáme nejčastěji:
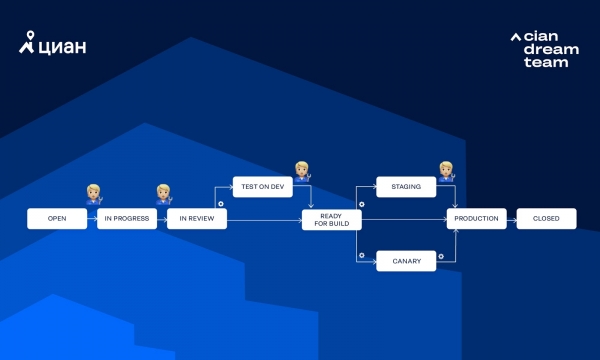
Na diagramu ozubené kolečko znamená, že přechod je vyvolán Integro automaticky, zatímco postava člověka označuje, že přechod je vyvolán manuálně člověkem. Podívejme se na několik cest, kterými může úkol projít v tomto workflow.
Úplně ruční testování na DEV+BETA bez kanárkových testů (obvykle tak vydáváme monolit):
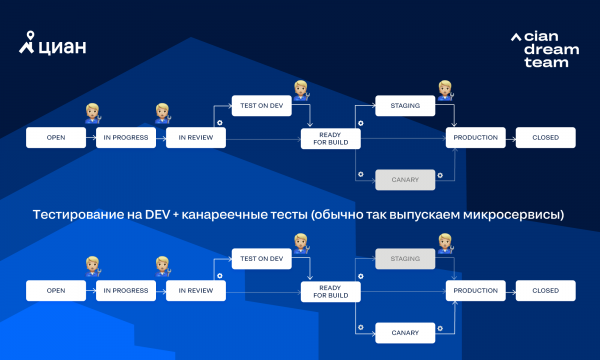
Mohou existovat i jiné kombinace přechodů. Někdy lze cestu, kterou úkol půjde, vybrat prostřednictvím options v Jira.
Pohyb úkolu
Podívejme se na hlavní kroky, které se provádějí při pohybu úkolu v workflow „Testování na DEV + kanárkové testy“:
1. Vývojář nebo PM vytvoří úkol.
2. Vývojář vezme úkol do práce. Po dokončení ho převede do stavu IN REVIEW.
3. Jira odešle Webhook směrem k Jira-mikroslužbě (odpovídá za integraci s Jira).
4. Jira-mikroslužba odešle žádost do Flow-servisu (odpovídá za vnitřní workflow, ve kterých se vykonává práce) k zahájení workflow.
5. Uvnitř Flow-servisu:
- Jsou přiřazeni recenzenti k úkolu (Users-mikroslužba, která zná všechny o uživatelích + Jira-mikroslužba).
- Pro každý nalezený repozitář se provádí hledání větví, ve kterých je větev našeho úkolu (pro usnadnění hledání se název větve shoduje s číslem úkolu v Jira). Většinou má úkol pouze jednu větev v jednom repozitáři, což usnadňuje správu fronty na nasazení a snižuje provázanost mezi repozitáři.
- Pro každou nalezenou větev se provádí následující sekvence akcí:
i) Slití master-větve (Git-mikroslužba pro práci s kódem).
ii) Větev je zablokována před změnami vývojářem (Bitbucket-mikroslužba).
iii) Je vytvořen Pull Request na tuto větev (Bitbucket-mikroslužba).
iv) Je odeslána zpráva o novém Pull Requestu do chatů vývojářů (Notify-mikroslužba pro práci s upozorněními).
v) Spouští se sestavení, testování a nasazení úkolu na DEV (Jenkins-mikroslužba pro práci s Jenkins).
vi) Pokud všechny předchozí body úspěšně skončily, Integro schválí Pull Request (Bitbucket-mikroslužba). - Integro čeká na schválení Pull Requestu od přiřazených recenzentů.
- Jakmile jsou získána všechna potřebná schválení (včetně úspěšně provedených automatizovaných testů), Integro převede úkol do stavu Test on Dev (Jira-mikroslužba).
6. Testeři provádějí testování úkolu. Pokud nejsou žádné problémy, převedou úkol do stavu Ready For Build.
7. Integro „vidí“, že úkol je připraven k vydání, a spouští jeho nasazení v kanárkovém režimu (Jenkins-mikroslužba). Připravenost k vydání je určena sadou pravidel. Například úkol je ve správném stavu, nejsou žádné blokace na jiné úkoly, v tuto chvíli nejsou aktivní nasazení této mikroslužby atd.
8. Úkol je převeden do stavu Canary (Jira-mikroslužba).
9. Jenkins spouští nasazení úkolu v kanárkovém režimu prostřednictvím Nomad (obvykle 1-3 instance) a informuje o nasazení monitorovací službu vydání (DeployWatch-mikroslužba).
10. DeployWatch-mikroslužba shromažďuje pozadí chyb a reaguje na něj, pokud je to nutné. Při překročení pozadí chyb (norma pozadí se počítá automaticky) je provedeno oznámení vývojářům prostřednictvím Notify-mikroslužby. Pokud vývojář během 5 minut nereaguje (stiskne Revert nebo Stay), spustí se automatický rollback kanárkových instancí. Pokud není pozadí překročeno, musí vývojář ručně spustit nasazení úkolu na Production (stisknutím tlačítka v UI). Pokud během 60 minut vývojář nespustil nasazení na Production, budou kanárkové instance také z důvodu bezpečnosti odebrány.
11. Po spuštění nasazení na Production:
- Úkol je převeden do stavu Production (Jira-mikroslužba).
- Jenkins-mikroslužba spouští proces nasazení a informuje o nasazení DeployWatch-mikroslužbu.
- DeployWatch-mikroslužba kontroluje, že na Production byly aktualizovány všechny kontejnery (byly případy, kdy se neaktualizovalo vše).
- Prostřednictvím Notify-mikroslužby se odešle oznámení o výsledcích nasazení na Production.
12. Vývojáři budou mít 30 minut na spuštění rollbacku úkolu z Production v případě zjištění nesprávného chování mikroslužby. Po uplynutí této doby bude úkol automaticky sloučen do masteru (Git-mikroslužba).
13. Po úspěšném merge do masteru bude stav úkolu změněn na Closed (Jira-mikroslužba).
Schéma si nenárokuje na úplnou detailnost (ve skutečnosti je kroků ještě více), ale umožňuje posoudit míru integrace do procesů. Nepovažujeme toto schéma za ideální a zlepšujeme procesy automatického doprovodu vydání a nasazení.
Co dál
Máme velké plány na rozvoj automatizace, například odmítnutí ručních operací při vydání monolitu, zlepšení monitorování při automatickém nasazení a zlepšení interakce s vývojáři.
Ale tímto místem zatím skončíme. Mnoho témat v přehledu automatizace jsme pokryli povrchně, některá jsme vůbec nezmínili, proto rádi odpovíme na vaše otázky. Těšíme se na vaše návrhy, co podrobněji osvětlit, pište do komentářů.
Zdroj: habr.com
