

Ahoj, Habrčané. Tradičně pokračujeme ve sdílení zajímavého materiálu před zahájením nových kurzů. Dnes jsme pro vás připravili článek o Google Cloud Spanner, který jsme spojili se spuštěním kurzu. .
Původně publikováno v .
Jako společnost nabízející řadu cloudových POS řešení pro maloobchodníky, restaurace a online prodejce po celém světě, Lightspeed využívá několik různých typů databázových platforem pro různé transakční, analytické a vyhledávací případy. Každá z těchto databázových platforem má své silné a slabé stránky. Když Google uvedl na trh Cloud Spanner — slibné funkce, které nemají prekročit v oblasti relačních databází, jako je prakticky neomezená horizontální škálovatelnost a SLA 99,999 % — nemohli jsme si nechat ujít příležitost ji vyzkoušet!
Abychom poskytli komplexní přehled našich zkušeností s Cloud Spanner a hodnotících kritérií, které jsme použili, zaměříme se na následující témata:
- Naše hodnotící kritéria
- Cloud Spanner v kostce
- Naše hodnocení
- Naše závěry
1. Naše hodnotící kritéria
Předtím, než se ponoříme do funkcí Cloud Spanner, jejích podobností a rozdílů s jinými řešeními na trhu, nejdříve si promluvme o hlavních případech použití, které jsme měli na mysli, když jsme zvažovali, kde nasadit Cloud Spanner v naší infrastruktuře:
- Jako náhrada (prevládající) tradičního SQL databázového řešení
- Jako OLTP řešení s podporou OLAP
Poznámka: Pro jednoduchost a přehlednost srovnává tento článek Cloud Spanner s variantami MySQL rodiny GCP Cloud SQL a Amazon AWS RDS.
Použití Cloud Spanner jako náhrady za tradiční SQL databázové řešení
V prostředí tradičních databází, kdy doba odezvy na dotaz do databáze se blíží nebo dokonce překračuje předem stanovené prahové hodnoty aplikace (většinou kvůli nárůstu počtu uživatelů a/nebo požadavků), existuje několik způsobů, jak snížit dobu odezvy na přijatelnou úroveň. Většina z těchto řešení však vyžaduje ruční zásah.
Například prvním krokem, který je třeba učinit, je podívat se na různé parametry databáze související s výkonem a nastavit je tak, aby nejlépe odpovídaly vzorům scénářů použití aplikací. Pokud to nebude stačit, můžete vybrat vertikální nebo horizontální škálování databáze.
Vertikální škálování aplikace zahrnuje aktualizaci instance serveru, obvykle přidáním většího počtu procesorů/jader, většího objemu operační paměti, rychlejšího úložiště atd. Přidání většího počtu hardwarových prostředků vede ke zvýšení výkonu databáze, měřeného především v transakcích za sekundu, a latencích transakcí pro OLTP systémy. Systémy relačních databází (které používají vícevláknový přístup), jako je MySQL, se dobře škálují vertikálně.
Tento přístup má několik nevýhod, ale nejzřejmější je maximální velikost serveru na trhu. Jakmile dosáhnete limitu největší instance serveru, zbývá jen jedna cesta: horizontální škálování.
Horizontální škálování je přístup, při kterém se do clusteru přidává více serverů, aby se ideálně lineárně zvyšoval výkon s přidáním počtu serverů. Většina tradičních databázových systémů se špatně škáluje horizontálně nebo se vůbec nenačítá. Například MySQL může horizontálně škálovat pro operace čtení přidáním slave-čteček, ale nemůže horizontálně škálovat pro operace zápisu.
Na druhé straně, díky své povaze Cloud Spanner může snadno horizontálně škálovat s minimálním zasahováním.
Plnohodnotná DB jako služba by měla být hodnocena z různých úhlů pohledu. Jako základ jsme vzali nejpopulárnější cloudovou DB — pro Google, GCP Cloud SQL a pro Amazon, AWS RDS. V našem hodnocení jsme se soustředili na následující kategorie:
- Porovnání funkcí: rozšíření SQL, DDL, DML; knihovny připojení/konnektory, podpora transakcí atd.
- Podpora vývoje: jednoduchost vývoje a testování.
- Podpora správy: správa instancí – například škálování nahoru/dolů a upgrade instancí; SLA, zálohování a obnovení; bezpečnost/kontrola přístupu.
Použití Cloud Spanner jako OLTP řešení s podporou OLAP.
I když Google výslovně netvrdí, že Cloud Spanner je určen pro analytické zpracování, sdílí některé atributy s jinými mechanismy, jako jsou Apache Impala & Kudu a YugaByte, které jsou určeny pro OLAP pracovní zátěže.
I kdyby existovala jen malá pravděpodobnost, že Cloud Spanner zahrnuje konzistentní horizontálně škálovatelný HTAP (hybridní transakčně/analytické zpracování) motor s (více či méně) použitelnou sadou funkcí OLAP, myslíme, že by to stálo za naši pozornost.
S tímto na paměti jsme prozkoumali následující kategorie:
- Načítání dat, indexy a podpora partitioning.
- Výkon dotazů a DML.
2. Cloud Spanner v několika slovech.
Google Spanner je clusterový systém řízení relačních databází (RDBMS), který Google používá pro několik svých vlastních služeb. Google jej zpřístupnil pro uživatele Google Cloud Platform na začátku roku 2017.
Zde jsou některé atributy Cloud Spanner:
- Silně konzistentní škálovatelný cluster RDBMS: používá hardwarovou synchronizaci času k zajištění konzistence dat.
- Podpora transakcí napříč tabulkami: transakce mohou zahrnovat více tabulek – nemusí být omezeny na jednu tabulku (na rozdíl od Apache HBase nebo Apache Kudu).
- Tabulky na základě primárního klíče: všechny tabulky musí mít deklarovaný primární klíč (PK), který může být složen z několika sloupců tabulky. Tabulková data jsou ukládána podle PK, což je činí velmi efektivními a rychlými pro vyhledávání podle PK. Stejně jako v jiných systémech na bázi PK, implementace musí být modelována s ohledem na předem promyšlené uživatelské případy pro dosažení .
- Střídající se tabulky: tabulky mohou mít fyzické závislosti mezi sebou. Řádky podřízené tabulky mohou být přiřazeny k řádkům nadřízené tabulky. Tento přístup zrychluje hledání vztahů, které mohou být definovány ve fázi modelování dat, například při společném umístění klientů a jejich faktur.
- Indexy: Cloud Spanner podporuje sekundární indexy. Index se skládá z indexovaných sloupců a všech sloupců primárního klíče. Pokud je to žádoucí, může index také obsahovat další neindexované sloupce. Index může být propojen s nadřízenou tabulkou pro zrychlení dotazů. Na indexy se vztahuje několik omezení, například maximální počet dodatečných sloupců uložených v indexu. Také dotazy přes indexy mohou být méně přímočaré než v jiných RDBMS.
„Cloud Spanner automaticky vybírá index pouze ve vzácných případech. Zejména Cloud Spanner nevybírá sekundární index automaticky, pokud dotaz požaduje jakékoli sloupce, které nejsou uloženy v ».
- Dohoda o úrovni služeb (SLA): nasazení v jednom regionu se SLA 99,99%; víceregionální nasazení se SLA 99,999%. Přestože samotná dohoda o úrovni služeb je pouze dohodou, nikoli nějakou zárukou, myslím, že zaměstnanci společnosti Google mají skutečně nějaká přesná data, aby mohli učinit tak vážné tvrzení. (Pro srovnání, 99,999% znamená 26,3 sekundy nedostupnosti služby za měsíc.)
- Více:
Poznámka: Projekt Apache Tephra přidává rozšířenou podporu transakcí do Apache HBase (nyní je také implementován v Apache Phoenix jako beta verze).
3. Náš odhad
Takže jsme všichni četli prohlášení Google o výhodách Cloud Spanner – prakticky neomezené horizontální škálování při zachování vysoké konzistence a velmi vysokého SLA. I když je těchto požadavků v každém případě extrémně obtížné dosáhnout, naším cílem nebylo je vyvracet. Místo toho se zaměřme na jiné aspekty, které většinu uživatelů databází zajímají: spolehlivost a uživatelská přívětivost.
Ohodnotili jsme Cloud Spanner jako náhradu za Sharded MySQL.
Google Cloud SQL a Amazon AWS RDS, dvě nejpopulárnější OLTP DB na cloudovém trhu, nabízejí velmi širokou škálu funkcí. Nicméně, abyste tyto databáze mohli škálovat za hranice velikosti jednoho uzlu, musíte provádět sharding aplikací. Tento přístup přináší dodatečnou složitost jak pro aplikace, tak pro správu. Prozkoumali jsme, jak Spanner zapadá do scénáře slučování několika segmentů do jednoho instance a jaké funkce (pokud vůbec nějaké) může být nutné obětovat.
Podpora SQL, DML a DDL, stejně jako konektor a knihovny?
Za prvé, při spuštění s jakoukoli databází je nutné vytvořit datový model. Pokud si myslíte, že můžete připojit JDBC Spanner k vašemu oblíbenému nástroji SQL, zjistíte, že můžete pomocí něj dotazovat svá data, ale nemůžete ho použít k vytváření tabulek nebo k provádění změn (DDL) či jakýchkoli operací vkládání/aktualizace/mazání (DML). Oficiální JDBC od Google nepodporuje ani jedno.
„V současné době ovladače nepodporují příkazy DML nebo DDL.“
Dokumentace Spanner
Seznam GCP není o nic lepší – můžete odesílat pouze SELECT dotazy. Naštěstí existuje JDBC ovladač s podporou DML a DDL od komunity, včetně transakcí. . I když je tento ovladač velmi užitečný, absence vlastního JDBC ovladače od Google vzbuzuje překvapení. Naštěstí Google nabízí relativně širokou podporu klientských knihoven (na bázi gRPC): C#, Go, Java, node.js, PHP, Python a Ruby.
Téměř povinné používání vlastních API Cloud Spanner (kvůli absenci DDL a DML v JDBC) přináší určitá omezení pro související oblasti kódu, jako jsou pooly připojení nebo frameworky pro vazbu databáze (např. Spring MVC). Obecně platí, že při použití JDBC si můžete svobodně zvolit oblíbený pool připojení (např. HikariCP, DBCP, C3PO atd.), který byl testován a dobře funguje. V případě vlastních API Spanner se musíme spoléhat na frameworky/pooly vazby/sezení, které jsme si vytvořili sami.
Struktura zaměřená na primární klíč (PK) umožňuje Cloud Spanneru být velmi rychlý při přístupu k datům přes PK, ale také přináší některé problémy s dotazy.
- Nemůžete aktualizovat hodnotu primárního klíče; nejprve musíte odstranit záznam s původním PK a znovu jej vložit s novou hodnotou. (To je podobné jako u jiných databází zaměřených na PK / úložišť.)
- Jakékoli operátory UPDATE a DELETE musí specifikovat PK v WHERE, proto nemohou být prázdné operátory DELETE all — vždy musí být poddotaz, například: UPDATE xxx WHERE id IN (SELECT id FROM table1)
- Není zde žádná možnost autoinkrementace nebo něčeho podobného, co určuje sekvenci pro pole PK. Aby to fungovalo, musí být odpovídající hodnota vytvořena na straně aplikace.
Sekundární indexy?
Google Cloud Spanner má vestavěnou podporu sekundárních indexů. Je to velmi příjemná funkce, která není vždy přítomna v jiných technologiích. Apache Kudu v současnosti vůbec nepodporuje sekundární indexy, zatímco Apache HBase nepodporuje indexy přímo, ale může je přidávat prostřednictvím Apache Phoenix.
Indexy v Kudu a HBase lze modelovat jako samostatné tabulky s odlišnými složeními primárních klíčů, ale atomickost operací prováděných s nadřazenou tabulkou a souvisejícími indexovými tabulkami musí být zajištěna na úrovni aplikace a není triviální při správné implementaci.
Jak bylo zmíněno v přehledu Cloud Spanner, jeho indexy se mohou lišit od indexů MySQL. Proto je nutné být obzvlášť opatrný při vytváření dotazů a profilování, aby bylo zajištěno, že se používá správný index tam, kde je potřeba.
Zobrazení?
Velmi populární a užitečný objekt v databázi — zobrazení. Mohou být užitečná pro mnoho uživatelských případů; dva mé oblíbené jsou úroveň logické abstrakce a úroveň bezpečnosti. Bohužel Cloud Spanner NEpodporuje zobrazení. To však pouze částečně omezují, protože pro oprávnění přístupu není detailnost na úrovni sloupců, kde zobrazení mohou být přijatelným řešením.
V dokumentaci Cloud Spanner v části, kde jsou podrobně popsány kvóty a omezení (), existuje jedna, která může být problematická pro některé aplikace: Cloud Spanner má standardně omezení na maximálně 100 databází na instanci. To se může stát vážnou překážkou pro databázi, která je určena k rozšíření na více než 100 databází. Naštěstí, po rozhovoru s naším technickým zástupcem Google jsme zjistili, že tento limit může být prakticky zvýšen na libovolnou hodnotu prostřednictvím Google podpory.
Podpora vývoje?
Cloud Spanner nabízí poměrně dobrou podporu programovacích jazyků pro práci s jeho API. Oficiálně podporované knihovny jsou v oblastech C#, Go, Java, node.js, PHP, Python a Ruby. Dokumentace je dostatečně podrobná, ale stejně jako u jiných pokročilých technologií je komunita poměrně malá ve srovnání s nejpopulárnějšími technologiemi databází, což může vést k delší době potřebné k řešení méně běžných případů použití nebo problémů.
Jak je to tedy s podporou místního vývoje?
Nenašli jsme způsob, jak vytvořit instanci Cloud Spanner v místním prostředí. Nejblíže, co máme, je Docker obraz , což v principu vypadá podobně, ale v praxi se značně liší. Například CockroachDB může používat PostgreSQL JDBC. Protože vývojové prostředí by mělo být co nejblíže produkčnímu prostředí, Cloud Spanner není ideální, jelikož se musíme spoléhat na plnou instanci Spanner. Pro úsporu nákladů můžete zvolit instanci pro jedno region.
Podpora administrace?
Vytvoření instance Cloud Spanner je velmi jednoduché. Stačí si vybrat mezi vytvořením multiregionální nebo instancí pro jedno region, určit region(y) a počet uzlů. Za méně než minutu bude instance spuštěna a připravena k použití.
Několik základních metrik je přímo dostupných na stránce Spanner v konzoli Google. Podrobnější pohledy jsou k dispozici prostřednictvím Stackdriveru, kde můžete také nastavit prahové hodnoty metrik a politiky upozornění.
Přístup k prostředkům?
MySQL nabízí rozsáhlá a velmi podrobná nastavení oprávnění/rolí uživatelů. Lze snadno nastavit přístup k určité tabulce nebo dokonce pouze k podmnožině jejích sloupců. Cloud Spanner používá nástroj Google Identity & Access Management (IAM), který umožňuje nastavovat politiky a oprávnění pouze na velmi vysoké úrovni. Nejpodrobnější možností je oprávnění na úrovni databáze, které se většině výrobních případů nehodí. Toto omezení vás nutí přidávat další bezpečnostní opatření do vašeho kódu, infrastruktury nebo obojího, abyste předešli neoprávněnému použití prostředků Spanner.
Zálohy?
Jednoduše řečeno, zálohy v Cloud Spanner neexistují. Ačkoli vysoké požadavky Google SLA mohou zaručit, že neztratíte žádná data kvůli poruchám hardwaru nebo databáze, lidem způsobeným chybám, nedostatkům aplikací atd. Všichni víme pravidlo: vysoká dostupnost nenahrazuje rozumnou strategii zálohování. Momentálně je jediným způsobem zálohování dat programový stream, který je přenáší z databáze do samostatného úložiště.
Výkon dotazů?
Pro načítání dat a testování dotazů jsme použili Yahoo! Cloud Serving Benchmark. V tabulce níže je pracovní zátěž B YCSB s poměrem čtení 95 % a zápisu 5 %.
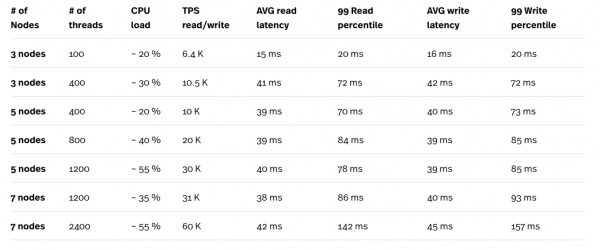
* Zátěžový test byl proveden na výpočetním enginu (CE) n1-standard-32 (32 vCPU, 120 GB paměti), a testovací instance nikdy nebyla úzkým místem v testech.
** Maximální počet vláken v jednom instance YCSB je 400. Celkem bylo potřeba spustit šest paralelních instancí YCSB testů, aby se dosáhlo celkového počtu 2400 vláken.
Při pohledu na výsledky testů, konkrétně kombinaci zatížení procesoru a TPS, jasně vidíme, že Cloud Spanner se dobře škáluje. Vysoké zatížení způsobené velkým počtem vláken je vyváženo větším počtem uzlů v cloudu Spanner. Ačkoli zpoždění vypadá docela vysoké, zejména při práci s 2400 vlákny, pro přesnější čísla by mohlo být nutné zopakovat testy s 6 menšími instancemi výpočetního enginu. Každá instance bude spouštět jeden test YCSB místo jedné velké instance CE se 6 paralelními testy. Takto bude snazší rozlišit zpoždění požadavků Cloud Spanner a zpoždění, která přidává síťové připojení mezi Cloud Spanner a instancí CE, na které se test provádí.
Jak si Cloud Spanner vede jako OLAP?
Particionace?
Rozdělení dat na fyzicky a/nebo logicky nezávislé segmenty, nazývané partitiony, je velmi populární koncept, který se vyskytuje ve většině OLAP mechanismů. Partitiony mohou významně zlepšit výkon dotazů a údržbu databáze. Podrobnější prozkoumání partition může odhalit další články, takže si pouze zmíníme důležitost existence schématu partitionace a sub-partitionace. Možnost dělit data na partitiony a dokonce dále na sub-partitiony je klíčem k výkonnosti analytických dotazů.
Cloud Spanner nepodporuje partitiony jako takové. Rozděluje data uvnitř na tzv. split-y na základě rozsahů primárního klíče. Rozdělení se provádí automaticky pro vyvážení zatížení v clusteru Cloud Spanner. Velmi užitečná funkce Cloud Spanner je rozdělení základního zatížení rodičovské tabulky (tabulky, která se nečlení s jinou). Spanner automaticky určuje, zda split data, která se čtou častěji, než data v jiných split-ách, a může se rozhodnout o dalším rozdělení. Takto může být zapojeno více uzlů do dotazu, což také efektivně zvyšuje propustnost.
Nahrávání dat?
Způsob Cloud Spanner pro velká data je stejný jako při běžném načítání. Pro maximální výkon je třeba dodržovat některé doporučení, včetně:
- Tříděte svá data podle primárního klíče.
- Rozdělte je na 10*počet uzlů samostatných sekcí.
- Vytvořte sadu pracovních úloh, které načítají data paralelně.
Při takovém načítání dat se využívají všechny uzly Cloud Spanner.
Použili jsme pracovní zátěž A YCSB k vygenerování sady dat o 10M řádcích.
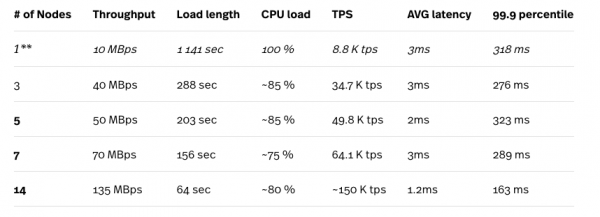
* Zátěžový test byl proveden na výpočetním stroji n1-standard-32 (32 vCPU, 120 GB paměti) a testovaný instance nikdy nebyla úzkým místem v testech.
** Nastavení s 1 uzlem se nedoporučuje pro jakoukoli produkční zátěž.
Jak bylo zmíněno výše, Cloud Spanner automaticky zpracovává split-y podle jejich zátěže, takže výsledky se zlepšují po několika po sobě jdoucích opakováních testu. Výsledky, které jsou zde uvedeny, jsou nejlepší výsledky, které jsme získali. Při pohledu na čísla výše vidíme, jak Cloud Spanner (dobře) škáluje s rostoucím počtem uzlů v clusteru. Čísla, která vynikají, představují extrémně nízké průměrné latence, které kontrastují s výsledky smíšených pracovních zátěží (95 % pro čtení a 5 % pro zápis), jak je popsáno v části výše.
Škálování?
Zvětšení a zmenšení počtu uzlů Cloud Spanner se provádí jedním kliknutím. Pokud chcete rychle načíst data, můžete zvážit zvýšení instance na maximum (v našem případě to bylo 25 uzlů v regionu US-EAST), a poté snížit počet uzlů, které odpovídají vaší běžné zátěži, poté, co se všechna data dostanou do databáze, s ohledem na limit 2 TB/uzel.
Bylo nám připomenuto tento limit i s mnohem menší databází. Po několika průchodech zátěžovými testy měla naše databáze velikost přibližně 155 GB, a při zmenšování na instanci s 1 uzlem jsme obdrželi následující chybu:
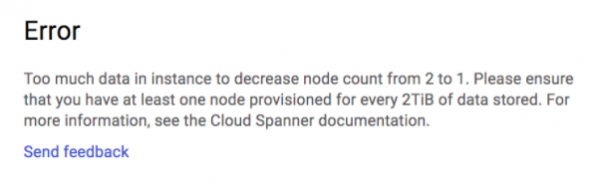
Podařilo se nám zmenšit z 25 na 2 instance, ale zasekli jsme se na dvou uzlech.
Zvýšení a snížení počtu uzlů v clusterech Cloud Spanner lze automatizovat pomocí REST API. To může být obzvlášť užitečné pro snížení zvýšeného zatížení systému během špičky.
Výkon OLAP dotazů?
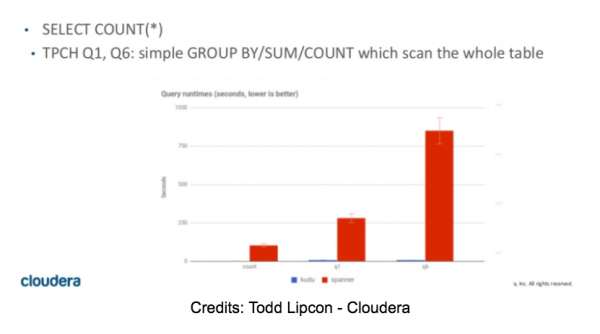
Původně jsme plánovali věnovat značný čas našemu hodnocení Spanneru této části. Po několika SELECT COUNT jsme si hned uvědomili, že testování bude krátké a že Spanner NENÍ vhodný jako OLAP motor. Bez ohledu na počet uzlů v clusterech trval jednoduchý výběr počtu řádků v tabulce o 10M řádcích od 55 do 60 sekund. Navíc jakýkoli dotaz, který vyžadoval větší objem paměti pro uchování mezivýsledků, skončil chybou OOM.
SELECT COUNT(DISTINCT(field0)) FROM usertable; — (10M distinct values)-> SpoolingHashAggregateIterator došel paměti během nové řady.
Některá čísla pro TPC-H dotazy lze nalézt v článku Todda Lipkona , slidy 42 a 43. Tato čísla souhlasí s našimi vlastním výsledky (bohužel).
4. Naše závěry
Vzhledem k současnému stavu funkcí Cloud Spanner je obtížné si představit jeho jednoduchou náhradu za stávající OLTP řešení, zejména když vaše potřeby překročí jeho možnosti. Bylo by třeba strávit značné množství času vývojem řešení, které by zohlednilo nedostatky Cloud Spanneru.
Když jsme začali hodnotit Cloud Spanner, očekávali jsme, že jeho správcovské funkce budou na úrovni nebo alespoň ne tak daleko od jiných řešení Google SQL. Ale byli jsme překvapeni naprostým nedostatkem záloh a velmi omezenou kontrolou přístupu k prostředkům. Nemluvě o absenci pohledů, absenci lokálního vývojového prostředí, nepodporovaných sekvencích, JDBC bez podpory DML a DDL a tak dále.
Kam se tedy obrátit, pokud potřebujete škálovat transakční databázi? Vypadá to, že na trhu zatím neexistuje jediné řešení, které by vyhovovalo všem případům použití. Existuje celá řada řešení s otevřeným a uzavřeným zdrojovým kódem (některé z nich jsou zmíněny v tomto článku), každé z nich má své silné a slabé stránky, ale žádné z nich nenabízí SaaS s SLA 99,999 % a vysokou mírou konzistence. Pokud je vysoká úroveň SLA vaší hlavní prioritou a nechcete vytvářet vlastní řešení pro více cloudových prostředí, Cloud Spanner by mohl být tím řešením, které hledáte. Měli byste si však být vědomi všech jeho omezení.
Spravedlnosti je třeba říci, že Cloud Spanner byl uveden do veřejného použití teprve na jaře 2017, takže má smysl očekávat, že některé jeho současné nedostatky by mohly nakonec zmizet (doufejme), a když se tak stane, může to vše změnit. Nakonec, Cloud Spanner není jen vedlejším projektem pro Google. Google ho používá jako základ pro další produkty Google. A když Google nedávno nahradil Megastore v Google Cloud Storage Cloud Spanner, umožnilo to Google Cloud Storage stát se striktně konzistentním pro seznamy objektů na celosvětové úrovni (což se stále netýká ).
Takže naděje stále existuje… doufáme.
A to je vše. Stejně jako autor článku, i my stále doufáme, co si o tom myslíte? Napište nám do komentářů
Všechny zájemce zveme k návštěvě našeho v rámci kterého podrobně předvedeme kurz od OTUS.
Zdroj: habr.com
