

Nápady a setkání o tom, jaké další procesy lze automatizovat, se v podnikání různé velikosti objevují každý den. Kromě toho, že vytváření modelu může zabrat spoustu času, je také důležité věnovat čas jeho hodnocení a kontrole, aby se zajistilo, že získaný výsledek není náhodný. Po implementaci je třeba jakýkoliv model nastavit na monitoring a pravidelně kontrolovat.
A to jsou všechny etapy, kterými je třeba projít v každé společnosti, bez ohledu na její velikost. Pokud hovoříme o měřítku a legacy Sberbanky, počet jemných nastavení se několikanásobně zvyšuje. Na konci roku 2019 bylo v Sberu již více než 2000 modelů. Není dostatečné pouze vyvinout model; je nutné integrovat se s průmyslovými systémy, vyvinout datové vitráže pro stavbu modelů a zajistit kontrolu jeho činnosti na clusteru.
Náš tým vyvíjí platformu Sber.DS. Ta umožňuje řešit úkoly strojového učení, zrychluje proces ověřování hypotéz, v podstatě zjednodušuje proces vývoje a validace modelů a také kontroluje výsledek práce modelu v PROM.
Abychom nepodváděli vaše očekávání, chci předem říci, že tento příspěvek je úvodní, a pod kapotou bude na začátek řečeno to, co vlastně skrývá platforma Sber.DS. Příběh o životním cyklu modelu od vytvoření po implementaci budeme vyprávět samostatně.
Sber.DS se skládá z několika komponentů, přičemž klíčovými jsou knihovna, systém vývoje a systém provádění modelů.
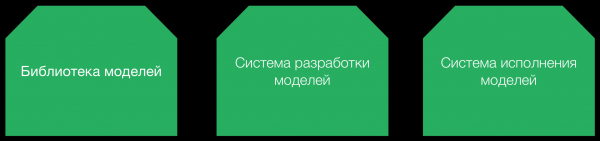
Knihovna kontroluje životní cyklus modelu od chvíle, kdy se objeví myšlenka na jeho vývoj, až po implementaci do PROM, nastavení na monitoring a vyřazení z provozu. Mnohé funkce knihovny jsou diktovány pravidly regulátora, například reporting a uchovávání tréninkových a validačních vzorků. V podstatě se jedná o registr všech našich modelů.
Systém vývoje je určen pro vizuální vývoj modelů a validačních metodik. Vytvořené modely procházejí prvotní validací a jsou dodávány do výkonného systému k plnění svých obchodních funkcí. V tomto výkonném systému může být model umístěn na monitor za účelem periodického spuštění validačních metodik pro kontrolu jeho práce.
V systému existuje několik typů uzlů. Některé jsou určeny k připojení k různým zdrojům dat, jiné slouží k transformaci původních dat a jejich obohacení (označování). Existuje mnoho uzlů pro tvorbu různých modelů a uzlů pro jejich validaci. Vývojář může načítat data z jakýchkoli zdrojů, transformovat je, filtrovat, vizualizovat mezidatové výsledky a dělit je na části.
Platforma také obsahuje již připravené moduly, které lze přetahovat na pracovní plochu projektu. Veškeré akce se provádějí pomocí vizualizovaného rozhraní. V podstatě lze problém řešit bez jediné řádky kódu.
Pokud vestavěné možnosti nestačí, systém poskytuje možnost rychlého vytvoření vlastních modulů. Zavedli jsme režim integrovaného vývoje na základě pro ty, kdo vytvářejí nové moduly "od nuly.
Architektura Sber.DS je postavena na mikroservisách. Existuje mnoho názorů na to, co jsou mikroservisy. Někteří si myslí, že stačí rozdělit monolitický kód na části, ale přitom stále mají všechny části přístup k jedné a téže databázi. U nás by mikroservis měl komunikovat s jiným mikroservisem pouze prostřednictvím REST API. Žádné obcházení přístupu k databázi přímo.
Snažíme se, aby služby nebyly příliš velké a neohyzdily se: jeden exemplář by neměl spotřebovávat více než 4-8 gigabajtů operační paměti a měl by poskytovat možnosti horizontálního škálování požadavků spuštěním nových exemplářů. Každá služba komunikuje s ostatními pouze prostřednictvím REST API (). Tým odpovědný za službu je povinen zachovávat zpětnou kompatibilitu API k poslednímu klientovi, který ji používá.
Jádro aplikace je napsáno v Javě s využitím Spring Frameworku. Řešení bylo původně navrženo pro rychlé nasazení v cloudové infrastruktuře, proto je aplikace postavena na systému kontejnerizace. (). Platforma se neustále vyvíjí, jak z hlediska rozšiřování obchodní funkčnosti (přidávají se nové konektory, AutoML), tak i z pohledu technologické efektivity.
Jedním z atributů naší platformy je, že můžeme spouštět kód vyvinutý ve vizuálním rozhraní na jakékoli výkonnostní platformě Sberbank. Aktuálně jich je již několik: jedna na Hadoopu, druhá — na OpenShiftu (Docker). Na tom však nezastavujeme a vytváříme integrační moduly pro spuštění kódu na jakékoli infrastruktuře, včetně on-premise i v cloudu. Co se týče možností efektivního zapojení do ekosystému Sberbank, plánujeme také podpořit práci s existujícími výkonnostními prostředími. V budoucnu by řešení mělo být flexibilně integrováno „z krabice“ do jakéhokoli prostředí jakékoli organizace.
Ti, kdo se někdy pokoušeli podporovat řešení, které spouští Python na Hadoopu v PROMu, vědí, že nestačí pouze připravit a dodat uživatelské prostředí Pythonu na každý datový uzel. Obrovské množství C/C++ knihoven pro strojové učení, které používají Python moduly, vám nedovolí klidně spát. Musíte nezapomínat na aktualizaci balíčků při přidávání nových knihoven nebo serverů, přičemž zachováváte zpětnou kompatibilitu s již implementovaným kódem modelů.
Existuje několik přístupů k tomu, jak to udělat. Například předem připravit několik často používaných knihoven a implementovat je do PROMu. V distribuci Hadoop od Cloudera se k tomu obvykle používá . Také se v Hadoopu objevila možnost spouštění -kontejnerů. V některých jednoduchých případech je možné dodat kód spolu s balíčkem .
Banka velmi vážně přistupuje k bezpečnosti spuštění cizího kódu, proto maximálně využíváme nové možnosti jádra Linuxu, kde proces, spuštěný v izolačním prostředí, , můžete například omezit přístup k síti a místnímu disku, což výrazně snižuje možnosti škodlivého kódu. Údaje každého oddělení jsou chráněny a přístup k nim mají pouze jejich vlastníci. Platforma zaručuje, že data z jedné oblasti mohou být přenesena do druhé oblasti pouze prostřednictvím procesu publikace dat s kontrolou na všech krocích, od přístupu k zdrojům až po umístění dat do cílového skladu.
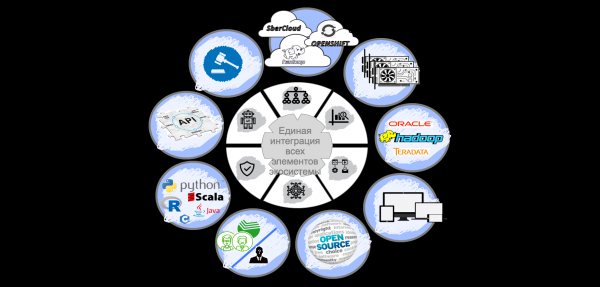
V tomto roce plánujeme dokončit MVP spuštění modelů napsaných v Pythonu/R/Java na Hadoopu. Stanovili jsme si ambiciózní cíl naučit se spouštět jakékoliv uživatelské prostředí na Hadoopu, abychom nijak neomezovali uživatele naší platformy.
Kromě toho, jak se ukázalo, mnoho specialistů na datové vědy má vynikající znalosti matematiky a statistiky, vytváří skvělé modely, ale příliš dobře se neorientují v transformacích velkých dat a potřebují pomoc našich datových inženýrů při přípravě tréninkových datových sad. Rozhodli jsme se pomoci kolegům a vytvořit pohodlné moduly pro typickou transformaci a přípravu rysů pro modely na Spark engine. To umožní více času věnovat vývoji modelů a nečekat, až datoví inženýři připraví novou datovou sadu.
Máme zaměstnance se znalostmi v různých oblastech: Linux a DevOps, Hadoop a Spark, Java a Spring, Scala a Akka, OpenShift a Kubernetes. Příště vám povíme o knihovně modelů, o tom, jak model prochází životním cyklem uvnitř společnosti, jak probíhá validace a zavedení.
Zdroj: habr.com
