

I když sama řešení PaaS („Platforma jako služba“) nemohou změnit způsoby individuální a týmové interakce, často slouží jako katalyzátor organizačních změn v reakci na zvýšenou flexibilitu IT technologií.
Ve skutečnosti je maximální návratnost investic do PaaS často možná pouze za podmínky změny organizačních rolí, oblastí odpovědnosti (úkolů) a vztahových schémat. Naštěstí řešení PaaS, jako je OpenShift Container Platform, mají dostatečnou flexibilitu, aby si každá IT organizace mohla autonomně stanovit tempo a rozsah změn týkajících se zúčastněných osob a probíhajících procesů.
Ve fázi containerizace podniků je hlavním prioritním úkolem zavedení platformy pro kontejnery jako nového systému nasazení aplikací. V tuto chvíli organizace spojují obvyklé práce s obvyklými rolemi, aby reagovaly na standardní požadavky vývojových týmů v oblastech, jako jsou úložné systémy, nasazovací prostředí atd. V dalších fázích containerizace se již jedná o automatizaci nebo poskytování možností samoobsluhy vývojářům, aby se snížily zátěže na systémové administrátory a zvýšila se autonomie a pružnost vývojářů na vyšší úroveň. Tímto způsobem se organizace začíná posouvat směrem k DevOps. V závěrečné fázi containerizace podnik dosahuje čistší, kanonické modely DevOps, v rámci kterého mnohé z dřívějších úkolů a prací přecházejí pod kontrolu křížových týmů, které se seskupují ne podle platforem nebo technologií, ale z pohledu zajištění fungování aplikací nebo aplikačních služeb.
V tomto příspěvku se zaměříme na průvodce potřebnými organizačními změnami a jak se mění tradiční IT role při zavádění technologií kontejnerů v podniku.
Spojení nových prací se starými rolemi
Ve své základní, počáteční formě se organizační model PaaS vytváří za účelem pružnějšího a rychlejšího přidělování IT zdrojů aplikacím jako prostředí pro běh. Ačkoli to přináší určité výhody správcům systémů, vývojáři zde obvykle nezískávají žádné významné přínosy nebo nové možnosti, protože v této fázi může podnik bez zahájení automatizace, zavádění samoobsluhy nebo radikálního zlepšení procesu nasazení dobře fungovat. I když PaaS minimálně zasahuje do procesů vývoje v této fázi, přesto zvyšuje dynamiku IT systému, což umožňuje správcům lépe obsluhovat požadavky vývojářů. Například pokud dříve trvalo vytváření vývojového prostředí z několika virtuálních strojů a úložných svazků dny, ba i týdny, přičemž byla zapotřebí účast několika různých správců, nyní se v PaaS vše provádí mnohem rychleji a pouze jedním správcem. Jinými slovy, vývojářské týmy podávají žádosti jako dříve, ale práce na realizaci těchto žádostí se nyní provádějí podle nového schématu.
Na cestě k organizaci DevOps
Spuštěním PaaS a převedením na ni specialistů na provoz IT systémů a vývojářů aplikací může organizace pokračovat ve zavádění metodologie DevOps, která zahrnuje mimo jiné následující základní principy:
- Rozdělit práci na malé fáze, aby bylo možné získat zpětnou vazbu v raných fázích, snižovat rizika a vyhýbat se "analytickému paralýze";
- Automatizovat operace v dostatečné míře, aby se nevytvářely překážky nebo úzká místa v procesu nasazení aplikace;
- Sdílení znalostí je klíčem k vybudování důvěry;
- Pravidelně splácet technické dluhy, vyčleněním v každém pracovním cyklu určitého času na systematická zlepšení.
Ve druhé fázi implementace kontejnerových technologií týmy vývoje samozřejmě začínají vidět příležitosti pro zlepšení a podnik se přiklání k více kanonickému modelu DevOps. Tradiční mechanismus podávání a provádění požadavků na údržbu je nyní vnímán jako úzké místo, a proto se organizace snaží automatizovat opakované úkony a poskytnout vývojářům možnosti samoobsluhy. Tyto možnosti vývojářů v rámci daného požadavku jsou určovány společnými úsilími IT specialistů pro provoz platformy a těmi, kdo odpovídají za dodávku aplikací. Jinými slovy, na místo systémových administrátorů, kteří vykonávali akce na základě požadavků vývojářů, přicházejí dvě uvedené kategorie zaměstnanců, které odpovídají za popis a aplikaci politik, které upravují, co vývojářům je povoleno dělat vlastními silami. Automatizované procesy pomáhají zajistit dodržování těchto požadavků a sladit akce v případech, kdy situace vychází za rámec stávajících politik.
Přechod na iterativní harmonogram, v němž IT prostředí a provozní model podléhá iterativním změnám v průběhu času, je kriticky důležitým milníkem v rámci formování zralého systému DevOps v podniku. Míra přijetí metodologie DevOps závisí na toleranci každé konkrétní organizace k změnám a na tom, jaké změny přinášejí největší prospěch. Například pokud potřeba vytvářet nové prostředí nebo aplikace vzniká zřídka, pak optimalizace odpovídajících akcí bude méně důležitá než zvýšení kontroly vývojářů nad životním cyklem aplikací.
Nové úkoly, které se objevují v IT organizacích při přechodu na OpenShift
V této kapitole se zaměříme na role a úkoly, které organizace přecházející na OpenShift obvykle aplikují pro urychlení automatizace a samoobsluhy pomocí technologií a PaaS.
V níže uvedené tabulce jsou uvedeny hlavní úkoly na vysoké úrovni, které existují v každé organizaci, jež implementovala OpenShift, s příklady příslušných prací a dovedností. Tento seznam úkolů není třeba zaměňovat s pracovním rozdělením nebo s organizační strukturou týmů; jedná se pouze o soubor úkolů, které musí být splněny osobami odpovědnými za podporu IT prostředí pro úspěšnou implementaci kontejnerové platformy. Skutečně ukážeme, že zavedení kontejnerových technologií vytváří předpoklady pro rozvoj zralejší strategie DevOps ve společnosti, což na druhé straně zvyšuje míru krosfunkcionality týmů a snižuje rizika úzké specializace jak na úrovni jednotlivců, tak týmů.
Tabulka 1. Definice úkolů OpenShift
Úkoly
Požadované dovednosti
Automatizace a příprava (provisioning) IT infrastruktury
Práce:
- Návrh a stavba hardwarových řešení
- Organizace a podpora automatizace počátečního nastavení
- Návrh a automatizace přípravy VM a hostitelů
- Návrh a realizace datových center
- Systémová administrace Linuxu
- Automatizační skripty
- Znalost systémů skladování
- Znalost v oblasti návrhu a realizace sítí
- Bezpečnost
Instalace a správa platformy OpenShift
Práce:
- Provádění instalace clusteru
- Správa infrastrukturních služeb
- Správa škálování platformy
- Ověření a autorizace na úrovni platformy
- Systémová administrace Linuxu
- Znalost síťových technologií
- Automatizační skripty (Ansible)
- Znalost systémů skladování
- Znalost kontejnerových technologií a architektur
- Znalost architektur Kubernetes a OpenShift
- Bezpečnost platforem
- Integrace monitorování
Správa přípravy klientských prostředí (tenant provisioning), izolace IT kapacit
Práce:
- Vytváření uživatelů a týmů v rámci platformy
- Návrh a správa kvót
- Návrh a realizace RBAC
- Znalost architektur Kubernetes a OpenShift
- Znalost kontejnerových technologií a architektur
- Automatizační skripty
- Dobré znalosti v oblasti projektů, kvót, vazby rolí a práce s plánovači
Sestavení a správa základních obrazů
Práce:
- Vývoj pracovního postupu změny obrazů
- Vývoj obrazů na základě standardů
- Systémová administrace Linuxu
- Automatizační skripty
- Konfigurace runtime komponent aplikací a middleware
- Znalost kontejnerových architektur
- Rámce pro sestavování aplikací (application build frameworks)
- Dobré znalosti v oblasti obrazů, imagestream a šablon
Návrh a správa nasazovacích pipeline
Práce:
- Návrh a dokumentace standardů pipeline
- Vytváření stručných příruček a šablon
- Školení vývojářů
- Správa zdrojového kódu
- Návrh a implementace aplikací
- Automatizační skripty
- Automatizované testování
- Testování kvality kódu
- Znalost kontejnerových architektur
- Znalost immutable infrastruktury
- Bezpečnost – správa přístupu k fázím pipeline, schvalování pracovních postupů atd.
- Dobrá znalost šablon OpenShift, komponent buildconfigs, deploymentconfigs, services, routes, configmaps
Vývoj aplikací a testů
Práce:
- Kódování aplikací
- Vývoj automatizovaných testů
- Reakce na selhání testů během nasazovací pipeline
- Reakce na selhání aplikací
- Uživatelské akceptační testování
- Návrh a implementace aplikací
- Automatizované testování
- Správa zdrojového kódu
- Monitorování aplikací
- Znalost architektur cloudových (cloud native) aplikací
Operační monitorování a správa aplikací
Práce:
- Návrh aplikací v kontextu výkonu
- Monitorování aplikací ve fázi běhu
- Škálování aplikací (nebo automatické škálování)
- Správa dostupnosti aplikací
- Kvóty na požadavky a limity pro správu zdrojů
- Testování výkonu a IT kapacit
- Návrh a implementace výkonu aplikací
- Monitorování výkonu aplikací
- Testování výkonu a zátěžové testování
Uživatelské akceptační testování
Práce:
- Testování UI (design a interakce s uživateli)
- Vývoj automatizovaných testů
- Návrh a ověřování uživatelských rozhraní
- Šablony automatizovaného testování
- Testovací frameworky
- Šablony návrhu aplikací
Nové role, které vznikají v IT organizaci při přechodu na OpenShift
Jakmile organizace přechází na model zaměřený na DevOps, počet specializovaných rolí obvykle klesá, zatímco počet cross-funkčních týmů a rolí roste s cílem maximalizovat efektivitu spolupráce. Zde je náš pohled na seznam hlavních pozic v IT organizaci, která používá OpenShift:
- Inženýr provozu aplikací (Application Operations Engineer) NEBO Inženýr spolehlivosti webu (Site Reliability Engineer). Dříve tato pozice mohla být nazývána „Administrátor serveru aplikací“.
- Vývojář aplikací / vývojář softwaru / programátor.
- Správce clusteru/aplikační platformy. Dříve se tato role mohla nazývat „Systémový administrátor“ nebo „Administrátor Linuxových platforem.“
- Manažer vydání softwaru (Release Manager)/Inženýr pro sestavení (Build Engineer).
Matice rolí a úkolů RACI
Konečně přecházíme k přiřazení výše uvedených pozic a úkolů, abychom poskytli obecný přehled o tom, jak by měla vypadat struktura organizace, která implementuje DevOps na platformě OpenShift. Původně mohou níže uvedené role vykonávat různé větve staré, tradiční organizační struktury. Ale v průběhu času dochází k konsolidaci a vznikají nové týmy zaměřené na aplikace, které soustředí většinu nebo dokonce všechny zde uvedené úkoly.
Úkoly
Role
Inženýr pro provoz aplikací/Inženýr pro spolehlivost webu
Vývojář aplikací/Vývojář softwaru/Inženýr programátor
Správce clusteru/aplikační platformy
Manažer vydání softwaru/Inženýr pro sestavení
Automatizace a příprava (provisioning) IT infrastruktury
I
I
R/A
C
Instalace a správa platformy OpenShift
C
I
R/A
C
Návrh a správa nasazovacích pipeline
C
C
I
R/A
Správa přípravy zákaznických prostředí (tenant provisioning), izolace a IT zdrojů
C
I
R/A
I
Sestavení a správa základních obrazů
R
C
R/A
C
Vývoj aplikací a testů
C
R/A
I
I
Operační monitorování a správa aplikací
R/A
C
C
I
Uživatelské akceptační testování
C
R
I
I
Značení v matici RACI
Zdroj:
- Responsible – Výkonný – ten, kdo vykonává potřebné úkoly.
- Accountable – Odpovědný – zaměstnanec, který v konečném důsledku nese odpovědnost za správné a pečlivé vykonání úkolu nebo dosažení výsledku; také jediný, kdo může delegovat práci výkonným.
- Consulted – Konzultanti – obvykle jsou to odborníci v dané oblasti, jejichž rady jsou vyžadovány; udržují se s nimi obousměrná komunikace.
- Informed – Informovaní – lidé, kteří jsou informováni o událostech (přičemž někdy pouze po dokončení úkolu nebo dosažení výsledku); získávají informace jednostranně.
Jak probíhá spolupráce týmů v DevOps organizaci
Tradiční schéma získávání zdrojů obvykle představuje cyklus žádostí o přidělení zdrojů, které jsou následně zpracovávány několika týmy. Nakonec jsou všechny požadované zdroje přiděleny a potvrzeny žádající stranou. Často jsou tyto procesy částečně, nebo dokonce zcela prováděny manuálně a vyžadují časté a mnohonásobné interakce mezi týmy pro úspěšné zpracování každé žádosti.
Obrázek 1. Tradiční IT organizace
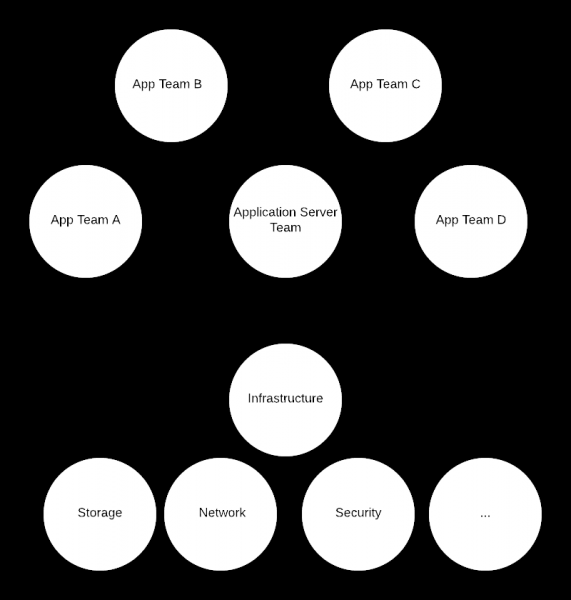
Výše uvedený diagram ilustruje typické vztahy mezi týmy v tradiční IT organizaci. V rámci této struktury se některé týmy obracejí na jiné s žádostí o provedení požadovaných úkolů, přičemž používají více či méně formalizované komunikační prostředky, jako jsou systémy tiketů nebo e-maily. Tyto žádosti poté směřují do fronty a čekají na svou řadu, přičemž dlouhé čekání často vede k zhoršení, ne-li k prohloubení vztahů mezi týmy. Napětí se ještě zvyšuje tím, že členové různých týmů se osobně setkávají jen zřídka a zpravidla si vyměňují pouze minimálně nezbytné informace.
Obrázek 2. IT organizace DevOps
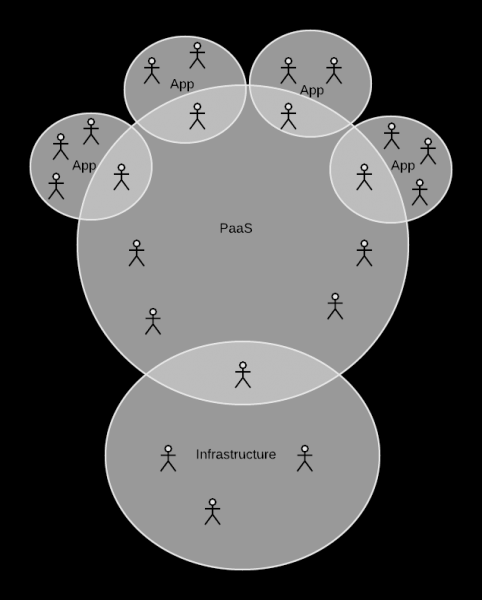
V tomto diagramu je znázorněno, jak vypadá spolupráce v organizaci DevOps. Tytéž týmy z předchozího diagramu se vzdaly neefektivních komunikací, které posilovaly roztříštěnost, a nahradily je osobními kontakty, čímž vytvořily trvalé komunikační kanály mezi týmy. Tyto kanály podporují vytváření hybridní sady dovedností, které zaměstnancům pomáhají lépe rozumět a chápat potřeby, problémy a příležitosti těch týmů, které reprezentují. Týmy si navzájem umožňují provádět nezbytné úkoly prostřednictvím automatizovaných samoobslužných portálů, místo aby manuálně zpracovávaly žádosti o změny, jak tomu bylo dříve. A díky přítomnosti komunikačních kanálů jsou tyto samoobslužné systémy schopny rychle se přizpůsobit potřebám týmů, pro které byly vytvořeny. Pro dosažení ještě většího vzájemného porozumění a výměny znalostí v rámci organizace členové týmů pravidelně provádějí rotaci rolí, aby získali zkušenosti se spoluprací s různými týmy a lépe rozuměli celkovému obrazu IT systémů, které spravují, čímž zvyšují svou úroveň mezioborovosti a užitečnosti.
Shrnutí
V tomto příspěvku jsme popsali, jak implementace řešení PaaS může povzbudit organizaci k zavedení metodologie DevOps, přičemž v rámci tohoto procesu dochází ke změnám v tradičních rolích a úkolech. Proto jsme se zaměřili na hlavní IT úkoly, které se objevují v organizaci při přechodu na OpenShift, a dovednosti potřebné k jejich splnění. Také jsme uvedli základní sadu organizačních rolí, které vznikají při formování křížově funkčních týmů DevOps, a matici RACI, která spojuje nové role s novými úkoly. A nakonec jsme se podívali na to, jak platforma OpenShift a s ní spojená metodologie DevOps mohou změnit organizační strukturu při přechodu od tradiční hierarchie a systémů správy žádostí k křížově funkčním týmům s vyšší úrovní osobní komunikace.
Zdroj: habr.com
