

Jmenuji se Pavel Parkhomenko, jsem vývojář ML. V tomto článku bych se chtěl podělit o strukturu služby Yandex.Zen a sdílet technická vylepšení, jejichž zavedení zvýšilo kvalitu doporučení. Z příspěvku se dozvíte, jak za pouhé milisekundy najít mezi miliony dokumentů ty nejrelevantnější pro uživatele; jak provádět kontinualní rozklad velké matice (s miliony sloupců a desítkami milionů řádků), aby nové dokumenty získaly svůj vektor během desítek minut; jak znovu použít rozklad matice uživatel-článek, abychom získali dobré vektorové reprezentace pro videa.
Naše doporučovací databáze obsahuje miliony dokumentů různých formátů: textové články vytvořené na naší platformě a převzaté z externích webů, videa, narativy a krátké příspěvky. Rozvoj podobné služby je spojen s mnoha technickými výzvami. Zde jsou některé z nich:
- Rozdělit výpočetní úkoly: všechny náročné operace provádět offline, zatímco v reálném čase realizovat pouze rychlé použití modelů, abychom odpovídali za 100-200 ms.
- Rychle zohlednit akce uživatele. K tomu je nutné, aby všechny události okamžitě přicházely do doporučovače a ovlivňovaly výsledky práce modelů.
- Udělat takový feed, aby se u nových uživatelů rychle přizpůsobil jejich chování. Nově příchozí uživatelé by měli cítit, že jejich zpětná vazba ovlivňuje doporučení.
- Rychle rozumět, komu doporučit nový článek.
- Okamžitě reagovat na neustálý příval nového obsahu. Desítky tisíc článků vychází každý den a mnoho z nich má omezenou životnost (řekněme, zprávy). To je odlišuje od filmů, hudby a jiného dlouhodobého a náročného obsahu.
- Přenášet znalosti z jedné domény do druhé. Pokud má doporučovací systém vyškolené modely pro textové články a do něj přidáme videa, můžeme znovu použít existující modely, aby se nový typ obsahu lépe řadil.
Povím vám, jak jsme tyto úkoly řešili.
Výběr kandidátů
Jak během několika milisekund drasticky zkrátit množství posuzovaných dokumentů na tisíce, aniž bychom významně zhoršili kvalitu hodnocení?
Předpokládejme, že jsme vytrénovali mnoho ML modelů, na jejichž základě jsme vytvořili znaky a naučili další model, který hodnotí dokumenty pro uživatele. Všechno by bylo skvělé, ale nelze prostě vzít a spočítat všechny znaky pro všechny dokumenty v reálném čase, pokud těch dokumentů jsou miliony a doporučení je třeba sestavit za 100-200 ms. Úkolem je vybrat z milionů nějaký podmnožinu, která bude hodnocena pro uživatele. Tento krok se obvykle nazývá výběr kandidátů. Na něj jsou kladeny určité požadavky. Zaprvé, výběr by měl probíhat velmi rychle, aby na samotné hodnocení zůstávalo co nejvíce času. Zadruhé, při výrazném snížení počtu dokumentů k hodnocení bychom měli co nejvíce zachovat relevantní dokumenty pro uživatele.
Náš princip výběru kandidátů se postupně vyvíjel a v současné době jsme dospěli k víceúrovňovému schématu:
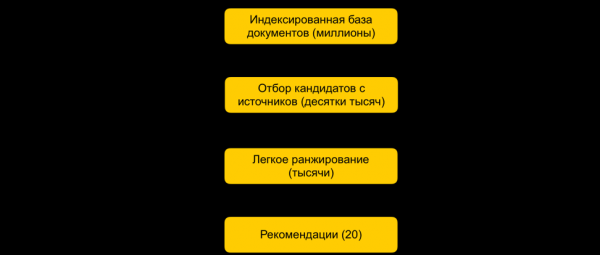
Nejprve jsou všechny dokumenty rozděleny do skupin a z každé skupiny jsou vybrány nejoblíbenější dokumenty. Skupinami mohou být weby, témata, shluky. Pro každého uživatele jsou na základě jeho historie vybírány nejbližší skupiny a z nich se vybírají nejlepší dokumenty. Také používáme kNN index pro výběr nejbližších dokumentů uživateli v reálném čase. Existuje několik metod pro vytváření kNN indexu, u nás nejlépe fungoval (Hierarchical Navigable Small World graphs). To je hierarchický model, který umožňuje za několik milisekund najít N nejbližších vektorů pro uživatele z milionové databáze. Nejdříve offline indexujeme celou naši databázi dokumentů. Vzhledem k tomu, že vyhledávání v indexu funguje poměrně rychle, je při dostupnosti několika silných embedování možné vytvořit několik indexů (jeden index pro každé embedování) a v reálném čase k nim přistupovat.
Pro každého uživatele máme desítky tisíc dokumentů. To je stále hodně na to, abychom spočítali všechny znaky, takže v této fázi aplikujeme lehké hodnocení — zjednodušený model těžkého hodnocení s nižším počtem znaků. Cílem je předpovědět, které dokumenty budou na vrcholu těžkého modelu. Dokumenty s nejvyšším prediktem budou použity v těžkém modelu, tedy v poslední fázi hodnocení. Tento přístup umožňuje v řádu milisekund zúžit databázi dokumentů, které se uživateli zobrazují, z milionů na tisíce.
Krok ALS v reálném čase
Jak zohlednit zpětnou vazbu uživatele okamžitě po kliknutí?
Důležitým faktorem v doporučeních je doba reakce na zpětnou vazbu uživatele. To je obzvlášť důležité pro nové uživatele: když člověk teprve začíná používat doporučovací systém, dostává nepřizpůsobený proud různorodých dokumentů. Jakmile provede první kliknutí, je nezbytné to okamžitě zohlednit a přizpůsobit se jeho zájmům. Pokud se všechny faktory počítají offline, rychlá reakce systému se stane nemožnou kvůli zpoždění. Je tedy nutné zpracovávat uživatelské akce v reálném čase. Pro tyto účely používáme krok ALS v reálném čase pro budování vektoru uživatele.
Předpokládejme, že máme pro všechny dokumenty vektorové zastoupení. Například můžeme offline na základě textu článku vybudovat embeddingy pomocí ELMo, BERT nebo jiných modelů strojového učení. Jak lze získat vektorové zastoupení uživatelů ve stejném prostoru na základě jejich interakcí v systému?
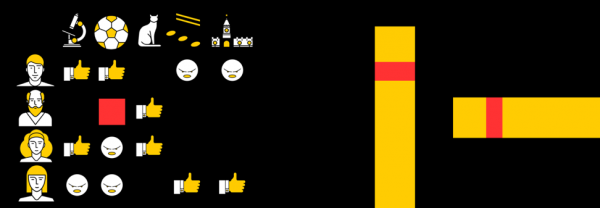
Obecný princip formování a rozkladu matice uživatel-dokumentPředstavme si, že máme m uživatelů a n dokumentů. U některých uživatelů jsou známy jejich preference vůči některým dokumentům. Tyto informace lze poté ztvárnit v podobě matice m x n: řádky odpovídají uživatelům a sloupce dokumentům. Jelikož většina dokumentů nebyla uživateli viděna, většina buněk matice zůstane prázdných, zatímco jiné budou vyplněny. Pro každou událost (like, dislike, kliknutí) v matici je přiřazena nějaká hodnota — avšak zjednodušeně uvažujme model, ve kterém like odpovídá 1 a dislike -1.
Rozložíme matici na dvě: P (m x d) a Q (d x n), kde d je rozměr vektorového zobrazení (obvykle je to malé číslo). Každému objektu tak bude odpovídat d-rozměrný vektor (uživateli — řádek v matici P, dokumentu — sloupec v matici Q). Tyto vektory budou embedddingy příslušných objektů. Abychom předpověděli, zda se uživateli dokument líbí, můžeme jednoduše vynásobit jejich embeddingy.
Jedním z možných způsobů rozložení matice je ALS (Alternating Least Squares). Budeme optimalizovat následující ztrátovou funkci:

Zde rui představuje interakci uživatele u s dokumentem i, qi je vektor dokumentu i, pu je vektor uživatele u.
Takže optimální vektor uživatele podle střední kvadratické chyby (při pevných vektorech dokumentů) lze analyticky nalézt prostřednictvím řešení příslušné lineární regrese.
Tento krok se nazývá „krok ALS“. A samotný algoritmus ALS spočívá v tom, že střídavě fixujeme jednu z matic (uživatelé a články) a aktualizujeme druhou, abychom našli optimální řešení.
Naštěstí nalezení vektorového zobrazení uživatele je poměrně rychlá operace, kterou lze provádět v reálném čase pomocí vektorových instrukcí. Tento trik umožňuje ihned zohlednit zpětnou vazbu uživatele při hodnocení. Takový embedding lze také použít v kNN-indexu pro zlepšení výběru kandidátů.
Distribuovaná kolaborativní filtrace
Jak provádět inkrementální distribuovanou faktorizační matici a rychle nalézt vektorové zobrazení nových článků?
Obsah není jediným zdrojem signálů pro doporučení. Dalším důležitým zdrojem je kolaborativní informace. Dobré známky v hodnocení lze tradičně získat z rozložení matice uživatel-dokument. Ale při pokusu o takové rozložení jsme narazili na problémy:
1. Máme miliony dokumentů a desítky milionů uživatelů. Matice se na jeden stroj celá nevejde a rozložení bude velmi zdlouhavé.
2. Většina obsahu v systému má krátkou životnost: dokumenty zůstávají aktuální jen několik hodin. Proto je nezbytné co nejrychleji vytvořit jejich vektorové zastoupení.
3. Pokud provedeme rozložení hned po publikaci dokumentu, nezíská dostatečné hodnocení od uživatelů. Proto bude jeho vektorové zastoupení s vysokou pravděpodobností méně kvalitní.
4. Pokud uživatel dá palec nahoru nebo dolů, nemůžeme to okamžitě zohlednit v rozložení.
Abychom vyřešili uvedené problémy, implementovali jsme distribuované rozložení matice uživatel-dokument s častými inkrementálními aktualizacemi. Jak to vlastně funguje?
Předpokládejme, že máme klastr N strojů (N se počítá na stovky) a chceme provést distribuované rozložení matice, která se na jeden stroj nevejde. Otázka zní – jak toto rozložení provést tak, aby na každém stroji byly dostatečné údaje a zároveň aby výpočty byly nezávislé?
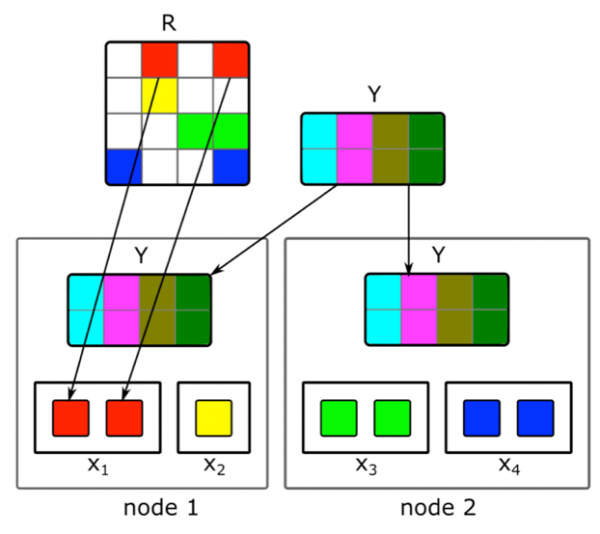
Použijeme výše popsaný algoritmus rozložení ALS. Pojďme se podívat, jak distribuovat jeden krok ALS – ostatní kroky budou podobné. Předpokládejme, že máme fixní matici dokumentů a chceme vytvořit matici uživatelů. K tomu ji rozdělíme na N částí podle řádků, každá část bude obsahovat přibližně stejné množství řádků. Odesíláme na každý stroj neprázdné buňky odpovídajících řádků, stejně jako matici embeddingů dokumentů (celou). Protože její velikost není příliš velká a matice uživatel-dokument je obvykle silně řídká, tato data se vejdou na běžný stroj.
Tento trik lze opakovat po mnoho epoch až do konvergence modelu, přičemž se střídavě mění fixní matice. I tak může rozklad matice trvat několik hodin. A to neřeší problém, že je nutné rychle získávat embeddingy nových dokumentů a aktualizovat embeddingy těch, které měly málo informací při vytváření modelu.
Pomohla nám implementace rychlé inkrementální aktualizace modelu. Předpokládejme, že máme aktuálně naučený model. Od jeho trénování se objevily nové články, se kterými naši uživatelé interagovali, a také články, které měly při trénování málo interakcí. K rychlému získání embeddingu těchto článků používáme embeddingy uživatelů získané během prvního velkého trénování modelu a provádíme jeden krok ALS, abychom vypočítali matici dokumentů při fixní matici uživatelů. To umožňuje získávat embeddingy docela rychle — během několika minut po zveřejnění dokumentu — a často aktualizovat embeddingy nových dokumentů.
Aby byly při doporučení okamžitě zohledněny akce uživatele, v runtime nepoužíváme embeddingy uživatelů získané offline. Místo toho provádíme krok ALS a získáváme aktuální vektor uživatele.
Přenos do jiné doménové oblasti
Jak využít zpětnou vazbu uživatelů k textovým článkům pro vytvoření vektorového reprezentace videa?
Původně jsme doporučovali pouze textové články, takže mnoho našich algoritmů je zaměřeno na tento typ obsahu. Avšak při přidání obsahu jiného typu jsme čelili potřebě přizpůsobit modely. Jak jsme tento úkol řešili na příkladu videa? Jednou z možností je přeškolit všechny modely od nuly. Ale to trvá dlouho, navíc některé algoritmy jsou náročné na objem trénovací sady, kterou v počátečních chvílích existence nového typu obsahu na službě ještě nemáme v potřebném množství.
Zvolili jsme jinou cestu a znovu použili textové modely pro videa. Při vytváření vektorových reprezentací videí nám pomohl stejný trik s ALS. Vzali jsme vektorovou reprezentaci uživatelů na základě textových článků a provedli krok ALS, využívající informace o zhlédnutích videí. Takto jsme bez obtíží získali vektorovou reprezentaci videí. A v runtime prostě vypočítáváme blízkost mezi vektorem uživatele získaným na základě textových článků a vektorem videa.
Závěr
Vývoj jádra reálného systému doporučení je spojen s množstvím úkolů. Je potřeba rychle zpracovávat data a aplikovat metody strojového učení pro efektivní využití těchto dat; budovat složité distribuované systémy, schopné za minimální čas zpracovávat uživatelské signály a nové kusy obsahu; a mnoho dalších úkolů.
V aktuálním systému, jehož strukturu jsem popsal, kvalita doporučení pro uživatele roste spolu s jeho aktivitou a délkou pobytu na službě. Ale samozřejmě, zde se skrývá i hlavní obtíž: systému se těžko hned podaří pochopit zájmy člověka, který málo interagoval s obsahem. Zlepšení doporučení pro nové uživatele je naším klíčovým úkolem. Pokračujeme v optimalizaci algoritmů, aby se relevantní obsah rychleji dostal do jejich feedu a nerelevantní se nezobrazoval.
Zdroj: habr.com
