

Když je tvou prací vytvářet něco krásného, nemusíš o tom příliš mluvit, protože výsledek je vidět pro všechny. Ale pokud odstraňuješ nápisy z plotů, nikdo si tvé práce nevšimne, dokud ploty nevypadají slušně nebo dokud nesmažeš něco nevhodného.
Jakýkoli služba, kde lze zanechat komentář, recenzi, poslat zprávu nebo nahrát obrázky, se dříve či později setká s problémem spamu, podvodů a vulgárních výrazů. Tomu se nelze vyhnout, ale je třeba s tím bojovat.
Jmenuji se Michail, pracuji v týmu Anti-spam, který chrání uživatele služeb Yandexu před podobnými problémy. Naše práce je zřídka vidět (a to je dobře!), proto vám dnes o ní povím více. Zjistíte, v jakých případech je moderování k ničemu a proč přesnost není jediným ukazatelem jeho účinnosti. Také si promluvíme o vulgaritě na příkladu koček a psů a o tom, proč je někdy užitečné "myslet jako vulgární člověk".
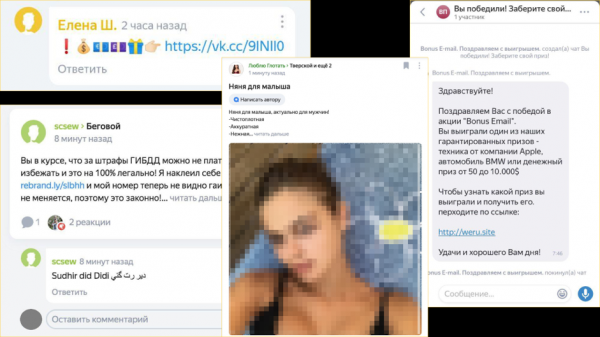
Na Yandexu vzniká stále více služeb, kde uživatelé publikují svůj obsah. Můžete položit otázku nebo napsat odpověď na Yandex.Q, diskutovat o zprávách ve vašem okolí na Yandex.Rajonu nebo sdílet dopravní situaci v rozhovorech na Yandex.Mapách. Ale s růstem publika se služba stává atraktivní pro podvodníky a spammery. Ti přicházejí a zaplňují komentáře: nabízejí snadné výdělky, propagují zázračné prostředky a slibují sociální dávky. Kvůli spammerům jedni uživatelé přicházejí o peníze a jiní ztrácí chuť trávit čas na zanedbané, spamem zarostlé službě.
A to není jediný problém. Snažíme se nejen chránit uživatele před podvodníky, ale také vytvořit pohodlnou atmosféru pro komunikaci. Pokud se lidé v komentářích setkávají s vulgaritami a urážkami, s velkou pravděpodobností odejdou a už se nevrátí. To znamená, že s tímto problémem je také třeba umět bojovat.
Čistý web
Jak to u nás často bývá, první návrhy vznikly v Hledání, v části, která bojuje se spamem ve výsledcích. Ještě před deseti lety se objevila potřeba filtrování obsahu pro dospělé pro rodinné vyhledávání a pro dotazy, které nevyžadují odpovědi z kategorie 18+. Tak se objevily první, ručně sestavené slovníky porna a vulgarit, které analytici doplňovali. Hlavním úkolem byla klasifikace dotazů na ty, kde je přípustné zobrazovat obsah pro dospělé, a kde ne. Na základě toho se shromažďovaly anotace, vytvářely se heuristiky, trénovaly se modely. Tak vznikly první návrhy pro filtrování nežádoucího obsahu.
Postupem času se v Yandexu začal objevovat UGC (uživatelský generovaný obsah) — zprávy, které píší sami uživatelé, a Yandex je pouze zveřejňuje. Z výše uvedených důvodů mnohé zprávy nebylo možné publikovat bez předchozího zhodnocení — vyžadovala se moderace. Tehdy se rozhodlo vytvořit službu, která by nabízela ochranu proti spamu a útočníkům pro všechny UGC produkty Yandexu a využívala by již vyvinuté návrhy pro filtrování nežádoucího obsahu ve vyhledávání. Služba byla pojmenována „Čistý Web“.
Nové úkoly a pomoc tolkařů
Zpočátku u nás fungovala pouze jednoduchá automatizace: služby nám posílaly texty a my jsme na ně aplikovali slovníky vulgarit, slovníky porna a regulární výrazy — analytici všechno sestavovali ručně. Ale služba se postupem času využívala ve stále větším počtu produktů Yandexu a my jsme se museli naučit pracovat s novými problémy.
Často místo recenze uživatelé publikují bezvýznamnou změť písmen, snaží se tak získat ocenění, někdy propagují svou společnost v recenzích konkurentů a jindy prostě pletou organizace a v recenzi o zverimexu napíšou: „Výborně připravená ryba!“. Možná, že jednoho dne se umělá inteligence naučí dokonale zachytit smysl jakéhokoli textu, ale nyní automatika občas selhává hůře než člověk.
Zjistilo se, že bez ručního označování se neobejdeme, a tak jsme k našemu systému přidali druhou úroveň – odesílání k manuální kontrole člověka. Sem se dostávaly ty publikované texty, u kterých klasifikátor neodhalil žádné problémy. Rozsah tohoto úkolu si snadno představíte, a tak jsme se nejen spolehli na hodnotitele, ale také využili „moudrost davu“, tedy jsme se obrátili o pomoc k pracovníkům na dálku. Právě oni nám pomáhají odhalit to, co stroj přehlédl, a tímto způsobem ho také učí.
Inteligentní caching a LSH hashing
Dalším problémem, s kterým jsme se setkali při práci s komentáři, je spam, a přesněji řečeno, jeho objemy a rychlost šíření. Když publikum Yandex.Region začalo rychle růst, přilákalo to spammery. Ti se naučili obcházet regulární výrazy tím, že mírně měnili text. Spam jsme samozřejmě stále nacházeli a odstraňovali, ale v měřítku Yandexu mohlo být nevhodné oznámení, i kdyby bylo zveřejněno jen na 5 minut, viděno stovkami lidí.
To nás samozřejmě neuspokojovalo, a tak jsme vyvinuli inteligentní caching textů na základě LSH (). Funguje to takto: normalizovali jsme text, odstranili odkazy a rozdělili ho na n-gramy (sekvence z n znaků). Poté jsme počítali hashe n-gramů, a podle nich jsme pak vytvářeli LSH vektor dokumentu. Smysl je v tom, že podobné texty, i když byly mírně pozměněny, se měnily na podobné vektory.
Toto řešení umožnilo znovu použít verdikty klasifikátorů a pracovníků na dálku pro podobné texty. Při spamových útocích, jakmile první zpráva prošla kontrolou a dostala se do cache s verdiktem „spam“, všechny nové podobné zprávy, i když byly upraveny, získaly stejný verdikt a byly automaticky odstraněny. Později jsme se naučili vycvičit a automaticky přeškolovat spamové klasifikátory, ale tento „inteligentní cache“ s námi zůstal a dodnes nám často pomáhá.
Klasifikátor kvalitních textů
Než jsme si stačili odpočinout od boje se spamem, uvědomili jsme si, že 95 % obsahu je u nás moderováno ručně: klasifikátory reagují pouze na porušení, zatímco většina textů je kvalitní. Zaměstnáváme pracovníky, kteří v 95 případech ze 100 udělují hodnocení „Všechno OK“. Bylo nutné se vrhnout na neobvyklou práci — vytvářet klasifikátory kvalitního obsahu, naštěstí se během této doby nashromáždilo dostatek anotací.
První klasifikátor vypadal takto: lemmatizujeme text (převádíme slova na jejich základní formu), odstraňujeme veškeré pomocné části řeči a používáme předem připravený „slovník dobrých lem“. Pokud jsou v textu všechna slova „dobrá“, znamená to, že celý text neobsahuje porušení. Na různých službách tento přístup okamžitě přinesl 25 až 35 % automatizace ruční anotace. Samozřejmě, tento přístup není ideální: není těžké zkombinovat několik nevinných slov a vytvořit velmi urážlivé vyjádření, ale umožnilo nám rychle dosáhnout dobré úrovně automatizace a dalo nám čas na školení složitějších modelů.
Následující verze klasifikátorů dobrých textů již zahrnovaly jak lineární modely, tak rozhodovací stromy a jejich kombinace. Pro označování hrubostí a urážek například zkoušíme neuronovou síť BERT. Je důležité zachytit význam slova v kontextu a vztah mezi slovy z různých vět, což BERT dobře zvládá. (Mimochodem, nedávno kolegové z Novinek , jak aplikují technologii na netradiční úkol — hledání chyb v nadpisech.) Výsledkem se podařilo automatizovat až 90 % toku v závislosti na službě.
Přesnost, úplnost a rychlost
Abychom se rozvíjeli, musíme chápat, jaký přínos mají různé automatické klasifikátory, změny v nich, a také zda neklesá kvalita ruční kontroly. K tomu používáme ukazatele přesnosti a úplnosti.
Přesnost je podíl správných verdiktů mezi všemi verdikty o špatném obsahu. Čím vyšší je přesnost, tím méně falešných pozitiv. Pokud se přesnost nezohledňuje, teoreticky je možné odstranit veškerý spam a vulgární slova, a tím i polovinu dobrých příspěvků. Na druhou stranu, pokud se spoléháme pouze na přesnost, nejlepší technologií by byla ta, která nikoho nechytá. Proto je zde další ukazatel: podíl odhaleného špatného obsahu mezi celkovým objemem špatného obsahu. Tyto dvě metriky se vzájemně vyvažují.
Pro měření vzorkujeme celý příchozí tok pro každou službu a předáváme vzorky obsahu posuzovatelům k odbornému hodnocení a srovnání s rozhodnutími stroje.
Ale existuje ještě jeden důležitý ukazatel.
Výše jsem psal, že nevhodnou zprávu mohou během 5 minut vidět stovky lidí. Proto počítáme, kolikrát jsme stihli lidem ukázat špatný obsah, než jsme ho skryli. To je důležité, protože nestačí pracovat kvalitně — je třeba také pracovat rychle. A když jsme budovali ochranu proti vulgaritám, plně jsme si to uvědomili.
Antivulgární opatření na příkladu kočiček a pejsků
Malé lyrické odbočení. Někdo může říci, že vulgarita a urážky nejsou tak nebezpečné jako škodlivé odkazy a nejsou tak rozčilující jako spam. Ale snažíme se udržovat pohodlné podmínky pro komunikaci milionů uživatelů a lidé se nechtějí vracet tam, kde jsou uráženi. Není náhodou, že zákaz vulgarit a urážek je předepsán v pravidlech mnoha komunit, včetně Habra. Ale to jsme trochu odbočili.
Slovníky vulgarit si neporadí se vším bohatstvím ruského jazyka. I když existují jen čtyři základní kořeny vulgarit, lze z nich vytvořit nespočet slov, která žádné regulární výrazy nechytí. Navíc lze část slova psát transkripcí, nahrazuje se písmeny podobnými kombinacemi, přehazuje se písmeny, přidávají se hvězdičky atd. Někdy není bez kontextu vůbec možné určit, co měl uživatel na mysli vulgaritami. Respektujeme pravidla Habra, proto to předvedeme ne na živých příkladech, ale na kočičkách a pejscích.
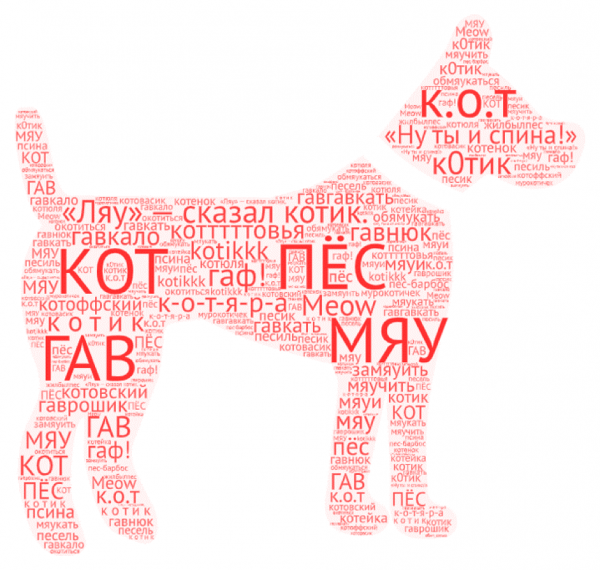
„Mňau,“ řekl kocourek. Ale rozumíme, že kocourek řekl jiné slovo…
Začali jsme uvažovat o algoritmech „neurčitého shody“ našeho slovníku a o inteligentnějším předzpracování: převáděli jsme transliteraci, spojovali mezery a interpunkci, hledali vzory a psali na ně jednotlivé regulární výrazy. Tato metoda přinášela výsledky, ale často snižovala přesnost, nedosahujíc požadované úplnosti.
Pak jsme se rozhodli „myslet jako vulgárníci“. Začali jsme sami přidávat šum do dat: přehazovali jsme písmena, generovali překlepy, nahrazovali písmena podobnými podle napsání a tak dále. Počáteční značkování jsme brali aplikací slovníků vulgarit na velké korpusy textů. Pokud vezmeme jednu větu a pokřivíme ji různými způsoby, získáme už mnoho vět. Takto můžeme zvýšit tréninkovou sadu několikrát. Zbývalo jen vyškolit na získaném vzorku nějaký více či méně inteligentní model, který by bral v úvahu kontext.
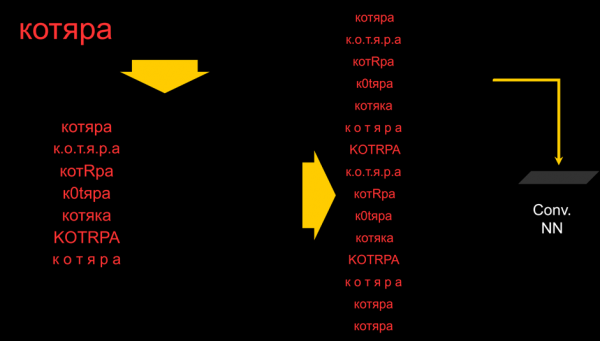
O finálním řešení je zatím předčasné mluvit. Stále experimentujeme s přístupy k tomuto problému, ale už vidíme, že jednoduchá konvoluční síť s několika vrstvami výrazně překonává slovníky a regulární výrazy: podařilo se zvýšit jak přesnost, tak úplnost.
Samozřejmě chápeme, že vždy existují způsoby, jak obejít i tu nejpokročilejší automatizaci, zvláště když jde o tak vzrušující činnost: psát tak, aby to stupidní stroj nepochopil. Tady, jako při boji proti spamu, nemáme za cíl odstranit samotnou možnost napsat něco neslušného, naším úkolem je udělat tak, aby ta hra nestála za to.
Otevřít možnost sdílet svůj názor, komunikovat a komentovat — to není těžké. Daleko složitější je dosáhnout bezpečných, komfortních podmínek a respektu k lidem. A bez toho nebude docházet k rozvoji jakékoli komunity.
Zdroj: habr.com
