

Zdravím, a nejprve trochu lyriky. Občas závidím kolegům, kteří pracují vzdáleně — mít možnost pracovat z jakéhokoliv místa připojeného k internetu, užívat si prázdniny kdykoliv, mít odpovědnost za projekty a termíny, místo abych byl v kanceláři od 8 do 17. Má pozice a pracovní povinnosti prakticky vylučují možnost dlouhého nepřítomnosti v datovém centru. Nicméně se občas objevují zajímavé případy, jako je ten popsaný níže — a chápu, že existuje jen málo pozic, kde je takový prostor pro tvůrčí vyjádření vnitřního troubleshooting specialisty.
Malý disclaimer — v době psaní článku není případ zcela vyřešen, ale vzhledem k rychlosti odpovědi dodavatelů může úplné řešení trvat ještě měsíce, a rád bych se nyní podělil o své poznatky. Doufám, vážení čtenáři, že mi tuto uspěchanost odpustíte. Ale dost bylo řečí — co se děje s případem?
Nejprve úvod: je zde firma (kde pracuji jako síťový inženýr), která hostí klientské řešení v privátním cloudu VMWare. Většina nových řešení se připojuje k VXLAN segmentům, které jsou řízeny NSX-V — nebudu hodnotit, kolik času mi toto řešení ušetřilo, stručně řečeno — hodně. Dokonce jsem se podařilo naučit kolegy konfiguraci NSX ESG a malá klientská řešení se nasazují bez mého zásahu. Důležitá poznámka — náš control plane používá unicast replikaci. Hypervizory jsou redundantně připojené dvěma rozhraními k různým fyzickým switchům Juniper QFX5100 (sestaveným ve Virtual Chassis) a politikou timingu route based on originating virtual port — to pro úplnost obrazu.
Klientská řešení jsou velmi rozmanitá: od Windows IIS, kde jsou všechny komponenty webového serveru nainstalovány na jednom stroji, až po celkem velké řešení — například load-balanced Apache webové fronty + LB MariaDB v Galera + sdílené servery synchronizované pomocí GlusterFS. Prakticky každý server je třeba monitorovat samostatně a veřejné adresy nemají všechny komponenty — pokud jste se s tímto úskalím setkali a máte elegantnější řešení, budu vděčný za radu.
Moje řešení monitorování spočívá v „připojení“ firewallu (Fortigate) k každé interní klientské síti (+SNAT a samozřejmě přísné omezení typu povoleného provozu) a sledování interních adres – tímto způsobem dochází k určité unifikaci a zjednodušení monitorování. Samotné monitorování probíhá z clusteru serverů PRTG. Schéma monitorování vypadá zhruba takto:
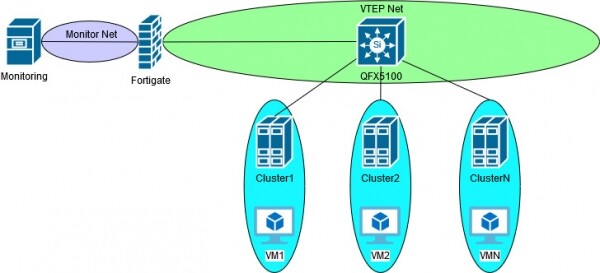
Pokud jsme operovali pouze s VLAN, vše bylo docela obvyklé a předvídatelné, fungovalo to jako hodinky. Po zavedení NSX-V a VXLAN jsme čelili otázce – zda je možné nadále monitorovat starým způsobem? V době této otázky bylo nejrychlejším řešením nasadit NSX ESG a připojit VXLAN trunk-interface do VTEP sítě. Rychlým v uvozovkách – protože použití GUI pro konfiguraci klientských sítí, SNAT a pravidel firewallu může unifikovat správu v jednom rozhraní vSphere, ale podle mého názoru je to docela neohrabané a kromě toho omezuje sadu nástrojů pro odstraňování problémů. Ti, kteří používali NSX ESG jako náhradu za „skutečný“ firewall, si myslím, že souhlasí. Ačkoli, pravděpodobně by takové řešení bylo stabilnější – vždyť se vše odehrává v rámci jednoho dodavatele.
Další řešení je použít NSX DLR v režimu mostu mezi VLAN a VXLAN. Tady je to myslím jasné — prostě se ztrácí výhoda použití VXLAN — protože v tomto případě je stejně nutné pokládat VLAN k monitorovací instalaci. Mimochodem, při práci na tomto řešení jsem narazil na problém, kdy DLR-most neposílal pakety virtuálce, se kterou byl na jednom hostiteli. Vím, vím — v knihách a průvodcích o NSX-V se jasně říká, že pro NSX Edge musí být vyhrazený samostatný cluster, ale to jsou jen knihy... Tak či onak, po několika měsících se zákaznickým supportem jsme problém nevyřešili. V zásadě jsem pochopil logiku fungování — modul jádra hypervizoru, odpovědný za enkapsulaci VXLAN, se nezapojil, pokud DLR a sledovaný server byly na jednom hostiteli, protože provoz neopouští hostitele a logicky by měl být připojen k VXLAN segmentu — enkapsulace není potřeba. Se supportem jsme se zastavili u virtuálního rozhraní vdrPort, které logicky spojuje uplinky a také provádí mostování/enkapsulaci — tam byla zaznamenána nesrovnalost ve vstupním provozu, kterou jsem vzal na zpracování v aktuálním případě. Ale jak bylo řečeno, nedovedl jsem tento případ do konce, protože jsem byl přeřazen na jiný projekt a tato cesta byla od začátku slepá a neměl jsem zvláštní chuť jej rozvíjet. Pokud se nemýlím, problém se pozoroval ve verzích NSX 6.1.4 a 6.2.
A tady — bingo! Fortinet oznamuje nativní . A ne jen point-to-point nebo VXLAN-over-IPSec, ne softwarové mostování VLAN-VXLAN — to vše začali implementovat již od verze 5.4 (a je to prezentováno u jiných ), a skutečná podpora unicast control plane. Při implementaci řešení jsem narazil na další problém – monitorované servery občas „zmizely“ a pak se objevily, přestože samotná virtuální mašina byla v chodu. Příčinou bylo, jak se ukázalo, to, že jsem zapomněl povolit Ping na VXLAN rozhraní. Při procesu rebalancování clusterů se virtuální stroje přesouvaly, a Ping završoval vMotion, aby označil nový ESXi host, na který byla stroj přesunuta. Moje hloupost, ale tento problém znovu podkopal důvěru v podporu výrobce – v tomto případě Fortinet. O tom, že každý případ týkající se VXLAN začíná otázkou „jaké máte v nastavení softswitch VLAN-VXLAN?“ ani nemluvím. Tentokrát mi doporučili změnit MTU – to je pro Ping, který má 32 bajtů. Pak „si pohrá mě“ s tcp-send-mss a tcp-receive-mss v politice – pro VXLAN, který je enkapsulován v UDP. Uf, promiňte – nabralo se to. Takhle jsem problém vyřešil vlastními silami.
Úspěšně otestování testovacího provozu, rozhodli jsme se implementovat toto řešení. A v produkci se ukázalo, že po dni nebo dvou postupně odpadá všechno, co se monitoruje přes VXLAN. Deaktivace/aktivace rozhraní pomohla, ale jen na chvíli. Vzhledem k pomalosti podpory výrobce jsem se začal věnovat troubleshooting své strany – koneckonců moje společnost, moje síť – moje zodpovědnost.
Pod spoilerem běh troubleshootingu. Kdo má dost písmen a chlubení – přeskočte a přejděte k postanalyzování.
Běh troubleshootinguDěkuji, že jste pokračovali ve čtení – pokračujeme!
Takže, monitorování funguje nějakou dobu, pak se samo odpojí. To znamená, že v pravidlech firewallu pravděpodobně nejsou žádné problémy. Nicméně, protože jsem se setkal s problémem visících systémových procesů ve Fortigate verzích 5.6+, takže nejprve se podíváme na „diagnose debug flow“ – očekávaně se provoz povoluje a odchází z rozhraní a očekávaně nic nepřichází zpět. To znamená, že budeme kopat dál po stacku. Budeme bohužel muset skrýt adresy, ať už jsou RFC1918 nebo ne, ale doufám, že proces obohatím dostatečným popisem pro pochopení. Server uvnitř VXLAN má adresu x.x.x.15, rozhraní Fortigate x.x.x.254, všechny ostatní adresy spadají do sítě VTEP.
Pro úspěšný přenos VXLAN inkapsulovaných paketů je třeba mít správné informace v několika tabulkách. Pro overlay to jsou ARP a OVSDB, pro underlay ARP a CAM. V případě Fortigate je VXLAN FDB a OVSDB. Tam začneme:
 fortigate (root) #diag sys vxlan fdb list vxlan-LS
mac=00:50:56:8f:3f:5a state=0x0002 flags=0x00 remote_ip=u.u.u.47 port=4789 vni=5008 ifindex=7
Tady je to docela jednoduché — MAC adresa virtuálního stroje by měla být na VTEP s adresou u.u.u.47. Po prozkoumání obsahu a nastavení ESXI clusteru zjišťuji, že MAC virtuálního stroje je správná, adresa VTEP také. Kontroluji CAM/ARP tabulku na Fortigate — znovu vše odpovídá nastavení ESXI hostitele:
fortigate (root) #get sys arp | grep u.u.u.47
u.u.u.47 0 00:50:56:65:f6:2c dmz
Tabulky jsou správné a provoz jde — může být problém jinde než na Fortigate? Úmyslně jsem přeskočil analýzu směrování provozu na Juniperu — logicky by to měl být další krok při odstraňování problémů, ale síť mám jednoduchou — pouze jeden VLAN pro VTEP a všechny komponenty jsou připojeny přímo. Také si vzpomínám na případ s DLR mostem, VDR a ztrátou provozu — jdu snifferovat na ESXI hostiteli a mezitím zakládám případ už na VMWare. Níže uvedená MAC „97:6e“ patří Fortigate, vmnic1 — to je rozhraní, které má VTEP s adresou u.u.u.47, snifferuji v obou směrech "—dir 2":
pktcap-uw --uplink vmnic1 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
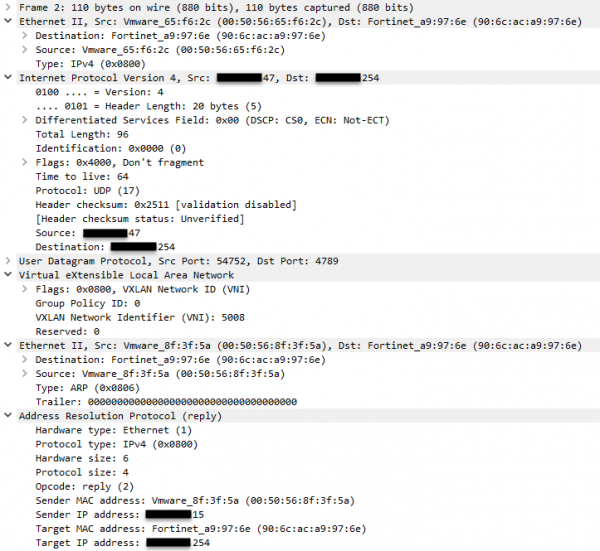
Pokrok — ve sniffu vidím ARP požadavek a přicházející odpověď. Přináším pouze ARP odpověď a vše je správně. Zmínil jsem, že server monitorování po celou dobu pingoval adresu x.x.x.15 — kde je ICMP provoz? Vzpomínám, že mám dvě uplinky. Tady bych mohl diskutovat a říci, že virtuální port zdroje je stejný (má politika spojení), tedy pro stejnou vNIC by měl být vybrán stejný uplink, ale když jsem na hostiteli, zkontrolovat jiný uplink není problém:
pktcap-uw --uplink vmnic4 --vni 5008 --mac 90:6c:ac:a9:97:6e --dir 2 -o /tmp/monitor.pcap
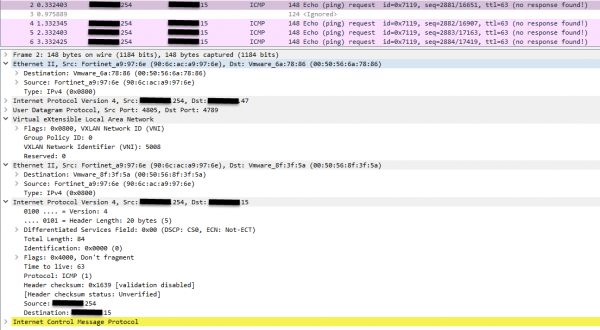
Přicházejí požadavky z FortiGate, ale odpověď nikde. To znamená, že problém není ve FortiGate. No, myslím si, že opět stejný problém s mizícím provozem na VDR, znovu směrovat případ na správné místo po dobu několika měsíců. Po pár dnech, když jsem zchladl a nechtěl se smířit s visením, jsem se rozhodl znovu posbírat sniffy pro support, abych urychlil proces. A tu "náhodou" padl můj pohled na Ethernetovou enkapsulaci underlay. Král není opravdový a MAC adresa VTEP neodpovídá jeho IP. Resetuji na nulu, sniffuji, kopám - je to tak, jak to mělo být. Připojím ARP tabulku vedle, aby bylo snazší srovnávat. Všimněte si první Ethernetové enkapsulace na obrázku nahoře:
fortigate (root) #get sys arp | grep x.x.x.47
x.x.x.47 0 00:50:56:65:f6:2c dmz
fortigate (root) #get sys arp | grep x.x.x.42
x.x.x.42 0 00:50:56:6a:78:86 dmz
Takže co máme na závěr - po migraci virtuálního stroje, FortiGate se snaží poslat provoz na VTEP z (správného) VXLAN FDB, ale používá špatný DST MAC a provoz je očekávaně odmítnut přijímajícím rozhraním hypervizoru. A to v jednom případě ze čtyř patřil tento MAC původnímu hypervizoru, ze kterého jsme začali migraci stroje.
Včera jsem dostal e-mail od technické podpory Fortinet - k mému případu otevřeli chybu 615586. Opravu nevím, zda se mám radovat nebo truchlit: na jedné straně - problém není v nastavení, na druhé - oprava přijde pouze s aktualizací firmwaru, nejlépe v příštím. Můj egoismus zesiluje také další chyba, kterou jsem odhalil minulý měsíc, pravda v tenkrát v HTML5 GUI vSphere. No, jako lokální QA oddělení dodavatelů…
Risknu s následujícím návrhem:
1 - multicast kontrolní rovina pravděpodobně nebude vystavena popsanému problému - MAC adresy VTEP se přece získávají z IP adresy skupiny, na kterou se rozhraní přihlásilo.
2 - problém FortiGate je pravděpodobně v offloadování relací na Network Processor (přibližně analogické CEF) - pokud se každý paket nechá projít CPU, budou se používat tabulky obsahující správné - alespoň na první pohled - informace. Zpětná vazba pro toto předpokládání je, že pomůže zavřít/otevřít rozhraní nebo vyčkat nějaký čas - více než 5 minut.
3 - změna teaming policy, například na explicit failover, nebo zavedení LAG nevyřeší problém, protože bylo pozorováno "zasekávání" MAC původního hypervizoru v enkapsulovaných paketech.
V tomto ohledu mohu sdílet, že jsem nedávno objevil , kde v jednom z článků bylo uvedeno, že stateful firewally a cachované způsoby přenosu dat jsou pouze nouzová řešení. Nuže, nejsem tak zkušený v IT, abych takové tvrzení mohl zaručit, navíc nesouhlasím se všemi tvrzeními blogových článků hned na první pohled. Přesto mi něco říká, že v slovech Ivana je část pravdy.
Děkuji za pozornost! Budu rád odpovědět na otázky a slyšet konstruktivní kritiku.
Zdroj: habr.com
