

Tisíce manažerů z prodejných kanceláří po celé zemi zaznamenávají v denně desítky tisíc kontaktů — faktů o komunikaci s potenciálními nebo stávajícími klienty. Nejprve je však potřeba tohoto klienta najít, ideálně co nejrychleji. A to se většinou děje podle názvu.
Není proto překvapující, že při zkoumání "náročných" dotazů na jedné z nejvíce zatížených databází — naším vlastním , jsem objevil "v topu" dotaz pro "rychlé" vyhledávání podle názvu pro karty organizací.
A další vyšetřování odhalilo zajímavý příklad nejprve optimalizace a poté degradace výkonu dotazu při postupném zdokonalování ze strany několika týmů, z nichž každý jednal výhradně s nejlepšími úmysly.
0: co vlastně chtěl uživatel
 [KDPV ]
Co si vlastně uživatel obvykle představuje, když mluví o "rychlém" vyhledávání podle názvu? Téměř nikdy to neznamená "čestné" vyhledávání podle podřetězce typu ... LIKE '%růže%' — protože pak v výsledku končí nejen 'Růželia' a 'Obchod Růže', ale také 'GRůže' a dokonce 'Dům Děda MoRůže'.
Uživatel si na běžné úrovni představuje, že mu zajistíte vyhledávání podle začátku slova v názvu a ukážete relevantnější to, co začíná na zadané. A uděláte to prakticky okamžitě — při zadání podřetězce.
1: omezujeme úkol
A už vůbec nebude člověk speciálně zadávat 'růže obchod', aby každé slovo jste museli hledat prefixně. Ne, uživateli je mnohem snazší reagovat na rychlou nápovědu pro poslední slovo, než cíleně "nedovádět" předchozí — podívejte se, jak to zpracovává jakýkoli vyhledávač.
Obecně, správně formulovat požadavky na úkol — to je více než polovina řešení. Někdy pečlivá analýza use case .
Co dělá abstraktní vývojář?
1.0: externí vyhledávací engine
Och, vyhledávání je složité, do toho se vůbec nechce — pojďme to předat devops! Ať nám rozvinou externí vyhledávací systém, Sphinx, ElasticSearch,…
Pracovní, i když časově náročný způsob synchronizace a rychlosti změn. Ale v našem případě to neplatí, protože hledání probíhá pouze v rámci dat každého klienta. A data mají dost vysokou změnlivost — a pokud teď manažer přidá kartu 'Obchod Růže', tak si za 5-10 sekund může vzpomenout, že zapomněl uvést email a chce ji najít a opravit.
Proto — pojďme hledat "přesně v databázi". Naštěstí nám PostgreSQL to umožňuje a ne jen jedním způsobem — ty si nyní projdeme.
1.1: "poctivý" podřetězec
Zaměřujeme se na slovo „podřetězec“. No, přesně pro indexové vyhledávání podle podřetězce (a dokonce i podle regulárních výrazů!) existuje skvělý ! Jen musíme potom správně seřadit.
Zkusme vzít pro zjednodušení model takovou tabulku:
CREATE TABLE firms(
  id
    serial
      PRIMARY KEY
, name
    text
);
Nahrajeme tam 7,8 milionu záznamů skutečných organizací a indexujeme:
CREATE EXTENSION pg_trgm;
CREATE INDEX ON firms USING gin(lower(name) gin_trgm_ops);
Hledáme pro podřetězcové vyhledávání prvních 10 záznamů:
SELECT
  *
FROM
  firms
WHERE
  lower(name) ~ ('(^|s)' || 'růže')
ORDER BY
  lower(name) ~ ('^' || 'růže') DESC -- nejprve "začínající na"
, lower(name) -- zbytek podle abecedy
LIMIT 10;
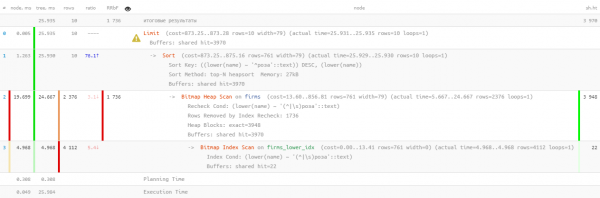
No, tak... 26ms, 31MB přečtených dat a více než 1,7K filtrovaných záznamů — pro 10 hledaných. Náklady jsou příliš vysoké, nedalo by se to nějak efektivněji?
1.2: vyhledávání podle textu? to je přece FTS!
Opravdu, PostgreSQL poskytuje velmi mocný (Full Text Search), včetně možnosti prefixového vyhledávání. Skvělá možnost, ani žádná rozšíření není potřeba! Zkusme:
CREATE INDEX ON firms USING gin(to_tsvector('simple'::regconfig, lower(name)));SELECT
*
FROM
firms
WHERE
to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'růže:*')
ORDER BY
lower(name) ~ ('^' || 'růže') DESC
, lower(name)
LIMIT 10; 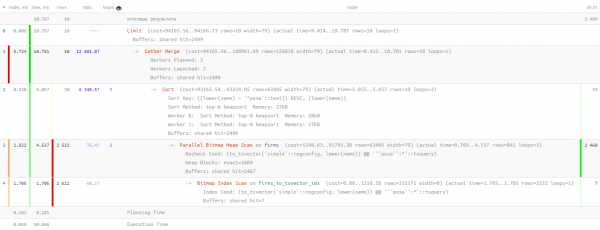
Tady nám trochu pomohla paralelizace vykonávání dotazu, zkrátila se doba na polovinu na 11ms. A přečíst jsme museli 1,5krát méně — jen 20MB. A čím méně — tím lépe, protože čím větší objem vyčítáme, tím vyšší je šance na cache miss, a každá zbytečně přečtená stránka dat z disku je potenciální "brzdou" pro dotaz.
1.3: stále LIKE?
Všechno předchozí je skvělé, ale pokud to spustíme sto tisíc krát za den, nashromáždí se už 2TB přečtených dat. V tom nejlepším případě z paměti, ale pokud máme smůlu, tak i z disku. Takže zkusme udělat to menší.
Vzpomínáme, že uživatel chce vidět nejprve „které začínají na ...“. Ale vždyť to je jasně prostřednictvím text_pattern_ops! A jen pokud nám „nebudou stačit“ 10 požadovaných záznamů, budeme je muset dočíst pomocí FTS vyhledávání:
CREATE INDEX ON firms(lower(name) text_pattern_ops);SELECT
*
FROM
firms
WHERE
lower(name) LIKE ('růže' || '%')
LIMIT 10; 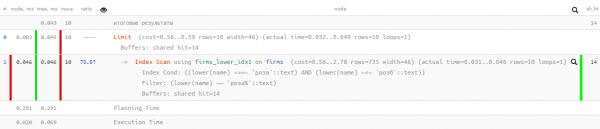
Skvělé výsledky — celkem 0.05 ms a něco málo přes 100 KB přečteno! Jen jsme zapomněli seřazení podle názvu, aby se uživatel neztratil v výsledcích:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('růže' || '%')
ORDER BY
  lower(name)
LIMIT 10; 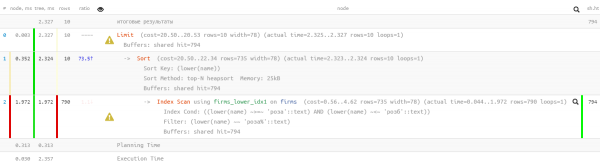
Omlouvám se, něco už není tak hezké — přestože index je, ale řazení se míjí s ním... To je sice už mnohem efektivnější než předchozí varianta, ale...
1.4: „dovybavit pilníkem“
Ale existuje index, který umožňuje hledat i podle rozsahu a přitom používat řazení správně — běžný btree!
CREATE INDEX ON firms(lower(name));Jen dotaz na něj bude nutné „sestavit ručně“:
SELECT
  *
FROM
  firms
WHERE
  lower(name) >= 'růže' AND
  lower(name) <= ('růže' || chr(65535)) -- pro UTF8, pro jednobajtové - chr(255)
ORDER BY
   lower(name)
LIMIT 10; 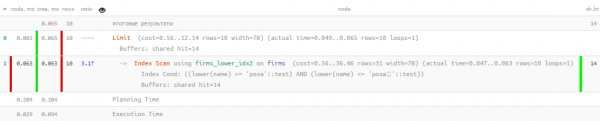
Skvěle — a řazení funguje a spotřeba zdrojů zůstala „mikroskopická“, o tisíce procent efektivnější než „čisté“ FTS! Zbývá vše spojit do jednoho dotazu:
(
  SELECT
    *
  FROM
    firms
  WHERE
    lower(name) >= 'růže' AND
    lower(name) <= ('růže' || chr(65535)) -- pro UTF8, pro jednbajtové kódování - chr(255)
  ORDER BY
     lower(name)
  LIMIT 10
)
UNION ALL
(
  SELECT
    *
  FROM
    firms
  WHERE
    to_tsvector('simple'::regconfig, lower(name)) @@ to_tsquery('simple', 'růže:*') AND
    lower(name) NOT LIKE ('růže' || '%') -- „začínající na“ jsme už našli výše
  ORDER BY
    lower(name) ~ ('^' || 'růže') DESC -- používáme stejné řazení, abychom NEšli po btree indexu
  , lower(name)
  LIMIT 10
)
LIMIT 10;
Poznamenám, že druhý poddotaz se provádí pouze pokud první vrátil méně očekávaného posledního LIMIT počtu řádků. O takovém způsobu optimalizace dotazů jsem .
Ano, nyní máme na tabulce současně btree i gin, přesto se ukázalo, že méně než 10% dotazů se dostane k vykonání druhého bloku. To znamená, že při těchto známých typických omezeních pro úkol jsme dokázali snížit celkovou spotřebu zdrojů serveru prakticky o tisíce procent!
1.5*: obejdeme se bez pilníku
Nahoře LIKE bránili nám použít nesprávné třídění. Ale lze ho „nasměrovat na správnou cestu“ pomocí použití operátoru USING:
Výchozí hodnota je
ASC. Dále lze specifikovat název konkrétního třídícího operátoru v dotazuUSING. Třídící operátor musí být členem „menší než“ nebo „větší než“ některého rodiny operátorů B-stromu.ASCobvykle rovnocennéUSING <aDESCobvykle rovnocennéUSING >.
V našem případě „menší než“ je ~<~:
SELECT
  *
FROM
  firms
WHERE
  lower(name) LIKE ('růže' || '%')
ORDER BY
  lower(name) USING ~<~
LIMIT 10; 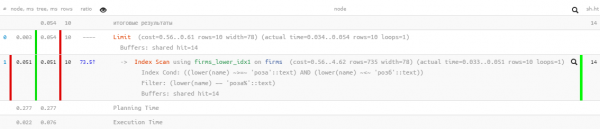
2: jak „zkysnou“ dotazy
Teď necháváme náš dotaz „uzrát“ půl roku až rok a s překvapením znovu objevíme, že je „v topu“ s čísly celkového denního „vylepšení“ paměti (buffers shared hit) v 5.5TB — tedy ještě více, než bylo původně.
Ne, samozřejmě, že náš byznys vyrostl a zátěž se zvýšila, ale ne tak moc! To znamená, že něco není v pořádku — pojďme to prozkoumat.
2.1: zrození paginace
V určitou chvíli jiné vývojářské týmu chtělo umožnit, aby z rychlého podřízeného vyhledávání bylo možné „skákat“ do rejstříku se stejnými, ale rozšířenými výsledky. A jaký rejstřík bez stránkování? Pojďme to připojit!
( ... LIMIT  + 10)
UNION ALL
( ... LIMIT  + 10)
LIMIT 10 OFFSET ;
Teď bylo možné bez stresu pro vývojáře zobrazit rejstřík výsledků vyhledávání s „typově stránkovou“ podnávkou.
Samozřejmě, ve skutečnosti, pro každou další stránku dat se čte čím dál více a více (všechno z předchozího, co vyřadíme, plus potřebný „odstaveček“) — to znamená, že to je jednoznačný antipattern. A správnější by bylo — spouštět vyhledávání na další iteraci od zapamatovaného klíče v rozhraní, ale o tom — příště.
2.2: touha po exotičnosti
V určitou chvíli se vývojář chtěl rozmanitější výsledkovou sadu dat z jiné tabulky, což vyžadovalo, aby byl celý předchozí dotaz zaslán do CTE:
WITH q AS (
  ...
  LIMIT  + 10
)
SELECT
  *
, (SELECT ...) sub_query -- nějaký dotaz na související tabulku
FROM
  q
LIMIT 10 OFFSET ;
A dokonce takto — není špatně, protože vnořený dotaz se počítá pouze pro 10 vrácených záznamů, kdyby nebylo...
2.3: DISTINCT bezúčelový a nemilosrdný
Někde v průběhu takové evoluce z druhého poddotazu se ztratilo NOT LIKE podmínka.Je jasné, že po tom UNION ALL začal vracet některé záznamy dvakrát — nejprve nalezené podle začátku řetězce, a poté znovu — podle začátku prvního slova tohoto řetězce. V limitě mohou všechny záznamy druhého poddotazu korespondovat se záznamy prvního.
Co dělá programátor místo hledání příčiny?.. Není to otázka!
- zdvojnásobíme velikost výchozích vzorků
- aplikujeme DISTINCT, aby byly k dispozici pouze jedinečné instance každého řetězce
WITH q AS (
  ( ... LIMIT  + 10)
  UNION ALL
  ( ... LIMIT  + 10)
  LIMIT  + 10
)
SELECT DISTINCT
  *
, (SELECT ...) sub_query
FROM
  q
LIMIT 10 OFFSET ;
To znamená, že výsledek bude nakonec stejný, ale šance, že „propadneme“ ve 2. poddotazu CTE, je nyní mnohem vyšší, a to i bez toho, se čte zjevně více.
Ale to není ta největší starost. Protože programátor požádal o výběr DISTINCT ne podle konkrétních, ale hned podle všech polí záznamů, tak se automaticky dostalo i pole sub_query — výsledek poddotazu. Nyní, k provedení DISTINCT, musela databáze už provést ne 10 poddotazů, ale všech + 10!
2.4: spolupráce nade vše!
Takto žili programátoři — netrápili se, protože v registru „dotáhnout“ na podstatné hodnoty N při chronickém zpomalení získávání každé další „stránky“ uživatel jednoznačně neměl trpělivost.
Až přišli programátoři z jiného oddělení a chtěli využít této pohodlné metody pro iterativní hledání — tedy bereme z nějakého vzorku kousek, filtrujeme podle dodatečných podmínek, vykreslíme výsledek, pak následující kousek (což v našem případě dosahujeme zvýšením N), a tak dále, dokud nenaplníme obrazovku.
Celkově, v zachyceném případě N dosáhlo hodnot téměř 17K, a během 24 hodin bylo „řetězem“ provedeno ne méně než 4K takových dotazů. Poslední z nich už bez obav skenovaly po 1GB paměti při každé iteraci…
Celkem
Zdroj: habr.com
