

Ahoj! Jmenuji se Alexej Pjankov, jsem vývojář ve společnosti Sportmaster. V tomto jsem popsal, jak začala práce na webu Sportmaster v roce 2012, jaké iniciativy se podařilo "protlačit" a naopak, jaké překážky jsme nasbírali.
Dnes chci sdílet myšlenky, které následují za jiným tématem – výběrem systému cache pro java backend v administraci webu. Toto téma má pro mě zvláštní význam – ačkoliv se příběh odehrával pouze 2 měsíce, během těchto 60 dnů jsme pracovali 12-16 hodin a bez jediného volného dne. Nikdy dříve jsem si nemyslel a nepředstavoval, že se dá tak mnohem pracovat.
Proto text rozděluji na 2 části, abych to nezahltil. Naopak, první část bude velmi lehká — příprava, úvod, některé úvahy o tom, co je cache. Pokud už jste zkušený vývojář nebo jste pracovali s cache, z technického hlediska v tomto článku pravděpodobně nic nového nenajdete. A pro juniory může být malý takový přehled užitečný, aby věděli, kterým směrem se podívat, pokud se ocitnou na takové křižovatce.
Když byla nová verze webu Sportmaster uvedena do produkce, data přicházela způsobem, jemně řečeno, velmi nepohodlným. Základem byly tabulky připravené pro předchozí verzi webu (Bitrix), které bylo potřeba natáhnout do ETL, upravit na nový vzhled a obohatit různými vylepšeními z dalších desítek systémů. Aby se nová fotografie nebo popis zboží objevily na webu, bylo nutné počkat do dalšího dne — aktualizace probíhala pouze v noci, 1x denně.
Zpočátku bylo tolik starostí během prvních týdnů po uvedení do provozu, že takové nepohodlí pro content managery bylo maličkostí. Ale jakmile se vše ustálilo, vývoj projektu pokračoval — po několika měsících, na začátku roku 2015, jsme začali aktivně vyvíjet administraci. V letech 2015 a 2016 to šlo dobře, pravidelně vydáváme nové verze, administrace pokrývá stále větší část přípravy dat a připravujeme se na to, že brzy naší skupině bude svěřeno to nejdůležitější a nejtěžší – produktový okruh (plná příprava a správa dat o všech produktech). Ale v létě 2017, těsně před spuštěním produktového okruhu, se projekt ocitl ve velmi složité situaci – právě kvůli problémům s cache. O tomto epizodu chci vyprávět ve druhé části této dvoudílné publikace.
Ale v tomto příspěvku začnu od začátku a shrnu několik myšlenek – představy o cacheování, které by bylo dobré si projít před velkým projektem.
Když se objeví úkol cacheování
Úkol cacheování se neobjevuje jen tak. Jsme vývojáři, vytváříme softwarový produkt a chceme, aby byl žádaný. Pokud je produkt žádaný a úspěšný, uživatelé přicházejí. A přicházejí další. A najednou je uživatelů tolik, že produkt se stává vysoce zatíženým.
Na počátku nepřemýšlíme o optimalizaci a výkonnosti kódu. Hlavní je funkčnost, rychle aplikovat pilotní verzi a ověřit hypotézy. A pokud se zatížení zvyšuje - posilujeme hardware. Zvyšujeme ho dvakrát, třikrát, pětkrát, dejme tomu desetkrát. Kdesi tady – finance už nebudou stačit. A kolikrát vzroste počet uživatelů? Nebude to 2-5-10, ale v případě úspěchu to bude od 100-1000 až po 100 tisíckrát. To znamená, že dříve nebo později se optimalizaci budeme muset věnovat.
Představme si, že nějaká část kódu (nazvěme tuto část funkcí) funguje nepřiměřeně dlouho a my chceme zkrátit čas vykonání. Funkce může být přístup k databázi, může být provádění nějaké složité logiky – hlavní je, že trvá dlouho. O kolik lze zkrátit čas vykonání? Úplně – lze ho zkrátit na nulu, ne dál. A jak lze zkrátit čas vykonání na nulu? Odpověď: úplně vyloučit vykonání. Místo toho okamžitě vrátit výsledek. A jak poznat výsledek? Odpověď: buď spočítat, nebo někde nahlédnout. Spočítat – to trvá dlouho. A nahlédnout – to je například si zapamatovat ten výsledek, který funkce vrátila při minulém volání se stejnými parametry.
To znamená, že implementace funkce pro nás není důležitá. Stačí vědět, od jakých parametrů závisí výsledek. Pokud tedy hodnoty parametrů představíme ve formě objektu, který je možné použít jako klíč v určitém úložišti — můžeme výsledek výpočtu uložit a při dalším zavolání ho přečíst. Pokud proces zápisu a čtení výsledku bude rychlejší než vykonání funkce – máme zisk v rychlosti. Velikost zisku může dosáhnout až 100, 1000 nebo dokonce 100 tisíckrát (10^5 – to je spíše výjimka, ale v případě výrazně zpomalující databáze – je to zcela možné).
Hlavní požadavky na systém cachování
První věc, která může být požadavkem na systém cachování — rychlá rychlost čtení a v menší míře – rychlost zápisu. To je tak, ale pouze do té doby, než nasadíme systém do produkce.
Zahrajeme si takový případ.
Představme si, že jsme zajistili hardware pro aktuální zatížení a nyní pomalu zavádíme cachování. Trochu přibývá uživatelů, roste zatížení – trochu přidáváme cache, připojujeme ji sem a tam. Tak to pokračuje nějakou dobu, a nyní už prakticky nevytváříme těžké funkce — veškerá hlavní zátěž spočívá na cache. Počet uživatelů se během této doby zvýšil Nkrát.
A pokud byl počáteční hardware kapacitně 2-5krát, pak s pomocí cache jsme mohli zvýšit výkon 10krát nebo, v dobrém případě 100krát, místy, možná i 1000krát. To znamená, že na stejném hardwaru — zpracováváme 100krát více požadavků. Skvělé, zasloužili jsme si odměnu!
Ale nyní, v jednom krásném okamžiku, náhodou, systém selhal a cache padla. Nic zvláštního — protože cache byla vybrána na základě požadavku „vysoká rychlost čtení a zápisu, zbytek není důležitý“.
Co se týká počáteční zátěže, měli jsme hardware 2-5krát, a zátěž za tuto dobu vzrostla 10-100krát. S pomocí cache jsme vylučovali volání pro těžké funkce a proto vše bylo rychlé. A teď, bez cache – kolikrát naše systém sníží? Co se s námi stane? Systém spadne.
I když naše cache nepřišla o data, ale pouze se na nějakou dobu vyčistila – bude třeba ji zahřát, a to nějaký čas potrvá. A během této doby – hlavní zátěž se přesune na funkce.
Výstup: Vysoce zatížené projekty v produkci vyžadují od systému kešování nejen vysokou rychlost čtení a zápisu, ale také zachování dat a odolnost vůči poruchám.
Mučení výběru
V projektu s administračním rozhraním proběhl výběr takto: nejprve jsme nasadili Hazelcast, protože jsme s tímto produktem měli již zkušenosti z hlavního webu. Avšak tento výběr se ukázal jako neúspěšný - podle našeho zátěžového profilu Hazelcast funguje nikoli pomalu, ale hrozně pomalu. A v době, kdy jsme se už podepsali na termínech uvedení do produkce.
Spoiler: jak se vlastně udály okolnosti, že jsme propásli takový problém a dostali se do napjaté situace - povím ve druhé části - a jak jsme se dostali ven. Ale teď - jen řeknu, že to byl silný stres a "myslet - nějak se nedá, třeseme lahví". "Třeseme lahví" - to je také spoiler, o tomto ještě později.
Co jsme udělali:
- Sestavujeme seznam všech systémů, které doporučuje google a StackOverflow. O něco více než 30.
- Píšeme testy se zátěží, charakteristickou pro produkci. K tomu jsme pořídili data, která procházejí systémem v produkčním prostředí - takový sniffer pro data ne v síti, ale uvnitř systému. Do testů jsme spustili právě tato data.
- Celý tým, každý si vybere další systém ze seznamu, nastaví ho a provede testy. Pokud test neprojde, nezvládne zátěž - vyřadíme ho a přejdeme k dalšímu v pořadí.
- Na 17. systému se ukázalo, že vše je beznadějné. Stačilo "třást lahví", je čas zamyslet se vážně.
Ale to je možnost, kdy je potřeba vybrat systém, který "projde rychlostí" v předem připravených testech. A co když takové testy ještě neexistují a je potřeba vybrat rychleji?
Modelujeme takovou variantu (těžko si představit, že mid-level+ vývojář žije ve vaku, a v době výběru ještě nemá preference, který produkt zkusit jako první - proto, další úvahy jsou spíše teoretické / filozofické / o juniorech).
Určivše požadavky, začneme vybírat řešení z krabice. Proč vynalézat kolo: půjdeme a vezmeme hotový systém kešování.
Pokud teprve začínáte a budete googlit, plus mínus pořadí, ale celkově budou vodítka taková. V první řadě narazíte na Redis, ten je všude slyšet. Potom se dozvíte, že existuje EhCache jako nejstarší a osvědčený systém. Dále bude napsáno o Tarantool — domácí vývoj, který má unikátní aspekt řešení. A také Ignite, protože v současnosti je na vzestupu popularity a těší se podpoře SberTechu. Na závěr ještě Hazelcast, protože v enterprise světě se často objevuje ve velkých společnostech.
Tímto seznam nekončí, systémů existují desítky. A my připojíme pouze jeden. Vezmeme vybraných 5 systémů na "konkurs krásy" a provedeme výběr. Kdo bude vítězem?
Redis
Čteme, co píšou na oficiálních stránkách.
— opensource projekt. Nabízí in-memory úložiště dat, možnost uložení on-disk, automatické rozdělení na partice, vysokou dostupnost a obnovu po síťových přerušeních.
Vypadá to skvěle, můžeme vzít a připojit — vše, co potřebuje, dělá. Ale podívejme se pro zajímavost na ostatní kandidáty.
EhCache
— "nejvíce široce používaná cache pro Java" (překlad sloganu z oficiálních stránek). Také opensource. A zde chápeme, že Redis není pro Javu, ale obecný, a pro interakci s ním potřebujeme obal. A EhCache bude pohodlnější. Co dalšího systém slibuje? Spolehlivost, ověřenost, plnohodnotnost. No a také je nejrozšířenější. A cacheuje terabyty dat.
Redis je zapomenut, jsem připraven vybrat EhCache.
Ale pocit patriotismu mě nutí podívat se, čím je dobrý Tarantool.
Tarantool
— vítá označením "Platforma pro integraci dat v reálném čase". Zní to velmi složitě, takže čteme stránku podrobně a nacházíme vyjádření: "Cacheuje 100% dat v operační paměti". To by mělo vyvolat otázky — vždyť dat může být mnohem více než paměti. Rozluštění spočívá v tom, že zde se má na mysli, že při zápisu dat na disk z paměti Tarantool neprovádí serializaci. Místo toho — využívá nízkoúrovňové vlastnosti systému, kdy je paměť jednoduše mapována na souborový systém s velmi dobrými parametry I/O. Celkově udělali něco jako skvělé a skvělé.
Podívejme se na implementace: Mail.ru firemní magistrála, Avito, Beeline, MegaFon, Alfa-Bank, Gazprom...
Pokud jste měli nějaké pochybnosti o Tarantool, případ nasazení v Mastercard mě definitivně přesvědčil. Volím Tarantool.
Ale přece jen...
Ignite
… existuje ještě , označený jako „in-memory počítačová platforma… in-memory rychlost na petabajtech dat“. I zde je spousta výhod: distribuovaná in-memory cache, nejrychlejší key-value úložiště a cache, horizontální škálovatelnost, vysoká dostupnost, přísná integrita. Zkrátka, nejrychlejší je Ignite.
Nasazení: Sberbank, American Airlines, Yahoo! Japan. A pak se dozvím, že Ignite není jen tak nasazen v Sberbank, ale tým SberTecha posílá své lidi do týmu samotného Ignite, aby vyvíjeli produkt. To mě úplně přesvědčilo a jsem připraven zvolit Ignite.
Úplně nerozumím, proč se dívám na pátý bod.
Hazelcast
Jdu na webové stránky , čtu. A ukazuje se, že nejrychlejší řešení pro distribuované cache je Hazelcast. Je to mnohem rychlejší než všechna ostatní řešení a vůbec je lídrem v oblasti in-memory data grid. Na jeho pozadí by bylo nesmyslné vzít něco jiného. Navíc využívá redundantní uložení dat pro nepřetržitou funkčnost clusteru bez ztráty dat.
To je to, jsem připraven zvolit Hazelcast.
Porovnání
Ale pokud se podíváme, všech pět kandidátů je popsáno tak, že každý z nich je ten nejlepší. Jak vybrat? Můžeme se podívat, který z nich je nejpopulárnější, hledat srovnání, a bolest hlavy bude pryč.
Najdeme takový , vybíráme naše 5 systémů.
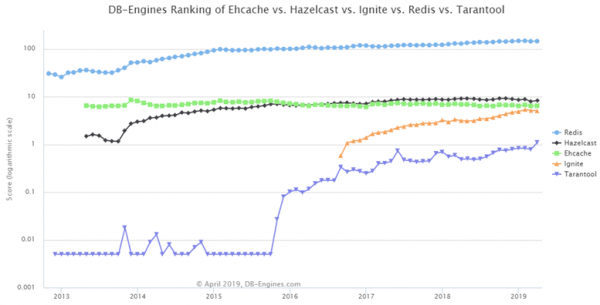
Zde jsou seřazeny: nahoře Redis, na druhém místě Hazelcast, zvyšují popularitu Tarantool a Ignite, EhCache zůstal, jak byl.
Ale podíváme se na : odkazy na webové stránky, celkový zájem o systém, nabídky pracovních míst — skvělé! Tedy, když mi systém spadne, řeknu: „Ne, je přece spolehlivý! Tady je mnoho pracovních nabídek…“. Takové jednoduší srovnání nebude fungovat.
Všechny tyto systémy nejsou jen systémy pro cache. Mají také spoustu dalších funkcí, včetně – když data nejsou přesouvána klientovi k zpracování, ale naopak: kód, který má být proveden nad daty, se přesune na server, tam se vykoná a výsledek se vrátí. A jako samostatný systém pro cache je často ani nevnímají.
Dobře, nevzdáváme se, najdeme přímé srovnání systémů. Vezmeme dvě nejlepší varianty — Redis a Hazelcast. Zajímá nás rychlost, podle tohoto parametru je srovnáme.
Hz vs Redis
Najdeme něco takového :
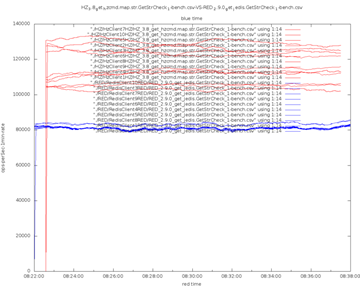
Modrá je Redis, červená Hazelcast. Hazelcast vítězí ve všech ohledech, a to má své opodstatnění: je vícerozměrný, vysoce optimalizovaný, každý vlákno pracuje se svou partií, takže nedochází k zámkům. Naopak Redis je jednovláknový, a z moderních vícejádrových CPU nevyužívá výhody. Hazelcast má asynchronní I/O, zatímco Redis-Jedis využívá blokující sockety. Nakonec, Hazelcast používá binární protokol, zatímco Redis je zaměřen na text, což znamená, že je méně efektivní.
Pro jistotu se podívejme na další zdroj srovnání. Co nám ukáže?
Redis vs Hz
Ještě jedno :
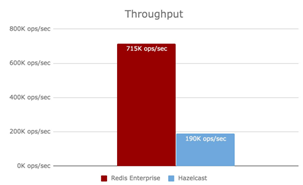
Zde je to naopak, červená je Redis. To znamená, že Redis má lepší výkon než Hazelcast. V prvním srovnání vyhrál Hazelcast, ve druhém pak Redis. velmi přesně vysvětlili, proč v předchozím srovnání vyhrál Hazelcast.
Ukazuje se, že výsledek prvního srovnání byl vlastně zmanipulován: Redis byl vzat v základním balení, zatímco Hazelcast byl přizpůsoben pro testovací případ. Takže to vychází na to, že za prvé, nikomu se nedá věřit, a za druhé, když si skutečně vybereme systém, musíme ho také správně nakonfigurovat. Tyto konfigurace zahrnují desítky, téměř stovky parametrů.
Protočme láhev
A celý proces, který jsme právě prošli, mohu vysvětlit takovou metaforou "Protočme láhev". To znamená, že nyní není třeba programovat, teď je nejdůležitější umět číst stackoverflow. A mám v týmu člověka, profesionála, který přesně takto pracuje v kritických chvílích.
Co dělá? Vidí nefunkční zařízení, vidí stack trace, vybírá z něj některá slova (která přesně — to je jeho odborná znalost v programu), hledá na googlu, nachází stackoverflow mezi odpověďmi. Nečte, nezkoumá, mezi odpověďmi na otázku — vybere něco, co nejvíce připomíná větu „udělat to a to“ (vybrat takovou odpověď — to je jeho talent, protože to není vždy ten odpověď, která získala nejvíce lajků), aplikuje, podívá se: pokud se něco změnilo, je to skvělé. Pokud se nic nezměnilo — vrátíme se zpět. A opakujeme spuštění-kontrolu-hledání. A tímto intuitivním způsobem dosáhne toho, že po nějaké době kód funguje. Neví proč, neví, co udělal, nedokáže to vysvětlit. Ale! Tohle funguje. A „požár je uhašen“. Teď se snažíme rozluštit, co jsme udělali. Když program funguje — je to o hodně snazší. A výrazně to šetří čas.
Tento způsob se velmi dobře vysvětluje na příkladu.
Kdysi bylo velmi populární skládat plachetnici do lahve. Plachetnice je velká a křehká, a hrdlo lahve je velmi úzké, nelze ji dovnitř dostat. Jak ji sestavit?
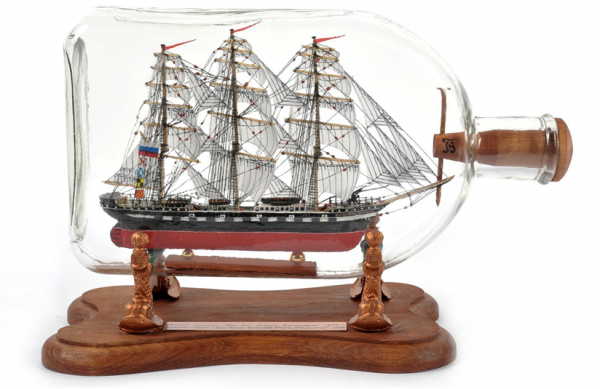
Existuje taková metoda, velmi rychlá a velmi efektivní.
Lodě se skládají z řady drobností: tyčinek, provázků, plachet, lepidla. To všechno vložíme do lahve.
Vezmeme lahev oběma rukama a začneme ji třást. Třeseme, třeseme. A obvykle – vznikne úplná hloupost, samozřejmě. Ale někdy. Někdy se podaří loď! Přesněji, něco podobného lodi.
Toto něco ukazujeme někomu: „Sergio, vidíš!?“. A skutečně, z dálky – vypadá to jako loď. Ale dál to nemůžeme pustit.
Existuje ještě jeden způsob. Používají ho pokročilejší kluci, takoví hackeři.
Dal jsem takovému chlapci úkol, on všechno udělal a odešel. A podíváš se – zdá se, že to je hotové. Ale za nějakou dobu, když je potřeba kód doladit — začíná tam něco kvůli němu… Dobře, že už se dostal daleko. To jsou kluci, kteří například na lahvi udělají tohle: vidíte, kde je dno – sklo se ohýbá. A není úplně jasné, jestli je průhledné nebo ne. Takže „hackeři“ zkrátí to dno, vloží tam loď, dno pak znovu přilepí a vypadá to, jako by to tak mělo být.
Z pohledu zadání je to zdá se správně. Ale co se týče lodí: proč vlastně vyrábět tuto loď, komu je vůbec potřeba? Žádnou funkčnost nenese. Obvykle takové lodě jsou dary velmi vysoce postaveným osobám, které je umísťují na poličku nad sebou jako určitou symboliku, jako znamení. A pokud má taková osoba, vedoucí velký podnik nebo vysoce postavený úředník, nad sebou vlajku s takovým nedokonalým výrobkem, u kterého je odříznutý krk? Bylo by lepší, kdyby se to nikdy nedozvěděl. A jak se vlastně vyrábějí lodě, které lze darovat důležité osobě?
Jedno místo, klíčové, se kterým se opravdu nic nedá udělat, je trup. A trup lodi právě prochází krkem. Když se loď skládá mimo láhev. Ale není to jen tak sešroubovat loď, je to pravé zlatnické řemeslo. Do jednotlivých částí se přidávají speciální páky, které umožňují je pak zvednout. Například plachty se skládají, pečlivě vnášejí dovnitř, a pak se pomocí pinzety velmi precizně, přesně, zpevňují a zvedají. Výsledkem je umělecké dílo, které lze s čistým svědomím a hrdostí darovat.
A pokud chceme, aby projekt byl úspěšný – v týmu musí být alespoň jeden zlatník. Ten, kdo dbá na kvalitu produktu a zohledňuje všechny aspekty, aniž by obětoval jakýkoli, i v okamžicích stresu, kdy okolnosti vyžadují něco rychlého na úkor důležitého. Všechny úspěšné projekty, které jsou stabilní, které prošly zkouškou času, jsou postaveny na tomto principu. Mají něco velmi precizního a unikátního, něco, co využívá všechny dostupné možnosti. V příkladu s lodí v láhvi se objevuje to, že trup lodi prochází krkem.
Pokud se vrátíme k úkolu výběru našeho cache serveru, jak by bylo možné tuto metodu použít? Navrhuji takovou variantu výběru ze všech systémů, co existují — netřást láhví, nevybírat, ale podívat se, co v nich vlastně je takového, na co se zaměřit při výběru systému.
Kde hledat úzké místo
Pokud nebudeme třást lahví a nebudeme procházet vše, co máme podle pořadí, podívejme se, jaké úkoly vzniknou, pokud bychom měli navrhnout takový systém samostatně. Sestavit kolo samozřejmě nebudeme, ale využijeme tento schéma, abychom se zorientovali, na co se zaměřit v popisech produktů. Nakreslíme takovou schéma.
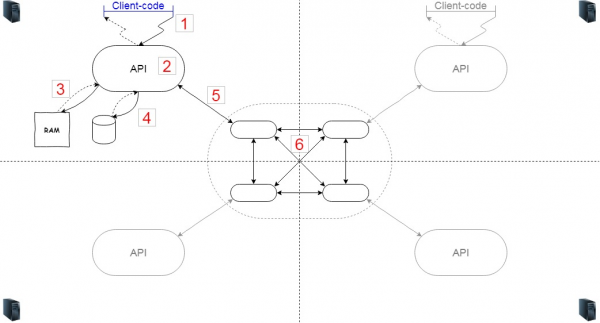
Pokud je systém distribuovaný, znamená to, že budeme mít několik serverů (6). Předpokládejme, že čtyři (což je pohodlné umístit do obrázku, ale samozřejmě jich může být kolik chcete). Pokud jsou servery umístěny na různých uzlech, pak na nich všech běží nějaký kód, jehož úkolem je zajistit, aby tyto uzly vytvořily cluster a v případě přerušení - spojily se a poznaly se navzájem.
Dále potřebujeme logiku kódu (2), která se vlastně týká caching. Tento kód interaguje s klienty prostřednictvím určitého API. Klientský kód (1) může být jak v rámci téže JVM, tak se k němu může přistupovat přes síť. Logika implementovaná uvnitř zahrnuje rozhodnutí o tom, jaké objekty nechat v cache a které vyhodit. Pro uložení cache použijeme paměť (3), ale pokud bude potřeba, můžeme část dat uložit i na disku (4).
Podíváme se, v jakých částech bude vznikat zátěž. Vlastně budou zátěž získávat každá šipka a každý uzel. Za prvé, mezi klientským kódem a API, pokud se jedná o síťovou interakci, může být pokles celkem patrný. Za druhé, v rámci samotného API - pokud se příliš snažíme s komplikovanou logikou, můžeme narazit na CPU. A bylo by dobré, aby logika zbytečně nemusela manipulovat s pamětí. Zbývá interakce se souborovým systémem – v běžném případě se jedná o serializaci / obnovení a zapsání / přečtení.
Dále interakce s clusterem. Pravděpodobně bude v tomto systému, ale může být také odděleně. Zde je také potřeba zohlednit přenos dat k němu, rychlost serializace dat a interakci mezi clustery.
Nyní, z jedné strany - můžeme si představit, "jaké ozubené kolo se budou otáčet" v cache systému při zpracování požadavků od našeho kódu, a z druhé strany - můžeme odhadnout, jaké a kolik požadavků náš kód tomuto systému vygeneruje. To stačí k tomu, abychom učinili více či méně rozumnou volbu – vybrali systém pro naše využití.
Hazelcast
Podíváme se, jak tuto dekompozici aplikovat na náš seznam. Například, Hazelcast.
Aby bylo možné ukládat a číst data z Hazelcast, klientský kód se odkazuje (1) na API. Hz umožňuje spustit server jako embedded, a v tomto případě je volání na API vlastně výzvou metody uvnitř JVM, což lze považovat za bezplatné.
Aby logika fungovala v (2), Hz se spoléhá na hash z bajtového pole serializovaného klíče – jinými slovy, serializace klíče proběhne v každém případě. To je nevyhnutelný overhead pro Hz.
Strategie vyřazení jsou implementovány dobře, ale pro specifické případy lze připojit své vlastní. O tuto část se není třeba obávat.
Úložiště (4) lze připojit. Skvělé. Interakce (5) pro embedded lze považovat za okamžitou. Výměna dat mezi uzly v clusteru (6) – ano, ta existuje. To je přínos pro odolnost proti chybám na úkor rychlosti. Cena může být snížena pomocí funkce Hz Near-cache – data získaná z jiných uzlů clusteru budou mezipaměťována.
Co lze v takových podmínkách udělat pro zvýšení rychlosti?
Například, aby se vyhnuli serializaci klíče v (2) – přidat na Hazelcast další cache pro nejvíce používaná data. Ve Sportmasteru pro tento účel zvolili Caffeine.
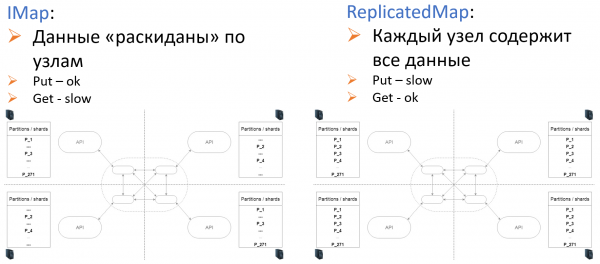
Pro vylepšení na úrovni (6) jsou v Hz navrženy dva typy úložiště: IMap a ReplicatedMap.
Stojí za zmínku, jak se Hazelcast dostal do technického stacku Sportmasteru.
V roce 2012, kdy jsme pracovali na prvním pilotním projektu budoucího webu, se právě Hazelcast stal prvním odkazem, který vyhledávač poskytl. Seznámení vzniklo "na první pokus" — okouzlilo nás to, že pouhé dvě hodiny poté, co jsme Hz připojili do systému — fungoval. A fungoval dobře. Do konce dne jsme dopsali nějaké testy a byli spokojeni. A tato zásoba energie nám stačila k překonání překvapení, která Hz v průběhu času přinášel. Nyní tým Sportmasteru nemá důvod se Hazelcastu vzdávat.
Ale takové argumenty, jako "první odkaz ve vyhledávači" a "rychle jsme sestavili HelloWorld" — to jsou samozřejmě výjimky a specifika okamžiku, ve kterém probíhalo rozhodování. Oprávněné zkoušky pro vybraný systém začínají s přechodem do produkce a právě na tuto fázi by se mělo zaměřit při výběru jakéhokoli systému, včetně cache. V našem případě lze říci, že jsme vybrali Hazelcast náhodně, ale později se ukázalo, že jsme vybrali správně.
Pro výrobu je mnohem důležitější monitorování, správa selhání na jednotlivých uzlech, replikace dat a náklady na škálování. Je tedy třeba se zaměřit na úkoly, které se objeví právě během správy systému – když zátěž desetinásobně překročí plánovanou, když omylem nahrajeme něco špatně a špatně, kdy bude potřeba nasadit novou verzi kódu, vyměnit data a udělat to bez toho, aby si toho klienti všimli.
Pro všechny tyto požadavky je Hazelcast bezesporu vhodný.
Pokračování příště
Ale Hazelcast není zázračný lék. V roce 2017 jsme vybrali Hazelcast pro cache v administraci pouze na základě dobrého dojmu z předchozí zkušenosti. To mělo klíčovou roli v velmi zlé vtipu, kvůli čemuž jsme se ocitli v obtížné situaci a "hrdinně" se z ní dostávali 60 dní. Ale o tom v další části.
A mezitím… Šťastný nový kód!
Zdroj: habr.com
