

Nahrál jsem na Github .
Jedná se o jednoduchou hash tabulku pro GPU, schopnou zpracovávat stovky milionů insertů za sekundu. Na mém notebooku s NVIDIA GTX 1060 kód vkládá 64 milionů náhodně generovaných párů klíč-hodnota přibližně za 210 ms a odstraňuje 32 milionů párů přibližně za 64 ms.
To znamená, že rychlost na notebooku činí přibližně 300 milionů insertů/s a 500 milionů deletů/s.
Tabulka je napsaná na CUDA, i když stejnou metodu lze aplikovat na HLSL nebo GLSL. Implementace má několik omezení, která zajišťují vysoký výkon na grafické kartě:
- Zpracovávají se pouze 32bitové klíče a stejné hodnoty.
- Hash tabulka má pevnou velikost.
- A tato velikost musí být mocninou dvou.
Pro klíče a hodnoty je třeba rezervovat jednoduchý oddělovací marker (v uvedeném kódu to je 0xffffffff).
Hash tabulka bez zámků
V hash tabulce se používá otevřená adresace s , což je prostě pole párů klíč-hodnota uložených v paměti a má vynikající výkon cache. To se nedá říct o chainingu, který znamená hledání ukazatele v propojeném seznamu. Hash tabulka je jednoduché pole, které uchovává prvky KeyValue:
struct KeyValue
{
    uint32_t key;
    uint32_t value;
};
Velikost tabulky je mocninou dvou, nikoli prvočíselné, protože pro použití pow2/AND masky stačí jeden rychlý pokyn, zatímco operátor modulo pracuje mnohem pomaleji. To je důležité v případě lineárního prohledávání, protože při lineárním hledání v tabulce musí být index slotu obalen v každém slotu. A jako výsledek se přidává náklad operace modulu v každém slotu.
Tabulka uchovává pouze klíč a hodnotu pro každý prvek, nikoli hash klíče. Protože tabulka uchovává pouze 32bitové klíče, hash se vypočítává velmi rychle. V uvedeném kódu se používá hash Murmur3, který provádí pouze několik posunů, XOR operací a násobení.
V hash tabulce se používá metoda ochrany proti blokacím, která nezávisí na pořadí umístění v paměti. I když některé zápisové operace naruší pořadí ostatních takových operací, hash tabulka si přesto zachová správný stav. O tom si povíme níže. Metoda skvěle funguje s grafickými kartami, na kterých současně běží tisíce vláken.
Klíče a hodnoty v hash tabulce se inicializují jako prázdné.
Kód lze modifikovat, aby mohl zpracovávat jak 64-bitové klíče, tak hodnoty. Pro klíče jsou potřeba atomické operace čtení, zápisu a porovnání s výměnou (compare-and-swap). A pro hodnoty jsou potřeba atomické operace čtení a zápisu. Naštěstí v CUDA jsou operace čtení-zápisu pro 32- a 64-bitové hodnoty atomické, pokud jsou přirozeně zarovnány (viz ), a moderní grafické karty podporují 64-bitové atomické operace porovnání s výměnou. Samozřejmě při přechodu na 64 bitů se výkon mírně sníží.
Stav hash tabulky
Každý pár klíč-hodnota v hash tabulce může mít jedno ze čtyř stavů:
- Klíč a hodnota jsou prázdné. V takovém stavu se hash tabulka inicializuje.
- Klíč byl zápisován, ale hodnota ještě ne. Pokud jiný vykonávací vlákno v tuto chvíli čte data, pak se vrátí prázdná hodnota. To je normální, to samé by se stalo, kdyby jiné vykonávací vlákno dokončilo dříve, a mluvíme o konkurenční struktuře dat.
- Zapsány byly jak klíč, tak hodnota.
- Hodnota je dostupná pro jiná vykonávací vlákna, ale klíč ještě ne. K tomu může dojít, protože model programování v CUDA předpokládá slabě uspořádaný model paměti. To je normální, v jakékoli situaci je klíč stále prázdný, i když hodnota taková již není.
Důležitý detail spočívá v tom, že jakmile byl klíč zapsán do slotu, již se nepohne — i když bude klíč odstraněn, o tom si povíme níže.
Kód hash tabulky funguje i se slabě uspořádanými modely paměti, ve kterých není známé pořadí čtení a zápisů do paměti. Když budeme rozebírat vkládání, hledání a odstraňování v hash tabulce, mějte na paměti, že každý pár klíč-hodnota se nachází v jednom ze čtyř výše popsaných stavů.
Vkládání do hash tabulky
CUDA funkce, která vkládá do hashovací tabulky páry klíč-hodnota, vypadá takto:
void gpu_hashtable_insert(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        uint32_t prev = atomicCAS(&hashtable[slot].key, kEmpty, key);
        if (prev == kEmpty || prev == key)
        {
            hashtable[slot].value = value;
            break;
        }
        slot = (slot + 1) & (kHashTableCapacity-1);
    }
}
Pro vložení klíče kód iteruje přes pole hashovací tabulky počínaje hashem vkládaného klíče. V každém slotu pole se provádí atomární operace porovnání a výměny, při které se klíč v tomto slotu porovnává s prázdným. Pokud je nalezen nesoulad, klíč ve slotu je aktualizován na vkládaný klíč a poté je vrácen původní klíč slotu. Pokud byl tento původní klíč prázdný nebo odpovídal vkládanému klíči, znamená to, že kód našel vhodný slot pro vložení a vloží do slotu vkládanou hodnotu.
Pokud je v jednom volání jádra gpu_hashtable_insert() je několik prvků se stejným klíčem, pak může být jakákoli z jejich hodnot zapsána do slotu klíče. To se považuje za normální: jedna z operací zápisu klíče-hodnoty během volání bude úspěšná, ale protože to vše probíhá paralelně v rámci několika výpočetních vláken, nemůžeme předpovědět, která operace zápisu do paměti bude poslední.
Vyhledávání v hashovací tabulce
Kód pro vyhledávání klíčů:
uint32_t gpu_hashtable_lookup(KeyValue* hashtable, uint32_t key)
{
        uint32_t slot = hash(key);

        while (true)
        {
            if (hashtable[slot].key == key)
            {
                return hashtable[slot].value;
            }
            if (hashtable[slot].key == kEmpty)
            {
                return kEmpty;
            }
            slot = (slot + 1) & (kHashTableCapacity - 1);
        }
}
Abychom našli hodnotu klíče uloženého v tabulce, iterujeme přes pole počínaje hashem hledaného klíče. V každém slotu kontrolujeme, zda je klíč ten, který hledáme, a pokud ano, vrátíme jeho hodnotu. Také kontrolujeme, zda je klíč prázdný, a pokud ano, přerušíme hledání.
Pokud se nám nepodaří najít klíč, kód vrátí prázdnou hodnotu.
Všechny tyto operace vyhledávání mohou probíhat konkurenčně během vkládání a odstraňování. Každý pár v tabulce bude mít pro vlákno jeden ze čtyř výše popsaných stavů.
Odstranění v hashovací tabulce
Kód pro odstraňování klíčů:
void gpu_hashtable_delete(KeyValue* hashtable, uint32_t key, uint32_t value)
{
    uint32_t slot = hash(key);

    while (true)
    {
        if (hashtable[slot].key == key)
        {
            hashtable[slot].value = kEmpty;
            return;
        }
        if (hashtable[slot].key == kEmpty)
        {
            return;
        }
        slot = (slot + 1) & (kHashTableCapacity - 1);
    }
}
Odstranění klíče se provádí neobvykle: klíč zůstává v tabulce a jeho hodnota (ne samotný klíč) je označena jako prázdná. Tento kód je velmi podobný lookup(), s výjimkou toho, že při nalezení shody podle klíče nastaví jeho hodnotu na prázdnou.
Jak bylo zmíněno výše, jakmile je klíč zapsán do slotu, již se nepohne. I při odstranění prvku z tabulky zůstává klíč na místě, pouze jeho hodnota se stává prázdnou. To znamená, že nemusíme používat atomickou operaci pro zapsání hodnoty slotu, protože na tom nezáleží, zda je aktuální hodnota prázdná nebo ne – stejně bude prázdná.
Změna velikosti hash tabulky
Změnit velikost hash tabulky lze vytvořením větší tabulky a vložením neprázdných prvků ze staré tabulky. Tuto funkčnost jsem neimplementoval, protože jsem chtěl udržet ukázku kódu jednoduchou. Navíc, v CUDA programech je alokace paměti často prováděna v hostitelském kódu, nikoli v CUDA jádře.
V článku popisuje, jak modifikovat tuto strukturu dat chráněnou proti zablokování.
Konkurence
Ve výše uvedených fragmentech kódu funkce gpu_hashtable_insert(), _lookup() a _delete() zpracovávají jeden pár klíč-hodnota najednou. A níže gpu_hashtable_insert(), _lookup() a _delete() zpracovávají pole párů paralelně, každý pár v samostatném GPU vláknu:
// CPU code to invoke the CUDA kernel on the GPU
uint32_t threadblocksize = 1024;
uint32_t gridsize = (numkvs + threadblocksize - 1) / threadblocksize;
gpu_hashtable_insert_kernel<<<gridsize, threadblocksize>>>(hashtable, kvs, numkvs);

// GPU code to process numkvs key/values in parallel
void gpu_hashtable_insert_kernel(KeyValue* hashtable, const KeyValue* kvs, unsigned int numkvs)
{
    unsigned int threadid = blockIdx.x*blockDim.x + threadIdx.x;
    if (threadid < numkvs)
    {
        gpu_hashtable_insert(hashtable, kvs[threadid].key, kvs[threadid].value);
    }
}
Hash tabulka chráněná proti zablokování podporuje konkurenční vkládání, hledání a mazání. Protože páry klíč-hodnota se vždy nacházejí v jednom ze čtyř stavů a klíče se nepohybují, tabulka zajišťuje správnost i při současném používání různých typů operací.
Pokud však zpracováváme dávku vkládání a mazání paralelně a pokud ve vstupním poli párů jsou duplicitní klíče, nebudeme schopni předpovědět, které páry "vyhrají" – které budou poslední zapsány do hash tabulky. Předpokládejme, že jsme spustili kód vkládání s vstupním polem párů A/0 B/1 A/2 C/3 A/4. Když kód dokončí, páry B/1 a C/3 budou zaručeně přítomny v tabulce, ale zároveň v ní bude jakákoli z párů A/0, A/2 nebo A/4Tohle může být problém, nebo také nemusí — záleží na aplikaci. Můžete dopředu vědět, že v inputovém poli nejsou duplicitní klíče, nebo pro vás může být nezáležet na tom, jaká hodnota byla uložena naposledy.
Pokud je to pro vás problém, je třeba rozdělit duplicitní páry do různých systémových CUDA-výzev. V CUDA jakákoliv operace s voláním jádra vždy skončí před dalším voláním jádra (alespoň uvnitř jednoho vlákna. V různých vláknech se jádra vykonávají paralelně). Pokud ve výše uvedeném příkladu zavoláte jedno jádro s A/0 B/1 A/2 C/3, a druhé s A/4, pak klíč A dostane hodnotu 4.
Nyní si promluvme o tom, zda by funkce lookup() a delete() měly používat prostý (plain) nebo proměnný (volatile) ukazatel na pole párů v hash tabulce. Tvrdí, že:
Komilátor může podle svého uvážení optimalizovat operace čtení a zápisu do globální nebo sdílené paměti … Tyto optimalizace lze deaktivovat pomocí klíčového slova
volatile: … jakýkoliv odkaz na tuto proměnnou se kompiluje do skutečné instrukce čtení nebo zápisu do paměti.
Úvahy o správnosti nevyžadují používání volatile. Pokud vlákno vykonává instrukci používající zakotvenou hodnotu z předchozí operace čtení, znamená to, že použije trochu zastaralé informace. Ale i tak jsou to informace z platného stavu hash tabulky v určitém okamžiku volání jádra. Pokud potřebujete použít ty nejnovější informace, můžete použít ukazatel volatile, ale pak se trochu sníží výkon: podle mých testů – při odstraňování 32 milionů prvků se rychlost snížila z 500 milionů odstraňování/s po 450 milionů odstraňování/s.
Výkon
V testu na vložení 64 milionů prvků a odstranění 32 milionů z nich konkurence mezi std::unordered_map a hash tabulkou pro GPU prakticky neexistuje:
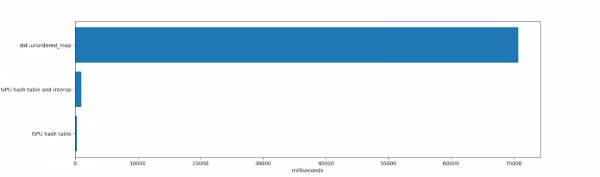
std::unordered_map strávila 70 691 ms na vložení a odstranění prvků s následným uvolněním unordered_map (uvolnění milionů prvků trvá nějaký čas, protože uvnitř unordered_map probíhá množství alokací paměti). Upřímně, u std:unordered_map úplně jiná omezení. Je to jediný CPU-výkonový proud, který podporuje klíče-hodnoty libovolné velikosti, dobře funguje při vysokých využitích a vykazuje stabilní výkon po mnoha smazáních.
Délka provozu hash tabulky pro GPU a meziprogramovou interakci činila 984 ms. To zahrnuje čas strávený umístěním tabulky do paměti a jejím smazáním (jednorázové vyčlenění 1 GB paměti, které v CUDA zabere nějaký čas), vkládáním a mazáním prvků, stejně jako iterací přes ně. Také byla zohledněna všechna kopírování do paměti a z paměti grafické karty.
Práce samotné hash tabulky trvala 271 ms. To zahrnuje čas strávený grafickou kartou na vkládání a mazání prvků, a nepočítá čas na kopírování do paměti a iteraci přes vzniklou tabulku. Pokud hash tabulka žije dlouho, nebo pokud je hash tabulka celá v paměti grafické karty (například pro vytvoření hash tabulky, která bude použita jiným GPU-kódem a ne centrálním procesorem), pak je výsledek testování relevantní.
Hash tabulka pro grafickou kartu vykazuje vysoký výkon díky velké propustnosti a aktivnímu paralelismu.
Nevýhody
Architektura hash tabulky má několik problémů, na které je třeba si dávat pozor:
- Linární znečištění narušuje klastrování, což způsobuje, že klíče v tabulce nejsou umístěny zdaleka ideálně.
- Klíče nejsou odstraňovány pomocí funkce
odstranita v průběhu času zaplňují tabulku.
V důsledku toho může výkon hash tabulky postupně klesat, zejména pokud existuje dlouho a provádí se v ní mnoho vkládání a mazání. Jedním ze způsobů, jak zmírnit tyto nedostatky, je znovu hashování do nové tabulky s dostatečně nízkou mírou využití a filtrování odstraněných klíčů při znovu hashování.
Abych ilustroval popsané problémy, použiji výše uvedený kód k vytvoření tabulky s 128 miliony prvků, cyklicky budu vkládat 4 miliony prvků, dokud nevyplním 124 milionů slotů (míra využití přibližně 0,96). Zde je tabulka výsledků, každý řádek je volání jádra CUDA s vložením 4 milionů nových prvků do jedné hash tabulky:
Míra využití
Doba vkládání 4 194 304 prvků
0,00
11,608448 ms (361,314798 miliónů klíčů/s)
0,03
11,751424 ms (356,918799 miliónů klíčů/s)
0,06
11,942592 ms (351,205515 miliónů klíčů/s)
0,09
12,081120 ms (347,178429 miliónů klíčů/s)
0,12
12,242560 ms (342,600233 miliónů klíčů/s)
0,16
12,396448 ms (338,347235 miliónů klíčů/s)
0,19
12,533024 ms (334,660176 miliónů klíčů/s)
0,22
12,703328 ms (330,173626 miliónů klíčů/s)
0,25
12,884512 ms (325,530693 miliónů klíčů/s)
0,28
13,033472 ms (321,810182 miliónů klíčů/s)
0,31
13,239296 ms (316,807174 miliónů klíčů/s)
0,34
13,392448 ms (313,184256 miliónů klíčů/s)
0,37
13,624000 ms (307,861434 miliónů klíčů/s)
0,41
13,875520 ms (302,280855 miliónů klíčů/s)
0,44
14,126528 ms (296,909756 miliónů klíčů/s)
0,47
14,399328 ms (291,284699 miliónů klíčů/s)
0,50
14,690304 ms (285,515123 miliónů klíčů/s)
0,53
15,039136 ms (278,892623 miliónů klíčů/s)
0,56
15,478656 ms (270,973402 miliónů klíčů/s)
0,59
15,985664 ms (262,379092 miliónů klíčů/s)
0,62
16,668673 ms (251,627968 miliónů klíčů/s)
0,66
17,587200 ms (238,486174 miliónů klíčů/s)
0,69
18,690048 ms (224,413765 miliónů klíčů/s)
0,72
20,278816 ms (206,831789 miliónů klíčů/s)
0,75
22,545408 ms (186,038058 miliónů klíčů/s)
0,78
26,053312 ms (160,989275 miliónů klíčů/s)
0,81
31,895008 ms (131,503463 miliónů klíčů/s)
0,84
42,103294 ms (99,619378 miliónů klíčů/s)
0,87
61,849056 ms (67,815164 miliónů klíčů/s)
0,90
105,695999 ms (39,682713 miliónů klíčů/s)
0,94
240,204636 ms (17,461378 miliónů klíčů/s)
Jak se zvyšuje koeficient využití, výkon klesá. To je nežádoucí ve většině případů. Pokud aplikace vkládá položky do tabulky a poté je vyřazuje (např. při počítání slov v knize), není to problém. Ale pokud aplikace používá dlouhodobou hash tabulku (např. v grafickém editoru k ukládání neprázdných částí obrazů, když uživatel často vkládá a maže informace), může to způsobit potíže.
A změřil jsem hloubku sondování hash tabulky po 64 milionech vložení (koeficient využití 0,5). Průměrná hloubka byla 0,4774, takže většina klíčů se nacházela buď v nejlepších možných slotů, nebo v jednom slotu od nejlepší pozice. Maximální hloubka sondování byla 60.
Pak jsem změřil hloubku sondování v tabulce s 124 miliony vložení (koeficient využití 0,97). Průměrná hloubka již činila 10,1757, a maximální — 6474 (!!). Výkon lineárního sondování výrazně klesá při vysokých koeficientech využití.
Nejlépe je u této hash tabulky udržovat nízký koeficient využití. Ale pak zvyšujeme výkon na úkor spotřeby paměti. Naštěstí, v případě 32bitových klíčů a hodnot, to může být odůvodněno. Pokud bychom v uvedeném příkladu udrželi koeficient využití 0,25 na tabulce se 128 miliony prvků, mohli bychom do ní umístit maximálně 32 milionů prvků, zatímco zbývajících 96 milionů slotů by bylo ztraceno — 8 bytů na každý pár, což znamená 768 MB ztracené paměti.
Všimněte si, že mluvíme o ztrátě paměti grafické karty, která je cennějším zdrojem než systémová paměť. I když většina moderních desktopových grafických karet podporujících CUDA má alespoň 4 GB paměti (v době psaní tohoto článku má NVIDIA 2080 Ti 11 GB), přesto by nebylo moudré takto velké objemy ztrácet.
Později se podrobněji zmíním o vytváření hash tabulek pro grafické karty, které nemají problémy s hloubkou prohledávání, a o metodách opětovného využití odstraněných slotů.
Měření hloubky prohledávání
Pro určení hloubky prohledávání klíče můžeme extrahovat hash klíče (jeho ideální index v tabulce) z jeho skutečného indexu v tabulce:
// get_key_index() -> index of key in hash table
uint32_t probelength = (get_key_index(key) - hash(key)) & (hashtablecapacity-1);
Díky magii dvou binárních čísel v doplňkovém kódu a skutečnosti, že kapacita hash tabulky je mocninou dvou, bude tento přístup fungovat i tehdy, když je index klíče přesunut na začátek tabulky. Představme si klíč, který se hashuje na 1, ale je vložen do slotu 3. Pak pro tabulku s kapacitou 4 dostaneme (3 — 1) & 3, což se rovná 2.
Závěr
Pokud máte otázky nebo poznámky, napište mi na nebo otevřete nové téma v.
Tento kód byl napsán pod vlivem skvělých článků:
V budoucnu se budu nadále zabývat implementacemi hash tabulek pro grafické karty a analyzovat jejich výkon. Plánuju řetězové spojování, Robin Hood hashing a cuckoo hashing s využitím atomových operací ve strukturách dat, které jsou vhodné pro grafické karty.
Zdroj: habr.com
