

Kanárka je malý pták, který neustále zpívá. Tito ptáci jsou citliví na metan a oxid uhelnatý. I při malých koncentracích nadbytečných plynů ve vzduchu ztrácejí vědomí nebo umírají. Zlatokopové a horníci brali ptáky s sebou do dolů: dokud kanárky zpívají, lze pracovat; když zmlknou — v dole je plyn a je čas odejít. Horníci obětovali malé ptáčky, aby vycházeli z dolů živí.
Podobná praxe se uplatnila i v IT. Například při standardním nasazení nové verze služby nebo aplikace na produkci s předchozím testováním. Testovací prostředí může být příliš drahé, automatizované testy nepokrývají všechno, co by si člověk přál, a netestování a obětování kvality je riskantní. Právě v takových případech pomáhá přístup Canary Deployment, kdy se na novou verzi pouští malé množství skutečného produkčního provozu. Tento přístup pomáhá bezpečně ověřit novou verzi na produkci, obětováním málo pro velký cíl. Podrobnosti o tom, jak tento přístup funguje, jak je užitečný a jak jej realizovat, prozradí Andrej Markelov (), na příkladu realizace ve společnosti Infobip.
Andrej Markelov — vedoucí inženýr v Infobip, 11 let se zabývá vývojem aplikací v Javě v oblasti financí a telekomunikací. Vyvíjí produkty Open Source, aktivně se podílí na Atlassian Community a píše pluginy pro produkty Atlassian. Evangelista Prometheus, Docker a Redis.
O společnosti Infobip
To je globální telekomunikační platforma, která umožňuje bankám, maloobchodníkům, internetovým obchodům a dopravním společnostem posílat zprávy svým zákazníkům prostřednictvím SMS, push notifikací, e-mailů a hlasových zpráv. V takovém byznysu je důležitá stabilita a spolehlivost, aby zákazníci dostávali zprávy včas.
IT infrastruktura Infobip v číslech:
- 15 datových center po celém světě;
- 500 unikátních služeb v provozu;
- 2500 instancí služeb, což je mnohem více než týmů;
- 4,5 TB měsíčního provozu;
- 4,5 miliardy telefonních čísel;
Byznys roste, a s ním i počet releasů. Provádíme přibližně 60 releasů denně, protože klienti chtějí více možností a výkonu. Ale je to obtížné — služeb je hodně a týmů málo. Musíme rychle psát kód, který musí fungovat na produkci bez chyb.
Verze
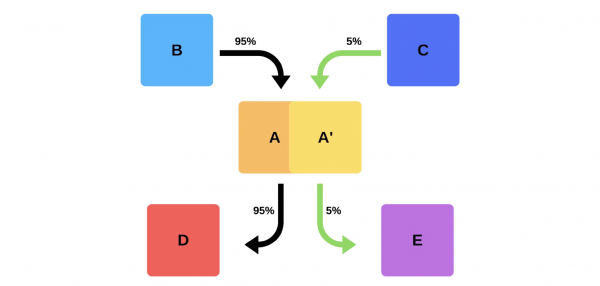
Typická verze u nás probíhá takto. Například existují služby A, B, C, D a E, z nichž každou vyvíjí jiný tým.
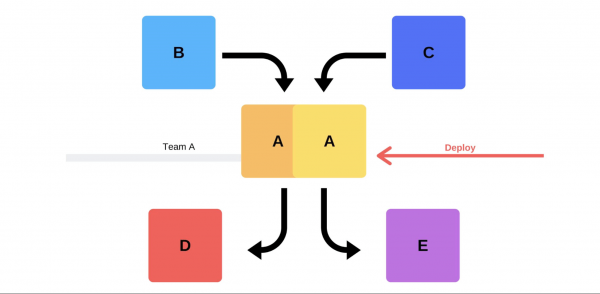
V jistém okamžiku se tým služby A rozhodne nasadit novou verzi, ale týmy služeb B, C, D a E o tom nemají tušení. Tým služby A má dvě možnosti, jak postupovat.
Provede inkrementální vydání: nejprve nahradí jednu verzi a poté druhou.
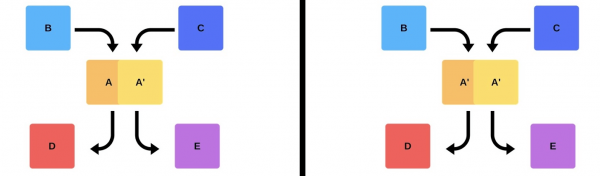
Existuje však druhá možnost: tým najde další zdroje a stroje, nasadí novou verzi a pak přepne router, což způsobí, že verze začne fungovat v produkci.
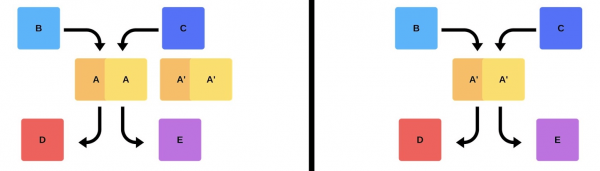
V obou případech se po nasazení téměř vždy vyskytnou problémy, i když byla verze otestována. Testovat lze ručně, automatizovaně, nebo testování vynechat — problémy se dostaví v každém případě. Nejjednodušší a správný způsob, jak je vyřešit, je vrátit se zpět k funkční verzi. Až poté se lze zabývat škodami, jejich příčinami a opravou.
Takže, co chceme?
Problémy nepotřebujeme. Pokud je klienti odhalí dříve než my, poškodí to naši pověst. Proto musíme najít problémy rychleji než klienti.Prací s předstihem minimalizujeme škody.
Zároveň chceme urychlit nasazení, aby probíhalo rychle, snadno, přirozeně a bez napětí ze strany týmu. Inženýry, DevOps inženýry a programátory je třeba šetřit — vydání nové verze je stres. Tým není spotřební materiál, snažíme se rázujně využívat lidské zdroje..
Problémy s nasazením
Klientský provoz je nepředvídatelný.Není možné předpovědět, kdy bude klientský provoz minimální. Nevíme, kde a kdy klienti zahájí své kampaně — možná dnes v noci v Indii a zítra v Hongkongu. Vzhledem k velkému časovému rozdílu nepřesahuje nasazení ani ve 2 hodiny v noci záruku, že klienti nebudou trpět.
Problémy poskytovatelů.Messengery a poskytovatelé jsou naši partneři. Někdy mají výpadky, které způsobují chyby během nasazení nových verzí.
Rozdělené týmy.Týmy, které vyvíjejí klientskou část a backend, se nacházejí v různých časových pásmech. Z tohoto důvodu často nemohou dosáhnout dohody.
Datacentra nelze zopakovat na stagi.V jednom datacentru je 200 stojanů — zopakovat to v pískovišti ani přibližně není možné.
Nepřetržité výpadkyjsou nepřijatelné! Máme akceptovatelnou úroveň dostupnosti (Error Budget), při které pracujeme 99,99 % času, a zbytek procenta představuje "právo na chybu". Dosáhnout 100% spolehlivosti není možné, ale je důležité neustále monitorovat pády a výpadky.
Klasické možnosti řešení
Psát kód bez chyb. Když jsem byl mladým vývojářem, manažeři často přicházeli s požadavkem na vydání bez chyb, ale to není vždy možné.
Psát testy. Testy fungují, ale někdy ne zcela podle očekávání byznysu. Získávání peněz není úkol testů.
Testovat na stagingu. Během 3,5 let mé práce v Infobip jsem nikdy neviděl, aby stav stagingu alespoň částečně odpovídal produkci.
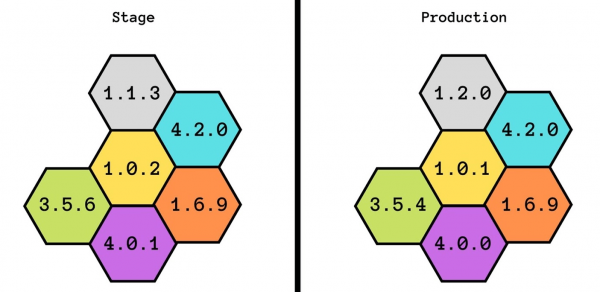
Ihned jsme se pokusili tuto myšlenku rozvinout: nejprve jsme měli staging, poté preprodukci a nakonec preproduci preprodukce. Ale ani to nepomohlo – ani výkonem si nebyly podobné. Se stagingem můžeme zaručit základní funkcionalitu, ale nevíme, jak to bude fungovat pod zatížením.
Vydání provádí ten, kdo vyvíjel. To je dobrá praxe: i když někdo změní název komentáře, ihned to nasazuje do produkce. Pomáhá to rozvíjet odpovědnost a nezapomínat na provedené změny.
Existují také další komplikace. Pro vývojáře je stresující trávit spoustu času tím, že vše kontroluje ručně.
Dohodnuté vydání. Tento přístup obvykle navrhuje vedení: "Dohodněme se, že každý den budete testovat a přidávat nové verze." To nefunguje: vždy existuje tým, který čeká na ostatní, nebo naopak.
Smoke testy
Další způsob, jak vyřešit naše problémy s nasazením. Podívejme se, jak fungují smoke testy na předchozím příkladu, kdy tým A chce nasadit novou verzi.
Nejprve tým nasazuje jeden instance do produkce. Zprávami v instanci od mocků simulujeme skutečný provoz, aby odpovídal normálním každodenním tokům. Pokud je všechno v pořádku, tým přepne novou verzi na uživatelský provoz.
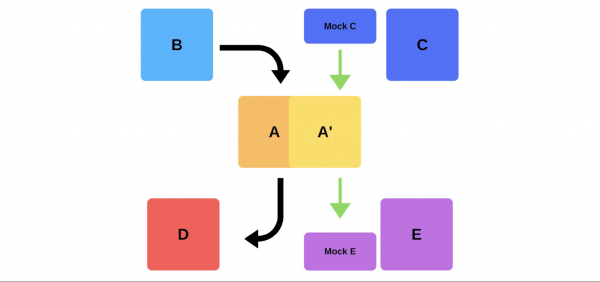
Druhá možnost – nasadit s dodatečným hardwarovým vybavením. Tým ho testuje na produkci, poté přepíná, a všechno funguje.
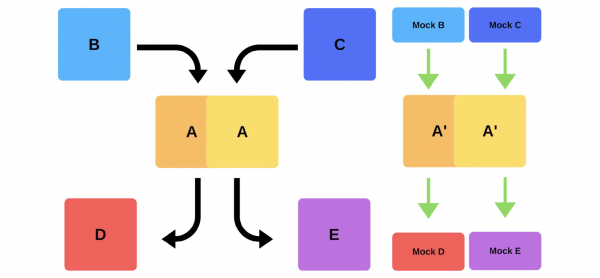
Nevýhody smoke testů:
- Testům nelze důvěřovat. Kde vzít stejný provoz jako na produkci? Můžete použít včerejší nebo týden starý, ale nemusí vždy odpovídat aktuálnímu.
- Těžko se udržuje. Budete muset udržovat testovací účty, pokaždé je resetovat před každým nasazením, když do úložiště odcházejí aktivní záznamy. To je složitější než napsat test ve své pískovně.
Jediný bonus tady — můžete zkontrolovat výkon.
Canary releasy
Kvůli nedostatkům smoke testů jsme začali používat canary releasy.
Praxe podobná tomu, jak horníci používali kanárky ke signalizaci úrovně plynů, našla své místo i v IT. Pouštíme trochu skutečného produkčního provozu na novou verzi, přičemž se snažíme dodržet Service Level Agreement (SLA). SLA je naše "právo na chybu", které můžeme využít jednou ročně (nebo během jiného časového intervalu). Pokud všechno bude v pořádku, přidáme více provozu. Pokud ne — vrátíme předchozí verze.
Realizace a detaily
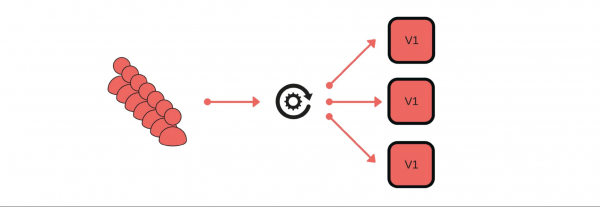
Jak jsme realizovali canary releasy? Například skupina klientů posílá zprávy prostřednictvím našeho servisu.
Nasazení probíhá takto: odebereme jeden uzel z vyvážiče zatížení (1), změníme verzi (2) a zvlášť pustíme trochu provozu (3).
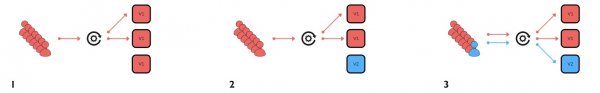
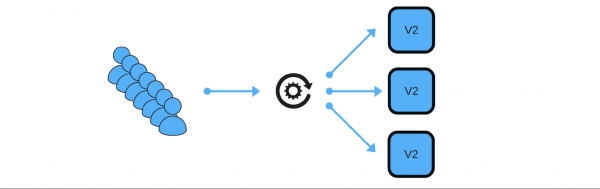
Celkově bude ve skupině všem dobře, i když jeden uživatel nebude spokojen. Pokud je vše v pořádku — změníme všechny verze.
Ukážu schematicky, jak to vypadá pro mikroservisy ve většině případů.
Existuje Service Discovery a další dva služby: S1N1 a S2. První služba (S1N1) informuje Service Discovery, když se spustí, a Service Discovery si ji pamatuje. Druhá služba se dvěma uzly (S2N1 a S2N2) také informuje Service Discovery při spuštění.
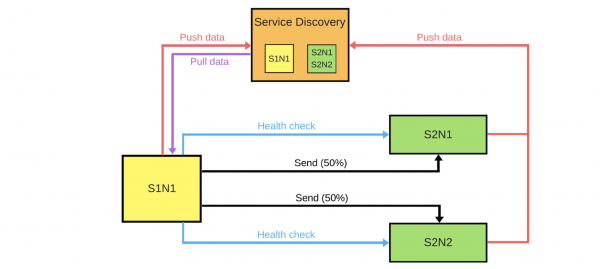
Druhá služba pro první funguje jako server. První si u Service Discovery vyžádá informace o svých serverech, a když je dostane — hledá a kontroluje je ("health check"). Když zkontroluje, odešle jim zprávy.
Když někdo chce nasadit novou verzi druhé služby, informuje Service Discovery, že druhý uzel bude canary uzlem: na něj bude posíláno méně provozu, protože právě proběhne nasazení. Odebereme canary uzel z vyvážiče zatížení a první služba mu neposílá provoz.
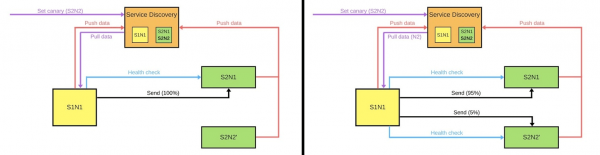
Měníme verzi a Service Discovery ví, že druhý uzel je nyní canary – můžeme mu dát menší zátěž (5%). Pokud je vše v pořádku, změníme verzi, vrátíme zátěž a pokračujeme dál.
Abychom to všechno realizovali, potřebujeme:
- vyvážení;
- monitoring, protože je důležité vědět, co očekává každý uživatel, a jak podrobně naše služby fungují;
- analýzu verzí, abychom pochopili, jak dobře nová verze bude fungovat v produkci;
- automatizace – píšeme sekvenci nasazení (deployment pipeline).
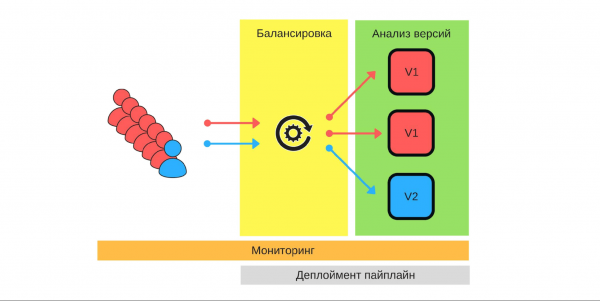
Vyvážení
To je první věc, nad kterou bychom se měli zamyslet. Existují dvě strategie vyvážení.
Nejjednodušší varianta je, když jeden uzel je vždy canary. Tento uzel vždy dostává méně provozu a začínáme nasazení s ním. V případě problémů porovnáme jeho výkon před nasazením a během něj. Například, pokud se chyby zdvojnásobily, znamená to, že i škody vzrostly dvojnásobně.
Canary uzel je určen během nasazení. Jakmile je nasazení dokončeno a odebereme z něj status canary uzlu, rovnováha provozu se obnoví. S menším počtem strojů dosáhneme spravedlivého rozdělení.
Monitoring
Základní kámen canary releasů. Musíme přesně chápat, proč to děláme a jaké metriky chceme sbírat.
Příklady metrik, které sbíráme z našich služeb.
- Počet chyb, které se zapisují do logů. To je zřejmý ukazatel, že vše funguje jak má. Obecně, je to dobrá metrika.
- Doba vyřízení požadavků (latence). Tuto metriku monitorují všichni, protože všichni chtějí pracovat rychle.
- Velikost fronty (procvakání).
- Počet úspěšných odpovědí za sekundu.
- Doba vyřízení 95% všech požadavků.
- Obchodní metriky: kolik peněz podnik vydělává za určité období nebo odliv uživatelů. Tyto metriky pro naši novou verzi mohou být důležitější než ty, které přidávají inženýři.
Příklady metrik ve většině populárních monitorovacích systémů.
Counter. To je určité rostoucí množství, například počet chyb. Tuto metriku je snadné interpolovat a studovat graf: včera byly 2 chyby, dnes je to 500, takže se něco nepovedlo.
Počet chyb za minutu nebo za sekundu, je to klíčový ukazatel, který lze vypočítat pomocí Counter. Tato data poskytují jasný přehled o výkonu systému na dálku. Zvažme na příkladu grafu počtu chyb za sekundu pro dvě verze produkčního systému.
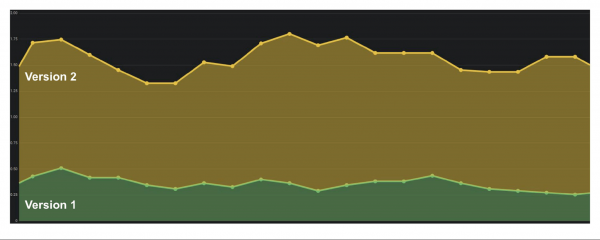
V první verzi bylo málo chyb, možná nefungoval audit. Ve druhé verzi je to mnohem horší. S jistotou můžeme říct, že existují problémy, a proto musíme tuto verzi vrátit.
Měřítko. Metričky jsou podobné jako Counter, ale zaznamenáváme hodnoty, které mohou jak růst, tak klesat. Například doba trvání dotazů nebo velikost fronty.
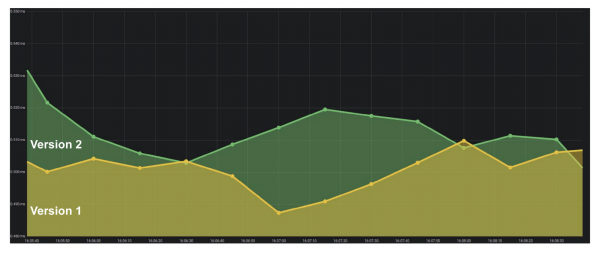
Na grafu je příklad doby odezvy (latency). Z grafu je vidět, že verze jsou podobné, dají se používat. Ale při bližším pohledu je zřejmé, jak se velikost mění. Pokud doba trvání dotazů roste se zvyšujícím se počtem uživatelů, je okamžitě jasné, že jsou problémy — takhle to dříve nebylo.
Shrnutí. Jedním z nejdůležitějších ukazatelů pro podnikání jsou percentily. Metrička ukazuje, že v 95% případů naše systém funguje tak, jak chceme. Můžeme se smířit, pokud někde jsou problémy, protože chápeme celkový trend, jak dobře nebo špatně to jde.
Nástroje
ELK Stack. Realizovat canary se dá za použití Elasticsearch — zaznamenáváme do něj chyby, když dochází k událostem. Nejjednodušším voláním API můžeme získat počet chyb v libovolném okamžiku a porovnat s minulými úseky: GET /applg/_cunt?q=level:errr.
Prometheus. Dobrý výkon měl v Infobip. Umožňuje realizovat vícerozměrné metriky, protože se používají štítky.
Můžeme použít úroveň, instance, service, kombinovat je v jednom systému. Pomocí offset můžeme zjistit, například, hodnotu veličiny před týdnem pouze jedním příkazem GET /api/v1/query?query={query}, kde {query}:
rate(logback_appender_total{
    level="error",
    instance=~"$instance"
}[5m] offset $offset_value)
Analýza verzí
Existuje několik strategií analýzy verzí.
Sledovat metriky pouze canary-nody. Jedna z nejjednodušších variant: nasadili jsme novou verzi a studujeme pouze její výkon. Ale pokud inženýr v této době začne studovat logy a neustále nervózně obnovuje stránky, pak je toto řešení ve své podstatě stejné jako ostatní.
Canary-noda se porovnává s jakoukoli jinou nodou. Toto porovnání s jinými instancemi, které fungují na plném provozu. Například pokud je s malým provozem situace horší nebo ne lepší než na skutečných instancích, pak je něco špatně.
Canary-noda se porovnává sama se sebou v minulosti. Uzly vyhrazené pro canary lze porovnat s historickými daty. Například, pokud bylo před týdnem vše v pořádku, můžeme se na tato data spolehnout, abychom pochopili aktuální situaci.
Automatizace
Chceme osvobodit inženýry od ručního porovnávání, a proto je důležité realizovat automatizaci. Proces nasazení (deployment pipeline) obvykle vypadá takto:
- zahájíme;
- odstraníme uzel z load balanceru;
- nainstalujeme canary uzel;
- zapneme load balancer s omezeným množstvím provozu;
- porovnáme.
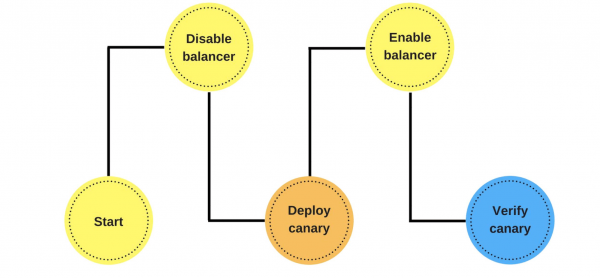
V této fázi realizujeme automatické porovnání. Jak může vypadat a proč je lepší než kontrola po nasazení, si ukážeme na příkladu z Jenkins.
Toto je pipeline v Groovy.
while (System.currentTimeMillis() < endCanaryTs) {
    def isOk = compare(srv, canary, time, base, offset, metrics)
    if (isOk) {
        sleep DEFAULT SLEEP
    }   else {
        echo "Canary selhalo, je třeba vrátit zpět"
        return false
    }
}
Zde v cyklu určujeme, že budeme porovnávat nový uzel po dobu jedné hodiny. Pokud proces canary ještě nebyl dokončen — voláme funkci. Ta oznamuje, zda je vše v pořádku nebo ne: def isOk = compare(srv, canary, time, base, offset, metrics).
Pokud je vše v pořádku — sleep DEFAULT SLEEP, například na sekundu, a pokračujeme. Pokud ne, vystoupíme — nasazení se nezdařilo.
Popis metriky. Podívejme se, jak by mohla vypadat funkce compare na příkladu DSL.
metric(
    'errorCounts',
    'rate(errorCounts{node=~"$canaryInst"}[5m] offset $offset)',
    {   baseValue, canaryValue ->
        if (canaryValue > baseValue * 1.3) return false
        return true
    }
)
Předpokládejme, že porovnáváme počet chyb a chceme zjistit počet chyb za sekundu za posledních 5 minut.
Máme dvě hodnoty: základní a canary uzel. Hodnota canary uzlu — aktuální. Základní — baseValue — to je hodnota jakéhokoliv jiného než canary uzlu. Porovnáváme hodnoty mezi sebou podle vzorce, který stanovujeme na základě svých zkušeností a pozorování. Pokud je hodnota canaryValue špatná, nasazení se nezdařilo a vracíme se zpět.
Proč je to všechno potřeba?
Člověk nemůže zkontrolovat stovky a tisíce metrik, tím spíše to udělat rychle. Automatické porovnání pomáhá zkontrolovat všechny metriky a rychle varuje o problémech. Čas varování je rozhodující: pokud se něco stalo za poslední 2 sekundy, pak škoda nebude tak velká, jako by se to stalo před 15 minutami. Zatímco si někdo všimne problému, napíše na podporu, a podpora nám, aby se vrátila zpět, můžeme ztratit klienty.
Pokud proces proběhl a vše je v pořádku, automaticky nasazujeme všechny ostatní uzly. Během této doby inženýři nic nedělají. Teprve když spustí canary, rozhodují, které metriky vzít, jak dlouho provádět srovnání a jakou strategii použít.
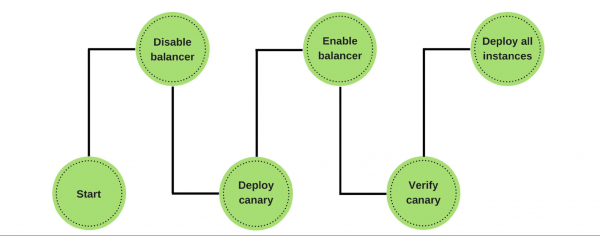
Pokud nastaly problémy — automaticky vracíme canary-uzel, pracujeme s předchozími verzemi a opravujeme chyby, které jsme našli. U metrik je snadné je najít a vidět poškození z nové verze.
Překážky
Realizovat to samozřejmě není snadné. Především je potřeba společný monitorovací systém. Inženýři mají své metriky, podpora a analytici mají jiné, a byznys třetí. Společný systém je společným jazykem, kterým hovoří byznys a vývoj.
Je třeba ověřit v praxi stabilitu metrik. Ověření pomáhá pochopit, jaký minimální soubor metrik potřebujeme pro zajištění kvality.
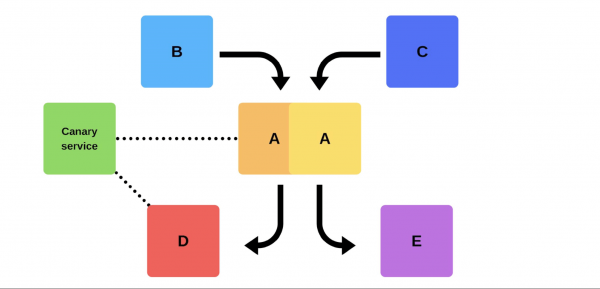
Jak toho dosáhnout? Použít canary-službu nikoli v okamžiku nasazení. Přidáme na staré verzi nějakou službu, která kdykoli bude schopná vzít jakýkoli vyčleněný uzel, snížit provoz bez nasazení. Poté srovnáváme: studujeme chyby a hledáme tu hranici, kdy dosahujeme kvality.
Jaký přínos jsme získali z canary-releasů
Minimalizovali jsme procento poškození z chyb. Většina chyb při nasazení nastává kvůli nesouladu některých dat nebo prioritě. Takových chyb bylo mnohem méně, protože můžeme problém vyřešit v prvních sekundách.
Optimalizovali jsme práci týmů. Nováčci mají "právo na chybu": mohou nasazovat do produkce bez strachu udělat chybu, což přináší další iniciativu a motivaci pracovat. Pokud něco pokazí, nebude to kritické a chybný nebude propuštěn.
Automatizovali jsme nasazení. Nyní to již není ruční proces jako dříve, ale skutečně automatizovaný. Ale trvá to déle.
Vyčlenili jsme důležité metriky. Celá společnost, počínaje byznysem a inženýry, chápe, co je v našem produktu skutečně důležité, jaké metriky, například odliv a příliv uživatelů. Kontrolujeme proces: testujeme metriky, zavádíme nové, sledujeme, jak fungují staré, abychom vytvořili systém, který bude efektivněji generovat zisk.
Máme spoustu skvělých praktik a systémů, které nám pomáhají. I přesto usilujeme o to být profesionály a vykonávat svou práci kvalitně, bez ohledu na to, zda máme systém, který nám pomůže, nebo ne.
Inženýrské přístupy a praktiky — . Pokud jste dosáhli úspěchů na cestě k technické dokonalosti a jste připraveni říct, co vám v tom pomohlo, — .
Plánujeme uspořádat 8. června. Chápeme, že nyní je obtížné rozhodnout se o účasti na konferenci. Ale zároveň považujeme karanténu za důvod, který nepřerušuje profesionální komunikaci a rozvoj. Proto v každém případě najdeme způsob, jak projednat úkoly technického leadra a přístupy k jejich řešení — pokud bude potřeba, přesuneme se do online formátu a rozvineme networking tam!
Zdroj: habr.com
