

Tato poznámka bude zajímavá pro ty, kteří používají knihovnu pro zpracování tabulkových dat pro R — data.table, a možná se potěší vidět flexibilitu jejího použití na různých příkladech.
Inspirován dobrým příkladem , a doufám, že jste již přečetli jeho článek, navrhuji se hlouběji zaměřit na optimalizaci kódu a výkon na základě data.table.
Úvod: odkud data.table pochází?
Nejlépe je začít seznámení s knihovnou o něco zdaleka, a to od datových struktur, ze kterých může být získán objekt data.table (dále DT).
Pole
Kód
## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)
Jednou z takových struktur je pole (?base::array). Stejně jako v jiných jazycích jsou pole vícerozměrná. Zajímavé je, že například dvourozměrné pole začíná zdědit vlastnosti od třídy matice (?base::matrix), a jednorozměrné pole, což je také důležité, nezdědí od vektoru (?base::vector).
Přitom je třeba chápat, že typ dat obsažených v jakémkoli objektu by měl být kontrolován funkcí base::typeof, která vrací vnitřní popis typu podle R Internals — obecným protokolem jazyka, spojeným s primárními C.
Další příkaz pro určení třídy objektu, base::class, vrací v případě vektorů vektorový typ (ten se název liší od vnitřního, ale také umožňuje pochopit typ dat).
Seznam
Z dvourozměrného pole, tedy matice, lze přejít na seznam (?base::list).
Kód
## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)
Přitom se děje několik věcí najednou:
- Druhé rozměry matice se smrsknou, což znamená, že dostáváme současně jak seznam, tak vektor.
- Seznam tak zdědí z těchto tříd. Je třeba mít na paměti, že prvku seznamu bude odpovídat jedna (skalární) hodnota z buňky matice-pole.
Díky tomu, že seznam je také vektor, lze na něj aplikovat některé funkce pro vektory.
Dataframe
Z seznamu, matice nebo vektoru lze přejít na dataframe (?base::data.frame).
Kód
## data.frames ------------

df <- as.data.frame(arrmatr)
df2 <- as.data.frame(mylist)

is.list(df)

df$V6 <- df$V1 + df$V2
Co je na něm zajímavé: dataframe zdědí od seznamu! Sloupce dataframe jsou buňky seznamu. To bude důležité v budoucnu, když budeme používat funkce aplikované na seznamy.
data.table
Získat DT (?data.table::data.table) lze z dataframe, seznamu, vektoru nebo matice. Například takto (in place).
Kód
## data.tables -----------------------
library(data.table)

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)
Užitečné je, že, stejně jako dataframe, DT zdědí vlastnosti seznamu.
DT a paměť
Na rozdíl od všech ostatních objektů v R base se datové tabulky předávají odkazem. Pokud je potřeba provést kopii do nové oblasti paměti, je potřeba funkce data.table::copy nebo je potřeba provést výběr ze starého objektu.
Kód
df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)
Tímto se úvod blíží ke konci. Datové tabulky představují pokračování vývoje datových struktur v R, které převážně probíhá prostřednictvím rozšíření a zrychlení operací prováděných nad objekty třídy data.frame. Přitom zůstává dědictví od jiných primitivů.
Některé příklady použití vlastností data.table
Jako seznam…
Iterace přes řádky dataframu nebo datové tabulky není nejlepší nápad, protože kód cyklu v jazyce R je výrazně pomalejší C, ale projít cyklem přes sloupce, kterých obvykle bývá výrazně méně, je zcela možné. Při procházení sloupci pamatujme, že každý sloupec je prvek seznamu, který obvykle obsahuje vektor. A operace nad vektory jsou v základních funkcích jazyka dobře vektorované. Také lze použít výběrové operátory, které jsou charakteristické pro seznamy a vektory: `[[`, `$`.
Kód
## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))
Vektorizace
Pokud je potřeba projít řádky velké datové tabulky, nejlepším řešením bude napsání funkce s vektorizací. Ale pokud to není možné, mějte na paměti, že cyklus uvnitř datové tabulky je přesto rychlejší než cyklus v R, protože se provádí na C.
Zkusíme na větším příkladu se 100K řádky. Budeme vytahovat první písmeno ze slov, která jsou součástí vektorového sloupce. w.
Aktualizováno
Kód
library(magrittr)
library(microbenchmark)

## Větší příklad ----

rown <- 100000

dt %
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vektorizace

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# druhý

first_l_f %
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# třetí

first_l_f2 %
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})
První běh s iterací přes řádky:
Úroveň: milisekundy
expr min
{ dt[, `:=`(first_l, unlist(strsplit(w, split = " ", fixed = T))[1]), by = 1:nrow(dt)] } 439.6217
lq mean median uq max neval
451.9998 460.1593 456.2505 460.9147 621.4042 100
Druhý běh, kde vektorace probíhá prostřednictvím převodu seznamu na matici a získávání prvků na řezu s indexem 1 (to je vlastně vektorace). Omlouvám se, vektorace na úrovni funkce strsplit, která umí přijímat vektor jako vstup. Ukazuje se, že proces převodu seznamu na matici je mnohem náročnější než samotná vektorace, ale i v tomto případě je to mnohem rychlejší než nevykonaná varianta.
Úroveň: milisekundy
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f(w)))] } 93.07916 112.1381 161.9267 149.6863 185.9893 442.5199 100
Zrychlení podle mediánu v 3krát.
Třetí běh, kde byla změněna schéma převodu na matici.
Úroveň: milisekundy
expr min lq mean median uq max neval
{ dt[, `:=`(first_l, .(first_l_f2(w)))] } 32.60481 34.13679 40.4544 35.57115 42.11975 222.972 100
Zrychlení podle mediánu v 13krát.
S tímto by se mělo experimentovat, čím více — tím lépe bude.
Ještě jeden příklad vektorace, kde je také text, ale přiblížený skutečným podmínkám: různé délky slov, různé počet slov. Je třeba vyzvednout první 3 slova. Takhle:
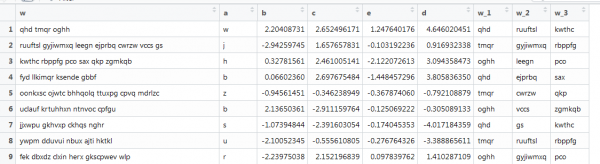
Zde už předchozí funkce nefunguje, protože vektory mají různou délku, a my jsme určovali velikost matice. Předěláme to prozkoumáním internetu.
Kód
# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]
Úroveň: milisekundy
expr min lq mean median
{ dt[, `:=`((paste0(«w_», 1:3)), strsplit(w, split = " ", fixed = T))] } 851.7623 916.071 1054.5 1035.199
uq max neval
1178.738 1356.816 100
Skript běžel průměrnou rychlostí 1 sekundu. Ne špatné.
S vařením v jedné řadě…
S objekty DT lze pracovat pomocí chaining. Vypadá to jako připojení syntaktických závorek zprava, v podstatě příjemná záležitost.
Kód
# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]
Teče potrubím…
Tyto operace lze provést také pomocí piping, vypadá to podobně, ale je funkčně bohatší, protože lze používat jakékoli metody, nikoli pouze DT. Vyvedeme koeficienty logistické regrese pro naše syntetická data s řadou filtrů na DT.
Kód
# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]
Statistika, strojové učení a další uvnitř DT
Lze použít lambda funkce, ale někdy je lepší je vytvořit zvlášť, specifikovat celý pipeline analýzy dat a vpřed — fungují uvnitř DT. Příklad byl obohacen o všechny výše zmíněné funkce, plus několik užitečných věcí z arzenálu DT (jako například odkazování na samotné DT uvnitř DT podle odkazu, který byl někdy vložen nekonzistentně, ale aby to fungovalo).
Kód
# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Závěr
Doufám, že se mi podařilo vytvořit souvislý, ale samozřejmě ne úplný, obrázek takového objektu jako je data.table, začínající od jeho vlastností spojených s dědictvím od tříd R a končící jeho vlastními funkcemi a prostředím složek tidyverse. Doufám, že vám to pomůže lépe studovat a aplikovat tuto knihovnu v práci a zábavě.
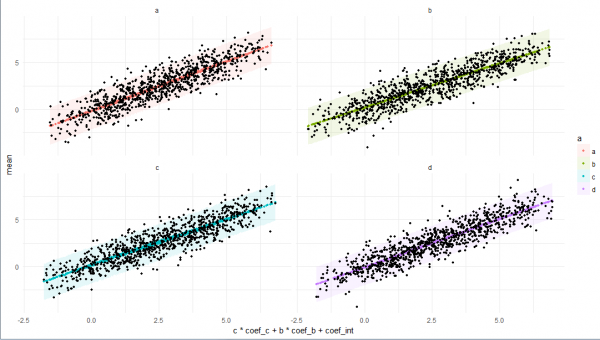
Děkuji!
Celý kód
Kód
## load libs ----------------

library(data.table)
library(ggplot2)
library(magrittr)
library(microbenchmark)


## arrays ---------

arrmatr <- array(1:20, c(4,5))

class(arrmatr)

typeof(arrmatr)

is.array(arrmatr)

is.matrix(arrmatr)


## lists ------------------

mylist <- as.list(arrmatr)

is.vector(mylist)

is.list(mylist)


## data.frames ------------

df <- as.data.frame(arrmatr)

is.list(df)

df$V6 <- df$V1 + df$V2


## data.tables -----------------------

data.table::setDT(df)

is.list(df)

is.data.frame(df)

is.data.table(df)

df2 <- df

df[V1 == 1, V2 := 999]

data.table::fsetdiff(df, df2)

df2 <- data.table::copy(df)

df[V1 == 2, V2 := 999]

data.table::fsetdiff(df, df2)


## operations on data.tables ------------

#using list properties

df$'V1'[1]

df[['V1']]

df[[1]][1]

sapply(df, class)

sapply(df, function(x) sum(is.na(x)))


## Bigger example ----

rown <- 100000

dt <-
	data.table(
		w = sapply(seq_len(rown), function(x) paste(sample(letters, 3, replace = T), collapse = ' '))
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

# vectorization

# zero - for loop

microbenchmark({
	for(i in 1:nrow(dt))
		{
		dt[
			i
			, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		]
	}
})

# first

microbenchmark({
	dt[
		, first_l := unlist(strsplit(w, split = ' ', fixed = T))[1]
		, by = 1:nrow(dt)
	   ]
})

# second

first_l_f <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		do.call(rbind, .) %>%
		`[`(,1)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f(w))
		]
})

# third

first_l_f2 <- function(sd)
{
	strsplit(sd, split = ' ', fixed = T) %>%
		unlist %>%
		matrix(nrow = 3) %>%
		`[`(1,)
}

dt[, first_l := NULL]

microbenchmark({
	dt[
		, first_l := .(first_l_f2(w))
		]
})

# fourth

rown <- 100000

words <-
	sapply(
		seq_len(rown)
		, function(x){
			nwords <- rbinom(1, 10, 0.5)
			paste(
				sapply(
					seq_len(nwords)
					, function(x){
						paste(sample(letters, rbinom(1, 10, 0.5), replace = T), collapse = '')
					}
				)
				, collapse = ' '
			)
		}
	)

dt <-
	data.table(
		w = words
		, a = sample(letters, rown, replace = T)
		, b = runif(rown, -3, 3)
		, c = runif(rown, -3, 3)
		, e = rnorm(rown)
	) %>%
	.[, d := 1 + b + c + rnorm(nrow(.))]

first_l_f3 <- function(sd, n)
{
	l <- strsplit(sd, split = ' ', fixed = T)

	maxl <- max(lengths(l))

	sapply(l, "length<-", maxl) %>%
		`[`(n,) %>%
		as.character
}

microbenchmark({
	dt[
		, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
		]
})

dt[
	, (paste0('w_', 1:3)) := lapply(1:3, function(x) first_l_f3(w, x))
	]


# chaining

res1 <- dt[a == 'a'][sample(.N, 100)]

res2 <- dt[, .N, a][, N]

res3 <- dt[, coefficients(lm(e ~ d))[1], a][, .(letter = a, coef = V1)]

# piping

samplpe_b <- dt[a %in% head(letters), sample(b, 1)]

res4 <-
	dt %>%
	.[a %in% head(letters)] %>%
	.[,
	  {
	  	dt0 <- .SD[1:100]

	  	quants <-
	  		dt0[, c] %>%
	  		quantile(seq(0.1, 1, 0.1), na.rm = T)

	  	.(q = quants)
	  }
	  , .(cond = b > samplpe_b)
	  ] %>%
	glm(
		cond ~ q -1
		, family = binomial(link = "logit")
		, data = .
	) %>%
	summary %>%
	.[[12]]


# function

rm(lm_preds)

lm_preds <- function(
	sd, by, n
)
{

	if(
		n < 100 |
		!by[['a']] %in% head(letters, 4)
	   )
	{

		res <-
			list(
				low = NA
				, mean = NA
				, high = NA
				, coefs = NA
			)

	} else {

		lmm <-
			lm(
				d ~ c + b
				, data = sd
			)

		preds <-
			stats::predict.lm(
				lmm
				, sd
				, interval = "prediction"
				)

		res <-
			list(
				low = preds[, 2]
				, mean = preds[, 1]
				, high = preds[, 3]
				, coefs = coefficients(lmm)
			)
	}

	res

}

res5 <-
	dt %>%
	.[e < 0] %>%
	.[.[, .I[b > 0]]] %>%
	.[, `:=` (
		low = as.numeric(lm_preds(.SD, .BY, .N)[[1]])
		, mean = as.numeric(lm_preds(.SD, .BY, .N)[[2]])
		, high = as.numeric(lm_preds(.SD, .BY, .N)[[3]])
		, coef_c = as.numeric(lm_preds(.SD, .BY, .N)[[4]][1])
		, coef_b = as.numeric(lm_preds(.SD, .BY, .N)[[4]][2])
		, coef_int = as.numeric(lm_preds(.SD, .BY, .N)[[4]][3])
	)
	, a
	] %>%
	.[!is.na(mean), -'e', with = F]


# plot

plo <-
	res5 %>%
	ggplot +
	facet_wrap(~ a) +
	geom_ribbon(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, ymin = low
			, ymax = high
			, fill = a
		)
		, size = 0.1
		, alpha = 0.1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = mean
			, color = a
		)
		, size = 1
	) +
	geom_point(
		aes(
			x = c * coef_c + b * coef_b + coef_int
			, y = d
		)
		, size = 1
		, color = 'black'
	) +
	theme_minimal()

print(plo)
Zdroj: habr.com
