

Jedním z běžných scénářů ve všech známých aplikacích je vyhledávání dat podle určitých kritérií a jejich zobrazení v čitelné podobě. Mohou zde být i další možnosti jako třídění, seskupování a stránkování. Úkol je na první pohled triviální, ale při jeho řešení dělá řada vývojářů chyby, které následně ovlivňují výkon. Pokusíme se prozkoumat různé varianty řešení tohoto úkolu a formulovat doporučení pro výběr nejefektivnější implementace.
Varianta stránkování #1
Nejjednodušší varianta, která mě napadne, je stránkování výsledků vyhledávání v jeho nejklasičtější podobě.
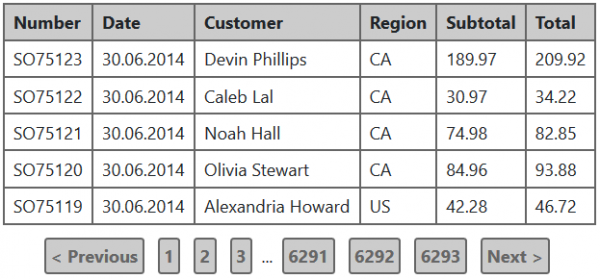
Předpokládáme, že v aplikaci se používá relační databáze. V tomto případě pro zobrazení informací v takové podobě bude potřeba provést dva SQL dotazy:
- Získat řádky pro aktuální stránku.
- Spočítat celkový počet řádků odpovídajících vyhledávacím kritériím — to je potřeba pro zobrazení stránek.
Podívejme se na první dotaz na příkladu testovací MS SQL databáze pro server 2016. Pro tento účel budeme používat tabulku Sales.SalesOrderHeader:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Výše uvedený dotaz vrátí prvních 50 objednávek ze seznamu, seřazených podle data přidání, jinými slovy — 50 posledních objednávek.
Provedený dotaz se rychle vykonává na testovací databázi, ale podívejme se na plán vykonání a statistiku vstupu a výstupu:
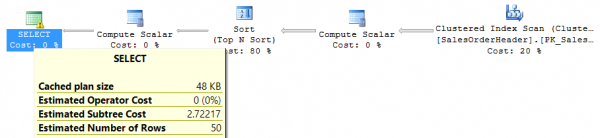
Tabulka 'SalesOrderHeader'. Počítání skenování 1, logické čtení 698, fyzické čtení 0, přečtení předem 0, logické čtení lob 0, fyzické čtení lob 0, přečtení předem lob 0.Získat statistiku vstupu/výstupu pro každý dotaz lze provedením příkazu SET STATISTICS IO ON v prostředí vykonávání dotazů.
Jak vidno z plánu vykonání, nejnáročnější je třídění všech řádků z původní tabulky podle data přidání. A problém je v tom, že čím více řádků se v tabulce objeví, tím náročnější bude třídění. V praxi by se takovému situacím mělo vyhýbat, proto přidáme index na datum přidání a podíváme se, zda se změnilo spotřebování zdrojů:
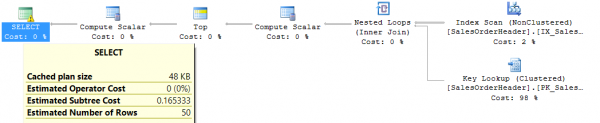
Tabulka 'SalesOrderHeader'. Počítání skenování 1, logické čtení 165, fyzické čtení 0, přečtení předem 5, logické čtení lob 0, fyzické čtení lob 0, přečtení předem lob 0.
Je zřejmé, že se to výrazně zlepšilo. Ale byly všechny problémy vyřešeny? Změňme dotaz na hledání objednávek, jejichž celková cena zboží překračuje 100 dolarů:
SELECT * FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
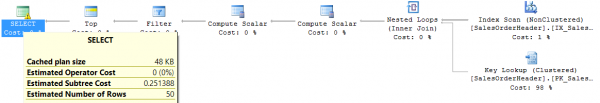
Tabulka 'SalesOrderHeader'. Počet skenování 1, logické čtení 1081, fyzické čtení 0, přečtení dopředu 0, logické čtení lob 0, fyzické čtení lob 0, přečtení dopředu lob 0.Máme legrační situaci: plán dotazu není o moc horší než ten předchozí, ale skutečný počet logických čtení je téměř dvakrát vyšší než při plném skenování tabulky. Řešení existuje — pokud z již existujícího indexu vytvoříme složený a jako druhé pole přidáme celkovou cenu zboží, opět získáme 165 logických čtení:
CREATE INDEX IX_SalesOrderHeader_OrderDate_SubTotal on Sales.SalesOrderHeader(OrderDate, SubTotal);
Tuto sérii příkladů lze ještě dlouho pokračovat, ale dvě hlavní myšlenky, které zde chci vyjádřit, jsou:
- Přidání jakéhokoli nového kritéria nebo pořadí řazení do vyhledávacího dotazu může mít zásadní vliv na rychlost jeho vykonání.
- Ale pokud potřebujeme načíst pouze část dat a ne všechny výsledky splňující podmínky vyhledávání — existuje mnoho způsobů, jak takový dotaz optimalizovat.
Nyní se přesuneme k druhému dotazu, zmíněnému na samém začátku — k tomu, který počítá počet záznamů, které splňují vyhledávací kritérium. Vezměme stejný příklad — hledání objednávek, které stojí více než 100 dolarů:
SELECT COUNT(1) FROM Sales.SalesOrderHeader
WHERE SubTotal > 100
Při existenci složeného indexu, uvedeného výše, získáme:
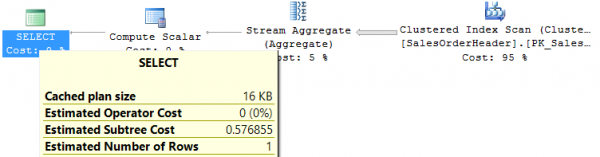
Tabulka 'SalesOrderHeader'. Počítání skenování 1, logické čtení 698, fyzické čtení 0, přečtení předem 0, logické čtení lob 0, fyzické čtení lob 0, přečtení předem lob 0.To, že dotaz prochází celým indexem, není překvapující, protože pole SubTotal není na první pozici, a proto dotaz nemůže toho využít. Problém se řeší přidáním dalšího indexu na pole SubTotal, a nakonec dává pouze 48 logických čtení.
Můžeme uvést ještě několik příkladů dotazů na počítání, ale podstata zůstane stejná: načtení porce dat a výpočet celkového počtu — to jsou dva zásadně odlišné dotazy, a každý vyžaduje svá opatření pro optimalizaci. Obecně platí, že nenajdeme kombinaci indexů, která by stejně dobře fungovala pro oba dotazy.
Jedním z důležitých požadavků, které je třeba upřesnit při vývoji takového vyhledávacího řešení, je, zda je pro podnik skutečně důležité vidět celkový počet nalezených objektů. Často tomu tak není. A navigace na konkrétní čísla stránek je podle mého názoru řešení s velmi úzkou oblastí použití, protože většina scénářů s stránkováním vypadá jako „přejít na další stránku“.
Varianta stránkování #2
Předpokládejme, že uživatelé nechtějí znát celkový počet nalezených objektů. Pokusíme se zjednodušit vyhledávací stránku:
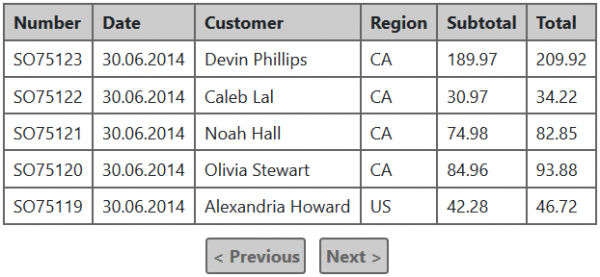
Ve skutečnosti se změnilo jen to, že není možné přecházet na konkrétní čísla stránek, a nyní tato tabulka pro zobrazení nemusí vědět, kolik jich celkem může být. Ale vzniká otázka — jak se tabulka dozví, zda jsou data pro další stránku (aby správně zobrazila odkaz „Další“)?
Odpověď je velmi jednoduchá: můžete načíst z databáze o jeden záznam více, než je třeba pro zobrazení, a přítomnost tohoto „dalšího“ záznamu ukáže, zda je další várka. Tímto způsobem bude pro získání jedné stránky dat třeba provést pouze jeden dotaz, což výrazně zlepší výkon a usnadní podporu takové funkčnosti. Měl jsem v praxi případ, kdy odmítnutí počítání celkového počtu záznamů zrychlilo výstup výsledků 4-5krát.
Pro tento přístup existuje několik variant uživatelského rozhraní: tlačítka „zpět“ a „vpřed“, jak je uvedeno výše, tlačítko „načíst více“, které jednoduše přidá novou várku do zobrazených výsledků, a „nekonečné scrollování“, které funguje na principu „načíst více“, ale signálem pro získání další várky je procházení uživateli všech zobrazených výsledků až na konec. Ať již je vizuální řešení jakékoli, princip výběru dat zůstává stejný.
Nuance implementace stránkování
Ve všech příkladech dotazů uvedených výše se používá přístup „offset + limit“, kdy je v samotném dotazu uvedeno, od které řady výsledků a kolik řad se má vrátit. Nejprve se podíváme, jak nejlépe organizovat předání parametrů v tomto případě. V praxi jsem se setkal s několika způsoby:
- Pořadové číslo požadované stránky (pageIndex), velikost stránky (pageSize).
- Pořadové číslo první položky, kterou je třeba vrátit (startIndex), maximální počet položek ve výsledku (count).
- Pořadové číslo první položky, kterou je třeba vrátit (startIndex), pořadové číslo poslední položky, kterou je třeba vrátit (endIndex).
Na první pohled se může zdát, že je to tak prosté, že na tom nezáleží. Ale není tomu tak – nejpohodlnější a nejuniverzálnější možností je druhá (startIndex, count). Na to existuje několik důvodů:
- Pro přístup s odečtením +1 položky, jak je uvedeno výše, je první varianta s pageIndex a pageSize extrémně nepraktická. Například chceme zobrazit 50 položek na stránce. Podle uvedeného algoritmu je třeba číst o jednu položku více, než je nutné. Pokud toto „+1“ není zajištěno na serveru, získáme to, že pro první stránku musíme žádat o položky od 1 do 51, pro druhou – od 51 do 101 atd. Pokud nastavíme velikost stránky na 51 a zvyšujeme pageIndex, druhá stránka vrátí od 52 do 102 atd. Tím pádem, v první variantě je jediný způsob, jak normálně realizovat tlačítko pro přechod na další stránku, zajistit na serveru odečtení „přebyteční“ položky, což je velmi nejednoznačný nuance.
- Třetí varianta nemá vůbec žádný smysl, protože pro provádění dotazů v drtivé většině databází bude stejně nutné předat počet, nikoli index poslední položky. Ačkoliv je odečtení startIndex od endIndex jednoduchá aritmetická operace, je zde nadbytečná.
Nyní je třeba popsat nevýhody implementace stránkování pomocí „offset + počet“:
- Získání každé další stránky bude nákladnější a pomalejší než předchozí, protože databázi bude stále muset projít všechny záznamy „od začátku“ podle kritérií vyhledávání a třídění, a poté se zastavit na potřebném úseku.
- Ne všechny DBMS mohou tento přístup podporovat.
Alternativy existují, ale ani ty nejsou dokonalé. První z takových přístupů se nazývá „keyset paging“ nebo „seek method“ a spočívá v tom, že po získání dávky si můžete zapamatovat hodnoty polí v poslední položce na stránce a poté je použít pro získání další dávky. Například jsme provedli takový dotaz:
SELECT * FROM Sales.SalesOrderHeader
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
A v posledním záznamu jsme získali hodnotu data objednávky '2014-06-29'. Pro získání další stránky bychom se mohli pokusit provést následující:
SELECT * FROM Sales.SalesOrderHeader
WHERE OrderDate < '2014-06-29'
ORDER BY OrderDate DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Problém je v tom, že OrderDate je neunikátní pole a uvedené podmínky s vysokou pravděpodobností vynechají mnoho potřebných řádků. Pro zpřesnění tohoto dotazu je nutné k podmínce přidat unikátní pole (předpokládejme, že 75074 je poslední hodnota primárního klíče z první dávky):
SELECT * FROM Sales.SalesOrderHeader
WHERE (OrderDate = '2014-06-29' AND SalesOrderID < 75074)
   OR (OrderDate < '2014-06-29')
ORDER BY OrderDate DESC, SalesOrderID DESC
OFFSET 0 ROWS
FETCH NEXT 50 ROWS ONLY
Tato varianta bude fungovat správně, ale obecně bude obtížné ji optimalizovat, protože podmínka obsahuje operátor OR. Pokud s růstem OrderDate roste hodnota primárního klíče, lze podmínku zjednodušit a ponechat pouze filtr podle SalesOrderID. Avšak pokud mezi hodnotami primárního klíče a polem, podle kterého je výsledek seřazen, neexistuje striktní korelace — většina DBMS se tomuto OR nevyhne. Známým výjimkou je PostgreSQL, kde je plně podporováno porovnání n-tic a uvedenou podmínku lze zapsat jako 'WHERE (OrderDate, SalesOrderID) < ('2014-06-29', 75074)'. Při použití složeného klíče s těmito dvěma poli by měl být takový dotaz dostatečně snadný.
Druhý alternativní přístup lze nalézt například v nebo — kdy dotaz kromě dat vrací speciální identifikátor, pomocí kterého lze získat další dávku dat. Pokud má tento identifikátor neomezenou životnost (jako v Cosmos DB), je to vynikající způsob realizace stránkování s postupným přechodem mezi stránkami (zmíněná varianta #2). Jeho možné nevýhody: není podporováno ve všech DBMS; získaný identifikátor další dávky může mít omezenou životnost, což obecně není vhodné pro realizaci interakce s uživateli (jako například ElasticSearch scroll API).
Složitá filtrace
Dále ztěžujeme úkol. Předpokládejme, že se objevila požadavek na implementaci takzvaného faceted search, který je všem dobře známý z internetových obchodů. Výše uvedené příklady založené na tabulce objednávek nejsou v tomto případě příliš výstižné, proto se přepneme na tabulku Product z databáze AdventureWorks:
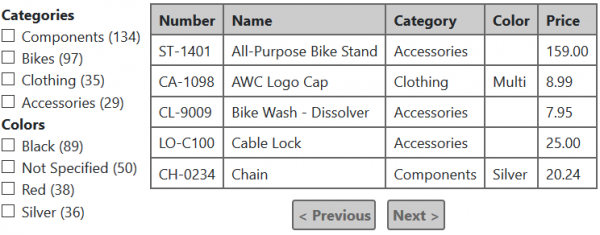
Jaký je princip faceted search? Je to v tom, že pro každou položku filtru se zobrazuje počet záznamů odpovídajících tomuto kritériu. s ohledem na filtry vybrané ve všech ostatních kategoriích..
Například pokud v tomto příkladu vybereme kategorii Bikes a barvu Black, tabulka zobrazí pouze černé bicykle, ale přitom:
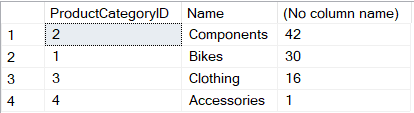
- Pro každé kritérium skupiny „Categories“ se zobrazí počet produktů z této kategorie černé barvy.
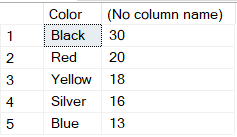
- Pro každé kritérium skupiny „Colors“ se zobrazí počet bicyklů této barvy.
Zde je příklad výstupu výsledku pro takové podmínky:
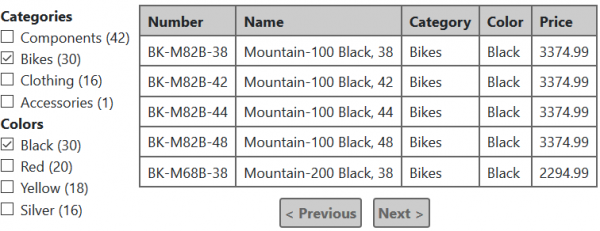
Pokud navíc zaškrtneme kategorii „Clothing“, tabulka zobrazí také černé oblečení, které je skladem. Počet produktů černé barvy v sekci „Color“ bude také přepočítán podle nových podmínek, pouze v sekci „Categories“ se nic nezmění… Doufám, že těchto příkladů je dostatek, abychom pochopili obvyklý algoritmus fungování faceted search.
Nyní si představme, jak by to bylo možné implementovat na relační databázi. Každá skupina kritérií, jako je Category a Color, bude vyžadovat samostatný dotaz:
SELECT pc.ProductCategoryID, pc.Name, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
  INNER JOIN Production.ProductCategory pc ON ps.ProductCategoryID = pc.ProductCategoryID
WHERE p.Color = 'Black'
GROUP BY pc.ProductCategoryID, pc.Name
ORDER BY COUNT(1) DESC
SELECT Color, COUNT(1) FROM Production.Product p
  INNER JOIN Production.ProductSubcategory ps ON p.ProductSubcategoryID = ps.ProductSubcategoryID
WHERE ps.ProductCategoryID = 1 --Bikes
GROUP BY Color
ORDER BY COUNT(1) DESC
Co není v tomto řešení v pořádku? Velmi jednoduše — špatně se škáluje. Každá sekce filtru vyžaduje samostatný dotaz pro výpočet množství a tyto dotazy nejsou nejlehčí. V internetových obchodech může v některých sekcích být i několik desítek filtrů, což se může ukázat jako vážný problém pro výkon.
Obvykle po těchto tvrzeních mi navrhují některá řešení, a to konkrétně:
- Sloučit všechny počty do jednoho dotazu. Technicky je to možné pomocí klíčového slova UNION, ale výkonu to příliš nepomůže — databáze bude muset stejně provést „od začátku“ každý z fragmentů.
- Když se ptám na problém, skoro pokaždé mi navrhují kešování počtů. Nuance je v tom, že to obecně nelze provést. Předpokládejme, že máme 10 „fascet“, z nichž každá má 5 hodnot. To je velmi „skromná“ situace ve srovnání s tím, co lze vidět v internetových obchodech. Výběr jednoho prvku fascety ovlivňuje počty v ostatních 9, jinými slovy, pro každou kombinaci kritérií mohou být počty různé. Celkově v našem příkladu existuje 50 kritérií, které si může uživatel vybrat, a tedy bude 250 možných kombinací. Na naplnění takové datové matice nebude dost paměti ani času. Můžete namítnout, že ne všechny kombinace jsou reálné a uživatel si zřídka vybírá více než 5-10 kritérií. Ano, můžete provést lazy loading a kešování počtů pouze pro to, co bylo kdy vybráno, ale čím více možností výběru, tím méně efektivní bude taková keš a tím více výrazné budou problémy s časem odezvy (zejména pokud se datový soubor pravidelně mění).
Naštěstí je zde řešení, které je již dlouho dost efektivní a předvídatelně funguje na velkých objemech dat. Pro jakoukoli z těchto možností má smysl rozdělit přepočet fascet a načítání stránky výsledků na dva paralelní požadavky na server a uspořádat uživatelské rozhraní tak, aby načítání dat ohledně fascet „nebránilo“ zobrazení výsledků vyhledávání.
- Provádějte úplné přepočty „fascetů“ co nejméně. Například neprovádějte přepočet při každé změně hledacích kritérií, místo toho nalezněte celkový počet výsledků odpovídajících aktuálním podmínkám a nabídněte uživateli, aby je zobrazil — „nalezeno 1425 záznamů, zobrazit?“ Uživatel může pokračovat ve změně podmínek hledání nebo stisknout tlačítko „zobrazit“. Teprve ve druhém případě budou provedeny všechny požadavky na získání výsledků a přepočet množství na všech „fascetech“. Jak není těžké si všimnout, bude nutné se vypořádat s požadavkem na získání celkového počtu výsledků a jeho optimalizací. Tento způsob můžete vidět v mnoha malých internetových obchodech. Je zřejmé, že to není všelék na tento problém, ale v jednoduchých případech může být dobrým kompromisem.
- Používejte vyhledávací enginy pro vyhledávání výsledků a počítání fascetů, jako jsou Solr, ElasticSearch, Sphinx a další. Všechny jsou navrženy pro vytváření „fascetů“ a dělají to dost efektivně díky invertovanému indexu. Jak fungují vyhledávací systémy, proč jsou v těchto případech efektivnější než databáze obecných účelů, jaké existují praktiky a nástrahy — to je téma pro samostatný článek. Zde však chci upozornit, že vyhledávací engine nemůže být náhradou hlavního úložiště dat, používá se jako doplněk: jakékoliv změny v základní databázi, které jsou pro vyhledávání relevantní, jsou synchronizovány do vyhledávacího indexu; mechanismus vyhledávání obvykle interaguje pouze s vyhledávacím enginem a neodkazuje na základní databázi. Jeden z nejdůležitějších aspektů zde je, jak spolehlivě tuto synchronizaci organizovat. Všechno závisí na požadavcích na „čas odezvy“. Pokud není čas mezi změnou v základní databázi a jejím „projevením“ ve vyhledávání kritický, lze vytvořit službu, která každých několik minut hledá nedávno změněné záznamy a indexuje je. Pokud je potřeba minimalizovat možný čas odezvy, lze implementovat něco jako pro odesílání aktualizací do vyhledávací služby.
Závěry
- Implementace paginace na straně serveru je vážné ztížení a má smysl ji používat pouze pro rychle rostoucí nebo jednoduše velké datové sady. Jak posoudit, co je „velké“ nebo „rychle rostoucí“ — neexistuje žádný absolutně přesný recept, ale držel bych se takového přístupu:
- Pokud získání celé kolekce dat s ohledem na serverový čas a přenos přes síť normálně splňuje požadavky na výkon, nemá smysl implementovat paginaci na straně serveru.
- Může nastat situace, kdy v blízké budoucnosti nebudou s výkonem žádné problémy, protože dat je málo, ale kolekce dat neustále roste. Pokud by nějaká datová sada mohla přestat splňovat předchozí bod v budoucnu, je lepší paginaci implementovat hned.
- Pokud z pohledu podnikání neexistuje žádná přísná požadavek na zobrazení celkového počtu výsledků nebo na zobrazení čísel stránek, a navíc ve vašem systému není vyhledávací engine — je lepší tyto momenty neimplementovat a zvážit variantu č. 2.
- Pokud existuje jasný požadavek na faceted search, máte dvě možnosti, jak neztratit výkon:
- Neprovádět znovu přepočet všech množství při každé změně kriterií vyhledávání.
- Použít vyhledávací engine jako Solr, ElasticSearch, Sphinx a další. Ale je třeba chápat, že nemůže být náhradou hlavní databáze a měl by být používán jako doplněk k hlavnímu úložišti pro řešení vyhledávacích úkolů.
- Také v případě faceted search má smysl rozdělit získání stránky výsledků vyhledávání a počítání množství na dva paralelní dotazy. Počítání množství může zabrat více času než získání výsledků, zatímco výsledky jsou důležitější pro uživatele.
- Pokud používáte SQL databázi pro vyhledávání, jakákoli změna kódu týkající se této části by měla být důkladně testována z hlediska výkonu na odpovídajícím objemu dat (převyšujícím objem v „živé“ databázi). Také je žádoucí využívat monitoring doby provádění dotazů na všech instancích databáze, a zejména — na „živém“. I když ve fázi vývoje byly plány dotazů v pořádku, se vzrůstajícím objemem dat se situace může výrazně změnit.
Zdroj: habr.com
