

S Elasticsearch se setkává mnoho lidí. Ale co se stane, když chcete pomocí něj ukládat logy "v obzvlášť velkém objemu"? A ještě bezbolestně přežít selhání některého z několika datových center? Jakou architekturu zvolit a na jaká úskalí narazíte?
V Odnoklassnikách jsme se rozhodli vyřešit otázku log managementu pomocí Elasticsearch a nyní se dělíme o naše zkušenosti v Habru: jak o architektuře, tak o úskalích.
Jsem Petr Zajcev, pracuji jako systémový administrátor v Odnoklassnikách. Předtím jsem také byl administrátorem, pracoval jsem s Manticore Search, Sphinx Search, Elasticsearch. Možná, pokud se objeví nějaký další …search, pravděpodobně budu pracovat i s ním. Také se účastním několika open-source projektů na dobrovolné bázi.
Když jsem přišel do Odnoklassniků, neuváženě jsem na pohovoru řekl, že umím pracovat s Elasticsearch. Poté, co jsem se zorientoval a provedl nějaké jednoduché úkoly, dostal jsem velký úkol na reformu systému log managementu, jaký existoval v té době.
Požadavky
Požadavky na systém byly formulovány následovně:
- Jako frontend měl být použit Graylog. Protože ve firmě už byly zkušenosti s tímto produktem, programátoři a testeři ho znali, byl jim známý a pohodlný.
- Objem dat: průměrně 50-80 tisíc zpráv za sekundu, ale pokud něco selže, tak není omezen žádným provozem, může to být 2-3 miliony řádků za sekundu.
- Po diskusi s klienty o požadavcích na rychlost zpracování vyhledávacích dotazů jsme pochopili, že typický vzor používání takového systému je následující: lidé hledají logy své aplikace za poslední dva dny a nechtějí čekat na výsledky jejich dotazu déle než jednu sekundu.
- Administrátoři trvali na tom, aby se systém v případě potřeby snadno škáloval, aniž by od nich vyžadoval hluboké porozumění tomu, jak je uspořádán.
- Aby byla jediná údržbová úloha, kterou tyto systémy čas od času vyžadovaly - to je vyměnit nějaký hardware.
- Kromě toho existuje v Odnoklassnikách skvělá technická tradice: jakákoli služba, kterou spouštíme, musí přežít selhání datového centra (náhlé, neplánované a kdykoli).
Poslední požadavek na realizaci tohoto projektu byl pro nás nejtěžší, o čemž se ještě podrobněji zmíním.
Prostředí
Pracujeme ve čtyřech datových centrech, přičemž datové uzly Elasticsearch mohou být umístěny pouze ve třech (z několika netechnických důvodů).
V těchto čtyřech datových centrech se nachází přibližně 18 tisíc různých zdrojů logů — hardware, kontejnery, virtuální stroje.
Důležitá vlastnost: spuštění clusteru probíhá v kontejnerech ne na fyzických strojích, ale na . Kontejnery mají zajištěna 2 jádra, obdobná 2.0Ghz v4, s možností využití dalších jader v případě jejich nečinnosti.
Jinými slovy:
Topologie
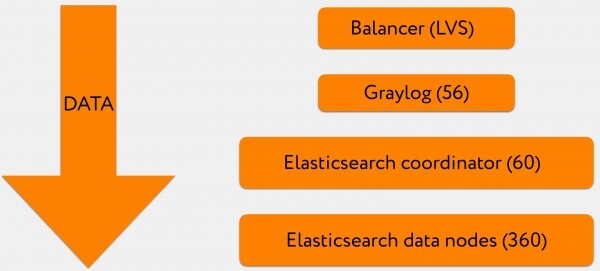
Celkové řešení mi původně připadalo následovně:
- 3-4 VIP jsou za A-záznamem domény Graylog, což je adresa, na kterou jsou odesílány logy.
- každý VIP představuje vyrovnávač zátěže LVS.
- Poté logy přicházejí do zásobníku Graylog, část dat jde ve formátu GELF, část ve formátu syslog.
- Dále se to všechno ve velkých dávkách zapisuje do zásobníku koordinátorů Elasticsearch.
- A ti zase odesílají žádosti o zápis a čtení na relevantní datové uzly.
Terminologie
Možná ne všichni se podrobně orientují v terminologii, a tak bych se na ni ráda na chvíli zastavila.
V Elasticsearch existuje několik typů uzlů — master, coordinator, data node. Existují také dva další typy pro různé transformace logů a propojení různých clusterů mezi sebou, ale my jsme používali pouze uvedené.
Master
Pinga všechny přítomné uzly v clusteru, udržuje aktuální mapu clusteru a rozšiřuje ji mezi uzly, zpracovává logiku událostí, zabývá se různými úkoly týkajícími se clusteru.
Koordinátor
Plní jednu jedinou úlohu: přijímá žádosti od klientů na čtení nebo zápis a směruje tento provoz. V případě, že jde o žádost o zápis, pravděpodobně se zeptá u mastera, na který shard příslušného indexu to má uložit, a přesměruje žádost dál.
Data uzel
Ukládá data, provádí vnější příchozí vyhledávací dotazy a operace s umístěnými shardy.
Graylog
To je něco jako sloučenina Kibany s Logstashem v ELK stacku. Graylog kombinuje uživatelské rozhraní a pipeline pro zpracování logů. Pod kapotou Graylogu fungují Kafka a Zookeeper, které zajišťují propojení Graylogu jako clusteru. Graylog umí cacheovat logy (Kafka) pro případ nepřístupnosti Elasticsearch a opakovat neúspěšné čtecí a zápisové požadavky, seskupovat a označovat logy podle nastavených pravidel. Stejně jako Logstash má Graylog funkčnost pro modifikaci řetězců před zápisem do Elasticsearch.
Kromě toho má Graylog vestavěné zjišťování služeb, které na základě jediné dostupné uzlu Elasticsearch vytváří celou mapu clusteru a filtruje ji podle konkrétního tagu, což umožňuje směřovat požadavky na určité kontejnery.
Vizualně to vypadá zhruba takto:

To je screenshot z konkrétní instance. Zde budujeme histogram na základě dotazu a zobrazujeme relevantní řetězce.
Indexy
Vrátíme-li se k architektuře systému, chtěl bych se podrobněji zabývat tím, jak jsme stavěli model indexů, aby to všechno fungovalo správně.
Na dříve uvedeném schématu je to nejnižší úroveň: data uzly Elasticsearch.
Index je velká virtuální entita složená z shardů Elasticsearch. Samotný každý shard je nic jiného než Lucene index. A každý Lucene index se skládá z jednoho nebo více segmentů.
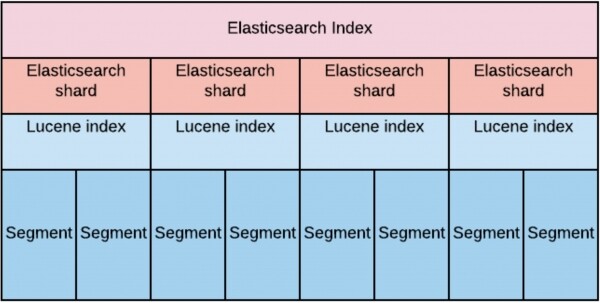
Při návrhu jsme odhadovali, že pro splnění požadavku na rychlost čtení při velkém objemu dat je nezbytné rovnoměrně "rozložit" tato data mezi data uzly.
To vedlo k tomu, že počet shardů na index (se replikami) by měl být přesně roven počtu data uzlů. Jednak proto, aby byl zajištěn replikovaný faktor rovný dvěma (to znamená, že můžeme ztratit polovinu clusteru). A za druhé, abychom mohli zpracovávat zápisové a čtecí požadavky alespoň na polovině clusteru.
Doba uchovávání byla nejprve stanovena na 30 dní.
Rozložení shardů lze graficky znázornit následujícím způsobem:
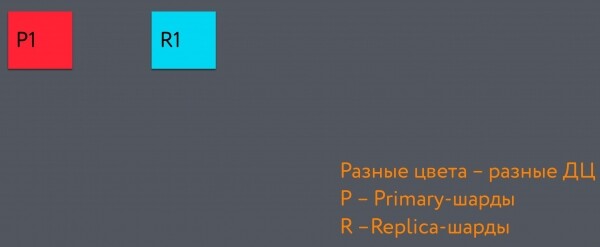
Celý tmavě šedý obdélník je index. Levý červený čtverec v něm je primary shard, první v indexu. A modrý čtverec je replica shard. Tyto se nacházejí v různých datových centrech.
Když přidáme další shard, dostane se do třetího datacentra. A nakonec získáme strukturu, která umožňuje ztrátu datacentra bez ztráty konzistence dat:
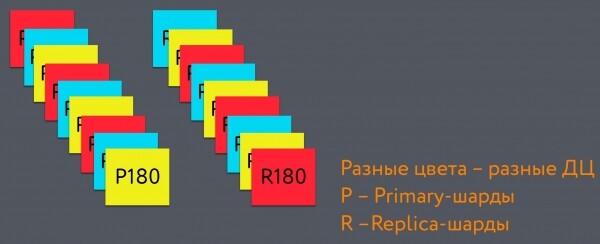
Rotaci indexů, tj. vytvoření nového indexu a odstranění nejstaršího, jsme nastavili na 48 hodin (podle vzoru použití indexu: posledních 48 hodin se hledá nejčastěji).
Takový interval rotace indexů je spojen s následujícími důvody:
Když na konkrétní datové uzly přijde vyhledávací dotaz, z pohledu výkonu je výhodnější, když je dotazována jedna shard, pokud je její velikost srovnatelná s velikostí heapu uzlu. To umožňuje udržovat "horkou" část indexu v heapu a rychle k ní přistupovat. Když je "horkých částí" příliš mnoho, degraduje se rychlost vyhledávání v indexu.
Když uzel začíná zpracovávat vyhledávací dotaz na jednom shardu, přidělí počet vláken, který odpovídá počtu hyperthreadingových jader fyzického stroje. Pokud vyhledávací dotaz zasahuje do velkého počtu shardů, počet vláken roste proporcionálně. To špatně ovlivňuje rychlost vyhledávání a negativně se odráží na indexaci nových dat.
Abychom zajistili požadovanou latenci vyhledávání, rozhodli jsme se použít SSD. Pro rychlé zpracování dotazů musely stroje, na nichž byly umístěny tyto kontejnery, mít alespoň 56 jader. Číslo 56 bylo zvoleno jako podmíněně dostatečná hodnota, která určuje počet vláken, které bude Elasticsearch generovat během provozu. V Elasticsearch mnoho parametrů thread pool přímo závisí na počtu dostupných jader, což přímo ovlivňuje potřebný počet uzlů v clusteru podle zásady "méně jader — více uzlů".
Nakonec se nám podařilo, že průměrný shard váží zhruba 20 gigabajtů a na 1 index připadá 360 shardů. Při rotaci každých 48 hodin tedy máme 15 kousků. Každý index obsahuje data za 2 dny.
Schémata zápisu a čtení dat
Pojďme se podívat, jak jsou v tomto systému zapisována data.
Představme si, že k nám z Graylog přichází nějaký dotaz do koordinátoru. Například chceme zaindexovat 2-3 tisíce řádků.
Koordinátor, který obdržel požadavek od Graylogu, se dotazuje mistra: „V požadavku na indexaci byl konkrétně uveden index, ale do kterého shardu to zapsat — není uvedeno.“
Mistr odpovídá: „Zapiš tuto informaci do shardu číslo 71“, po čemž je bezprostředně směrována do relevantního datového uzlu, kde se nachází primary-shard číslo 71.
Po tom se log transakcí replikoval na replica-shard, který se nachází již v jiném datovém centru.
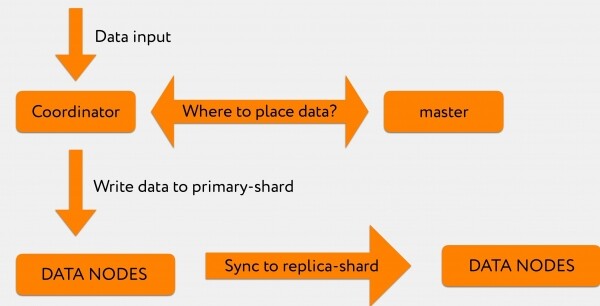
Z Graylogu přichází koordinační požadavek. Koordinátor ho přesměrovává podle indexu, přičemž Elasticsearch podle principu round-robin rozděluje požadavky mezi primary-shard a replica-shard.
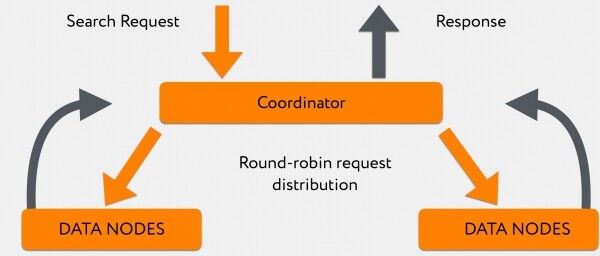
Uzly v počtu 180 kusů odpovídají nerovnoměrně a zatímco odpovídají, koordinátor shromažďuje informace, které do něj již „vyplyvly“ rychlejší datové uzly. Poté, když buď veškeré informace dorazily, nebo byl dosažen timeout, předává vše přímo klientovi.
Celý tento systém průměrně zpracovává vyhledávací požadavky za posledních 48 hodin za 300-400ms, s výjimkou těch požadavků, které mají leading wildcard.
„Kvítka“ s Elasticsearch: konfigurace Java
Aby to všechno fungovalo tak, jak jsme původně chtěli, dlouho jsme ladili různé věci v clusteru.
První část nalezených problémů byla spojena s tím, jak je v Elasticsearch ve výchozím nastavení přednastavená Java.
Problém první
Pozorovali jsme velmi vysoký počet zpráv o tom, že na úrovni Lucene, když jsou spuštěny background joby, se mergení segmentů Lucene končí chybou. V logách bylo vidět, že to je chyba OutOfMemoryError. Podle telemetrie jsme viděli, že je hromada volná, a nebylo jasné, proč tato operace selhává.
Zjistilo se, že mergení Lucene indexů probíhá mimo hromadu. A kontejnery jsou poměrně striktně omezeny co do spotřebovaných zdrojů. Do těchto zdrojů se vešel pouze heap (hodnota heap.size byla přibližně rovna RAM), a nějaké off-heap operace selhávaly s chybou alokace paměti, pokud z nějakého důvodu nepřekračovaly těch ~500MB, které zůstávaly do limitu.
Oprava byla docela triviální: zvýšili jsme dostupný objem RAM pro kontejner, po čemž jsme zapomněli, že takové problémy jsme měli.
Problém druhý
Asi po 4-5 dnech po spuštění clusteru jsme si všimli, že datové uzly začínají periodicky vypadávat z clusteru a znovu se do něj dostávat po 10-20 sekundách.
Když jsme se začali zabývat problémy, zjistili jsme, že paměť off-heap v Elasticsearch není prakticky nijak řízena. Když jsme kontejneru přiřadili více paměti, získali jsme možnost naplňovat direct buffer pools různými informacemi, které byly vyčištěny pouze po spuštění explicitního GC v Elasticsearch.
V některých případech tato operace probíhala velmi dlouho, a mezitím stihl cluster označit tento uzel jako již nedostupný. Tento problém je dobře popsán. .
Řešení bylo následující: omezili jsme Java na využívání většiny paměti mimo hromadu pro tyto operace. Omezili jsme ji na 16 gigabajtů (-XX:MaxDirectMemorySize=16g), což vedlo k tomu, že se explicitní GC spouštěl výrazně častěji a běžel značně rychleji, což přestalo destabilizovat cluster.
Třetí problém
Pokud si myslíte, že problémy s "uzly, které opouštějí cluster v nejméně očekávanou chvíli" tímto skončily, mýlíte se.
Když jsme konfigurovali práci s indexy, vybrali jsme mmapfs, abychom na čerstvých shardech s velkou segmentovaností. To byla docela hrubá chyba, protože při použití mmapfs je soubor mapován do operační paměti, a dále pracujeme s mapovaným souborem. V důsledku toho se při pokusu GC zastavit vlákna v aplikaci velmi dlouho dostáváme do safepoint, a po cestě tam aplikace přestává odpovídat na dotazy masteru ohledně toho, zda je živá. Odpovídajícím způsobem master předpokládá, že uzel již není v clusteru přítomen. Poté, po 5-10 sekundách, garbage collector dokončí svou práci, uzel ožije, znovu se připojí k clusteru a začne inicializaci shardů. To všechno silně připomínalo „produkci, kterou jsme si zasloužili“ a nebylo vhodné pro nic vážného.
Abychom se tohoto chování zbavili, nejprve jsme přešli na standardní niofs, a poté, když jsme se z pátých verzí Elastic migraci na šesté, vyzkoušeli hybridfs, kde se tento problém nevyskytoval. O typech úložiště si můžete přečíst více. .
Čtvrtý problém
Poté byla ještě jedna velmi zajímavá problém, kterou jsme opravovali rekordně dlouho. Chytali jsme ji 2-3 měsíce, protože její vzor byl absolutně nepochopitelný.
Někdy naši koordinátoři vypadli do Full GC, obvykle někdy po obědě, a odtud se už nevrátili. Přitom, když jsme logovali zpoždění GC, vypadalo to takto: všechno šlo dobře, dobře, dobře, a pak najednou — a všechno se prudce zhoršilo.
Nejprve jsme si mysleli, že máme zlomyslného uživatele, který spouští nějaký dotaz, který vyhazuje koordinátora z pracovního režimu. Velmi dlouho jsme logovali dotazy a snažili jsme se zjistit, co se děje.
Nakonec se ukázalo, že v okamžiku, kdy nějaký uživatel spustí velmi velký dotaz, a ten se dostane na konkrétní koordinátor Elasticsearch, některé uzly odpovídají déle než ostatní.
A to čas, po který koordinátor čeká na odpověď všech uzlů, shromažďuje výsledky z uzlů, které již odpověděly. Pro GC to znamená, že se nám velmi rychle mění vzor využití hromady. A ten GC, který jsme používali, si s tímto úkolem neporadil.
Jediné řešení, které jsme našli pro změnu chování clusteru v takové situaci — migrace na JDK13 a použití sběrače odpadu Shenandoah. To vyřešilo problém, koordinátoři u nás přestali padat.
Tímto problémy s Javou skončily a začaly problémy s propustností.
„Bobulky“ s Elasticsearch: propustnost
Problémy s propustností znamenají, že náš cluster pracuje stabilně, ale při vrcholech počtu indexovaných dokumentů a v okamžicích manévrů je výkon nedostatečný.
První pozorovaný symptom: při nějakých „vzbouřeních“ v produkci, kdy se náhle generuje velmi velké množství logů, se v Graylogu začala často objevovat chyba indexace es_rejected_execution.
To se dělo proto, že thread_pool.write.queue na jedné datové uzlu má před tím, než Elasticsearch dokáže zpracovat žádost o indexaci a uložit informace do shardu na disk, ve výchozím nastavení možnost cache pouze 200 žádostí. A v o tomto parametru se mluví velmi málo. Uvádí se pouze maximální počet vláken a výchozí velikost.
Samozřejmě jsme šli upravit tuto hodnotu a zjistili jsme následující: konkrétně v našem nastavení se celkem dobře cache až 300 žádostí, ale větší hodnota s sebou nese to, že znovu letíme do Full GC.
Kromě toho, jelikož se jedná o dávky zpráv, které přicházejí v rámci jednoho požadavku, bylo také potřeba upravit Graylog, aby zapisoval méně často a v malých dávkách, ale v obrovských dávkách nebo každé 3 sekundy, pokud dávka není stále plná. V takovém případě se ukazuje, že informace, které zapisujeme do Elasticsearch, se stávají dostupnými ne za dvě sekundy, ale za pět (což nám plně vyhovuje), ale snižuje se počet retrievů, které musíme provést, abychom protlačili velkou dávku informací.
To je zvláště důležité v momentech, kdy nám něco někde spadne a urputně o tom hlásí, abychom nedostali úplně spamatovaný Elastic, a za nějakou dobu — nefunkční kvůli ucpaným bufferům uzly Graylog.
Kromě toho, když k těmto výbuchům docházelo v produkci, dostávali jsme stížnosti od programátorů a testerů: v okamžiku, kdy velmi potřebovali tyto logy, byly jim poskytovány velmi pomalu.
Začali jsme se tím zabývat. Z jedné strany bylo jasné, že dotazy na vyhledávání a dotazy na indexaci fungují v podstatě na stejných fyzických strojích, a tak nebo onak budou určité propady.
To bylo možné částečně obejít díky tomu, že v šesti verzích Elasticsearch vznikl algoritmus, který umožňuje rozdělovat dotazy mezi relevantní data-uzly ne náhodně round-robin (kontejner, který se zabývá indexací a drží primary-shard, může být velmi vytížen, nebude mít možnost rychle odpovědět), ale nasměrovat tento dotaz na méně zatížený kontejner s replica-shard, který odpoví výrazně rychleji. Jinými slovy, přišli jsme k use_adaptive_replica_selection: true.
Obraz čtení začíná vypadat takto:
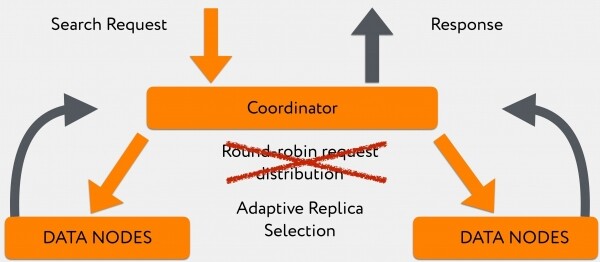
Přechod na tento algoritmus značně zlepšil čas dotazu v momentech, kdy probíhal velký tok logů na zápis.
Nakonec hlavní problém spočíval v bezbolestném vyvedení datacentra.
Co jsme chtěli od clusteru okamžitě po ztrátě spojení s jedním DC:
- Pokud máme v odpadlém datacentru aktuálního mastera, bude převolen a přesune se jako role na jiný uzel v jiném DC.
- Master rychle vyhodí ze shluku všechny nedostupné uzly.
- Na základě zbývajících bude vědět: v ztraceném datovém centru jsme měli takové primary shard, rychle propromuje komplementární replica shard v zbývajících datových centrech a naše indexování dat poběží dál.
- V důsledku toho se nám postupně degraduje propustnost clustera pro zápis a čtení, ale celkově to bude fungovat i když pomalu, ale stabilně.
Jak se ukázalo, chtěli jsme něco takového:
A dostali jsme následující:
Jak se to stalo?
V okamžiku pádu datového centra se nám úzkým místem stal master.
Proč?
To spočívá v tom, že v masteru je TaskBatcher, který zodpovídá za rozšiřování určitých úloh a událostí v clusteru. Jakýkoliv výstup uzlu, jakékoli povýšení shardu z replica na primary, jakákoli úloha na vytvoření nějakého shardu – to všechno se nejprve dostane do TaskBatcheru, kde se zpracovává postupně a jedním vláknem.
V okamžiku výstupu jednoho datového centra se ukázalo, že všechny datové uzly ve zbývajících datových centrech cítily za povinnost informovat mastera, že "nás ztratily takové shard a takové datové uzly".
Zároveň přežívající datové uzly posílaly všechny tyto informace aktuálnímu masterovi a snažily se čekat na potvrzení, že je přijal. Toho se nedočkaly, protože master dostával úlohy rychleji, než stihl odpovědět. Uzly opakovaně poslaly žádosti s časovým limitem, zatímco master už ani nesnažil na ně odpovědět, byl zcela pohlcen úlohou třídění žádostí podle priority.
V terminálním pohledu to vyšlo tak, že datové uzly spamovaly mastera až tak, že odešel do full GC. Po tom se role mastera přenesla na nějaký následující uzel, s nímž se stalo přesně totéž, a nakonec se cluster zcela rozpadl.
Prováděli jsme měření, a do verze 6.4.0, kde to bylo opraveno, nám stačilo vyřadit najednou pouze 10 datových uzlů ze 360, abychom zcela zničili cluster.
Vypadalo to zhruba takto:
Po verzi 6.4.0, kde opravili ten špatný bug, datové uzly přestaly zabíjet mastera. Ale "chytřejší" od toho není. A to konkrétně: když vyřazujeme 2, 3 nebo 10 (jakékoli množství, které není jediné) datových uzlů, master dostává nějakou první zprávu, která říká, že uzel A odešel, a snaží se o tom říct uzlu B, uzlu C, uzlu D.
A v současnosti se s tím dá bojovat pouze nastavením časového limitu na pokusy někomu něco říct, což je zhruba 20-30 sekund, a tímto způsobem řídit rychlost výstupu datacentra z clusteru.
V zásadě to spadá do těch požadavků, které byly původně stanoveny pro finální produkt v rámci projektu, ale z pohledu „čisté vědy“ je to chyba. Ta byla mimochodem úspěšně opravena vývojáři ve verzi 7.2.
A když nějaký data-uzel vyšel, ukázalo se, že šíření informace o jeho výstupu je důležitější než říct celému clusteru, že na něm byly takové primary-shardy (aby se promovaly replica-shardy v jiném datacentru na primary a bylo možné do nich zapisovat informace).
Proto, když už vše „utichlo“, vystouplé data-uzly nejsou okamžitě označeny jako stale. Dále jsme nuceni čekat, až se vyprší všechny pingy k vystouplým data-uzlům, a teprve poté náš cluster začne vyprávět, že tam, tam a tam je třeba pokračovat ve psaní informací. Více o tom si můžete přečíst .
Výsledkem je, že operace výstupu datacentra nám dnes trvá přibližně 5 minut v hodinách špičky. Pro tak velký a neobratný stroj je to docela dobrý výsledek.
Nakonec jsme dospěli k následujícímu řešení:
- Máme 360 data-uzlů s disky o kapacitě 700 gigabajtů.
- 60 koordinátorů pro směrování provozu přes tyto data-uzly.
- 40 masterů, které jsme si ponechali jako nějaké dědictví z dob před verzí 6.4.0 — abychom přežili výstup datacentra, byli jsme morálně připraveni ztratit několik strojů, abychom garantovali, že i při nejhorším scénáři budeme mít quorum masterů.
- Jakékoliv pokusy o kombinaci rolí na jednom kontejneru narazily na to, že dříve nebo později uzel selhal pod zátěží.
- V celém clusteru se používá heap.size, který je 31 gigabajtů: všechny pokusy o zmenšení velikosti vedly k tomu, že při těžkých vyhledávacích dotazech s leading wildcard buď zabily nějaké uzly, nebo se v samotném Elasticsearch zablokoval circuit breaker.
- Kromě toho, pro zajištění výkonnosti vyhledávání, jsme se snažili udržovat počet objektů v clusteru co možná nejmenší, abychom zpracovávali co nejméně událostí v nejtěsnějším místě, které bylo u nás v masteru.
Nakonec o monitorování
Aby to všechno fungovalo tak, jak má, monitorujeme následující:
- Každé datové uzly hlásí do našeho cloudu, že existují, a že na nich jsou určité shard. Když někde něco vypneme, cluster během 2-3 sekund hlásí, že v centru A jsme vypnuli uzly 2, 3 a 4 – to znamená, že v jiných datových centrech nemůžeme v žádném případě vypínat ty uzly, na kterých zůstaly shardy v jediném exempláři.
- Známe-li charakter chování mastera, velmi pečlivě sledujeme počet pending úloh. Protože i jedna visící úloha, pokud se včas neodstraní, může teoreticky v nějaké krizové situaci způsobit problém, kvůli kterému neproběhne například propagace replica shardu na primary, což zablokuje indexaci.
- Také se velmi důkladně díváme na zpoždění garbage collector, protože jsme s tímto měli již velké potíže při optimalizaci.
- Rejecty podle vláken, abychom předem věděli, kde se nachází „úzké místo“.
- A standardní metriky, jako heap, RAM a I/O.
Při budování monitorování je nutné brát v úvahu specifika Thread Pool v Elasticsearch. popisuje možnosti nastavení a výchozí hodnoty pro vyhledávání, indexaci, ale zcela mlčí o thread_pool.management. Tyto vlákna zpracovávají mimo jiné dotazy typu _cat/shards a jiné podobné, které jsou pohodlné pro psaní monitorování. Čím větší je cluster, tím více takových dotazů se vykonává za jednotku času, a výše zmíněné thread_pool.management nejenže není zastoupeno v oficiální dokumentaci, ale je také ve výchozím nastavení limitováno na 5 vláken, což se velmi rychle využije, po čemž monitorování přestává správně fungovat.
Co bych chtěl říci na závěr: podařilo se nám to! Dokázali jsme našim programátorům a vývojářům poskytnout nástroj, který v téměř každé situaci dokáže rychle a spolehlivě poskytnout informace o tom, co se děje na produkci.
Ano, bylo to dost složité, ale přesto se nám podařilo naše požadavky začlenit do již existujících produktů, které jsme nemuseli patchovat ani přepisovat pro sebe.
Zdroj: habr.com
