

Balíček tidyr je součástí jedné z nejpopulárnějších knihoven v jazyce R — tidyverse.
Hlavním účelem balíčku je úprava dat do přehledného formátu.
Na Habr již existuje věnovaný tomuto balíčku, ale datuje se do roku 2015. Chci se však podělit o nejaktuálnější změny, o kterých před několika dny informoval jeho autor Hadley Wickham.
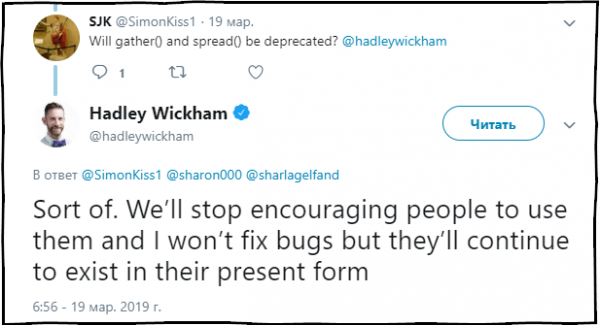
SJK: Budou funkce gather() a spread() považovány za zastaralé?
Hadley Wickham: Do určité míry. Přestaneme doporučovat používání těchto funkcí a opravovat v nich chyby, ale i nadále budou přítomny v balíčku v současném stavu.
Obsah
Pokud se zajímáte o analýzu dat, možná vás zaujmou mé a kanály. Většina obsahu je věnována jazyku R.
Koncept TidyData
Cíl tidyr — pomoci vám upravit data do tzv. přehledného formátu. Přehledná data jsou data, kde:
- Každá proměnná je ve sloupci.
- Každé pozorování je řádek.
- Každá hodnota je buňka.
S daty, která jsou upravena do tidy data, je mnohem snadnější a pohodlnější pracovat při analýze.
Hlavní funkce zahrnuté v balíčku tidyr
tidyr obsahuje sadu funkcí určených k transformaci tabulek:
fill()— vyplnění chybějících hodnot ve sloupci předchozími hodnotami;separate()— rozdělí jedno pole na několik podle oddělovače;unite()— provádí operaci spojení několika polí do jednoho, což je opačné k funkciseparate();pivot_longer()— funkce, která převádí data z širokého formátu do dlouhého;pivot_wider()— funkce, která převádí data z dlouhého formátu do širokého. Operace je opačná té, kterou provádí funkcepivot_longer().gather()zastaralá — funkce, která převádí data z širokého formátu do dlouhého;spread()zastaralá — funkce, která převádí data z dlouhého formátu do širokého. Operace je opačná té, kterou provádí funkcegather().
Nový koncept převodu dat z širokého formátu do dlouhého a naopak
Dříve se pro takový typ transformace používaly funkce gather() a spread(). V průběhu let existence těchto funkcí se ukázalo, že pro většinu uživatelů, včetně autora balíčku, názvy těchto funkcí a jejich argumentů byly dost obtížně pochopitelné a způsobovaly potíže při jejich hledání a pochopení toho, která z těchto funkcí převádí datový rámec z širokého do dlouhého formátu a naopak.
V důsledku toho byly tidyr přidány dvě nové, důležité funkce, které jsou určeny k transformaci datových rámců.
Nové funkce pivot_longer() a pivot_wider() byly vytvořeny pod vlivem některých funkcí z balíčku cdata, který vytvořil John Mount a Nina Zumel.
Instalace nejaktuálnější verze tidyr 0.8.3.9000
Pro instalaci nové, nejaktuálnější verze balíčku tidyr 0.8.3.9000, ve které jsou dostupné nové funkce, použijte následující kód.
devtools::install_github("tidyverse/tidyr")
V době psaní článku jsou tyto funkce dostupné pouze ve vývojové verzi balíčku na GitHubu.
Přechod na nové funkce
Ve skutečnosti není obtížné převést staré skripty na práci s novými funkcemi, pro větší pochopení vezmu příklad z dokumentace starých funkcí a ukážu, jak se tyto operace provádějí pomocí nových pivot_*() funkcí.
Převedení širokého formátu na dlouhý.
Příklad kódu z dokumentace funkce gather
# example
library(dplyr)
stocks <- data.frame(
  time = as.Date('2009-01-01') + 0:9,
  X = rnorm(10, 0, 1),
  Y = rnorm(10, 0, 2),
  Z = rnorm(10, 0, 4)
)

# old
stocks_gather <- stocks %>% gather(key   = stock,
                                   value = price,
                                   -time)

# new
stocks_long   <- stocks %>% pivot_longer(cols      = -time,
                                       names_to  = "stock",
                                       values_to = "price")
Převedení dlouhého formátu na široký.
Příklad kódu z dokumentace funkce spread
# old
stocks_spread <- stocks_gather %>% spread(key = stock,
                                          value = price)

# new
stock_wide    <- stocks_long %>% pivot_wider(names_from  = "stock",
                                            values_from = "price")
Jelikož v uvedených výše příkladech práce s pivot_longer() a pivot_wider(), v původním tabulkovém formátu stocks nejsou sloupce uvedené v argumentech names_to a values_to jejich názvy je třeba uvádět v uvozovkách.
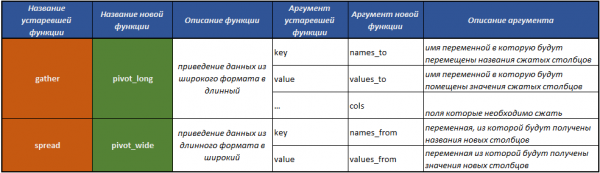
Tabulka, se kterou vám nejlépe pomůže pochopit, jak přejít na práci s novou koncepcí tidyr.
Poznámka od autora
Celý následující text je adaptivní, dokonce bych řekl volný překlad z oficiálního webu knihovny tidyverse.
Jednoduchý příklad převodu dat z širokého formátu na dlouhý
pivot_longer () — dělá datové sady delší, snižuje počet sloupců a zvyšuje počet řádků.
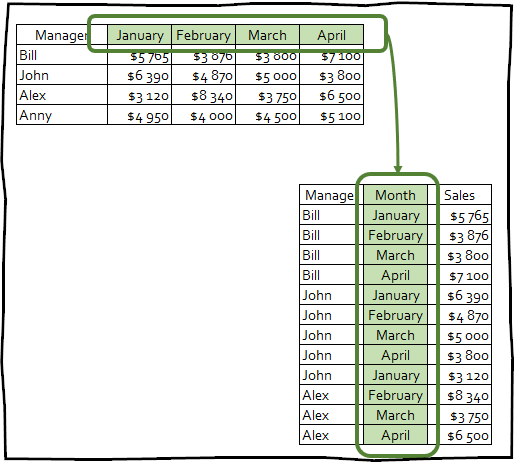
Pro provedení příkladů uvedených v článku je nejprve nutné načíst potřebné balíčky:
library(tidyr)
library(dplyr)
library(readr)
Předpokládejme, že máme tabulku s výsledky průzkumu, v níž (mimo jiné) se ptali lidí na jejich náboženství a roční příjem:
#> # A tibble: 18 x 11
#>    religion `<$10k` `$10-20k` `$20-30k` `$30-40k` `$40-50k` `$50-75k`
#>    <chr>      <dbl>     <dbl>     <dbl>     <dbl>     <dbl>     <dbl>
#>  1 Agnostic      27        34        60        81        76       137
#>  2 Atheist       12        27        37        52        35        70
#>  3 Buddhist      27        21        30        34        33        58
#>  4 Catholic     418       617       732       670       638      1116
#>  5 Don’t k…      15        14        15        11        10        35
#>  6 Evangel…     575       869      1064       982       881      1486
#>  7 Hindu          1         9         7         9        11        34
#>  8 Histori…     228       244       236       238       197       223
#>  9 Jehovah…      20        27        24        24        21        30
#> 10 Jewish        19        19        25        25        30        95
#> # … with 8 more rows, and 4 more variables: `$75-100k` <dbl>,
#> #   `$100-150k` <dbl>, `>150k` <dbl>, `Don't know/refused` <dbl>
Tato tabulka obsahuje údaje o náboženství respondentů v řádcích, zatímco úroveň příjmu je rozdělena podle názvů sloupců. Počet respondentů z každé kategorie je uložen v hodnotách buněk na průsečíku náboženství a úrovně příjmu. Pro uvedení tabulky do úhledného, správného formátu stačí použít pivot_longer():
pew %>%
  pivot_longer(cols = -religion, names_to = "income", values_to = "count")
pew %>%
pivot_longer(cols = -religion, names_to = "income", values_to = "count")
#> # A tibble: 180 x 3
#> religion income count
#>
#> 1 Agnostik 2 Agnostik 10-20k 34
#> 3 Agnostik 20-30k 60
#> 4 Agnostik 30-40k 81
#> 5 Agnostik 40-50k 76
#> 6 Agnostik 50-75k 137
#> 7 Agnostik 75-100k 122
#> 8 Agnostik 100-150k 109
#> 9 Agnostik >150k 84
#> 10 Agnostik Neznámý/odmítnutí 96
#> # … s 170 dalšími řádkyArgumenty funkce pivot_longer()
- První argument cols, popisuje, které sloupce je třeba sloučit. V tomto případě všechny sloupce kromě čas.
- Argument names_to dává název proměnné, která bude vytvořena z názvů sloupců, které jsme sloučili.
- values_to dává název proměnné, která bude vytvořena z dat uložených ve hodnotách buněk sloučených sloupců.
Specifikace
Toto je nová funkce balíčku tidyr, která byla dříve při práci se zastaralými funkcemi nedostupná.
Specifikace je datový rámec, kde každý řádek odpovídá jednomu sloupci v novém výstupním datovém rámci, a dvěma speciálním sloupcům, které začínají s:
- .*.name obsahuje původní název sloupce.
- .value obsahuje název sloupce, do kterého budou vstupovat hodnoty buněk.
Ostatní sloupce specifikace odrážejí, jak bude v novém sloupci výstupně zobrazen název sloučených sloupců z .*.name.
Specifikace popisuje metadata uložená v názvu sloupce, s jedním řádkem pro každý sloupec a jedním sloupcem pro každou proměnnou sloučenou s názvem sloupce, možná se vám teď toto určení zdá matoucí, ale po zvážení několika příkladů to bude mnohem jasnější.
Účel specifikace spočívá v tom, že můžete extrahovat, měnit a nastavovat nová metadata k transformovanému datovému rámci.
Pro práci se specifikacemi při transformaci tabulky z širokého formátu do dlouhého slouží funkce pivot_longer_spec().
Jak tato funkce funguje, bere libovolný datový rámec a formuje jeho metadata popsaným výše způsobem.
Pro ilustraci vezmeme datovou sadu who, která se dodává spolu s balíčkem tidyr. Tato datová sada obsahuje informace poskytované mezinárodní organizací zdravotnictví o výskytu tuberkulózy.
who
#> # A tibble: 7,240 x 60
#>    country iso2  iso3   year new_sp_m014 new_sp_m1524 new_sp_m2534
#>        & &
#>  1 Afghan… AF    AFG    1980          NA           NA           NA
#>  2 Afghan… AF    AFG    1981          NA           NA           NA
#>  3 Afghan… AF    AFG    1982          NA           NA           NA
#>  4 Afghan… AF    AFG    1983          NA           NA           NA
#>  5 Afghan… AF    AFG    1984          NA           NA           NA
#>  6 Afghan… AF    AFG    1985          NA           NA           NA
#>  7 Afghan… AF    AFG    1986          NA           NA           NA
#>  8 Afghan… AF    AFG    1987          NA           NA           NA
#>  9 Afghan… AF    AFG    1988          NA           NA           NA
#> 10 Afghan… AF    AFG    1989          NA           NA           NA
#> # … with 7,230 more rows, and 53 more variables
Vybudujeme jeho specifikaci.
spec %
  pivot_longer_spec(new_sp_m014:newrel_f65, values_to = "count")
#> # A tibble: 56 x 3
#> .name .value name
#> <chr> <chr> <chr>
#> 1 new_sp_m014 count new_sp_m014
#> 2 new_sp_m1524 count new_sp_m1524
#> 3 new_sp_m2534 count new_sp_m2534
#> 4 new_sp_m3544 count new_sp_m3544
#> 5 new_sp_m4554 count new_sp_m4554
#> 6 new_sp_m5564 count new_sp_m5564
#> 7 new_sp_m65 count new_sp_m65
#> 8 new_sp_f014 count new_sp_f014
#> 9 new_sp_f1524 count new_sp_f1524
#> 10 new_sp_f2534 count new_sp_f2534
#> # … with 46 more rowsPole country, iso2, iso3 už jsou proměnné. Naším úkolem je převrátit sloupce s new_sp_m014 o newrel_f65.
V názvech těchto sloupců je uchována následující informace:
- Prefix
new_naznačuje, že sloupec obsahuje data o nových případech onemocnění tuberkulózou, aktuální datový rámec obsahuje informace pouze o nových onemocněních, proto tento prefix v aktuálním kontextu nemá žádný význam. sp/rel/sp/eppopisuje způsob diagnostiky onemocnění.m/fpohlaví pacienta.014/1524/2535/3544/4554/65věkový rozsah pacienta.
Můžeme tyto sloupce rozdělit pomocí funkce extract(), pomocí regulárního výrazu.
spec %
        extract(name, c("diagnosis", "gender", "age"), "new_?(.*)_(.)(.*)")
#> # A tibble: 56 x 5
#> .name .value diagnosis gender age
#> <chr> <chr> <chr> <chr> <chr>
#> 1 new_sp_m014 count sp m 014
#> 2 new_sp_m1524 count sp m 1524
#> 3 new_sp_m2534 count sp m 2534
#> 4 new_sp_m3544 count sp m 3544
#> 5 new_sp_m4554 count sp m 4554
#> 6 new_sp_m5564 count sp m 5564
#> 7 new_sp_m65 count sp m 65
#> 8 new_sp_f014 count sp f 014
#> 9 new_sp_f1524 count sp f 1524
#> 10 new_sp_f2534 count sp f 2534
#> # … with 46 more rowsVšimněte si, že sloupec .*.name by měl zůstat nezměněn, protože je naším indexem v názvech sloupců původní datové sady.
Pohlaví a věk (sloupce gender a age) mají pevně stanovené a známé hodnoty, proto se doporučuje tyto sloupce převést na faktory:
spec %
            mutate(
              gender = factor(gender, levels = c("f", "m")),
              age = factor(age, levels = unique(age), ordered = TRUE)
            )
Nakonec, abychom mohli aplikovat naši vytvořenou specifikaci na původní datový rámec who musíme použít argument spec ve funkci pivot_longer().
who %>% pivot_longer(spec = spec)
#> # A tibble: 405,440 x 8
#>    country     iso2  iso3   year diagnosis gender age   count
#>    <chr>       <chr> <chr> <int> <chr>     <fct>  <ord> <int>
#>  1 Afghanistan AF    AFG    1980 sp        m      014      NA
#>  2 Afghanistan AF    AFG    1980 sp        m      1524     NA
#>  3 Afghanistan AF    AFG    1980 sp        m      2534     NA
#>  4 Afghanistan AF    AFG    1980 sp        m      3544     NA
#>  5 Afghanistan AF    AFG    1980 sp        m      4554     NA
#>  6 Afghanistan AF    AFG    1980 sp        m      5564     NA
#>  7 Afghanistan AF    AFG    1980 sp        m      65       NA
#>  8 Afghanistan AF    AFG    1980 sp        f      014      NA
#>  9 Afghanistan AF    AFG    1980 sp        f      1524     NA
#> 10 Afghanistan AF    AFG    1980 sp        f      2534     NA
#> # … with 405,430 more rows
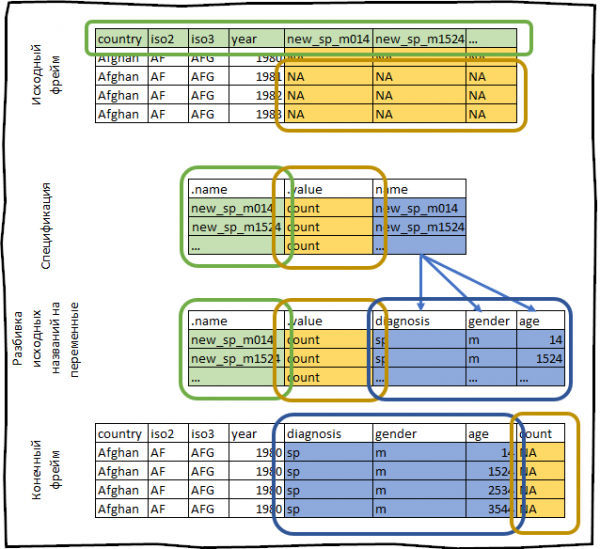
Vše, co jsme právě udělali, lze schematicky znázornit následujícím způsobem:
Specifikace s využitím více hodnot (.value)
V uvedeném příkladu sloupec specifikace .value obsahoval pouze jednu hodnotu, což je ve většině případů skutečně tak.
Ale čas od času může nastat situace, kdy budete potřebovat shromáždit v hodnotách data ze sloupců s různými typy dat. S pomocí zastaralé funkce spread() to by bylo docela složité udělat.
Níže uvedený příklad je převzat z k balíčku data.table.
Vytvořme tréninkový datový rámec.
family <- tibble::tribble(
  ~family,  ~dob_child1,  ~dob_child2, ~gender_child1, ~gender_child2,
       1L, "1998-11-26", "2000-01-29",             1L,             2L,
       2L, "1996-06-22",           NA,             2L,             NA,
       3L, "2002-07-11", "2004-04-05",             2L,             2L,
       4L, "2004-10-10", "2009-08-27",             1L,             1L,
       5L, "2000-12-05", "2005-02-28",             2L,             1L,
)
family % mutate_at(vars(starts_with("dob")), parse_date)
#> # A tibble: 5 x 5
#> family dob_child1 dob_child2 gender_child1 gender_child2
#> <int> <date> <date> <int> <int>
#> 1 1 1998-11-26 2000-01-29 1 2
#> 2 2 1996-06-22 NA 2 NA
#> 3 3 2002-07-11 2004-04-05 2 2
#> 4 4 2004-10-10 2009-08-27 1 1
#> 5 5 2000-12-05 2005-02-28 2 1Vytvořený datový rámec obsahuje v každém řádku informace o dětech jedné rodiny. V rodinách může být jedno nebo dvě děti. U každého dítěte jsou uvedena data o datu narození a pohlaví, přičemž údaje o každém dítěti jsou v samostatných sloupcích, naším úkolem je přivést tyto údaje do správného formátu pro analýzu.
Všimněte si, že máme dvě proměnné s informacemi o každém dítěti: jeho pohlaví a datum narození (sloupce s prefixem dop obsahují datum narození, sloupce s prefixem gender obsahují pohlaví dítěte). V očekávaném výsledku by měly být v samostatných sloupcích. Můžeme to udělat generováním specifikace, ve které má sloupec .value dvě různá hodnoty.
spec %
  pivot_longer_spec(-family) %>%
  separate(col = name, into = c(".value", "child"))%>%
  mutate(child = parse_number(child))
#> # A tibble: 4 x 3
#>   .name         .value child
#>   <chr>         <chr>  <dbl>
#> 1 dob_child1    dob        1
#> 2 dob_child2    dob        2
#> 3 gender_child1 gender     1
#> 4 gender_child2 gender     2
Tak se pojďme podívat na kroky, které provádí výše uvedený kód.
pivot_longer_spec(-family)— vytváříme specifikaci, která zhušťuje všechny existující sloupce kromě sloupce family.separate(col = name, into = c(".value", "child"))— rozdělujeme sloupec .*.name, který obsahuje názvy původních polí, podle podtržítka a vložíme získané hodnoty do sloupců .value a child.mutate(child = parse_number(child))— převádíme hodnoty pole child z textového na číselný datový typ.
Nyní můžeme aplikovat získanou specifikaci na původní datový rámec a přivést tabulku do požadovaného formátu.
family %>%
    pivot_longer(spec = spec, na.rm = T)
#> # A tibble: 9 x 4
#> family child dob gender
#> <int> <dbl> <date> <int>
#> 1 1 1 1998-11-26 1
#> 2 1 2 2000-01-29 2
#> 3 2 1 1996-06-22 2
#> 4 3 1 2002-07-11 2
#> 5 3 2 2004-04-05 2
#> 6 4 1 2004-10-10 1
#> 7 4 2 2009-08-27 1
#> 8 5 1 2000-12-05 2
#> 9 5 2 2005-02-28 1Používáme argument na.rm = TRUE, protože aktuální forma dat nutí vytvářet nadbytečné řádky pro neexistující pozorování. Jelikož rodina č. 2 má pouze jedno dítě, na.rm = TRUE zaručuje, že rodina 2 bude mít jeden řádek ve výstupu.
Převod datových rámců z dlouhého formátu do širokého
pivot_wider() — je inverzní transformací a naopak zvyšuje počet sloupců datového rámce tím, že snižuje počet řádků.
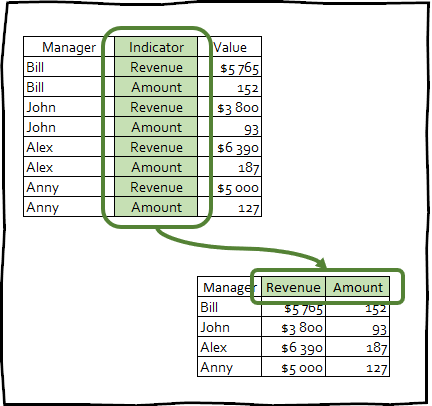
Takového druhu transformace se velmi zřídka používá k uspořádání dat do čistého formátu, nicméně tento přístup může být užitečný pro vytváření pivotních tabulek používaných v prezentacích nebo pro integraci s jinými nástroji.
Ve skutečnosti jsou funkce pivot_longer() a pivot_wider() symetrické a provádějí vzájemně opačné akce, tj: df %>% pivot_longer(spec = spec) %>% pivot_wider(spec = spec) a df %>% pivot_wider(spec = spec) %>% pivot_longer(spec = spec) vrátí původní df.
Nejjednodušší příklad úpravy tabulky na široký formát
Pro demonstraci funkcionality pivot_wider() budeme používat datovou sadu fish_encounters, která obsahuje informace o tom, jak různé stanice zaznamenávají pohyb ryb v řece.
#> # A tibble: 114 x 3
#>    fish  station  seen
#>    <fct> <fct>   <int>
#>  1 4842  Release     1
#>  2 4842  I80_1       1
#>  3 4842  Lisbon      1
#>  4 4842  Rstr        1
#>  5 4842  Base_TD     1
#>  6 4842  BCE         1
#>  7 4842  BCW         1
#>  8 4842  BCE2        1
#>  9 4842  BCW2        1
#> 10 4842  MAE         1
#> # … with 104 more rows
V drtivé většině případů bude tato tabulka informativnější a uživatelsky přívětivější, pokud prezentujeme informace o každé stanici v samostatném sloupci.
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
fish_encounters %>% pivot_wider(names_from = station, values_from = seen)
#> # A tibble: 19 x 12
#>    fish  Release I80_1 Lisbon  Rstr Base_TD   BCE   BCW  BCE2  BCW2   MAE
#>        &        &
#>  1 4842        1     1      1     1       1     1     1     1     1     1
#>  2 4843        1     1      1     1       1     1     1     1     1     1
#>  3 4844        1     1      1     1       1     1     1     1     1     1
#>  4 4845        1     1      1     1       1    NA    NA    NA    NA    NA
#>  5 4847        1     1      1    NA      NA    NA    NA    NA    NA    NA
#>  6 4848        1     1      1     1      NA    NA    NA    NA    NA    NA
#>  7 4849        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#>  8 4850        1     1     NA     1       1     1     1    NA    NA    NA
#>  9 4851        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> 10 4854        1     1     NA    NA      NA    NA    NA    NA    NA    NA
#> # … s 9 dalšími řádky a 1 další proměnnou: MAW
Tato datová sada zaznamenává informace pouze v případech, kdy byla ryba nalezena stanicí, tj. pokud nebyla žádná ryba zachycena některou stanicí, pak tyto údaje v tabulce nebudou. To znamená, že výstupní data budou vyplněna NA.
Nicméně v tomto případě víme, že absence záznamu znamená, že ryba nebyla zaznamenána, takže můžeme použít argument values_fill ve funkci pivot_wider() a vyplnit tyto chybějící hodnoty nulami:
fish_encounters %>% pivot_wider(
  names_from = station,
  values_from = seen,
  values_fill = list(seen = 0)
)
#> # A tibble: 19 x 12
#> fish Release I80_1 Lisbon Rstr Base_TD BCE BCW BCE2 BCW2 MAE
#> <fct> <int> <int> <int> <int> <int> <int> <int> <int> <int> <int>
#> 1 4842 1 1 1 1 1 1 1 1 1 1
#> 2 4843 1 1 1 1 1 1 1 1 1 1
#> 3 4844 1 1 1 1 1 1 1 1 1 1
#> 4 4845 1 1 1 1 1 0 0 0 0 0
#> 5 4847 1 1 1 0 0 0 0 0 0 0
#> 6 4848 1 1 1 1 0 0 0 0 0 0
#> 7 4849 1 1 0 0 0 0 0 0 0 0
#> 8 4850 1 1 0 1 1 1 1 0 0 0
#> 9 4851 1 1 0 0 0 0 0 0 0 0
#> 10 4854 1 1 0 0 0 0 0 0 0 0
#> # … with 9 more rows, and 1 more variable: MAW <int>Generování názvu sloupce z několika původních proměnných
Představte si, že máme tabulku, která obsahuje kombinaci produktu, země a roku. Abychom vygenerovali testovací datový rámec, můžeme provést následující kód:
df %
  filter((product == "A" & country == "AI") | product == "B") %>%
  mutate(value = rnorm(nrow(.)))
#> # A tibble: 45 x 4
#> product country year value
#> <chr> <chr> <int> <dbl>
#> 1 A AI 2000 -2.05
#> 2 A AI 2001 -0.676
#> 3 A AI 2002 1.60
#> 4 A AI 2003 -0.353
#> 5 A AI 2004 -0.00530
#> 6 A AI 2005 0.442
#> 7 A AI 2006 -0.610
#> 8 A AI 2007 -2.77
#> 9 A AI 2008 0.899
#> 10 A AI 2009 -0.106
#> # … with 35 more rowsNaším úkolem je rozšířit datový rámec tak, aby jeden sloupec obsahoval data pro každou kombinaci produktu a země. K tomu stačí předat do argumentu names_from vektor, který obsahuje názvy slučovaných polí.
df %>% pivot_wider(names_from = c(product, country),
                 values_from = "value")
#> # A tibble: 15 x 4
#> year A_AI B_AI B_EI
#> <int> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 0.607 1.20
#> 2 2001 -0.676 1.65 -0.114
#> 3 2002 1.60 -0.0245 0.501
#> 4 2003 -0.353 1.30 -0.459
#> 5 2004 -0.00530 0.921 -0.0589
#> 6 2005 0.442 -1.55 0.594
#> 7 2006 -0.610 0.380 -1.28
#> 8 2007 -2.77 0.830 0.637
#> 9 2008 0.899 0.0175 -1.30
#> 10 2009 -0.106 -0.195 1.03
#> # … with 5 more rowsMůžete také použít specifikace pro funkci pivot_wider(). Ale při podání do pivot_wider() specifikace provádí přeměnu, která je opačná pivot_longer(): vytvářejí se sloupce, které jsou uvedeny v .*.name, pomocí hodnot z .value a dalších sloupců.
Pro tuto datovou sadu můžete vygenerovat vlastní specifikaci, pokud chcete, aby každá možná kombinace země a produktu měla svůj vlastní sloupec, a ne pouze ty, které jsou v datech:
spec %
  expand(product, country, .value = "value") %>%
  unite(".name", product, country, remove = FALSE)
#> # A tibble: 4 x 4
#> .name product country .value
#> <chr> <chr> <chr> <chr>
#> 1 A_AI A AI value
#> 2 A_EI A EI value
#> 3 B_AI B AI value
#> 4 B_EI B EI valuedf %>% pivot_wider(spec = spec) %>% head()#> # A tibble: 6 x 5
#> year A_AI A_EI B_AI B_EI
#> <int> <dbl> <dbl> <dbl> <dbl>
#> 1 2000 -2.05 NA 0.607 1.20
#> 2 2001 -0.676 NA 1.65 -0.114
#> 3 2002 1.60 NA -0.0245 0.501
#> 4 2003 -0.353 NA 1.30 -0.459
#> 5 2004 -0.00530 NA 0.921 -0.0589
#> 6 2005 0.442 NA -1.55 0.594Několik pokročilých příkladů práce s novým konceptem tidyr
Úprava dat do přehledného formátu na příkladu souboru dat o příjmech a nájemném v USA
Datový soubor us_rent_income obsahuje informace o průměrném příjmu a nájmu pro každý stát v USA za rok 2017 (datový soubor je k dispozici v balíčku tidycensus).
us_rent_income
#> # A tibble: 104 x 5
#>    GEOID NAME       variable estimate   moe
#>
#>  1 01    Alabama    income      24476   136
#>  2 01    Alabama    rent          747     3
#>  3 02    Alaska     income      32940   508
#>  4 02    Alaska     rent         1200    13
#>  5 04    Arizona    income      27517   148
#>  6 04    Arizona    rent          972     4
#>  7 05    Arkansas   income      23789   165
#>  8 05    Arkansas   rent          709     5
#>  9 06    California income      29454   109
#> 10 06    California rent         1358     3
#> # … s 94 dalšími řádky
V jakém formátu jsou data ve datasetu us_rent_income pracovat s nimi je velmi nepohodlné, proto bychom chtěli vytvořit datový soubor se sloupci: rent, rent_moe, come, income_moe. Existuje mnoho způsobů, jak vytvořit tuto specifikaci, ale hlavní je, že musíme vygenerovat každou kombinaci hodnot proměnné a estimate/moe, a poté vygenerovat název sloupce.
  spec %
    expand(variable, .value = c("estimate", "moe")) %>%
    mutate(
      .name = paste0(variable, ifelse(.value == "moe", "_moe", ""))
    )
#> # A tibble: 4 x 3
#> variable .value .name
#> <chr> <chr> <chr>
#> 1 income estimate income
#> 2 income moe income_moe
#> 3 rent estimate rent
#> 4 rent moe rent_moePoskytnutí této specifikace pivot_wider() nám dává výsledek, který hledáme:
us_rent_income %>% pivot_wider(spec = spec)
#> # A tibble: 52 x 6
#>    GEOID NAME                 income income_moe  rent rent_moe
#>    <chr> <chr>                 <dbl>      <dbl> <dbl>    <dbl>
#>  1 01    Alabama               24476        136   747        3
#>  2 02    Alaska                32940        508  1200       13
#>  3 04    Arizona               27517        148   972        4
#>  4 05    Arkansas              23789        165   709        5
#>  5 06    California            29454        109  1358        3
#>  6 08    Colorado              32401        109  1125        5
#>  7 09    Connecticut           35326        195  1123        5
#>  8 10    Delaware              31560        247  1076       10
#>  9 11    District of Columbia  43198        681  1424       17
#> 10 12    Florida               25952         70  1077        3
#> # … with 42 more rows
Světová banka
Někdy vyžaduje přivedení datového souboru do správné podoby několik kroků.
Datový soubor world_bank_pop obsahuje údaje Světové banky o populaci každé země v období od roku 2000 do roku 2018.
#> # A tibble: 1,056 x 20
#>    country indicator `2000` `2001` `2002` `2003`  `2004`  `2005`   `2006`
#>    <chr>   <chr>      <dbl>  <dbl>  <dbl>  <dbl>   <dbl>   <dbl>    <dbl>
#>  1 ABW     SP.URB.T… 4.24e4 4.30e4 4.37e4 4.42e4 4.47e+4 4.49e+4  4.49e+4
#>  2 ABW     SP.URB.G… 1.18e0 1.41e0 1.43e0 1.31e0 9.51e-1 4.91e-1 -1.78e-2
#>  3 ABW     SP.POP.T… 9.09e4 9.29e4 9.50e4 9.70e4 9.87e+4 1.00e+5  1.01e+5
#>  4 ABW     SP.POP.G… 2.06e0 2.23e0 2.23e0 2.11e0 1.76e+0 1.30e+0  7.98e-1
#>  5 AFG     SP.URB.T… 4.44e6 4.65e6 4.89e6 5.16e6 5.43e+6 5.69e+6  5.93e+6
#>  6 AFG     SP.URB.G… 3.91e0 4.66e0 5.13e0 5.23e0 5.12e+0 4.77e+0  4.12e+0
#>  7 AFG     SP.POP.T… 2.01e7 2.10e7 2.20e7 2.31e7 2.41e+7 2.51e+7  2.59e+7
#>  8 AFG     SP.POP.G… 3.49e0 4.25e0 4.72e0 4.82e0 4.47e+0 3.87e+0  3.23e+0
#>  9 AGO     SP.URB.T… 8.23e6 8.71e6 9.22e6 9.77e6 1.03e+7 1.09e+7  1.15e+7
#> 10 AGO     SP.URB.G… 5.44e0 5.59e0 5.70e0 5.76e0 5.75e+0 5.69e+0  4.92e+0
#> # … with 1,046 more rows, and 11 more variables: `2007` <dbl>,
#> #   `2008` <dbl>, `2009` <dbl>, `2010` <dbl>, `2011` <dbl>, `2012` <dbl>,
#> #   `2013` <dbl>, `2014` <dbl>, `2015` <dbl>, `2016` <dbl>, `2017` <dbl>
Naším cílem je vytvořit přehledný datový soubor, kde každá proměnná je v samostatném sloupci. Zatím není jasné, jaké konkrétní kroky jsou potřeba, ale začneme s nejzřejmějším problémem: rok je rozložen do několika sloupců.
Abychom to opravili, je třeba použít funkci pivot_longer().
pop2 %
  pivot_longer(`2000`:`2017`, names_to = "year")
#> # A tibble: 19,008 x 4
#> country indicator year value
#> <chr> <chr> <chr> <dbl>
#> 1 ABW SP.URB.TOTL 2000 42444
#> 2 ABW SP.URB.TOTL 2001 43048
#> 3 ABW SP.URB.TOTL 2002 43670
#> 4 ABW SP.URB.TOTL 2003 44246
#> 5 ABW SP.URB.TOTL 2004 44669
#> 6 ABW SP.URB.TOTL 2005 44889
#> 7 ABW SP.URB.TOTL 2006 44881
#> 8 ABW SP.URB.TOTL 2007 44686
#> 9 ABW SP.URB.TOTL 2008 44375
#> 10 ABW SP.URB.TOTL 2009 44052
#> # … with 18,998 more rowsDalším krokem je zvážit proměnnou indicator.
pop2 %>% count(indicator)
#> # A tibble: 4 x 2
#>   indicator       n
#>   <chr>       <int>
#> 1 SP.POP.GROW  4752
#> 2 SP.POP.TOTL  4752
#> 3 SP.URB.GROW  4752
#> 4 SP.URB.TOTL  4752
Kde SP.POP.GROW je růst populace, SP.POP.TOTL je celkový počet obyvatel a SP.URB. * je totéž, ale pouze pro městské oblasti. Rozdělme tyto hodnoty na dvě proměnné: area — lokalita (total nebo urban) a proměnnou obsahující skutečné údaje (population nebo growth):
pop3 %
  separate(indicator, c(NA, "area", "variable"))
#> # A tibble: 19,008 x 5
#> country area variable year value
#> <chr> <chr> <chr> <chr> <dbl>
#> 1 ABW URB TOTL 2000 42444
#> 2 ABW URB TOTL 2001 43048
#> 3 ABW URB TOTL 2002 43670
#> 4 ABW URB TOTL 2003 44246
#> 5 ABW URB TOTL 2004 44669
#> 6 ABW URB TOTL 2005 44889
#> 7 ABW URB TOTL 2006 44881
#> 8 ABW URB TOTL 2007 44686
#> 9 ABW URB TOTL 2008 44375
#> 10 ABW URB TOTL 2009 44052
#> # … with 18,998 more rowsNyní zbývá pouze rozdělit proměnnou variable na dva sloupce:
pop3 %>%
  pivot_wider(names_from = variable, values_from = value)
#> # A tibble: 9,504 x 5
#> country area year TOTL GROW
#> <chr> <chr> <chr> <dbl> <dbl>
#> 1 ABW URB 2000 42444 1.18
#> 2 ABW URB 2001 43048 1.41
#> 3 ABW URB 2002 43670 1.43
#> 4 ABW URB 2003 44246 1.31
#> 5 ABW URB 2004 44669 0.951
#> 6 ABW URB 2005 44889 0.491
#> 7 ABW URB 2006 44881 -0.0178
#> 8 ABW URB 2007 44686 -0.435
#> 9 ABW URB 2008 44375 -0.698
#> 10 ABW URB 2009 44052 -0.731
#> # … with 9,494 more rowsSeznam kontaktů
Poslední příklad, představte si, že máte seznam kontaktů, který jste zkopírovali a vložili z webových stránek:
contacts <- tribble(
  ~field, ~value,
  "name", "Jiena McLellan",
  "company", "Toyota",
  "name", "John Smith",
  "company", "google",
  "email", "john@google.com",
  "name", "Huxley Ratcliffe"
)
Přivést tento seznam do tabulkového formátu je dost obtížné, protože neexistuje proměnná, která by identifikovala, jaká data patří kterému kontaktu. Můžeme to opravit tím, že si všimneme, že údaje o každém novém kontaktu začínají jménem ("name"), proto můžeme vytvořit jedinečný identifikátor a zvyšovat ho o jeden pokaždé, když se ve sloupci field objeví hodnota "name":
contacts %
  mutate(
    person_id = cumsum(field == "name")
  )
contacts
#> # A tibble: 6 x 3
#> field value person_id
#> <chr> <chr> <int>
#> 1 name Jiena McLellan 1
#> 2 company Toyota 1
#> 3 name John Smith 2
#> 4 company google 2
#> 5 email john@google.com 2
#> 6 name Huxley Ratcliffe 3Nyní, když máme jedinečný identifikátor pro každého kontaktu, můžeme otočit pole a hodnotu do sloupců:
contacts %>%
  pivot_wider(names_from = field, values_from = value)
#> # A tibble: 3 x 4
#> person_id name company email
#> <int> <chr> <chr> <chr>
#> 1 1 Jiena McLellan Toyota <NA>
#> 2 2 John Smith google john@google.com
#> 3 3 Huxley Ratcliffe <NA> <NA>Závěr
Osobně si myslím, že nový koncept tidyr je opravdu intuitivně srozumitelnější a výrazně převyšuje ve funkcionalitě zastaralé funkce. spread() a gather()Doufám, že vám tento článek pomohl pochopit pivot_longer() a pivot_wider().
Zdroj: habr.com
