

Ať se technologie vyvíjejí jakkoli, vždy se za nimi táhne řada zastaralých přístupů. Může to být dáno plynulým přechodem, lidským faktorem, technologickými potřebami nebo čímkoli jiným. V oblasti zpracování dat jsou nejvýraznějšími příklady datové zdroje. Ať si přejeme se toho zbavit, část dat se stále přenáší v messengeru a e-mailech, nemluvě o více archaických formátech. Zveme vás, abyste se pod kat rozebrali jeden z variant pro Apache Airflow, který ilustruje, jak lze získávat data z elektronické pošty.
Pozadí
Mnoho dat se dodnes přenáší prostřednictvím e-mailu, počínaje mezilidskou komunikací a konče standardy interakce mezi firmami. Je dobré, když se podaří napsat rozhraní pro získávání dat nebo přidělit lidi v kanceláři, kteří tuto informaci budou vkládat do pohodlnějších zdrojů, ale často taková možnost prostě není. Konkrétní úkol, s nímž jsem se setkal, je připojení známého CRM systému k datovému skladu a následně k systému OLAP. Historicky se stalo, že pro naši společnost bylo používání tohoto systému pohodlné v určité oblasti podnikání. Proto by všichni rádi měli možnost manipulovat s daty i z tohoto externího systému. V první řadě byla samozřejmě prozkoumána možnost získávání dat z otevřeného API. Bohužel, API nepokrývalo získávání všech potřebných dat a, abych byl upřímný, bylo v mnoha ohledech nedokonalé, přičemž technická podpora nechtěla, nebo nemohla vyhovět vstřícnému požadavku na poskytnutí vyčerpávajícího funkčního rozsahu. Na druhou stranu, tento systém nabízel možnost pravidelného získávání chybějících dat na e-mail ve formě odkazu pro stažení archivu.
Je třeba poznamenat, že to nebyl jediný případ, kdy chtěl business shromažďovat data z e-mailů nebo messengerů. Nicméně v tomto případě jsme nemohli ovlivnit externí společnost, která poskytuje část dat pouze tímto způsobem.
Apache Airflow
Pro stavbu ETL procesů většinou používáme Apache Airflow. Aby čtenář, který s touto technologií není obeznámen, lépe pochopil, jak to vypadá v kontextu a celkově, popíšu pár úvodních informací.
Apache Airflow je open-source platforma, která se používá pro stavbu, vykonávání a monitorování ETL (Extract-Transform-Loading) procesů v jazyce Python. Hlavním konceptem v Airflow je orientovaný acyklický graf, kde vrcholy grafu představují konkrétní procesy a hrany grafu představují tok řízení nebo informací. Proces může jednoduše volat jakoukoli Python funkci, nebo může mít složitější logiku z sekvenčního volání několika funkcí v rámci třídy. Pro nejčastější operace již existuje spousta připravených prací, které lze použít jako procesy. Mezi tyto práce patří:
- operátory — pro přenos dat z jednoho místa na druhé, například z tabulky databáze do datového skladu;
- senzory — pro čekání na určitý událost a směrování toku řízení k následujícím vrcholům grafu;
- hooky — pro nízkoúrovňové operace, například pro získání dat z tabulky databáze (používají se v operátorech);
- atd.
Podrobně popisovat Apache Airflow v tomto článku by bylo nevhodné. Stručné úvody lze vidět nebo .
Hook pro získání dat
V první řadě, pro vyřešení úkolu je potřeba napsat hook, pomocí kterého bychom mohli:
- připojit se k e-mailu;
- najít požadovaný e-mail;
- získat data z e-mailu.
from airflow.hooks.base_hook import BaseHook
import imaplib
import logging

class IMAPHook(BaseHook):
    def __init__(self, imap_conn_id):
        """
           IMAP hook pro získání dat z e-mailu

           :param imap_conn_id:       Identifikátor připojení k e-mailu
           :type imap_conn_id:        string
        """
        self.connection = self.get_connection(imap_conn_id)
        self.mail = None

    def authenticate(self):
        """
            Připojujeme se k e-mailu
        """
        mail = imaplib.IMAP4_SSL(self.connection.host)
        response, detail = mail.login(user=self.connection.login, password=self.connection.password)
        if response != "OK":
            raise AirflowException("Přihlášení selhalo")
        else:
            self.mail = mail

    def get_last_mail(self, check_seen=True, box="INBOX", condition="(UNSEEN)"):
        """
            Metoda pro získání identifikátoru posledního e-mailu,
            který splňuje podmínky hledání

            :param check_seen:      Označit poslední e-mail jako přečtený
            :type check_seen:       bool
            :param box:             Název schránky
            :type box:              string
            :param condition:       Podmínky pro hledání e-mailů
            :type condition:        string
        """
        self.authenticate()
        self.mail.select(mailbox=box)
        response, data = self.mail.search(None, condition)
        mail_ids = data[0].split()
        logging.info("Ve schránce byly nalezeny následující e-maily: " + str(mail_ids))

        if not mail_ids:
            logging.info("Žádné nové e-maily nenalezeny")
            return None

        mail_id = mail_ids[0]

        # pokud je takových e-mailů více
        if len(mail_ids) > 1:
            # označíme ostatní jako přečtené
            for id in mail_ids:
                self.mail.store(id, "+FLAGS", "\Seen")

            # vracíme poslední
            mail_id = mail_ids[-1]

        # je potřeba označit poslední jako přečtený
        if not check_seen:
            self.mail.store(mail_id, "-FLAGS", "\Seen")

        return mail_id
Logika je následující: připojíme se, najdeme poslední nejaktuálnější e-mail, pokud existují další — ignorujeme je. Používá se právě taková funkce, protože novější e-maily obsahují všechna data těch starších. Pokud to tak není, můžeme vracet pole všech e-mailů nebo zpracovat první a ostatní při dalším průchodu. Obecně to vždy závisí na úkolu.
Přidáváme k hooku dvě pomocné funkce: pro stažení souboru a pro stažení souboru podle odkazu v emailu. Mimochodem, je možné je vyčlenit do samostatného operátoru, což závisí na frekvenci využívání této funkcionality. Co dalšího doplnit do hooku, opět závisí na úkolu: pokud v emailu přicházejí soubory, lze stahovat přílohy k emailu, pokud jsou data v emailu, je potřeba analyzovat email atd. V mém případě email přichází s jedním odkazem na archiv, který potřebuji uložit na určité místo a spustit další proces zpracování.
    def download_from_url(self, url, path, chunk_size=128):
        """
            Metoda pro stažení souboru

            :param url:              Adresa pro stažení
            :type url:               string
            :param path:             Kam uložit soubor
            :type path:              string
            :param chunk_size:       Po kolika bytech zapisovat
            :type chunk_size:        int
        """
        r = requests.get(url, stream=True)
        with open(path, "wb") as fd:
            for chunk in r.iter_content(chunk_size=chunk_size):
                fd.write(chunk)

    def download_mail_href_attachment(self, mail_id, path):
        """
            Metoda pro stažení souboru podle odkazu v emailu

            :param mail_id:         Identifikátor emailu
            :type mail_id:          string
            :param path:            Kam uložit soubor
            :type path:             string
        """
        response, data = self.mail.fetch(mail_id, "(RFC822)")
        raw_email = data[0][1]
        raw_soup = raw_email.decode().replace("r", "").replace("n", "")
        parse_soup = BeautifulSoup(raw_soup, "html.parser")
        link_text = ""

        for a in parse_soup.find_all("a", href=True, text=True):
            link_text = a["href"]

        self.download_from_url(link_text, path)
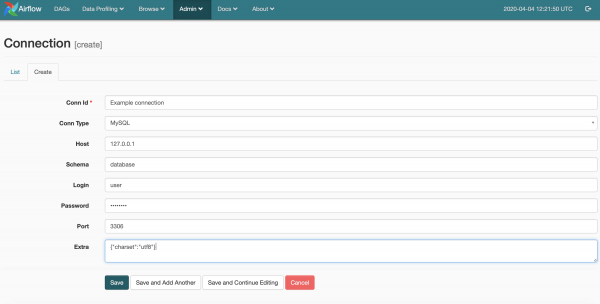
Kód je jednoduchý, a proto pravděpodobně nepotřebuje další vysvětlení. Řeknu jen něco o magické větě imap_conn_id. Apache Airflow uchovává parametry připojení (uživatelské jméno, heslo, adresu a další parametry), na které lze odkazovat podle řetězcového identifikátoru. Vizuálně řízení připojení vypadá takto
Senzor pro čekání na data
Jelikož už umíme připojit a získávat data z e-mailu, nyní můžeme napsat senzor pro jejich očekávání. Napsat hned operátor, který by zpracovával data, pokud jsou k dispozici, se mi nepodařilo, protože na základě získaných dat z e-mailu fungují i další procesy, včetně těch, které berou související data z jiných zdrojů (API, telefonie, webové metriky atd.). Uvedu příklad. V CRM systému se objevil nový uživatel a ještě neznáme jeho UUID. Při pokusu získat data z SIP telefonie tak obdržíme hovory spojené s jeho UUID, ale nemůžeme je správně uložit a využít. V takových případech je důležité mít na paměti závislost dat, obzvlášť pokud pocházejí z různých zdrojů. To jsou sice nedostatečné prostředky pro zachování integrity dat, ale v některých případech nezbytné. A také není rozumné zbytečně zatěžovat zdroje.
Tím pádem náš senzor spustí následující vrcholy grafu, pokud jsou na e-mailu čerstvé informace, a také označí předchozí informace jako neaktuální.
from airflow.sensors.base_sensor_operator import BaseSensorOperator
from airflow.utils.decorators import apply_defaults
from my_plugin.hooks.imap_hook import IMAPHook

class MailSensor(BaseSensorOperator):
    @apply_defaults
    def __init__(self, conn_id, check_seen=True, box="Doručená pošta", condition="(UNSEEN)", *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.conn_id = conn_id
        self.check_seen = check_seen
        self.box = box
        self.condition = condition

    def poke(self, context):
        conn = IMAPHook(self.conn_id)
        mail_id = conn.get_last_mail(check_seen=self.check_seen, box=self.box, condition=self.condition)

        if mail_id is None:
            return False
        else:
            return True
Získáváme a používáme data
Pro získávání a zpracovávání dat lze napsat samostatného operátora, nebo použít ty stávající. Jelikož je logika zatím triviální — získat data z e-mailu, navrhuji pro příklad standardní PythonOperator.
from airflow.models import DAG

from airflow.operators.python_operator import PythonOperator
from airflow.sensors.my_plugin import MailSensor
from my_plugin.hooks.imap_hook import IMAPHook

start_date = datetime(2020, 4, 4)

# Standard configuration of the graph
args = {
    "owner": "example",
    "start_date": start_date,
    "email": ["home@home.ru"],
    "email_on_failure": False,
    "email_on_retry": False,
    "retry_delay": timedelta(minutes=15),
    "provide_context": False,
}

dag = DAG(
    dag_id="test_etl",
    default_args=args,
    schedule_interval="@hourly",
)

# Define the sensor
mail_check_sensor = MailSensor(
    task_id="check_new_emails",
    poke_interval=10,
    conn_id="mail_conn_id",
    timeout=10,
    soft_fail=True,
    box="my_box",
    dag=dag,
    mode="poke",
)

# Function to fetch data from the email
def prepare_mail():
    imap_hook = IMAPHook("mail_conn_id")
    mail_id = imap_hook.get_last_mail(check_seen=True, box="my_box")
    if mail_id is None:
        raise AirflowException("Empty mailbox")

    conn.download_mail_href_attachment(mail_id, "./path.zip")

prepare_mail_data = PythonOperator(task_id="prepare_mail_data", default_args=args, dag=dag, python_callable= prepare_mail)

# Description of other graph nodes
...

# Set connections in the graph
mail_check_sensor >> prepare_mail_data
prepare_data >> ...
# Description of other control flows
Mimochodem, pokud máte firemní e-mail také na mail.ru, nebudete moci vyhledávat e-maily podle tématu, odesílatele a podobně. Slíbili to už v dávném roce 2016, ale zřejmě si to rozmysleli. Řešil jsem to vytvořením samostatné složky pro potřebné e-maily a nastavením filtru na potřebné e-maily v webovém rozhraní. Tímto způsobem se do této složky dostanou pouze potřebné e-maily a podmínky pro vyhledávání jsou v mém případě jednoduše (UNSEEN).
Shrneme to, máme následující sekvenci: zkontrolujeme, zda jsou nové e-maily splňující podmínky, pokud existují, stáhneme archiv podle odkazu z posledního e-mailu.
Pod posledními mnoha tečkami je vynecháno, že tento archiv bude rozbalen, data z archivu vyčištěna a zpracována, a nakonec to vše půjde na další ETL proces, ale to už přesahuje téma článku. Pokud to bylo zajímavé a užitečné, rád budu pokračovat v popisu ETL řešení a jejich částí pro Apache Airflow.
Zdroj: habr.com
