

Ahoj, jmenuji se Alexandr a jsem inženýr kvality dat, který se zabývá kontrolou dat na kvalitu. V tomto článku se podíváme na to, jak jsem se k tomu dostal a proč se v roce 2020 ukázalo toto odvětví testování jako klíčové.
Světový trend
Dnešní svět prochází dalším technologickým revolucí, jejíž jedním z aspektů je využívání akumulovaných dat různými společnostmi k podpoře vlastního prodeje, zisků a PR. Zdá se, že právě dostupnost kvalitních dat a schopných mozků, které z nich dokážou udělat peníze (správně je zpracovat, vizualizovat, vytvořit modely strojového učení atd.), jsou dnes klíčem k úspěchu pro mnohé. Zatímco před 15-20 lety se intenzivní práce na akumulaci a monetizaci dat soustředila hlavně na velké firmy, dnes je to výsadou téměř všech rozumných subjektů.
Vzhledem k tomu před několika lety všechny portály věnované hledání práce po celém světě začaly přetékáním nabídkami na pozice Data Scientist, protože všichni byli přesvědčeni, že pokud mají ve svém týmu takového specialistu, mohou vytvořit supermodel strojového učení, předpovědět budoucnost a udělat "kvantový skok" pro firmu. Postupem času lidé pochopili, že tento přístup téměř nikde nefunguje, protože ne všechna data, která se dostanou do rukou těchto specialistů, jsou vhodná pro trénink modelů.
A začaly požadavky od Data Scientistů: "Kupme ještě data od těchto a těch...", "Nedostáváme dost dat...", "Potřebujeme ještě trochu dat a ideálně kvalitních...". Na základě těchto požadavků se začaly vytvářet četné interakce mezi společnostmi, které vlastní různé sady dat. To samozřejmě vyžadovalo technickou organizaci tohoto procesu — připojit se k datovému zdroji, stáhnout data, zkontrolovat, že byla plně nahrána, atd. Počet takových procesů začal růst a dnes máme obrovskou poptávku po jiném druhu specialistů — inženýrech kvality dat — těch, kdo by sledovali tok dat v systému (data pipelines), kvalitu dat na vstupu a výstupu a vyvodili závěry o jejich dostatečnosti, celistvosti a dalších charakteristikách.
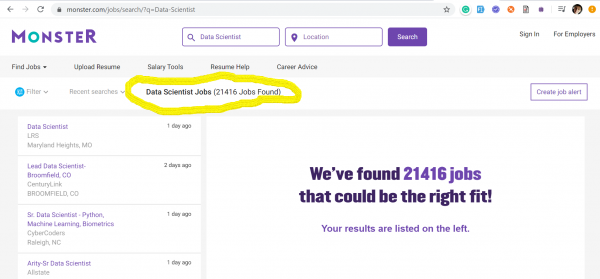
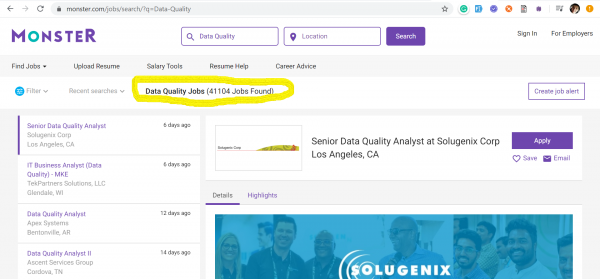
Trend kvality datových inženýrů k nám přišel ze Spojených států, kde v bouřlivé éře kapitalismu nikdo není připraven prohrát bitvu o data. Níže jsem uvedl screenshoty z dvou nejpopulárnějších pracovních portálů v USA: a — na kterých jsou zobrazeny údaje k 17. březnu 2020 o počtu vyhlášených pracovních pozic podle klíčových slov: Data Quality a Data Scientist.
Data Scientists – 21,416 pracovních pozic
Data Quality – 41,104 pracovních pozic
Data Scientists – 404 pracovních pozic
Data Quality – 2,020 pracovních pozic
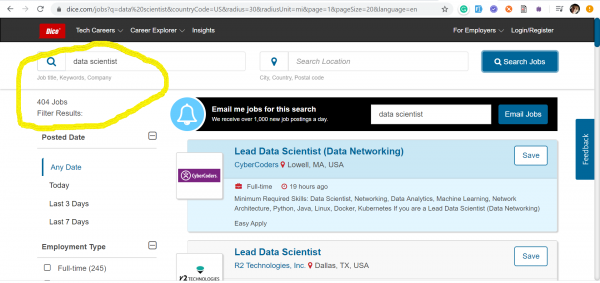
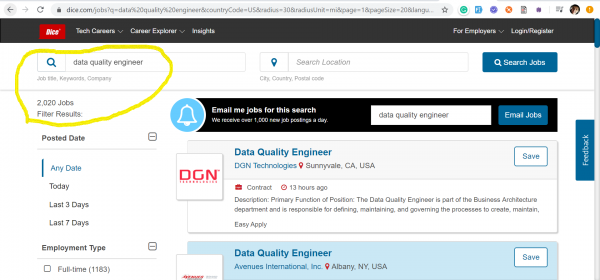
Je zřejmé, že tyto profese si navzájem nekonkurují. Screenshoty jsem chtěl pouze ilustrovat aktuální situaci na trhu práce, pokud jde o poptávku po inženýrech kvality dat, kterých je nyní výrazně více než po Data Scientists.
V červnu 2019 společnost EPAM, reagujíc na potřeby moderního IT trhu, vyčlenila Data Quality jako samostatnou praxi. Data Quality inženýři ve své každodenní práci spravují data, kontrolují jejich chování v nových podmínkách a systémech, monitorují relevanci dat, jejich dostatečnost a aktuálnost. Přestože v praktickém smyslu se Data Quality inženýři skutečně věnují klasickému funkčnímu testování pouze málo, NE což silně závisí na projektu (příklad uvedu dále).
Povinnosti Data Quality inženýra se neomezují pouze na rutinní manuální/automatické kontroly na „nulls, count a sums“ v databázových tabulkách, ale vyžadují hluboké pochopení obchodních potřeb klienta a odpovídajícím způsobem schopnosti transformovat dostupná data na užitečné obchodní informace.
Teorie kvality dat
Abychom si co nejlépe představili roli takového inženýra, pojďme si objasnit, co vlastně kvalitní data v teorii znamenají.
Kvalita dat — je jedním z kroků správy dat (celý svět, který vám ponecháme na samostatné studium) a zodpovídá za analýzu dat podle následujících kritérií:
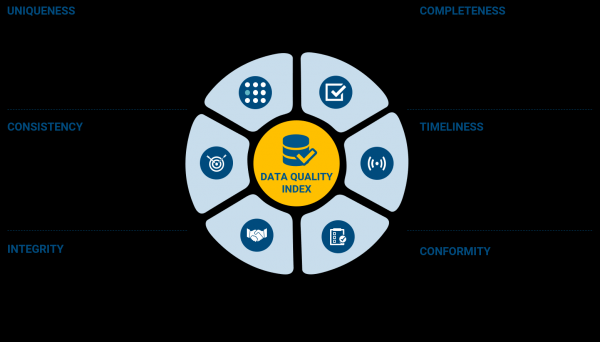
Myslím, že není potřeba rozebírat každý z bodů (v teorii se nazývají „data dimensions“), jsou dobře popsány na obrázku. Avšak samotný proces testování nepředpokládá striktní kopírování těchto charakteristik do testovacích scénářů a jejich kontrolu. V oblasti kvality dat, stejně jako v jiných typech testování, je třeba se především řídit požadavky na kvalitu dat, které byly dohodnuty s účastníky projektu, přijímajícími obchodní rozhodnutí.
V závislosti na projektu může inženýr kvality dat vykonávat různé funkce: od obvyklého testera-automatizátora s povrchními posouzeními kvality dat až po osobu, která provádí hluboké profilování podle výše uvedených charakteristik.
Velmi podrobné popisy procesů správy dat, kvality dat a příbuzných témat jsou skvěle popsány v knize s názvem „DAMA-DMBOK: Data Management Body of Knowledge: 2nd Edition“. Tuto knihu velmi doporučuji jako úvod do této tématiky (odkaz na ni najdete na konci článku).
Můj příběh
V IT průmyslu jsem prošel cestou od Junior testera v produktových firmách až po Lead Data Quality Engineer ve společnosti EPAM. Po přibližně dvou letech práce jako tester jsem měl pevné přesvědčení, že jsem vykonal všechny druhy testování: regresní, funkční, stresové, stability, bezpečnosti, UI atd. — a vyzkoušel jsem velké množství testovacích nástrojů, přičemž jsem pracoval ve třech programovacích jazycích: Java, Scala, Python.
Když se ohlédnu zpět, chápu, proč se soubor mých profesionálních dovedností ukázal být tak různorodý — účastnil jsem se projektů spojených s prací s daty, velkými i malými. To mě přivedlo do světa mnoha nástrojů a příležitostí pro růst.
Abychom ocenili rozmanitost nástrojů a možností, jak získávat nové znalosti a dovednosti, stačí se podívat na obrázek níže, na kterém jsou zobrazeny ty nejpopulárnější z nich ve světě „Data & AI“.
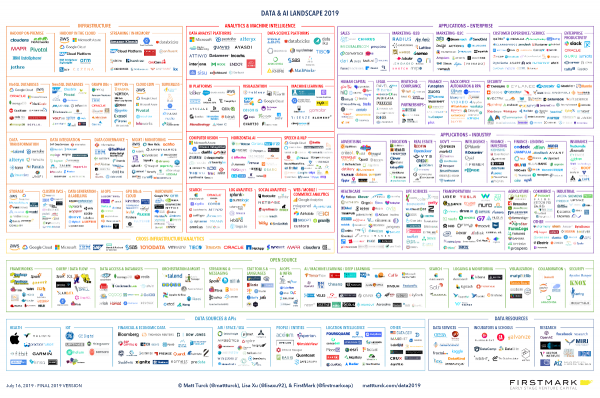
Takovéto ilustrace každoročně vytváří jeden z renomovaných venture kapitalistů Matt Turck, který pochází z vývoje softwaru. Zde je jeho blog a , kde pracuje jako partner.
Obzvlášť rychle jsem profesionálně rostl, když jsem byl jediným testerem na projektu, nebo alespoň na začátku projektu. Právě v takovém okamžiku je třeba převzít odpovědnost za celý testovací proces, a nemáte možnost ustoupit, pouze jít vpřed. Zpočátku to bylo děsivé, ale nyní jsou mi jasné všechny výhody takového zkoušení:
- Začínáte komunikovat s celým týmem jako nikdy předtím, protože neexistuje žádný prokurátor pro komunikaci: žádný testovací manažer, žádní kolegové testeři.
- Ponoření do projektu se stává neuvěřitelně hlubokým a máte informace o všech komponentech jak v obecné, tak v detailní rovině.
- Vývojáři na vás nepohlížejí jako na "toho kluka z testování, který dělá nevysvětlitelné věci", ale spíše jako na rovnocenného kolegu, který tým přináší neuvěřitelný přínos svými automatickými testy a předvídáním vzniku chyb v konkrétní části produktu.
- V důsledku toho jste efektivnější, kvalifikovanější a žádanější.
Jak projekt rostl, v 100% případů jsem se stal mentorem pro nově příchozí testery, školil jsem je a předával jim znalosti, které jsem sám získal. V závislosti na projektu jsem však ne vždy dostal od vedení specialisty na automatizované testování vysoké úrovně a byla potřeba buď je školit v automatizaci (pro zájemce), nebo vytvářet nástroje pro jejich používání v každodenních aktivitách (nástroje pro generování dat a jejich nahrávání do systému, nástroj pro provádění zátěžového testování/testování stability „rychle“ atd.).
Příklad konkrétního projektu
Bohužel, kvůli závazkům o mlčenlivosti nemohu podrobně vyprávět o projektech, na kterých jsem pracoval, ale uvedu příklady typických úkolů inženýra kvality dat na jednom z projektů.
Podstatou projektu bylo realizovat platformu pro přípravu dat pro školení strojového učení. Objednavatelem byla velká farmaceutická společnost z USA. Technicky to byl cluster , postavený na instancích, s několika mikroslužbami a založeným na open-source projektu firmy EPAM — , přizpůsobeným potřebám konkrétního objednavatele (nyní byl projekt přetvořen na ). ETL procesy byly uspořádány pomocí a přesouvali data z systému zákazníka do Buckets. Poté se na platformu nasadil Docker obraz modelu strojového učení, který se trénoval na aktuálních datech a prostřednictvím REST API rozhraní poskytoval předpovědi, které zajímaly podniky a řešily konkrétní úkoly.
Vizuálně to vypadalo asi takto:
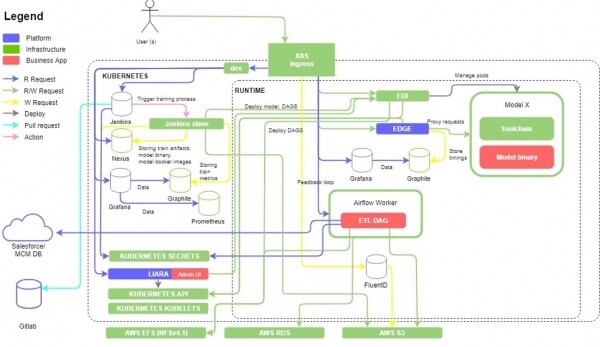
Funkčního testování na tomto projektu bylo dostatek, a vzhledem k rychlosti vývoje funkcionalit a potřebě udržovat tempo release cyklu (dvoutýdenní sprinty) bylo třeba hned přemýšlet o automatizaci testování nejkritičtějších částí systému. Většina samotné platformy postavené na Kubernetes byla pokryta automatizovanými testy, které byly implementovány v + Python, ale bylo také třeba je udržovat a rozšiřovat. Kromě toho, pro pohodlí zákazníka, byla vytvořena GUI pro správu modelů strojového učení, nasazených na clusteru, stejně jako možnost uvést, odkud a kam je třeba přesunout data pro trénink modelů. Tato rozsáhlá funkce vedla k rozšíření automatizovaných funkčních kontrol, které se převážně prováděly prostřednictvím REST API volání a malé části end-to-end UI testů. Přibližně v polovině tohoto procesu se k nám přidal manuální tester, který exceloval v akceptačním testování verzí produktu a komunikaci se zákazníkem ohledně akceptace dalšího releasu. Díky příchodu nového specialisty jsme mohli dokumentovat naši práci a přidat několik velmi důležitých manuálních kontrol, které bylo složité ihned automatizovat.
A konečně, poté, co jsme dosáhli stability platformy a vytvořili nadstavbu GUI, jsme se pustili do budování ETL pipeline pomocí Apache Airflow DAGs. Automatizovaná kontrola kvality dat byla prováděna pomocí speciálně napsaných Airflow DAGs, které kontrolovaly data na základě výsledků práce ETL procesu. V rámci tohoto projektu jsme měli štěstí, protože klient nám poskytl přístup k anonymizovaným datovým sadám, na kterých jsme testovali. Kontrolovali jsme data po řádcích na shodu typů, přítomnost poškozených dat, celkový počet záznamů před a po, srovnání transformací provedených ETL procesem z hlediska agregace, změny názvů sloupců a další. Kromě toho byly tyto kontroly škálovány na různé zdroje dat, například kromě SalesForce také na MySQL.
Kontroly konečné kvality dat se prováděly na úrovni S3, kde byly uloženy a byly připraveny k použití pro výuku modelů strojového učení. Pro získání dat z konečného CSV souboru, který ležel v S3 Bucket, a jejich validaci, byl napsán kód pomocí .
Také z pohledu klienta byl požadavek na uchování části dat v jednom S3 Bucketu a části v jiném. K tomu bylo také potřeba napsat dodatečné kontroly, které kontrolovaly důvěryhodnost takového třídění.
Obecné zkušenosti z jiných projektů
Příklad nejvíce základního seznamu aktivit Data Quality inženýra:
- Připravit testovací data (platná, neplatná, velká, malá) prostřednictvím automatizovaného nástroje.
- Nahrát připravenou datovou sadu do zdrojového systému a zkontrolovat její připravenost k použití.
- Spustit ETL procesy na zpracování datové sady ze zdrojového úložiště do konečného nebo mezilehlého stavu s použitím určitého souboru nastavení (pokud je možné zadat konfigurovatelné parametry pro ETL úlohu).
- Ověřit zpracovaná data ETL procesem z hlediska jejich kvality a shody s obchodními požadavky.
Hlavní důraz při kontrolách by se měl klást nejen na to, zda datový tok v systému vůbec proběhl a dosáhl konce (což je součástí funkčního testování), ale především na kontrolu a validaci dat z hlediska souladu s očekávanými požadavky, odhalování anomálií a podobně.
Nástroje
Jednou z technik takové kontroly dat může být organizace řetězových kontrol na každé fázi zpracování dat, nazývaná v literatuře "data chain" — kontrola dat od zdroje až po místo konečného použití. Takové kontroly se většinou realizují pomocí psaní kontrolních SQL dotazů. Je jasné, že tyto dotazy by měly být co nejlehčí a zaměřeny na jednotlivé úseky kvality dat (metadata tabulek, prázdné řádky, NULL hodnoty, syntaktické chyby — další požadované kontrolní atributy).
Při regresním testování, kde se používají již připravené (neměnitelné nebo jen mírně měnitelné) datové sady, mohou v kódu automatických testů existovat již hotové šablony pro kontrolu dat na shodu s kvalitou (popis očekávaných metadat tabulek; výběrové objekty, které mohou být náhodně vybírány během testu, a další).
Během testování je také nutné psát testovací ETL procesy pomocí rámců jako je Apache Airflow, nebo dokonce nástroje typu black-box cloud, například , a další. Tato skutečnost nutí testovací inženýry ponořit se do principů fungování výše uvedených nástrojů a efektivně provádět jak funkční testování (například existujících ETL procesů na projektu), tak je využívat pro kontrolu dat. Konkrétně pro Apache Airflow již existují hotové operátory pro práci s populárními analytickými databázemi, jako je . Nejzákladnější příklad jeho použití již byl uveden , takže se nebudu opakovat.
Kromě hotových řešení nikdo vám nezakazuje implementovat své vlastní techniky a nástroje. To bude pro projekt nejen přínosem, ale i pro samotného Data Quality Engineer, který si tím rozšíří své technické obzory a dovednosti v programování.
Jak to funguje na skutečném projektu
Dobrou ilustrací posledních odstavců o „datovém řetězci“, ETL a všudypřítomných kontrolách je následující proces z jednoho reálného projektu:
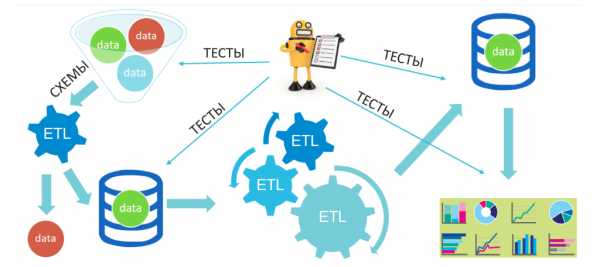
Zde do vstupní „trychtýře“ našeho systému přicházejí různé údaje (pochopitelně připravené námi): platné, neplatné, smíšené atd., poté jsou filtrovány a putují do meziskladiště, kde na ně čeká další řada transformací, a poté jsou uloženy do konečného úložiště, ze kterého bude následně probíhat analytika, tvorba datových vitrín a vyhledávání obchodních poznatků. V takovém systému, aniž bychom funkčně ověřovali pracovní postupy ETL, se zaměřujeme na kvalitu dat před a po transformacích a také na výstup pro analytiku.
Shrnuto, bez ohledu na místa, kde jsem pracoval, byl jsem všude zapojen do datových projektů, které spojovaly následující rysy:
- Pouze prostřednictvím automatizace lze ověřit některé případy a dosáhnout uspokojivého vydání pro podnik.
- Tester v takovém projektu je jedním z nejrespektovanějších členů týmu, protože přináší obrovský přínos každému z účastníků (urychlení testování, kvalitní data pro data science, odhalování chyb v raných fázích).
- Nezáleží na tom, zda pracujete na vlastním hardwaru nebo v cloudu — všechny zdroje jsou zabalena v klastry typu Hortonworks, Cloudera, Mesos, Kubernetes atd.
- Projekty jsou postaveny na mikroservisním přístupu s dominujícími distribuovanými a paralelními výpočty.
Upozorňuji, že při testování v oblasti kvality dat se tester zaměřuje na kód produktu a použité nástroje.
Charakteristické rysy testování kvality dat
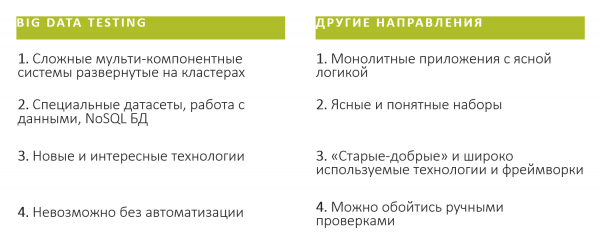
Kromě toho jsem si vybral následující (hned dodám, že velmi zjednodušené a výhradně subjektivní) charakteristické rysy testování v Date (Big Data) projektech (systémech) a dalších oblastech:
Užitečné odkazy
- Teorie: .
- EPAM
- Doporučené materiály pro začínajícího inženýra kvality dat:
- Bezplatný kurz na Stepik: .
- Kurz na LinkedIn Learning: .
- Články:
- ;
- ;
- ;
- Video:
- ;
- ;
Závěr
Kvalita dat — to je velmi mladá perspektivní oblast, jejíž součástí být znamená být součástí jakéhosi startupu. Pokud se dostanete do Data Quality, ponoříte se do velkého množství moderních, žádaných technologií, ale co je nejdůležitější — před vámi se otevřou obrovské příležitosti pro generování a realizaci vašich nápadů. Budete moci využít přístup neustálého zlepšování nejen v projektu, ale i pro sebe, neustále se rozvíjející jako odborník.
Zdroj: habr.com
