

Ahoj, Habr!
Data jsou nejcennějším aktivem společnosti. Tohle tvrdí snad každá firma orientující se na digitální technologie. A těžko s tím polemizovat: bez diskuzí o přístupech k řízení, uchovávání a zpracování dat se dnes neobejde žádná velká IT konference.
Data k nám přicházejí zvenčí, také se formují uvnitř firmy, a pokud mluvíme o datech telekomunikační firmy, pak to je pro interní zaměstnance pokladnice informací o klientovi, jeho zájmech, zvycích či umístění. Při správném profilování a segmentaci reklamní nabídky fungují nejefektivněji. Nicméně, v praxi to není tak růžové. Data, která firmy uchovávají, mohou být beznadějně zastaralá, nadbytečná, opakující se, nebo o jejich existenci neví nikdo jiný než úzký okruh uživatelů. ¯_(ツ)_/¯
Jinými slovy, s daty je třeba efektivně nakládat – pouze v tomto případě se stanou aktivem, které přináší podniku skutečný prospěch a zisk. Bohužel, pro řešení otázek správy dat je třeba překonat poměrně mnoho obtíží. Ty jsou převážně podmíněny jak historickým dědictvím v podobě «zoo» systémů, tak absencí jednotných procesů a přístupů k jejich řízení. Ale co znamená „řídit data“?
O tom si právě popovídáme pod článkem, a také o tom, jak nám pomohl open-source stack.
Koncept strategického řízení dat Data Governance (DG) je na ruském trhu už dost známý a cíle, kterých podniky dosahují jeho implementací, jsou jasné a jednoznačně deklarované. Naše firma se stala výjimkou a stanovila si za úkol implementaci konceptu řízení dat.
Takže, čím jsme začali? Nejprve jsme si stanovili klíčové cíle:
- Zajistit dostupnost našich dat.
- Zajistit transparentnost životního cyklu dat.
- Poskytnout uživatelům firmy konzistentní a nespochybnitelná data.
- Poskytnout uživatelům firmy ověřená data.
V současné době je na trhu software dostupné několik desítek nástrojů třídy Data Governance.
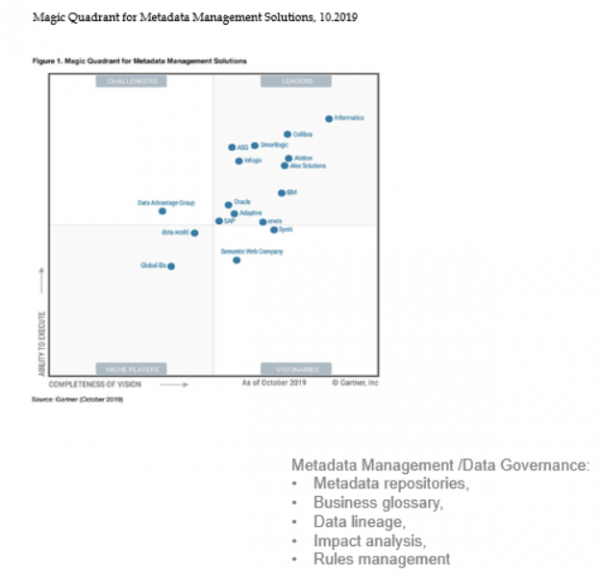
Ale po podrobném rozboru a studiu řešení jsme zaznamenali několik kritických poznámek:
- Většina výrobců nabízí komplexní soubor řešení, který je pro nás nadbytečný a duplicitně pokrývá již existující funkce. Navíc je integrace do stávající IT infrastruktury z pohledu zdrojů nákladná.
- Funkčnost a rozhraní jsou určeny pro technologické pracovníky, nikoli pro konečné podnikové uživatele.
- Nízká přizpůsobivost produktů a absence úspěšných implementací na ruském trhu.
- Vysoké náklady na software a jeho další podporu.
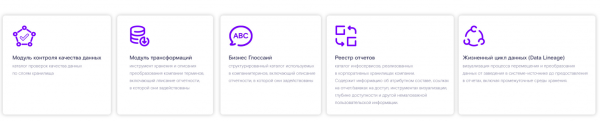
Uvedená kritéria a doporučení k importu softwaru pro ruské firmy nás přesvědčila jít směrem k vlastnímu vývoji na opensource stacku. Jako platformu jsme zvolili Django – bezplatný a svobodný framework napsaný v Pythonu. Takto jsme vymezili klíčové moduly, které budou podporovat výše uvedené cíle:
- Seznam zpráv.
- Podnikový glosář.
- Modul popisu technických transformací.
- Modul popisu životního cyklu dat od zdroje po nástroj BI.
- Modul kontroly kvality dat.
Seznam zpráv
Na základě interních výzkumů ve velkých firmách zaměstnanci tráví 40—80 % času hledáním dat při řešení úkolů souvisejících s daty. Proto jsme si dali za cíl zpřístupnit informace o existujících zprávách, které byly dříve dostupné pouze zákazníkům. To nám umožňuje zkrátit čas potřebný k tvorbě nových reportů a zajišťuje demokratizaci dat.
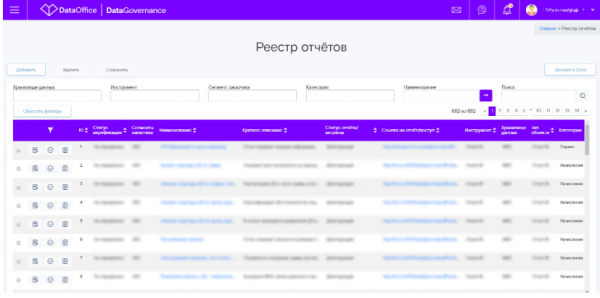
Seznam zpráv se stal jednotným oknem pro reportování pro interní uživatele z různých regionů, oddělení a divizí. Obsahuje konsolidované informace o infomačních službách, které byly vytvořeny v několika firemních úložištích, jichž je v Rostelekome hodně.
Ale seznam není jen suchý výpis vytvořených zpráv. Pro každou zprávu poskytujeme uživateli potřebné informace pro samostatné seznámení se s ní:
- krátký popis zprávy;
- úroveň dostupnosti dat;
- segment zákazníka;
- nástroj vizualizace;
- název firemního úložiště;
- podnikové funkční požadavky;
- odkaz na zprávu;
- odkaz na žádost o přístup;
- status realizace.
Podle zpráv je k dispozici analýza úrovně využití a zprávy jsou zařazeny na vrchol seznamu na základě analýzy protokolů podle počtu jedinečných uživatelů. A to není vše. Kromě obecných charakteristik jsme také zahrnuli podrobný popis atributů zpráv s příklady hodnot a metodikou výpočtů. Takový detail uživatelům okamžitě dává odpověď, zda je zpráva pro ně užitečná nebo ne.
Vývoj tohoto modulu se stal důležitým krokem k demokratizaci dat a významně zkrátil dobu hledání potřebných informací. Kromě zkrácení doby hledání se také snížil počet žádostí k týmu podpory o poskytování konzultací. Nelze nezmínit ještě jeden užitečný výsledek, kterého jsme dosáhli vytvořením jednotného registru zpráv – zabránění vývoji duplicitních zpráv pro různé strukturální jednotky.
Byznysový glosář
Všichni víte, že i v rámci jedné a té samé společnosti hovoří byznys jinými jazyky. Ano, používají ty samé termíny, ale rozumějí pod nimi zcela odlišné věci. Tento problém má řešit byznysový glosář.
Pro nás je byznysový glosář — nikoli pouze příručka s popisem termínů a metodologií výpočtu. Je to plnohodnotné prostředí pro vývoj, schvalování a potvrzování terminologie, budování vazeb mezi termíny a dalšími informačními aktivy společnosti. Než se termín dostane do byznysového glosáře, musí projít všemi fázemi schvalování s byznysovými zadavateli a centrem kvality dat. Teprve poté se stává dostupným pro používání.
Jak jsem již zmínil výše, jedinečnost tohoto nástroje spočívá v tom, že umožňuje sledovat vazby od úrovně byznysového termínu až po konkrétní uživatelské zprávy, ve kterých je používán, a také na úroveň fyzických objektů databází.
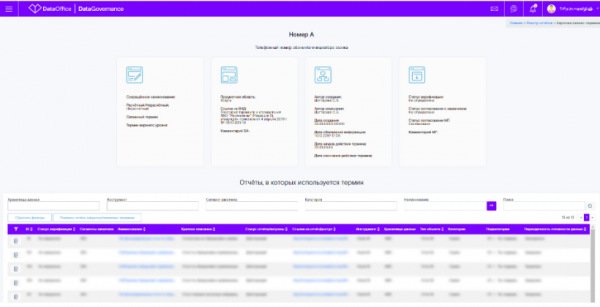
Toho bylo dosaženo díky využití identifikátorů termínů glosáře v podrobném popisu zpráv z registru a popisu fyzických objektů databází.
V současnosti je v glosáři definováno a schváleno více než 4000 termínů. Jeho použití usnadňuje a zrychluje zpracování příchozích dotazů na změny v informačních systémech společnosti. Pokud je požadovaný ukazatel již realizován v nějaké zprávě, uživatel ihned uvidí soubor připravených zpráv, kde je tento ukazatel použit, a může se rozhodnout o efektivním opětovném využití stávající funkčnosti nebo o jejím minimálním doplnění, aniž by inicioval nové žádosti o vývoj nové zprávy.
Modul popisu technických transformací a DataLineage
Zeptáte se, co to jsou za moduly? Není pouze nezbytné zavést Registr zprávy a Glosář, je také třeba přenést všechny obchodní termíny na fyzický model databází. Tímto způsobem jsme dokázali dokončit proces formování životního cyklu dat od zdrojových systémů po BI vizualizaci napříč všemi vrstvami datového skladu. Jinými slovy - vybudovat DataLineage.
Vyvinuli jsme rozhraní, jehož základem byl dříve používaný formát popisu pravidel a logiky transformace dat ve společnosti. Prostřednictvím rozhraní se zavádí stále stejné informace jako dříve, ale povinným požadavkem se stalo určení identifikátoru termínu z obchodního glosáře. Takto budujeme vztah mezi obchodními a fyzickými vrstvami.
Komu to pomůže? Čím byl starý formát, se kterým jsme pracovali několik let, nedostatečný? Jak moc se zvýšily pracovní náklady na formulaci požadavků? S takovými otázkami jsme se museli potýkat v průběhu zavádění nástroje. Odpovědi na ně jsou poměrně jednoduché – je to potřeba nám všem, datovému úřadu naší společnosti a našim uživatelům.
Ano, zaměstnanci se museli adaptovat, zpočátku to vedlo k mírnému navýšení pracovních nákladů na přípravu dokumentace, ale tento problém jsme vyřešili. Praxe, identifikace a optimalizace problémových míst udělaly své. Dosáhli jsme hlavního cíle – zvýšili jsme kvalitu vyvíjených požadavků. Povinná pole k vyplnění, standardizované příručky, masky pro vstup, vestavěné kontroly – to vše nám umožnilo mnohonásobně zvýšit kvalitu popisů transformací. Opustili jsme praxi předávání skriptů ve formě požadavků na vývoj, sdíleli jsme znalosti, které byly dostupné pouze týmu zabývajícímu se vývojem. Vytvořená databáze metadat výrazně zkracuje čas na provádění regresních analýz a poskytuje možnost rychlé ocenění vlivu změn na kterékoliv vrstvě IT krajin (reporty vitríny, agregáty, zdroje).
A co mají společného běžní uživatelé reportů, jaké mají přínosy? Díky možnosti tvorby DataLineage naši uživatelé, i ti, kteří jsou vzdáleni od SQL a jiných programovacích jazyků, rychle získávají informace o zdrojích a objektech, na jejichž základě je sestavován konkrétní report.
Modul kontroly kvality dat
Vše, o čem jsme mluvili výše v souvislosti s zajištěním transparentnosti dat, nemá význam bez pochopení, že data, která předáváme uživatelům, jsou správná. Jeden z důležitých modulů naší koncepce správy dat – modul kontroly kvality dat.
V aktuální fázi je to katalog kontrol pro vybrané entity. Nejbližším cílem rozvoje produktu je rozšíření seznamu kontrol a integrace s registrem reportů.
Co to přinese a komu? Pro koncového uživatele registru bude k dispozici informace o plánovaných a skutečných datech připravenosti reportu, výsledky provedených kontrol s dynamikou, údaje o zdrojích nahraných do reportu.
Pro nás integrovaný modul kvality dat do pracovních procesů znamená:
- Rychlé formulování očekávání zákazníků.
- Rozhodování o dalším využití dat.
- Získání předběžného souboru problémových bodů v raných fázích práce pro vývoj pravidelných kontrol kvality.
Samozřejmě, to jsou první kroky k budování komplexního procesu správy dat. Jsme si však jisti, že pouze cílenou prací na tomto úkolu a aktivním zaváděním nástrojů DataGovernance do pracovního procesu zajistíme našim klientům informovanost, vysokou úroveň důvěry v data, transparentnost jejich získávání a zvýšíme rychlost zavádění nové funkčnosti.
Tým DataOffice
Zdroj: habr.com
