

Pozn. přek.: tento poučný příběh Omio — evropského cestovního agregátoru — provádí čtenáře od základní teorie po fascinující praktické detaily konfigurace Kubernetes. Seznámení s těmito případy pomáhá nejen rozšiřovat obzory, ale také předcházet netriviálním problémům.
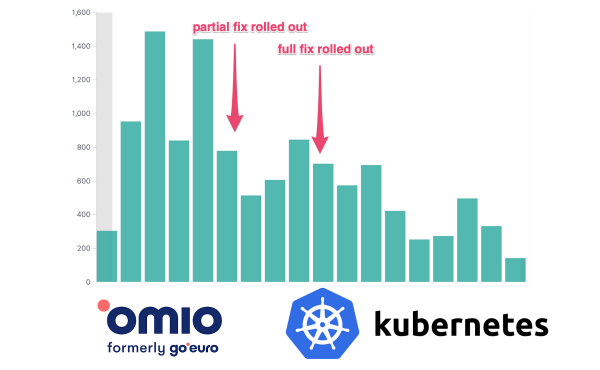
Stalo se vám někdy, že aplikace 'zamrzla', přestala reagovat na dotazy o stavu (health checky) a vy jste nemohli pochopit důvod takového chování? Jedno z možných vysvětlení souvisí s limitem kvot na CPU. O tom bude tato статья.
TL;DR:
Důrazně doporučujeme vzdát se limitů CPU v Kubernetes (nebo vypnout CFS kvoty v Kubelet), pokud používáte verzi Linuxového jádra s chybou CFS kvot. V jádře je to vážná a chyba, která vede k nadměrnému zpožďování a latenci..
V Omio je celá infrastruktura řízena Kubernetes.Všechny naše stateful i stateless zátěže běží výhradně na Kubernetes (používáme Google Kubernetes Engine). V posledních šesti měsících jsme zaznamenali náhodná zpoždění. Aplikace zamrzají nebo přestávají reagovat na health checky, ztrácejí spojení se sítí atd. Takové chování nás dlouho mátlo, a nakonec jsme se rozhodli se problémem zabývat podrobněji.
Shrnutí článku:
- Něco málo o kontejnerech a Kubernetes;
- Jak jsou realizovány požadavky a limity CPU;
- Jak limit CPU funguje v prostředích s více jádry;
- Jak sledovat throttling CPU;
- Řešení problému a nuance.
Něco málo o kontejnerech a Kubernetes
Kubernetes je v podstatě moderní standard ve světě infrastruktury. Jeho hlavním úkolem je orchestraci kontejnerů.
Kontejnery
Dříve jsme museli vytvářet artefakty jako Java JAR/WAR, Python Egg nebo spustitelné soubory pro následné spuštění na serverech. Aby však fungovaly, museli jsme vykonat další práci: nainstalovat běhové prostředí (Java/Python), umístit potřebné soubory na správná místa, zajistit kompatibilitu s konkrétní verzí operačního systému atd. Jinými slovy, museli jsme pečlivě sledovat správu konfigurací (což často způsobovalo rozepře mezi vývojáři a systémovými administrátory).
Kontejnery všechno změnily. Nyní artefaktem představuje kontejnerový obraz. Můžeme ho chápat jako rozšířený spustitelný soubor, který obsahuje nejen program, ale i plnohodnotné běhové prostředí (Java/Python/…) a také potřebné soubory/balíčky, předinstalované a připravené k spuštění. Kontejnery lze nasazovat a spouštět na různých serverech bez jakýchkoliv dalších akcí.
Navíc kontejnery fungují ve vlastním písečkovém prostředí. Mají svůj vlastní virtuální síťový adaptér, vlastní souborový systém s omezeným přístupem, svou hierarchii procesů, svá omezení na CPU a paměť atd. To vše je realizováno díky zvláštní subsystému jádra Linux – namespaces (jmenné prostory).
Kubernetes
Jak bylo zmíněno dříve, Kubernetes je orchestrace kontejnerů. Funguje takto: poskytnete mu skupinu strojů a pak říkáte: „Hej, Kubernetes, spusť deset instancí mého kontejneru s 2 procesory a 3 GB paměti na každou a udržuj je v chodu!“. Kubernetes se postará o všechno ostatní. Najde volné kapacity, spustí kontejnery a bude je restartovat podle potřeby, provede aktualizaci při změně verzí atd. V podstatě Kubernetes umožňuje abstrahovat se od hardwarové části a činí všechny tyto různé systémy vhodnými pro nasazení a práci aplikací.
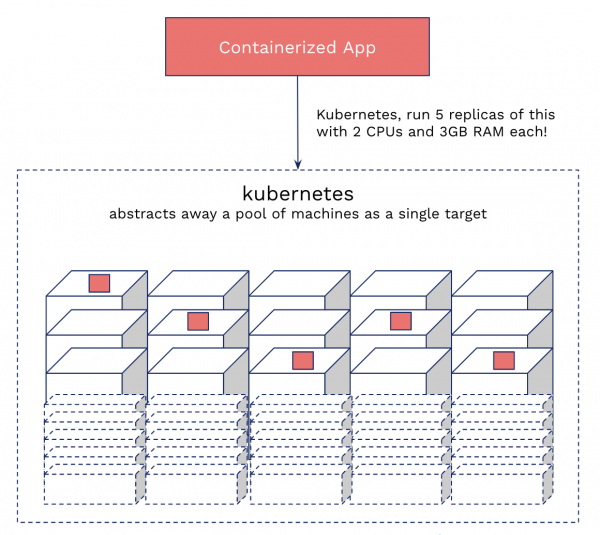
Kubernetes z pohledu obyčejného člověka
Co jsou to requesty a limity v Kubernetes
Dobře, rozumíme kontejnerům a Kubernetes. Také víme, že několik kontejnerů může být na jednom stroji.
Můžeme si to přirovnat k družstevnímu bytu. Máme prostornou místnost (stroje/uzly) a pronajímáme ji několika nájemníkům (kontejnerům). Kubernetes hraje roli realitního makléře. Vzniká otázka, jak udržet nájemníky od vzájemných konfliktů? Co když se jeden z nich rozhodne zabrat koupelnu na půl dne?
Právě sem vstupují do hry requesty a limity. CPU Request je potřeba výhradně pro plánování. Je to něco jako „přání seznam“ kontejneru a slouží k vybírání nejvhodnějšího uzlu. Zároveň CPU Limit se dá přirovnat k nájemní smlouvě – jakmile vybereme uzel pro kontejner, ten nebude moci překročit stanovené hranice. A tady vzniká problém…
Jak jsou implementovány requesty a limity v Kubernetes
Kubernetes používá vestavěný mechanismus přiškrcování pro realizaci limitů CPU. Pokud aplikace překročí tento limit, zapne se přiškrcení (tj. dostává méně časových cyklů CPU). Requesty a limity pro paměť jsou organizovány jinak, a proto se snáze detekují. Stačí zkontrolovat poslední stav restartu podu: není označen jako „OOMKilled“. S přiškrcením CPU to není tak jednoduché, protože K8s zpřístupňuje pouze metriky využití a ne podle cgroups.
CPU Request
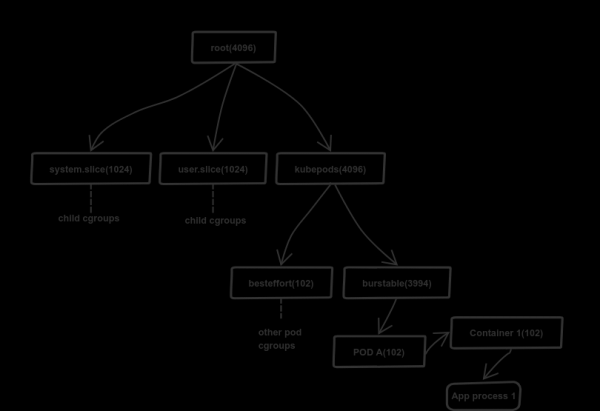
Jak je implementován CPU request
Pro jednoduchost si uveďme proces na příkladu stroje se 4jádrovým CPU.
K8s používá mechanismus kontrolních skupin (cgroups) pro správu alokace zdrojů (paměť a procesor). Pro něj je k dispozici hierarchický model: potomek dědí limity rodičovské skupiny. Podrobnosti o alokaci jsou uchovávány ve virtuálním souborovém systému (/sys/fs/cgroup). V případě procesoru je to /sys/fs/cgroup/cpu,cpuacct/*.
K8s používá soubor cpu.share k rozdělování procesorových zdrojů. V našem případě získává kořenová kontrolní skupina 4096 podílů zdrojů CPU — 100% dostupného výkonu procesoru (1 jádro = 1024; jedná se o fixní hodnotu). Kořenová skupina distribuuje zdroje proporcionálně podle podílů potomků uvedených v cpu.share, a ti na oplátku zacházejí stejným způsobem se svými potomky, a tak dále. V typickém uzlu Kubernetes má kořenová kontrolní skupina tři potomky: system.slice, user.slice a kubepods. Dvě první podskupiny jsou používány k rozdělení zdrojů mezi kritické systémové zátěže a uživatelské programy mimo K8s. Poslední — kubepods — je vytvářena Kubernetesem pro rozdělení zdrojů mezi mody.
Na výše uvedeném schématu je vidět, že první a druhá podskupina dostaly po 1024 podílu, přičemž podskupině kubepod bylo přiděleno 4096 podílů. Jak je to možné: vždyť kořenové skupině je k dispozici pouze 4096 podílů, a součet podílů jejích potomků podstatně tento počet přesahuje (6144)? Skutečnost je taková, že hodnota má logický význam, a proto plánovač Linuxu (CFS) ji používá k proporcionálnímu rozdělení zdrojů CPU. V našem případě první dvě skupiny dostávají po 680 skutečných podílech (16,6% z 4096), zatímco kubepod dostává zbývajících 2736 podílů. V případě nečinnosti první dvě skupiny nebudou využívat přidělené zdroje.
Naštěstí plánovač disponuje mechanismem, který zabraňuje ztrátě nevyužitých CPU zdrojů. Převádí „nečinné“ výkonové jednotky do globálního fondu, z něhož jsou rozdělovány mezi skupiny vyžadující dodatečné výpočetní schopnosti (přenášení probíhá po dávkách, aby se předešlo ztrátám způsobeným zaokrouhlováním). Podobná metoda se aplikuje i na všechny potomstvo.
Tento mechanismus zajišťuje spravedlivé rozdělení procesorových výkonů a dbá na to, aby žádný proces „nezískával“ zdroje od ostatních.
CPU Limit
I když se konfigurace limitů a požadavků v K8s zdají být podobné, jejich implementace se radikálně liší: je to nejvíce zavádějící a nejméně zdokumentovaná část.
K8s využívá pro implementaci limitů. Jejich nastavení je určeno v souborech cfs_period_us a cfs_quota_us ve složce cgroup (tam se také nachází soubor cpu.share).
Na rozdíl od cpu.sharekvoty vychází z časového období, nikoli z dostupné procesorové kapacity. cfs_period_us určuje délku období (epochy) — to je vždy 100000 mikrosekund (100 ms). V K8s je možné tuto hodnotu změnit, avšak zatím je to možné pouze v alpha verzi. Plánovač využívá epochu k resetování vyčerpaných kvot. Druhý soubor, cfs_quota_us, určuje dostupný čas (kvotu) v každé epoše. Všimněte si, že je také uvedena v mikrosekundách. Kvota může překračovat délku epochy; jinými slovy, může být delší než 100 ms.
Podívejme se na dva scénáře na 16jádrových strojích (nejběžnější typ počítačů u nás v Omio):
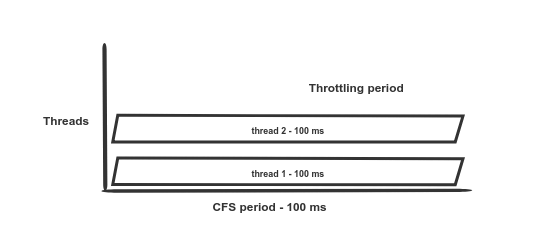
Scénář 1: 2 vlákna a limit 200 ms. Bez throttle.
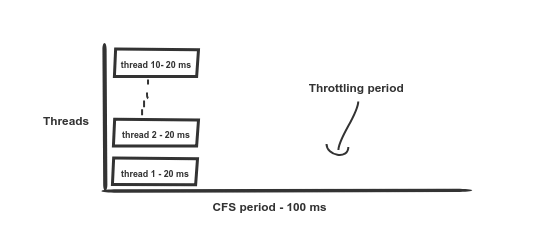
Scénář 2: 10 vláken a limit 200 ms. Throttle začíná po 20 ms, přístup k procesorovým zdrojům se obnoví o dalších 80 ms.
Předpokládejme, že jste nastavili limit CPU na 2 jádra; Kubernetes převede tuto hodnotu na 200 ms. To znamená, že kontejner může maximálně využívat 200 ms procesorového času bez throttlingu.
A tady to začíná být zajímavé. Jak bylo uvedeno výše, dostupná kvota činí 200 ms. Pokud s vámi paralelně běží deset vláken na 12jádrovém stroji (viz ilustrace ke scénáři 2), zatímco všechny ostatní pod'y jsou nečinné, kvota bude vyčerpána již za 20 ms (protože 10 * 20 ms = 200 ms) a všechna vlákna daného pod'u se "zaseknou" (throttle) na následujících 80 ms. Situaci komplikuje již zmíněný , kvůli kterému dochází k nadměrnému škrcení a kontejner nemůže vyprodukovat ani přidělenou kvótu.
Jak hodnotit škrcení v podech?
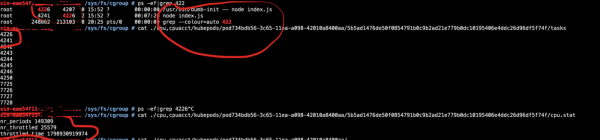
Jednoduše se přihlaste do podu a proveďte cat /sys/fs/cgroup/cpu/cpu.stat.
-
nr_periods— celkový počet období plánovače; -
nr_throttled— počet škrcených období v rámcinr_periods; -
throttled_time— souhrnné škrcené časové úseky v nanosekundách.
Co se vlastně děje?
Nakonec máme vysoké škrcení ve všech aplikacích. Někdy je to jeden a půlkrát silnější než odhadované!
To vede k různým chybám — selhání kontrol připravenosti (readiness), zamrznutí kontejnerů, přerušení síťových připojení, časovým limitům v rámci služebních volání. Nakonec se to projevuje ve zvýšené latenci a vyšším počtu chyb.
Řešení a důsledky
Tady je to jednoduché. Vzdali jsme se limitů CPU a začali aktualizovat jádro OS v klastrech na nejnovější verzi, ve které byl bug opraven. Počet chyb (HTTP 5xx) v našich službách okamžitě výrazně poklesl:
Chyby HTTP 5xx
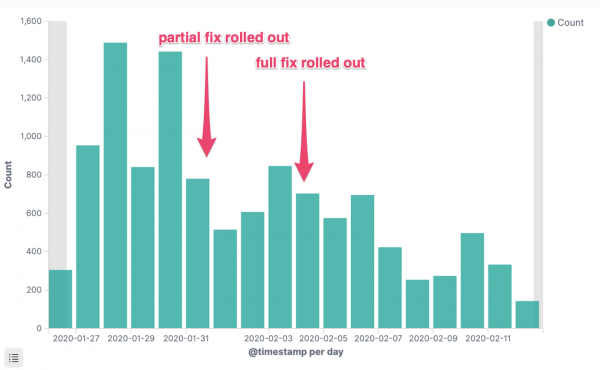
Chyby HTTP 5xx jedné kriticky důležité služby
Čas odezvy p95
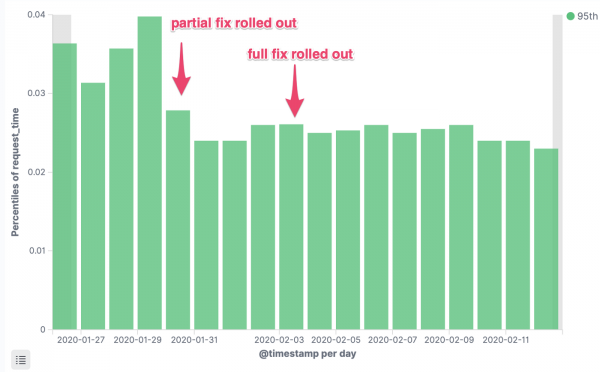
Latence požadavků kriticky důležité služby, 95. percentil
Náklady na provoz
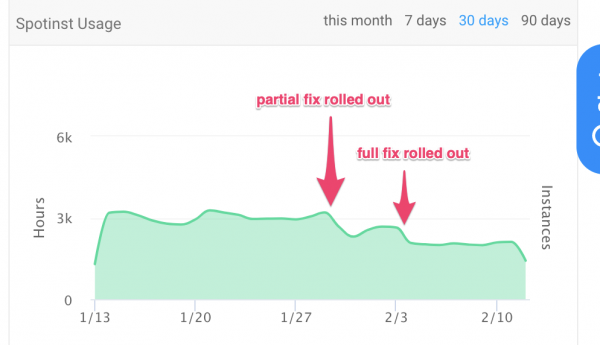
Počet vynaložených instance-hodin
Jaký je háček?
Jak bylo řečeno na začátku článku:
Můžeme udělat analogii s družstevním bytem… Kubernetes hraje roli realitního makléře. Ale jak udržet nájemníky, aby nedocházelo ke konfliktům? Co když se jeden z nich například rozhodne zabrat koupelnu na půl dne?
Tady je háček. Jeden nezodpovědný kontejner může pohlcovat veškeré dostupné procesorové zdroje na stroji. Pokud máte solidní technologický stack (například správně nastavené JVM, Go, Node VM), pak to není problém: v takových podmínkách se dá fungovat dlouhou dobu. Ale pokud jsou aplikace špatně optimalizovány nebo vůbec neoptimalizovány (FROM java:latest), situace se může vymknout kontrole. U nás v Omio máme automatizované základní Dockerfilese s adekvátními výchozími nastaveními pro hlavní jazykové stacky, takže takový problém neexistoval.
Doporučujeme sledovat metriky (využití, saturace a chyby), zpoždění API a frekvence výskytu chyb. Sledujte, aby výsledky odpovídaly očekávání.
Odkazy
Taková je naše historie. Následující materiály velmi pomohly objasnit, co se děje:
- ;
- ;
- ;
- ;
- — hledejte "cpu throttling".
Zprávy o chybách Kubernetes:
- ;
- ;
- .
Setkali jste se s podobnými problémy ve své praxi nebo máte zkušenosti s throttlingem v kontejnerizovaných produkčních prostředích? Podělte se o svůj příběh v komentářích!
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
