

Ve zprávě jsou představeny některé přístupy, které umožňují sledovat výkon SQL dotazů, když jich je miliony denně, a kontrolovaných serverů PostgreSQL – stovky.
Jaká technická řešení nám umožňují efektivně zpracovávat takové objemy informací, a jak to usnadňuje život běžného vývojáře.
Koho zajímá analýza konkrétních problémů a různé techniky optimalizace SQL dotazů a řešení typických DBA úloh v PostgreSQL – také se lze na toto téma.
Jmenuji se Kirill Borovikov, zastupuji . Konkrétně se specializuji na práci s databázemi v naší společnosti.
Dnes vám povím, jak se zabýváme optimalizací dotazů, když potřebujete ne "rozebírat" výkon jednoho dotazu, ale řešit problém hromadně. Když je dotazů miliony a potřebujete najít nějaké názory na řešení tohoto velkého problému.
Obecně, «Tensor» pro milion našich klientů – to je : korporativní sociální síť, řešení pro videohovory, pro interní i externí oběh dokumentů, účetní systémy pro účetnictví a sklad,… Takže takový „megakomplex“ pro komplexní řízení podnikání, ve kterém je více než 100 různých vnitřních projektů.
Aby všechny normálně pracovaly a rozvíjely se – máme 10 center vývoje po celé zemi, v nichž je více než 1000 vývojářů.
S PostgreSQL pracujeme od roku 2008 a nahromadili jsme velký objem toho, co zpracováváme – to jsou klientská data, statistiky, analytické údaje, data z externích informačních systémů – více než 400 TB.Pouze v „produkci“ je přibližně 250 serverů, a celkově monitorujeme kolem 1000 databázových serverů.
SQL je deklarativní jazyk. Popisujete ne „jak“ něco má fungovat, ale „co“ chcete získat. DBMS lépe ví, jak provést JOIN – jak spojit vaše tabulky, jaké podmínky uplatnit, co půjde podle indexu, co ne…
Některé DBMS přijímají nápovědy: „Ne, tyto dvě tabulky spoj v určitém pořadí“, ale PostgreSQL to tak neumí. To je vědomá pozice vedoucích vývojářů: „Raději vylepšíme optimalizátor dotazu, než dovolíme vývojářům používat nějaké nápovědy“.
Ale i když PostgreSQL nedovoluje řídit se 'zvenčí', skvěle umožňuje vidět, co se děje uvnitř, když vykonáváte svůj dotaz, a kde se objevují problémy.
Obecně, s jakými klasickými problémy se vývojář [k DBA] obvykle obrací? 'Tady jsme spustili dotaz a všechno jde pomalu, všechno se zaseklo, něco se děje… Je to katastrofa!'Příčiny jsou téměř vždy stejné:
neefektivní dotazovací algoritmus
- Vývojář: 'Teď mám v SQL 10 tabulek přes JOIN…' – a očekává, že se jeho podmínky zázračně efektivně 'vyřeší', a on dostane všechno rychle. Ale zázraky se nedějí, a jakýkoli systém při takové variabilitě (10 tabulek v jednom FROM) vždy dává nějakou chybu. [
článek] - Tento moment je velmi aktuální právě pro PostgreSQL, když jste velký dataset 'nalili' na server, děláte dotaz – a on vám 'seká' po tabulce. Protože včera tam bylo 10 záznamů, a dnes 10 milionů, ale PostgreSQL o tom ještě neví, a je třeba mu to naznačit. [
'zásek' kvůli zdrojům] - Umístili jste velkou a zatíženou databázi na slabý server, který postrádá disk, paměť a výkonnost samotného procesoru. A to je vše… Někde je strop výkonnosti, nad který už nemůžete skočit.
Složitý moment, ale jsou nejaktuálnější pro různé měnící se dotazy (INSERT, UPDATE, DELETE) – to je samostatné velké téma. - blokace
Získání plánu
… A pro všechno ostatní potřebujeme
plán ! Musíme vidět, co se děje uvnitř serveru.Plán vykonání dotazu pro PostgreSQL je strom algoritmu vykonání dotazu v textové podobě. Právě ten algoritmus, který byl na základě analýzy plánovačem uznán za nejefektivnější.
Každý uzel stromu je operace: vyhledání dat v tabulce nebo indexu, vytvoření bitové mapy, spojení dvou tabulek, sjednocení, průnik nebo vyloučení výběrů. Vykonání dotazu znamená procházení uzly tohoto stromu.
Abychom získali plán dotazu, nejjednodušší způsob je provést příkaz
EXPLAIN . Abychom získali všechny skutečné atributy, tedy abychom vlastně dotaz na databázi vykonali –EXPLAIN (ANALYZE, BUFFERS) SELECT ... EXPLAIN (ANALYZE, BUFFERS) SELECT ....
Špatný okamžik: když to provádíte, děje se to „tady a teď“, takže je to vhodné pouze pro místní ladění. Pokud vezmete nějaký vysoce zatížený server, který je pod silným tokem změn dat, a vidíte: „Au! Tady máme pomalý dotaz.toto dotaz.“ Půl hodiny, hodinu zpět — zatímco jste běhali a vytahovali tento dotaz z logů, nosili ho zpět na server, celá vaše datová sada a statistiky se změnily. Provádíte ho za účelem ladění — a on se provádí rychle! A vy nevíte, „proč“, proč to bylo pomalé.
Abychom pochopili, co se přesně stalo v okamžiku, kdy je dotaz prováděn na serveru, inteligentní lidé napsali . Je přítomen v prakticky všech nejběžnějších distribučních verzích PostgreSQL a může být jednoduše aktivován v konfiguračním souboru.
Pokud rozpozná, že nějaký dotaz se provádí déle, než je hranice, kterou mu řeknete, udělá „snímek“ plánu tohoto dotazu a zapíše ho společně do logu..
Zdá se, že je vše v pořádku, jdeme do logu a vidíme tam… [textový blok]. Ale nemůžeme o něm říct nic jiného než to, že je to skvělý plán, protože trval 11 ms.
Vypadá to dobře — ale nic není jasné, co se vlastně dělo. Kromě celkového času nic zvláštního nevidíme. Protože sledovat takovou „latuhy“ v obyčejném textu je vůbec neinformativní.
Ale i když je to neinformativní, ne pohodlné, existují závažnější problémy:
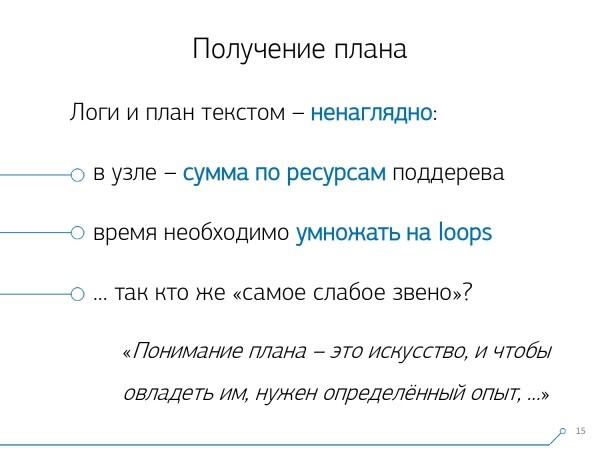
- V uzlu se uvádí součet zdrojů celého podstromu pod ním. To znamená, že prostě tak zjistit, kolik času bylo konkrétně stráveného na tomto Index Scan — není možné, pokud pod ním je nějaká vnořená podmínka. Musíme dynamicky sledovat, zda uvnitř nejsou žádní „potomci“ a podmínkové proměnné, CTE — a vše si „pamatovat“.
- Druhá věc: čas, který je uveden v uzlu, je čas jednorázového provádění uzlu.Pokud byl tento uzel prováděn v rámci například cyklu přes záznamy tabulky víckrát, zvyšuje se počet smyček — cyklů tohoto uzlu v plánu. Ale čas atomárního provádění zůstává v plánu stejný. To znamená, že abychom pochopili, jak dlouho byl tento uzel celkově prováděn, musíme jedno vynásobit druhým — opět „v hlavě“.
V takové situaci je téměř nemožné pochopit, "Kdo je nejslabší článek?" Proto i samotní vývojáři v "manuálu" uvádějí, že "Porozumění plánu je umění, které se musí učit, zkušenost...".
Ale máme 1000 vývojářů a každému z nich tuto zkušenost do hlavy nepředáš. Já, ty, on — ví, ale někdo tam vzadu — už ne. Možná se to naučí, možná ne, ale pracovat musí už teď — odkud by tuto zkušenost vzal.
Vizualizace plánu
Takže jsme si uvědomili — abychom se vypořádali s těmito problémy, potřebujeme dobrou vizualizaci plánu.
Nejdřív jsme šli "po trhu" — podívejme se na internet, co vůbec existuje.
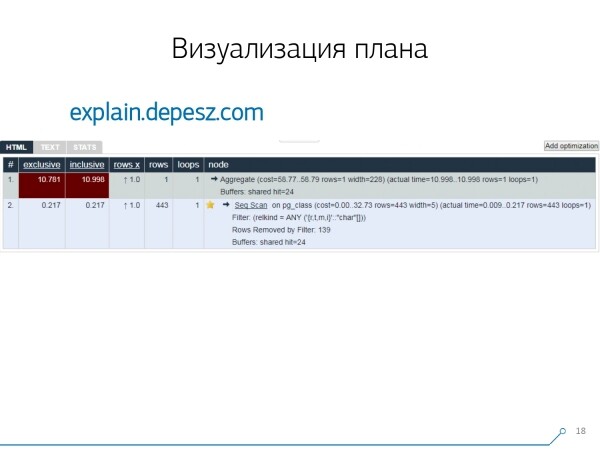
Ale ukázalo se, že pokud jde o "živá" řešení, která se více či méně vyvíjejí, je jich velmi málo — doslova jedno: od Huberta Lubaczewského. Do pole "předáváš" textovou reprezentaci plánu, on ti ukáže tabulku se rozebranými daty:
- vlastní doba zpracování uzlu
- celkový čas v celém podstromu
- počet záznamů, který byl vytažen a který se statisticky očekával
- tělo uzlu samotného
Tento servis má také možnost sdílet archiv odkazů. Hodil jsi tam svůj plán a říkáš: "Hej, Vašku, tady máš odkaz, tam je něco špatně."
Ale jsou tu i malé problémy.
Za prvé, ohromné množství "kopírování a vkládání". Vezmeš kus logu, strčíš to tam, a znovu, a znovu.
Za druhé, neexistuje analýza počtu přečtených dat těch bufferů, které vypisuje EXPLAIN (ANALYZE, BUFFERS), zde to nevidíme. On prostě neumí je analyzovat, chápat a pracovat s nimi. Když čteš velké množství dat a chápeš, že můžeš nesprávně "rozložit" na disku a v paměťovém cache, tato informace je velmi důležitá.
Třetí negativní moment — velmi slabý rozvoj tohoto projektu. Komity jsou velmi malé, pokud jednou za půl roku, a kód je v Perlu.
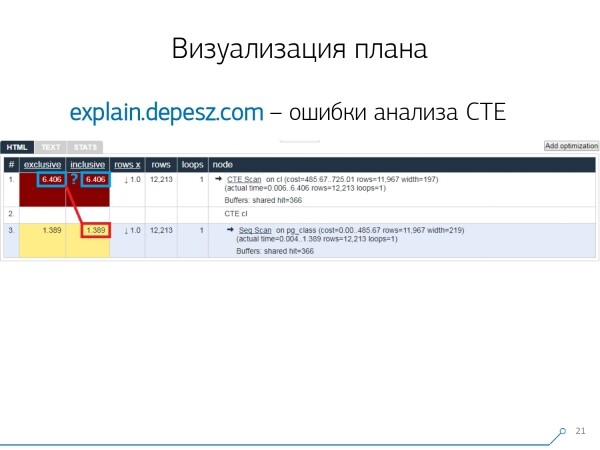
Ale to všechno je "lyrika", s tím bychom nějak mohli žít, ale je tu jedna věc, která nás silně od tohoto servisu odvrátila. Jsou to chyby analýzy Common Table Expression (CTE) a různých dynamických uzlů jako InitPlan/SubPlan.
Pokud věříme tomuto obrázku, pak máme celkový čas provádění každého jednotlivého uzlu větší než celkový čas provádění celého dotazu. Je to jednoduché — z uzlu CTE Scan nebyl odečten čas generování tohoto CTE.. Takže už nevíme správnou odpověď na to, jak dlouho samotné skenování CTE trvalo.
Tady jsme si uvědomili, že nastal čas napsat své vlastní — hurá-hurá! Každý vývojář říká: „Teď napíšeme svoje, bude to super jednoduché!“
Vzali jsme typický stack pro webové služby: jádro na Node.js + Express, natáhli Bootstrap a pro krásné diagramy — D3.js. A naše očekávání se docela naplnila — první prototyp jsme dostali za 2 týdny:
- vlastní parser plánu
To znamená, že nyní můžeme analyzovat jakýkoli plán, který generuje PostgreSQL. - správná analýza dynamických uzlů — CTE Scan, InitPlan, SubPlan
- analýza rozložení bufferů — kde se stránky dat čtou z paměti, kde z lokálního cache, kde z disku
- získali jsme vizuální přehlednost
Abychom nemuseli všechno tohle "kopat" v logu, ale hned viděli "nejslabší článek" na obrázku.
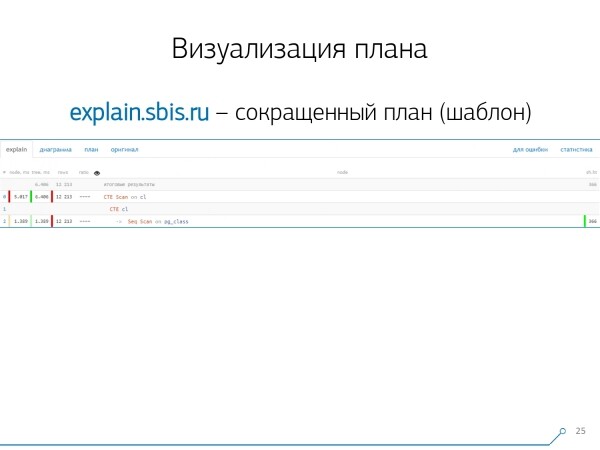
Dostali jsme přibližně takový obrázek — hned se zvýrazněním syntaxe. Ale obvykle naši vývojáři nepracují s kompletní představou plánu, ale s tím, co je kratší. Všechny čísla jsme už rozparsovali a odložili je stranou, a uprostřed jsme nechali pouze první řádek, který ukazuje, jaký to je uzel: CTE Scan, generace CTE nebo Seq Scan podle nějaké tabulky.
Toto zkrácené zobrazení nazýváme šablonou plánu.
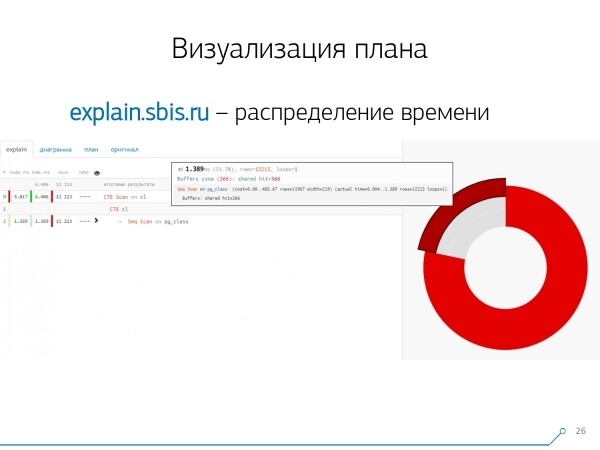
Co by ještě bylo užitečné? Bylo by užitečné vidět, jaký podíl na jaký uzel se z celkového času rozkládá — a prostě jsme "přilepili" vedle koláčový graf.
Přejíždíme na uzel a vidíme — vlastně Seq Scan z celkového času zabral méně než čtvrtinu, zatímco zbytek 3/4 zabral CTE Scan. Hrůza! Toto malé upozornění ohledně "rychlosti" CTE Scanu, pokud je aktivně používáte ve svých dotazech. Nejsou příliš rychlé — jsou pomalejší než běžné skenování tabulek.
Ale obvykle jsou takové diagramy zajímavější a složitější, když najednou převedeme na segment a vidíme, například, že více než polovina celkového času nějaký Seq Scan "sežral". A navíc uvnitř tam byl nějaký Filter, spousta záznamů byla podle něj vyřazena… Můžeme tento obrázek rovnou poslat vývojáři a říct: „Vašo, máš tady opravdu všechno špatně! Rozuměj tomu, podívej se — něco není v pořádku!“
Samozřejmě, bez "ořechů" se to neobešlo.
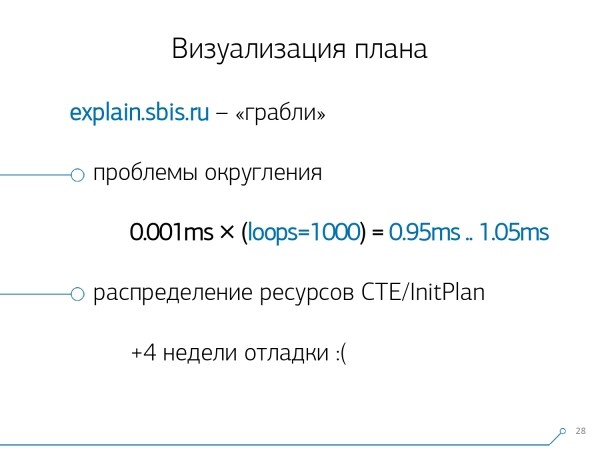
První problém, na který jsme narazili, je zaokrouhlování. Čas každého jednotlivého uzlu plánu je uveden s přesností na 1 μs. A když počet cyklů uzlu překročí například 1000 — po provedení PostgreSQL došlo k dělení s "přesností na", takže při zpětném výpočtu získáme celkový čas "někde mezi 0,95 ms a 1,05 ms". Když se jedná o mikrosekundy, není to tak hrozné, ale když už mluvíme o [milisekundách], musíme při "vyhodnocování" zdrojů podle uzlů plánu "kdo kolik spotřeboval" tuto informaci zohlednit.
Druhou, složitější záležitostí je rozdělení zdrojů (těch samých buffers) mezi dynamické uzly. To nám na prototyp zabralo další 4 týdny přes první 2 týdny.
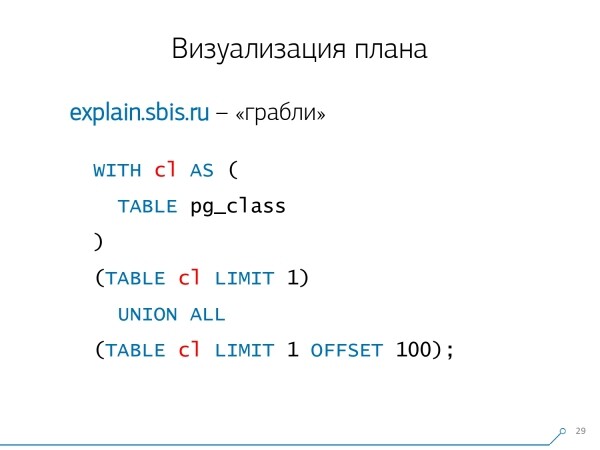
Tento problém lze získat poměrně snadno — vytvoříme CTE a něco v ní jakoby čteme. Ve skutečnosti je PostgreSQL "inteligentní" a nic tam přímo číst nebude. Poté z ní vezmeme první záznam a k němu sto první ze stejné CTE.
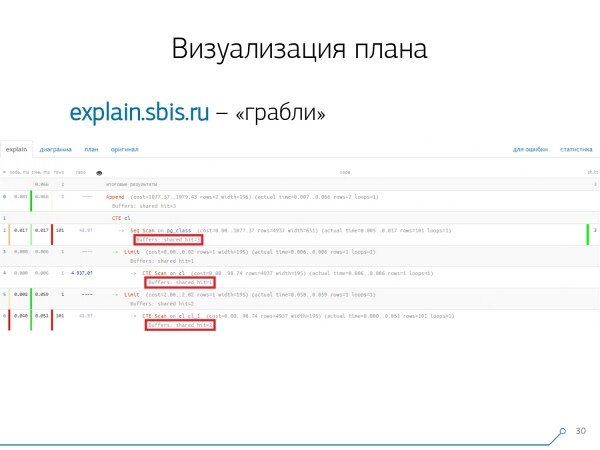
Díváme se na plán a chápeme — je divné, že jsme měli 3 buffery (datové stránky), které byly "spotřebovány" v Seq Scan, další 1 v CTE Scan a 2 v druhém CTE Scan. To znamená, že pokud to všechno jednoduše sečteme, dostaneme 6, ale z tabulky jsme přečetli pouze 3! CTE Scan totiž nic nikde nečte, ale pracuje přímo s pamětí procesu. Tady je jasně něco v nepořádku!
Ve skutečnosti se ukazuje, že těch 3 datových stránek, které byly požadovány v Seq Scan, nejprve požádal první CTE Scan, a poté druhý, a přidal mu další 2. Takže bylo přečteno celkem 3 datové stránky, ne 6.
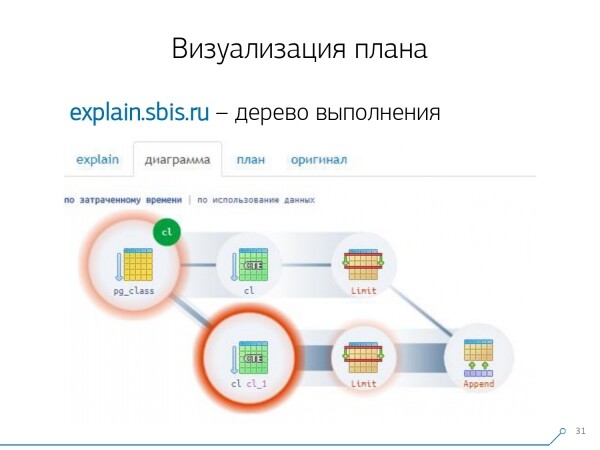
A tento obraz nám přivedl k pochopení, že vykonávání plánu již není strom, ale spíše nějaký acyklický graf. A získali jsme přibližně takovou diagramu, abychom chápali „co odkud vlastně přišlo“. Takže tady jsme vytvořili CTE z pg_class, a požádali o ni dvakrát, a prakticky celý čas jsme strávili na větvi, když jsme ji požádali podruhé. Je jasné, že přečíst 101. záznam je mnohem dražší než jen první z tabulky.

Na chvíli jsme vydechli. Řekli jsme: „Teď, Neo, víš kung-fu! Nyní je naše zkušenost přímo na obrazovce. Teď jí můžeš využít.“
Konsolidace logů
Naši 1000 vývojářů si ulevilo. Ale my jsme si uvědomovali, že máme jen stovky 'bojových' serverů a celý ten 'copy-paste' ze strany vývojářů je velmi nepraktický. Pochopili jsme, že si to musíme sestavit sami.
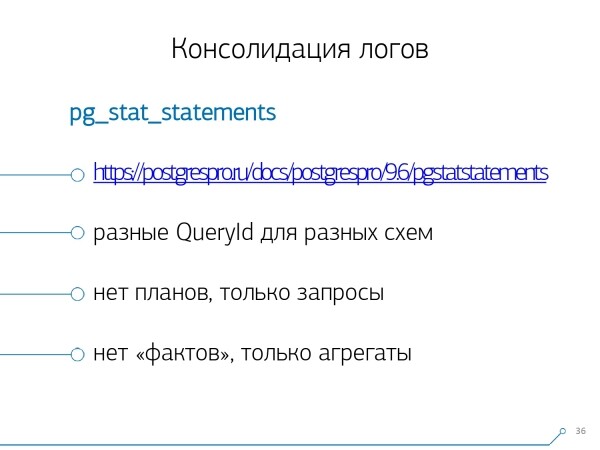
Obecně existuje nativní modul, který dokáže sbírat statistiky, ovšem je také potřeba ho aktivovat v konfiguraci — to je . Ale ten nás neuspokojil.
Za prvé, stejným dotazům v různých schématech v rámci jedné databáze přiděluje různé QueryId. To znamená, že pokud nejprve provedeme SET search_path = '01'; SELECT * FROM user LIMIT 1;, a poté SET search_path = '02'; a podobný dotaz, tak ve statistikách tohoto modulu budou různé záznamy, a nebudu schopen shromáždit celkovou statistiku právě v rámci tohoto profilu dotazu, bez ohledu na schémata.
Druhý problém, který nám bránil v jeho použití — neexistence plánů. Tedy plán — chybí, pouze samotný dotaz. Vidíme, co zpomalovalo, ale nechápeme, proč. A tady se vracíme k problému rychle se měnícího datového souboru.
A poslední problém — neexistence 'faktů'. Tedy nelze odkazovat na konkrétní instanci provedení dotazu — ta neexistuje, máme pouze agregovanou statistiku. S tím se dá pracovat, ale je to velmi složité.
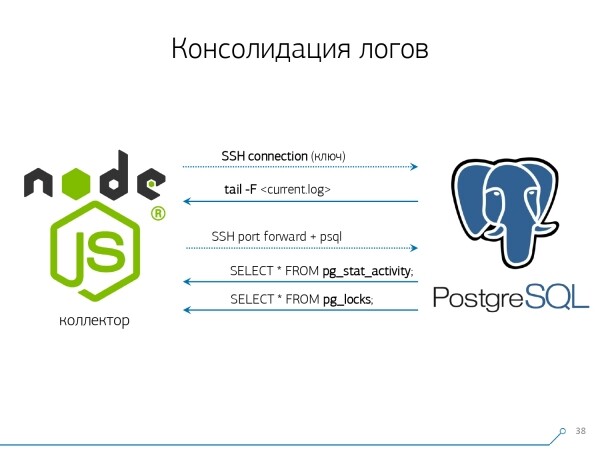
Proto jsme se rozhodli bojovat s 'copy-paste' a začali psát sběrač.
Sběrač se připojuje přes SSH, 'natahuje' chráněné spojení k serveru s databází pomocí certifikátu a tail -F 'se připojuje' k němu na logový soubor. Tímto způsobem získáváme kompletní 'zrcadlo' celého logového souboru, který server generuje. Zátěž na samotný server je přitom minimální, protože nic neparsujeme, pouze zrcadlíme provoz.
Protože jsme již začali psát rozhraní na Node.js, pokračovali jsme v psaní sběrače rovněž na něm. A tato technologie se ukázala jako osvědčená, protože pro práci se slabě strukturovanými textovými daty, jakým log je, se JavaScript velmi dobře hodí. A samotná infrastruktura Node.js jako backendová platforma umožňuje snadno a pohodlně pracovat se síťovými připojeními a vůbec s nějakými datovými toky.
Protože tedy »táhneme« dvě připojení: první, abychom »poslouchali« samotný log a získávali ho, a druhé — abychom se občas ptali databáze. „A v logu se objevilo, že je zablokována tabulka s oid 123“, ale to vývojáři nic neříká, a bylo by dobré se zeptat databáze „Jaké tedy je OID = 123?“ Takto se občas ptáme databáze na to, co ještě nevíme.
„Jen jedno jsi nezohlednil, existuje druh sloním podobných včel!..“ Začali jsme vyvíjet tento systém, když jsme chtěli monitorovat 10 serverů. Nejkritičtější podle našeho názoru, na kterých se objevovaly nějaké problémy, se kterými bylo těžké se vypořádat. Ale během prvního čtvrtletí jsme dostali na monitoring stovku — protože systém „zabral“, všichni chtěli, všem to vyhovovalo.
To vše je třeba sumarizovat, datové toky jsou velké a aktivní. Vlastně, co monitorujeme, s čím umíme pracovat — to také používáme. Využíváme i PostgreSQL jako úložiště dat. A nic rychlejšího pro „nalévání“ dat do něj, než operátor COPY zatím není.
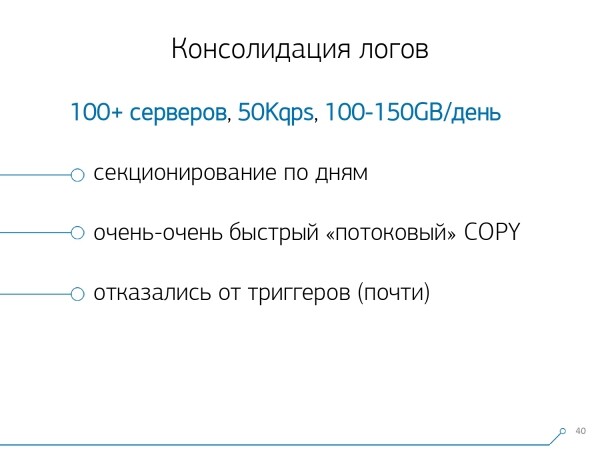
Ale prostě „nalévat“ data — to není úplně naše technologie. Protože pokud máte na stovce serverů přibližně 50k požadavků za sekundu, generuje vám to 100-150 GB logů denně. Proto jsme museli databázi pečlivě „piličit“.
Za prvé, udělali jsme rozdělení podle dnů, protože, upřímně, nikoho nezajímá korelace mezi dny. Jaký má význam, co jsi měl včera, když dnes v noci jsi vydal novou verzi aplikace — a už máš nějakou novou statistiku.
Za druhé, naučili jsme se (byli jsme nuceni) velmi-velmi rychle zapisovat pomocí COPY. Tedy ne jen COPY, protože je rychlejší než INSERT, ale ještě rychlejší.
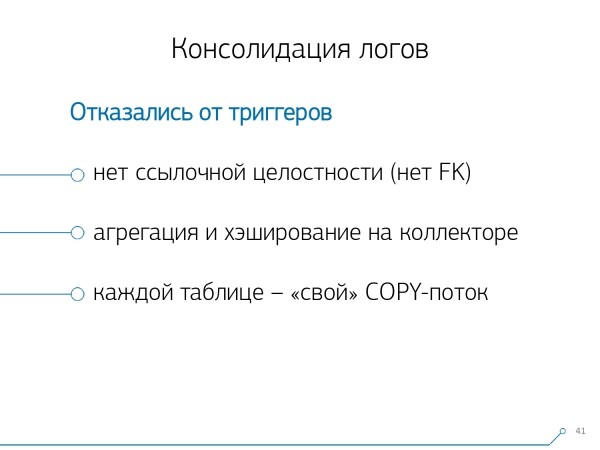
Třetí bod — museli jsme se vzdát triggerů, a tedy i Foreign Keys. Tedy nemáme vůbec žádnou referenční integritu. Protože pokud máte tabulku, na které je pár FK, a říkáte ve struktuře databáze, že „tento záznam z logu se odkazuje přes FK například na skupinu záznamů“, pak když ho vkládáte, PostgreSQL nemá nic jiného, než vzít a poctivě provést SELECT 1 FROM master_fk1_table WHERE ... s tím identifikátorem, který se pokoušíte vložit — jen abychom ověřili, že tento záznam tam existuje, že svou vložkou „neporušujete“ tento Foreign Key.
Místo jedné položky v cílové tabulce a jejích indexů dostáváme také čtení ze všech tabulek, na které se odkazuje. A to nepotřebujeme — naším úkolem je zapsat co nejvíce a co nejrychleji s co nejmenší zátěží. Takže FK — pryč!
Další věc — agregace a hashing. Původně jsme je měli implementované v DB — bylo to pohodlné, když přišla položka, udělat v nějaké tabulce „plus jedna“ přímo v triggeru. Dobře, pohodlné, ale špatné, protože při vložení jedné položky musíte také přečíst a zapsat něco z jiné tabulky. A co víc, nejen to přečíst a zapsat — musíte to udělat pokaždé.
A teď si představte, že máte tabulku, ve které jen počítáte počet požadavků, které prošly určitou hostitelskou adresou: +1, +1, +1, ..., +1. A to, v zásadě, nepotřebujete — to všechno lze sečíst v paměti na kolektoru a poslat do databáze najednou +10.
Ano, v případě nějakých problémů může „kolabovat“ logická integrita, ale to je prakticky nerealistický scénář — protože máte normální server, v něm baterii v řadiči, máte transakční deník, deník na souborovém systému… Celkově to nestojí za to. Nestojí za ztrátu výkonu, kterou získáte díky triggerům/FK, ty náklady, které s tím nesete.
Totéž platí pro hashing. Přijde k vám nějaký požadavek, z něj v DB vypočítáte nějaký identifikátor, napíšete do databáze a všem pak říkáte ten. Všechno je v pořádku, dokud během zápisu nepřijde druhý, který se pokusí zapsat to stejné — a to už vytváří zámek, což je špatně. Proto pokud můžete generaci nějakých ID převést na klienta (ve vztahu k databázi), je lepší to udělat.
Pro nás bylo ideální použít MD5 z textu — požadavek, plán, šablona,… Vypočítáváme ho na straně kolektoru a už do databáze „naléváme“ hotové ID. Délka MD5 a denní oddělování nám umožňuje nebýt ve stresu ohledně možných kolizí.
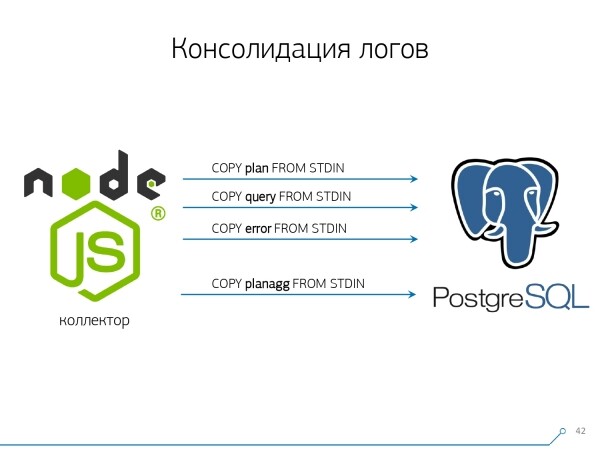
Ale abychom to všechno zapsali rychle, potřebovali jsme upravit samotný zápisový proces.
Jak obvykle zapisujeme data? Máme nějaký dataset, který rozkládáme na několik tabulek a pak pomocí COPY — nejprve do první, pak do druhé, do třetí… Není to pohodlné, protože máme jedno datové proudění, které zapisujeme ve třech krocích postupně. Je to nepříjemné. Můžeme to udělat rychleji? Můžeme!
K tomu stačí tyto toky uložit paralelně jeden vedle druhého. To znamená, že máme v samostatných tocích chyby, dotazy, šablony, zámky,… — a zapisujeme to všechno paralelně. K tomu stačí držet neustále otevřený COPY kanál pro každou jednotlivou cílovou tabulku.
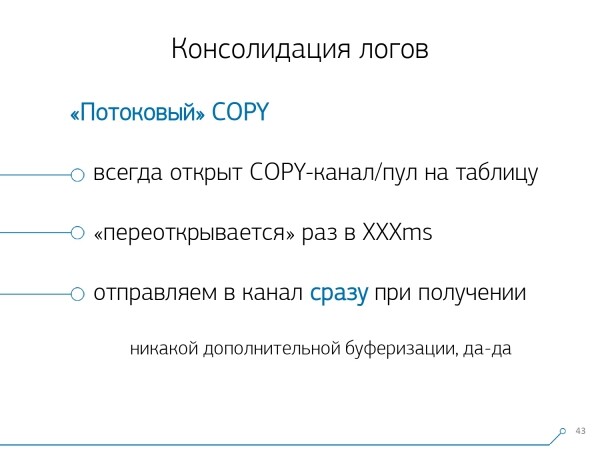
To znamená, že u sběrače je vždy stream, do kterého mohu zapisovat potřebná data. Ale aby je databáze viděla, a nikdo nezůstal viset na zámku, čekající, až se data zapíší, COPY je třeba přerušovat s určitou periodicitou. Pro nás se ukázala jako nejefektivnější perioda kolem 100 ms — zavřeme a hned znovu otevřeme na tu samou tabulku. A pokud máme jednoho proudu nedostatek při určitých špičkách, provádíme pooling do určitého limitu.
Dále jsme zjistili, že pro takový profil zátěže je jakákoliv agregace, kdy se záznamy shromažďují do balíčků — zlo. Klasickým zlem je INSERT ... VALUES a dále 1000 záznamů. Protože v tomto okamžiku dochází k špičce zápisu na médium a všichni ostatní, kteří se snaží něco zapsat na disk, budou čekat.
Abychom se zbavili takových anomálií, prostě nic neagregujte, nebufferizujte vůbec. A pokud přece jen nastane bufferizace na disk (naštěstí, Stream API v Node.js to umožňuje zjistit) — odložte toto spojení. Jakmile dostanete událost, že je opět volné — zapisujte do něj z nahromaděné fronty. A zatímco je obsazené — vezměte z poolu další volné a zapisujte do něj.
Před zavedením takového přístupu k zápisu dat jsme měli přibližně 4K zápisových operací, a tímto způsobem jsme zatížení snížili na čtvrtinu. Nyní se nám to díky nově sledovaným databázím opět zvýšilo šestkrát — až na 100 MB/s. A nyní uchováváme logy za poslední 3 měsíce v objemu kolem 10-15 TB, doufajíc, že během tří měsíců dokáže každý vývojář vyřešit jakýkoli problém.
Chápeme problémy
Ale jen shromáždit všechna tato data — je to dobré, užitečné, relevantní, ale málo — je třeba je pochopit. Protože to jsou miliony různých plánů za den.
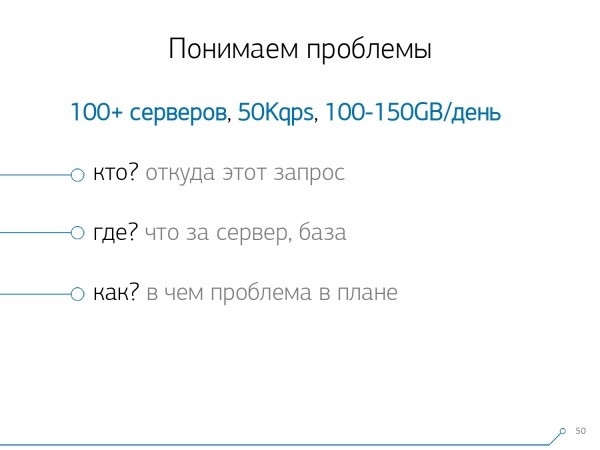
Ale miliony — to je neřízené, nejprve je třeba to «zmenšit». A v první řadě je třeba rozhodnout, jak to «zmenšení» budete organizovat.
Vyčlenili jsme si tři klíčové body:
- kdo tento požadavek poslal
To znamená, z jaké aplikace přišel: webové rozhraní, backend, platební systém nebo něco jiného. - kde to se stalo
Na kterém konkrétním serveru. Protože pokud máte pod jednou aplikací několik serverů a najednou jeden „zpomalil“ (protože „disk se pokazil“, „pamět praskla“, nějaký jiný problém), je třeba se konkrétně obrátit na server. - jak jak přesně se problém projevoval v tom či onom plánu
Abychom pochopili „kdo“ nám poslal požadavek, používáme standardní prostředek — nastavení proměnné relace: SET application_name = '{bl-host}:{bl-method}'; — zachytíme jméno hostitele byznys logiky, ze kterého přichází požadavek, a název metody nebo aplikace, která ho iniciovala.
Po předání „majitele“ požadavku je třeba ho zaznamenat do logu — k tomu konfiguruje proměnnou log_line_prefix = ' %m [%p:%v] [%d] %r %a'. Kdo má zájem, může , co to všechno znamená. Ukazuje se, že v logu vidíme:
- čas
- identifikátory procesu a transakce
- jméno databáze
- IP toho, kdo poslal tento požadavek
- a jméno metody
Dále jsme pochopili, že není příliš zajímavé sledovat korelaci jednoho požadavku mezi různými servery. Není často situace, kdy jedno aplikace má stejný problém tady i tam. Ale i když stejný — podívejte se na jakýkoliv z těchto serverů.
Takže řez „jeden server — jeden den“ se nám ukázal jako dostatečný pro jakoukoliv analýzu.
První analytický řez — to je ten správný „šablona“ — zkrácená forma prezentace plánu, očištěná od všech číselných ukazatelů. Druhý řez — aplikace nebo metoda, a třetí — konkrétní uzel plánu, který nám způsobil problémy.
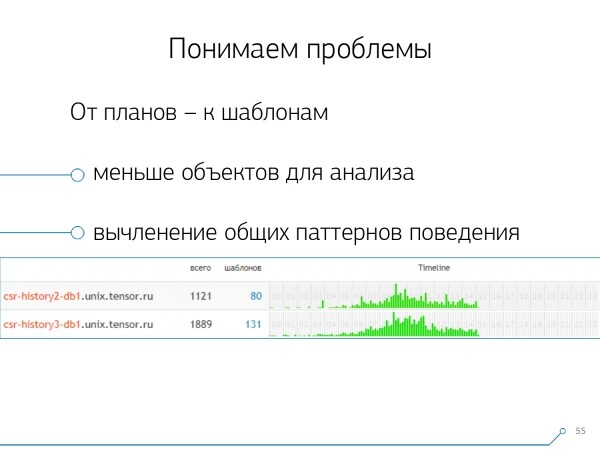
Když jsme přešli od konkrétních instancí k šablonám, získali jsme hned dvě výhody:
- radikální snížení počtu objektů pro analýzu
Problém už nevyrážíme v tisících požadavků nebo plánů, ale ve desítkách šablon. - časová osa
Tedy shrnout „fakta“ v rámci nějakého průřezu lze zobrazit jejich výskyt během dne. A tady si můžete uvědomit, že pokud se vám nějaký vzor objevuje, například jednou za hodinu, zatímco by měl – jednou za den, stojí za to zamyslet se, co se stalo – kdo a proč ho vyvolal, možná by tu neměl být. To je další nečíselný, čistě vizuální způsob analýzy.
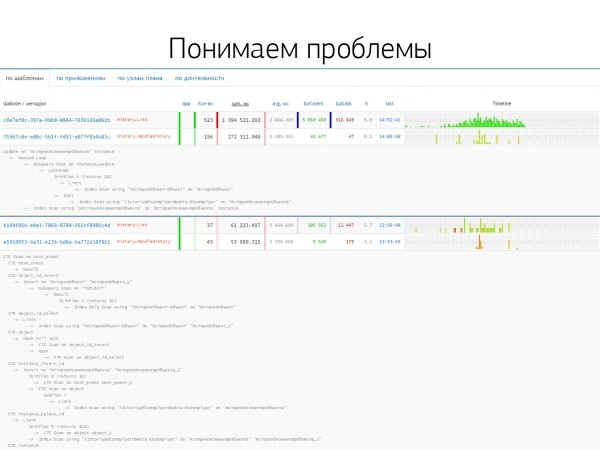
Ostatní metody vycházejí z ukazatelů, které extrahujeme z plánu: kolikrát se takový vzor stal, celkový a průměrný čas, kolik dat bylo přečteno z disku a kolik z paměti…
Protože například přijdete na stránku analýzy hostitele, podíváte se – něco začalo příliš mnoho číst z disku. Disk na serveru nezvládá – a kdo z něj čte?
A můžete třídit podle jakéhokoli sloupce a rozhodnout se, čím se právě teď budete zabývat – zatížením na procesor nebo na disk, nebo celkovým počtem dotazů… Seřadili jste, podívali se na „top“ a opravili – vydali novou verzi aplikace.
A hned vidíte různé aplikace, které chodí se stejným vzorem od dotazu typu SELECT * FROM users WHERE login = 'Vasya'. Frontend, backend, zpracování… A vy se zamýšlíte, proč by zpracování mělo číst uživatele, pokud s ním neinteraguje.
Zpětný způsob – ihned vidět, co aplikace dělá. Například frontend – tohle, tohle, tohle, a také tohle jednou za hodinu (právě časový rámec pomáhá). A hned se objevuje otázka – přece není úkolem frontendu dělat něco jednou za hodinu…
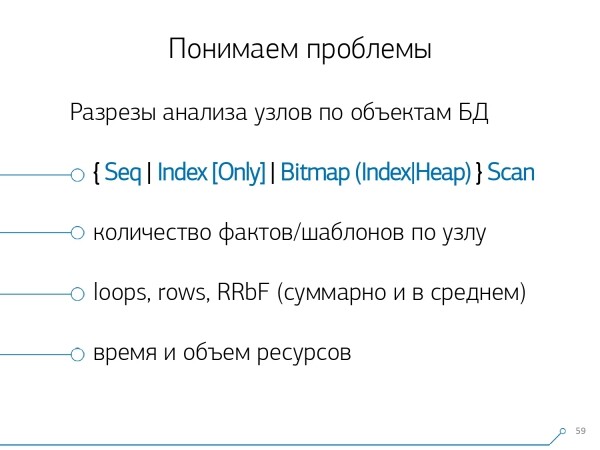
Po nějaké době jsme si uvědomili, že nám chybí agregované statistiky v rámci uzlů plánu. Vyčlenili jsme z plánů pouze ty uzly, které něco dělají s daty samotných tabulek (čtou/píšou je podle indexu nebo ne). V podstatě se k předchozímu obrázku přidává jen jeden aspekt – kolik záznamů nám tento uzel přinesl, a kolik jich odmítl (Rows Removed by Filter).
Nemáte vhodný index na tabulce, provedete na něj dotaz, ten proletí kolem indexu, spadne do Seq Scan… všechny záznamy kromě jednoho jste filtrovali. A proč byste za den měli mít 100M filtrovaných záznamů, nebylo by lepší nasadit index?
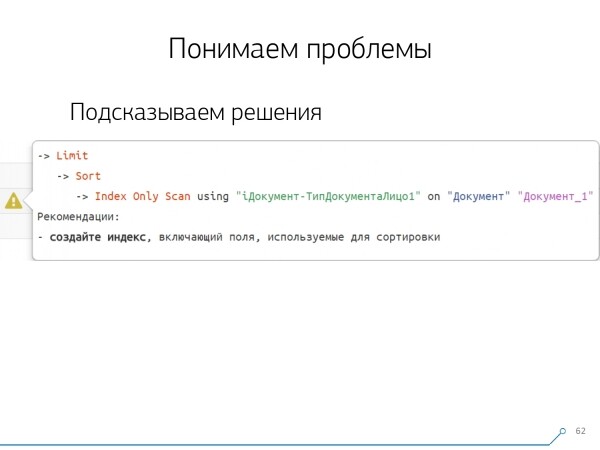
Po analýze všech plánů uzlů jsme zjistili, že existují určité typové struktury v plánech, které s velmi vysokou pravděpodobností vypadají podezřele. Bylo by dobré poradit vývojáři: „Kámo, tady nejdřív čti podle indexu, pak tříděním a nakonec odstřihneš“ — obvykle je tam jeden záznam.
Všichni, kdo psali dotazy s tímto vzorem, se jistě setkali: „Dej mi poslední objednávku od Vasy, její datum“. A pokud nemáte index podle data, nebo v použitém indexu není datum, tak přesně na takovéhle „hrabě“ šlápnete.
Ale víme, že je to „hrabě“ — tak proč hned neporadit vývojáři, co má udělat. Otevřením plánu teď náš vývojář hned vidí krásný obrázek s radami, kde mu hned říkají: „Tady a tady máš problémy, a řeší se tak a tak.“
V důsledku toho objem zkušeností potřebných k vyřešení problémů na začátku a nyní klesl v řádech. Takový nástroj jsme vytvořili.
Zdroj: habr.com
