

Nedávno jsem vyprávěl, jak pomocí standardních receptů z databáze PostgreSQL. Dneska se podíváme na to, jak můžeme učinit zapisování do DB efektivnější bez jakýchkoli „zásahů“ do konfigurace — prostě správnou organizací datových toků.
#1. Секционирование
Článek o tom, jak a proč byste měli organizovat už byl, dnes se budeme věnovat praxi aplikace některých přístupů v rámci našeho .
„Doba už dávno minulá…“
Na začátku, jako každý MVP, náš projekt startoval pod poměrně nízkým zatížením — monitorování probíhalo pouze pro desítku nejkritičtějších serverů, všechny tabulky byly relativně kompaktní… Ale čas plynul, sledovaných hostitelů přibývalo, a když jsme se opět pokusili něco udělat s jednou z tabulek o velikosti 1.5TB, pochopili jsme, že takhle žít je sice možné, ale velmi nepohodlné.
Časy byly skoro báječné, populární byly různé varianty PostgreSQL 9.x, takže celé dělení muselo probíhat „ručně“ — přes dědění tabulek a spouštěče směrování s dynamickým PROVÉST.
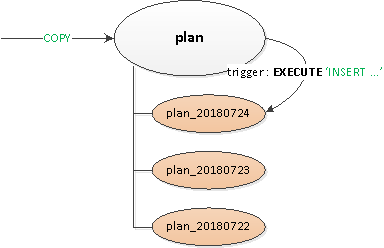
Vytvořené řešení se ukázalo být dost univerzální, aby se dalo aplikovat na všechny tabulky:
- Byla vyhlášena prázdná „hlavičková“ rodičovská tabulka, na které byly popsány všechny potřebné indexy a spouštěče..
- Záznam z pohledu klienta se prováděl do „kořenové“ tabulky, a uvnitř pomocí spouštěče směrování
BEFORE INSERTbyl záznam „fyzicky“ vložen do potřebné sekce. Pokud taková sekce ještě neexistovala — chytli jsme výjimku a … - … s pomocí na základě rodičovské tabulky se vytvářela sekce s omezením na potřebné datum, aby při extrakci dat byl přístup pouze do ní.
PG10: první pokus
Ale dělení přes dědění historicky nebylo příliš přizpůsobeno pro práci s aktivním tokem zápisu nebo velkým množstvím potomkovských sekcí. Například si můžeme vzpomenout, že algoritmus výběru správné sekce měl kvadratickou složitost, což při 100+ sekcích funguje, jak asi tušíte…
V PG10 byla tato situace silně optimalizována, byl zaveden podporu Proto jsme se hned pokusili aplikovat to po migraci úložiště, ale...
Jak se ukázalo po prostudování manuálu, nativně sekcionovaná tabulka v této verzi:
- nepodporuje popis indexů
- nepodporuje na ní spouštěče
- nemůže být sama ničím "potomkem"
- nepodporuje
INSERT ... ON CONFLICT - nedokáže automaticky generovat sekce
Po tvrdém zásahu jsme pochopili, že se bez modifikací aplikace neobejdeme, a odložili další zkoumání na půl roku.
PG10: druhá šance
Takže jsme začali řešit vzniklé problémy po jednom:
- Protože spouštěče a
ON CONFLICTse nám některde přece jen hodily, vytvořili jsme mezitím proxy tabulku. - zbavili jsme se "routování" ve spouštěčích — tedy od
PROVÉST. - Vytáhli jsme samostatně šablonovou tabulku se všemi indexy, aby se ani na proxy tabulce nevyskytovaly.
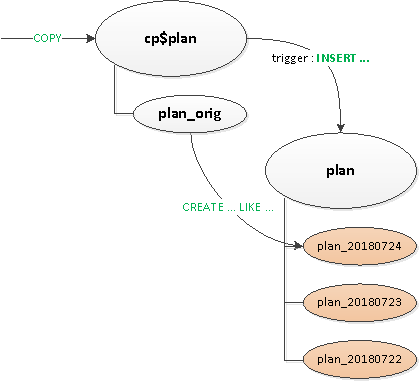
Nakonec, po tom všem, jsme nativně sekcionovali hlavní tabulku. Vytvoření nové sekce zůstalo na aplikaci.
"Šijeme" slovníky
Jak v každém analytickém systému, i u nás byly "fakty" a "řezy" (slovníky). V našem případě jako takové sloužily například homogenních pomalých dotazů nebo text samotného dotazu.
"Fakty" jsme měli sekcionovány podle dnů už dávno, takže jsme mohli pohodlně odstraňovat zastaralé sekce, a ty nám nevadily (logy přece!). Ale slovníky se ukázaly jako problém...
Není to tak, že jich bylo příliš mnoho, ale přibližně na 100TB "faktů" vznikl slovník o velikosti 2.5TB.Z takové tabulky se nic snadno neodstraní, nedá se komprimovat v přijatelném čase a zápis do ní se postupně zpomaloval.
Vypadá to jako slovník… v něm by měla být každá položka zastoupena přesně jednou… a to je správné, ale!.. Nikdo nám nebrání mít každý den samostatný slovník! Ano, to přináší určitou nadbytečnost, ale umožňuje to:
- psát/číst rychleji díky menší velikosti sekcí
- spotřebovávat méně paměti díky práci s kompaktnějšími indexy
- ukládat méně dat díky možnosti rychlého odstranění zastaralých
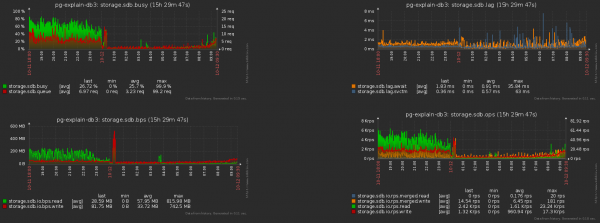
V důsledku celého komplexu opatření se zátěž CPU snížila o ~30%, na disku - o ~50%:
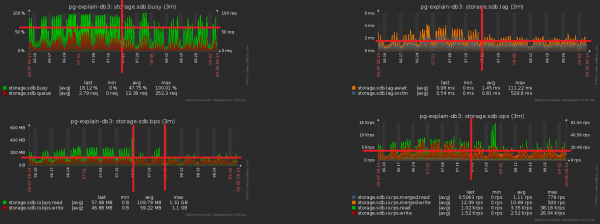
Pokračovali jsme ve zapisování do databáze přesně toho samého, jen s menší zátěží.
#2. Эволюция и рефакторинг БД
Takže jsme se dostali k tomu, že máme pro každý den svou sekci s daty. Vlastně, CHECK (dt = '2018-10-12'::date) — to je klíč sekcionace a podmínka pro zařazení záznamu do konkrétní sekce.
Jelikož všechny reporty v našem servisu jsou budovány podle konkrétního data, indexy ještě z "ne-sekcionovaných časů" byly všechny typu (Server, Datum, Šablona plánu), (Server, Datum, Uzlový plán), (Datum, Třída chyby, Server),…
Ale nyní v každé sekci žijí své instance každého takového indexu… A v rámci každé sekce datum je konstantou… Ukazuje se, že nyní do každého takového indexu lacině vkládáme konstantu jako jedno z polí, což zvyšuje jeho objem i čas hledání, ale nepřináší žádný výsledek. Sami jsme si nastražili pasti, ups…
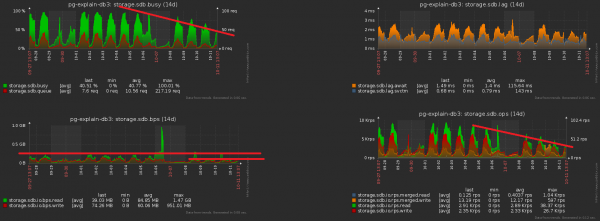
Směr optimalizace je zřejmý — prostě odstraňujeme pole s datem ze všech indexů u sekcionovaných tabulek. Při našich objemech zisk je kolem 1TB/týden!
A nyní si povšimněme, že tento terabajt ještě musel být nějak zapsán. To znamená, že nyní musíme ukládat méně na disk! Na tomto obrázku je dobře vidět dosažený efekt z provedeného úklidu, kterému jsme věnovali týden:
#3. «Размазываем» пиковую нагрузку
Jedním z velkých problémů zatížených systémů je nadměrná synchronizace nějakých operací, které to nevyžadují. Někdy "protože si toho nevšimli", někdy "bylo to jednodušší", ale dříve či později se toho musí zbavit.
Přibližujeme předchozí obrázek — a vidíme, že disk u nás "proudí" zatížení s dvojnásobnou amplitudou mezi sousedními měřeními, což zjevně "statisticky" nemá být při takovém počtu operací:
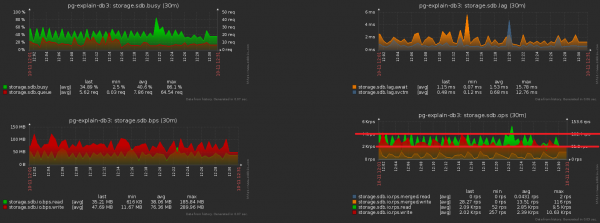
Dosáhnout toho je dost snadné. Na monitorování jsme měli již téměř 1000 serverů, každý zpracováván jednotlivým logickým proudem, a každý proud odesílá nahromaděné informace do databáze s určitou periódou, přibližně takto:
setInterval(sendToDB, interval)Problém spočívá v tom, že všechny proudy startují zhruba ve stejnou dobu, takže momenty odeslání se téměř vždy shodují "do bodu". Ups č. 2…
Naštěstí se to dá celkem snadno opravit, přidáním "náhodného" rozptýlení v čase:
setInterval(sendToDB, interval * (1 + 0.1 * (Math.random() - 0.5)))#4. Кэшируем, что нужно можно
Třetí tradiční problém highloadu — absence cache tam, kde by měl být. mohl být.
Například jsme umožnili analýzu podle uzlů plánu (všechny tyto Seq Scan on users), ale hned si myslet, že jsou většinou stejné — zapomněli.
Ne, samozřejmě, do databáze se nic znovu nepíše, to odřízne spouštěč s INSERT ... ON CONFLICT DO NOTHING. Ale přesto tato data dorazí do databáze, a ještě je potřeba navíc čtení pro kontrolu konfliktu provádět. Ups č. 3…
Rozdíl v počtu záznamů odesílaných do databáze před/po zapnutí cache — je zřejmý:
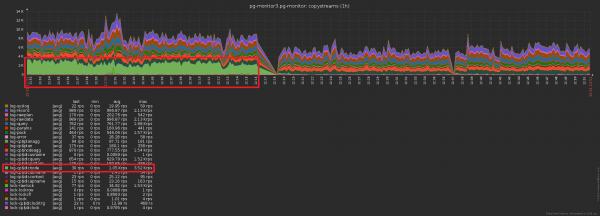
A to je — související pokles zátěže na úložiště:
Celkem
„Terabajt za den“ zní strašidelně. Pokud děláte vše správně, je to jen 2^40 bytů / 86400 sekund = ~12.5MB/s, což zvládly i běžné IDE disky. 🙂
A pokud to vezmete vážně, i při desetinásobném „přetížení“ zátěže během dne se bez problémů vejdete do možností moderních SSD.
Zdroj: habr.com
