

Dnes vám vyprávím příběh. Příběh evoluce výpočetní techniky a vzniku remote pracovních míst od dávných dob až po současnost.
Vývoj IT
Hlavní, co si z historie IT odnést, je…
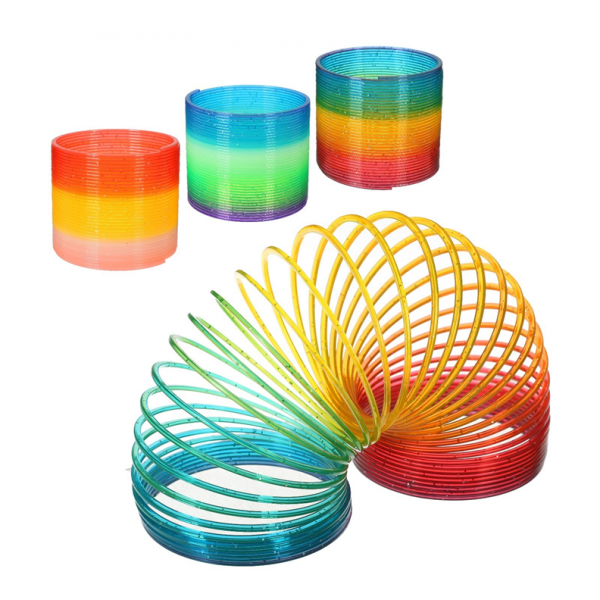
Samozřejmě, že IT se vyvíjí spirálovitě. Ta samá řešení a koncepty, které byly před desetiletími zavrženy, nabývají nový smysl a úspěšně začínají fungovat za nových podmínek, s novými úkoly a novými kapacitami. V tomto se IT neliší od jakékoli jiné oblasti lidského poznání a historie Země jako celku.
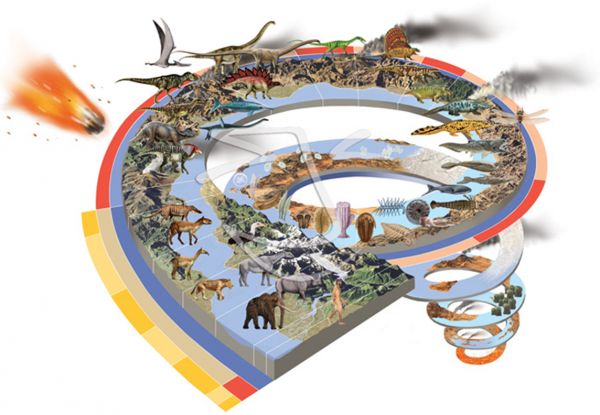
Kdysi dávno, kdy byly počítače obrovské
„Myslím, že na světě je místo pro přibližně pět počítačů,“ řekl šéf IBM Thomas Watson v roce 1943.
Brzká výpočetní technika byla obrovská. Ne, špatně, raná technika byla monstrózní, kyklopská. Celý výpočetní stroj zaujímal plochu srovnatelnou se sportovní halou a stál naprosto nesmyslné peníze. Jako příklad komponentů můžeme uvést modul operační paměti na feritových kroužcích (1964).
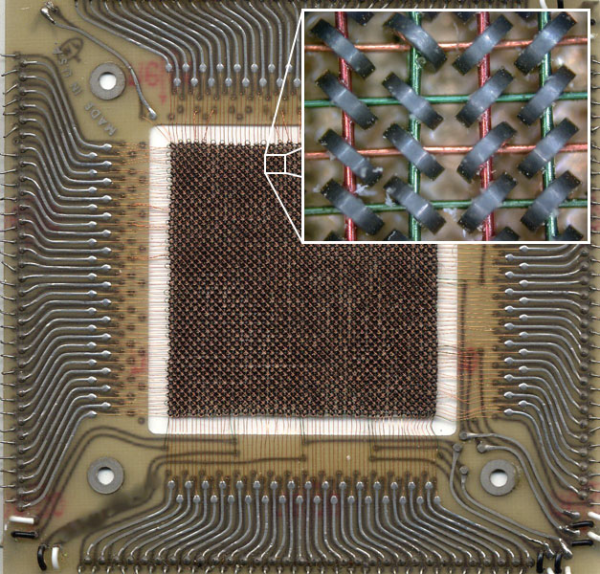
Tento modul měří 11 cm * 11 cm a má kapacitu 512 bajtů (4096 bitů). Skříň plně naplněná těmito moduly měla sotva kapacitu dávno zastaralé disketové jednotky 3,5" (1,44 MB = 2950 modulů), přičemž spotřebovávala výrazné množství elektrické energie a hřála se jako parní stroj.
Obrovské rozměry souvisí s anglickým názvem ladění programového kódu — „debugging“. Jedna z prvních programátorek v historii, Grace Hopper (ano, byla to žena), námořní důstojník, v roce 1945 zaznamenala do svého deníku události po vyšetřování poruchy v programu.
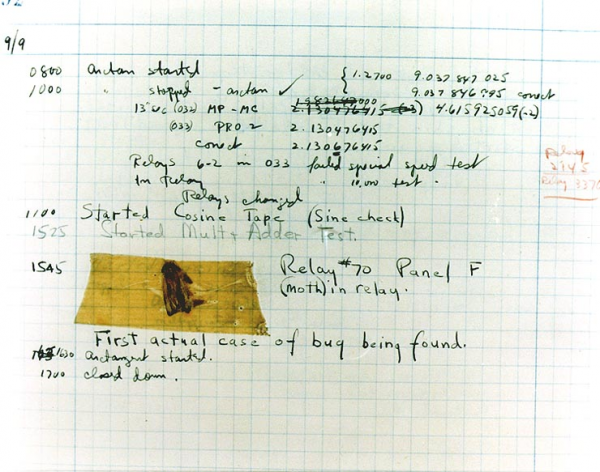
Jelikož moth (moucha) je obecně bug (chyba), veškeré další problémy a kroky řešení, které personál hlásil nadřízeným, byly označovány jako „debugging“ (doslovně odstranění chyby), takže se pro selhání programu a chybu v kódu natrvalo ustálil název bug a ladění se stalo debagem.
S postupem vývoje elektroniky, zejména polovodičové elektroniky, se fyzické rozměry strojů začaly zmenšovat, zatímco výpočetní výkon rostl. Ale i přesto nebylo možné poskytnout každému počítač osobně.
„Neexistují žádné důvody, proč by si chtěl někdo držet počítač doma,“ řekl Ken Olsen, zakladatel DEC, v roce 1977.
V 70. letech se objevuje termín minipočítač. Pamatuji si, že když jsem poprvé přečetl tento termín před mnoha lety, představil jsem si něco jako netbook, téměř kapesní počítač. Nemohl jsem být dál od pravdy.
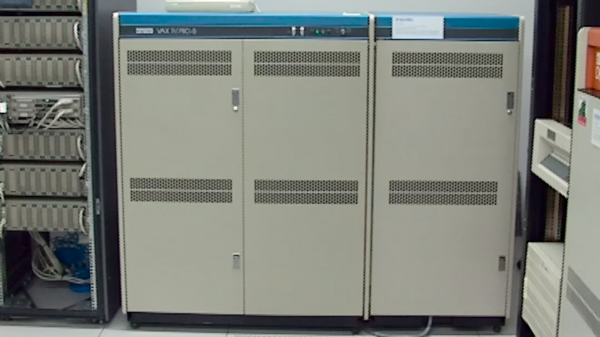
Minipočítač je jen v porovnání s obrovskými strojovnami, ale stále jde o několik skříní s vybavením v hodnotě stovek tisíc a milionů dolarů. Přesto již výpočetní výkon vzrostl natolik, že ne vždy byl plně využit, a počítače začaly být dostupné studentům a akademikům.
A pak přišel ON!
Mnozí se nezamýšlejí nad latinskými kořeny v anglickém jazyce, ale právě tento jazyk nám přinesl vzdálený přístup, jak ho známe dnes. Terminus (lat.) — konec, hranice, cíl. Cílem Terminátora T800 bylo ukončit život Johna Connora. Také víme, že dopravní stanice, na kterých se provádí nastupování a vystupování cestujících nebo nakládání a vykládání nákladu, se nazývají terminály — konečnými cíli tras.
Odpovídajícím způsobem se objevila koncepce terminálového přístupu, a můžete vidět nejznámější terminál na světě, který stále žije v našich srdcích.
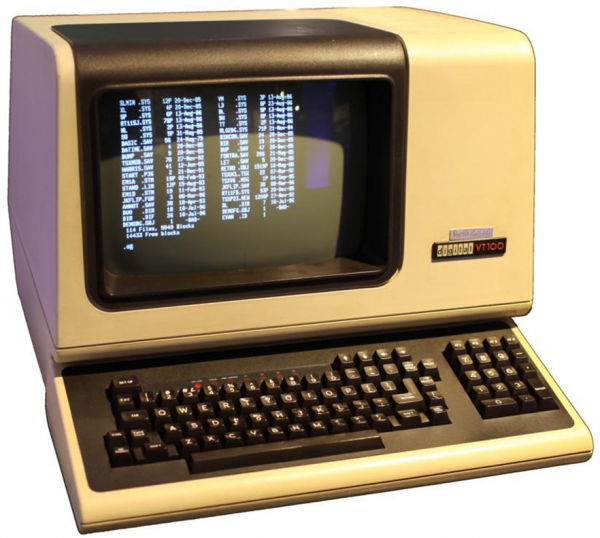
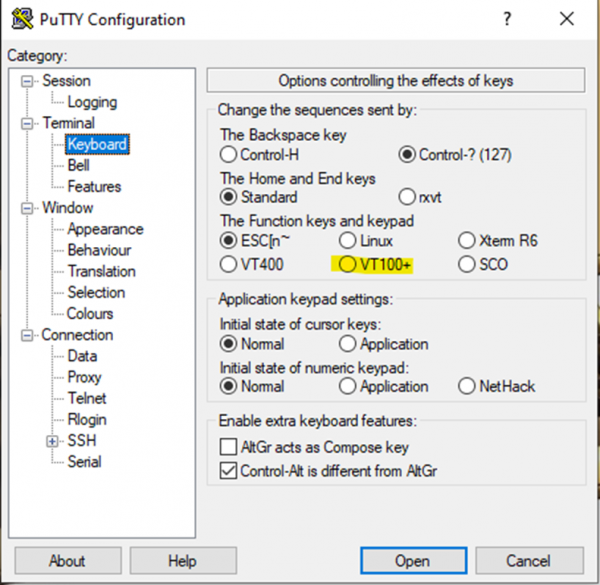
DEC VT100 se nazývá terminálem, protože uzavírá informační linku. Má prakticky nulový výpočetní výkon, a jeho jediným úkolem je zobrazit informace přijaté z velkého stroje a přenést vstup z klávesnice na stroj. A i když VT100 fyzicky dávno zemřeli, stále je plně využíváme.
Naše dny
„Naše dny“ bych začal počítat od počátku 80. let, od okamžiku, kdy se objevily první dostupné procesory pro širokou veřejnost s nějakou významnou výpočetní silou. Tradičně se považuje, že hlavním procesorem této éry se stal Intel 8088 (rodina x86) jako zakladatel vítězné architektury. Jaký je tedy principielní rozdíl v porovnání s koncepcí 70. let?
Poprvé se objevuje trend přesunu zpracování informací z centra na okraj. Ne všechny úkoly vyžadují šílené (ve srovnání se slabou x86) výkony mainframe nebo dokonce minipočítače. Intel nezůstává pozadu, v 90. letech uvádí rodinu Pentium, která se stala prvním opravdu masovým domácím CPU v Rusku. Tyto procesory už dokážou hodně, nejen napsat dopis — ale také multimédia a práci s malými databázemi. V podstatě pro malé podniky je zcela zbytečné mít servery — vše lze vykonávat na okraji, na klientských strojích. S každým rokem jsou procesory výkonnější a rozdíl mezi servery a osobními počítači se z hlediska výpočetní kapacity stále zmenšuje, často zůstává pouze v rezervaci napájení, podpoře hot-swap a speciálních skříních pro montáž do racků.
Pokud porovnáme moderní klientské procesory s "úsměvnými" pro administrátory těžkých serverů z 90. let od společnosti Intel se superpočítači minulosti, stává se to dokonce poněkud nepříjemným.
Podívejme se na starého pána, který je prakticky mým vrstevníkem. Cray X-MP/24 z roku 1984.
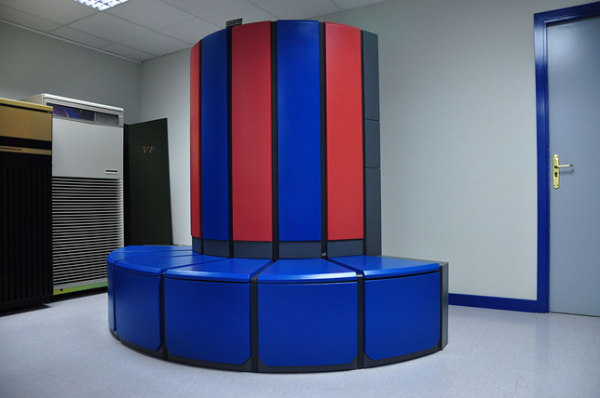
Tento stroj patřil do top superpočítačů z roku 1984, měl 2 procesory po 105 MHz a vrcholnou výpočetní kapacitu 400 MFlops (milionů floating-point operací). Konkrétně ten stroj, který je na fotografii, stál v laboratoři kryptografie NSA USA a zabýval se dekódováním šifer. Pokud převedeme 15 milionů dolarů z roku 1984 na dolary z roku 2020, tak cena činí 37,4 milionu, nebo 93 500 dolarů / MFlops.
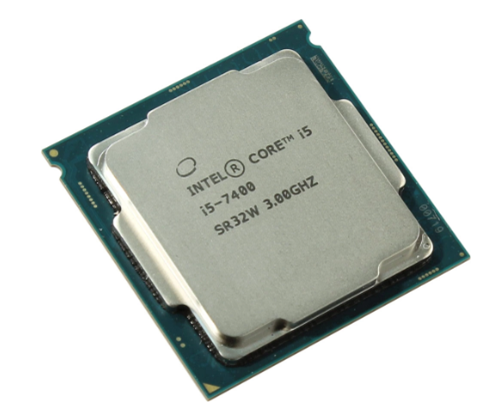
V tomu stroji, na kterém píšu tyto řádky, je procesor Core i5-7400 z roku 2017, což není zrovna nový kousek, a dokonce v roce svého uvedení byl nejmladším 4-jádrovým ze všech desktopových procesorů střední třídy. 4 jádra s základní frekvencí 3,0 GHz (3,5 s Turbo Boost) a zdvojení vláken pomocí HyperThreading poskytují od 19 do 47 GFlops výpočetního výkonu podle různých testů při ceně 16 000 rublů za procesor. Pokud sestavíme stroj kompletně, můžeme akceptovat jeho cenu jako 750 dolarů (podle cen a kurzu k 1. březnu 2020).
Nakonec tak dostáváme převahu docela průměrného desktopového procesoru dneška 50-120krát nad superpočítačem z top10 celkem zřetelného minulého století, přičemž pokles specifické ceny MFlops se stává zcela ohromujícími 93500 / 25 = 3700krát.
Proč ještě potřebujeme servery a centralizaci výpočtů, když máme takové možnosti na okraji — to zůstává nejasné!
Zpětný skok — spirála udělala obrat
Bezdiskové stanice
Prvním signálem, že přesun výpočtů na okraj nebude konečný, bylo zavedení technologie bezdiskových pracovních stanic. Při výrazném rozložení pracovních stanic po provozu, a zejména v znečištěném prostředí, se naléhavě objevuje otázka správy a údržby těchto stanic.
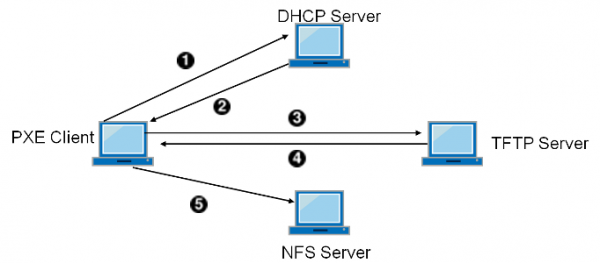
Objevuje se pojem 'koridorový čas' — procento času, kdy se pracovník technické podpory nachází v koridoru, na cestě k zaměstnanci s problémem. Tento čas je placený, ale zcela neproduktivní. Nezanedbatelnou roli, zejména v znečištěných prostorách, sehrály poruchy pevných disků. Pojďme odstranit disk z pracovního stanice a vše ostatní udělat prostřednictvím sítě, včetně zavádění. Síťový adaptér dostává kromě adresy od DHCP serveru také dodatečné informace — adresu TFTP serveru (zjednodušená služba pro soubory) a jméno obrazového souboru, načítá jej do operační paměti a spouští stroj.
Kromě menšího počtu poruch a snížení koridorového času, nyní už není nutné kalibrovat stroj na místě, stačí přinést nový a starý odvézt na diagnostiku na vybavené pracovní místo. Ale to není všechno!
Bezdisková stanice se stává podstatně bezpečnější — pokud by se náhodou někdo dostal do místnosti a odnesl všechny počítače, došlo by pouze k ztrátě zařízení. Na bezdiskových stanicích se neukládají žádná data.
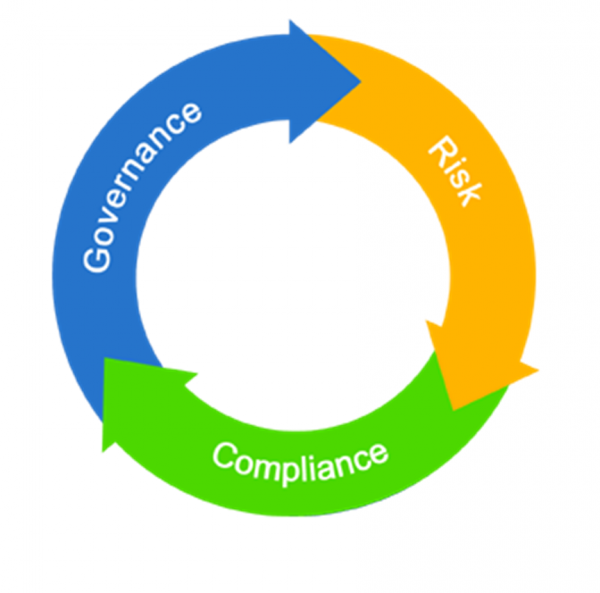
Pamatujeme na tento moment, informační bezpečnost začíná hrát stále větší roli po 'beztarifním dětství' informačních technologií. A v IT stále více pronikají hrozné a důležité 3 písmena — GRC (Governance, Risk, Compliance), čili česky "Řízení, Riziko, Soulad."
Terminálové servery
Rozšíření stále výkonějších osobních počítačů na periferii výrazně předběhlo vývoj veřejných sítí. Klasické klient-server aplikace z 90. let a počátku 00. let nefungovaly příliš dobře přes úzký kanál, pokud výměna dat dosahovala nějakých významných hodnot. Zvlášť to bylo obtížné pro vzdálené kanceláře, které se připojovaly přes modem a telefonní linku, která navíc občas zamrzala nebo se přerušovala. A…
Spirála udělala obrat a ocitla se opět v terminálovém režimu s konceptem terminálových serverů.
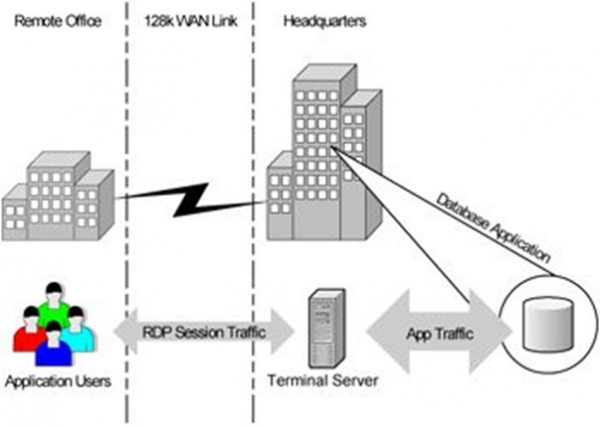
Ve skutečnosti jsme se vrátili do 70. let s jejich nulovými klienty a centralizací výpočetní síly. Velmi rychle se ukázalo, že kromě čistě ekonomických aspektů terminální přístup poskytuje obrovské možnosti pro organizaci bezpečného přístupu zvenčí, včetně práce z domova pro zaměstnance, nebo velmi omezeného a kontrolovaného přístupu kontraktorům z nedůvěryhodných sítí a nedůvěryhodných/nekompatibilních zařízení.
Nicméně terminálové servery měly, i přes všechny své výhody a progresivnost, také řadu nevýhod - nízkou flexibilitu, problém hlučného souseda, striktní serverový Windows atd.
Zrození proto VDI
Pravda, na počátku a uprostřed 00. let už se na scéně objevovala průmyslová virtualizace x86 platformy. A někdo vyslovil jednoduchou myšlenku, která visela ve vzduchu: a co kdybychom namísto centralizace všech klientů na serverových terminálových farmách dali každému jeho osobní VM s klientským Windows a dokonce administrátorským přístupem?
Odklon od tlustých klientů
Současně s virtualizací relací a OS se rozvíjel přístup zaměřený na zjednodušení funkce klienta na úrovni aplikace.
Logika za tím byla poměrně jednoduchá, neboť osobní notebooky nebyly stále ještě pro všechny, internet také nebyl dostupný pro každého, a mnozí se mohli připojit pouze z internetových kaváren s velmi omezenými, mírně řečeno, právy. Ve skutečnosti, vše co bylo možné spustit - byl prohlížeč. Prohlížeč se stal neodmyslitelnou součástí OS, internet pevně vcházel do našich životů.
Jinými slovy, současně probíhal trend na přesun logiky z klienta do centra ve formě webových aplikací, pro jejichž přístup potřebujete pouze ten nejjednodušší klient, internet a prohlížeč.
A my jsme se ocitli nejen na stejném místě, odkud jsme začínali – s nulovými klienty a centrálními servery. Dostali jsme se tam několika nezávislými cestami.
Virtuální Desktopová Infrastruktura
Brokér
V roce 2007 lídr trhu v průmyslové virtualizaci, VMware, vydal první verzi svého produktu VDM (Virtual Desktop Manager), který se stal de facto prvním na právě se rodícím trhu virtuálních desktopů. Samozřejmě netrvalo dlouho, než se ozval lídr terminálových serverů Citrix, a v roce 2008 s akvizicí XenSource se objevuje XenDesktop. Nejpřesvědčivěji však existovali i další dodavatelé se svými nabídkami, ale nebudeme se příliš ponořovat do historie, abychom odstoupili od konceptu.
A tato koncepce přetrvává dodnes. Klíčovou součástí VDI je brokér spojení.
To je srdce infrastruktury virtuálních desktopů.
Brokér zodpovídá za nejdůležitější procesy fungování VDI:
- Určuje dostupné prostředky pro připojeného klienta (stroje/relace);
- Vyvažuje podle potřeby klienty mezi skupinami strojů/relací;
- Přenáší klienta na vybraný prostředek.
Dnes může být klientem (terminálem) pro VDI prakticky cokoliv, co má obrazovku – notebook, smartphone, tablet, kiosk, tenký nebo nulový klient. A zpětnou částí, tou, která vykonává produktivní zátěž – je relace terminálového serveru, fyzický stroj, virtuální stroj. Moderní vyspělé produkty VDI jsou úzce integrovány s virtuální infrastrukturou a samostatně ji řídí v automatickém režimu, nasazují nebo naopak odstraňují již nepotřebné virtuální stroje.
Někde stranou, ale pro některé klienty extrémně důležitou technologií VDI je podpora hardwarového zrychlení 3D grafiky pro práci projektantů nebo designérů.
Protokol
Druhou nesmírně důležitou součástí vyzralého řešení VDI je protokol pro přístup k virtuálním zdrojům. Pokud jde o práci v rámci podnikové místní sítě s vynikající spolehlivou sítí 1 Gbps do pracovního místa a zpožděním 1 ms, lze vzít prakticky jakýkoli a vůbec o tom nepřemýšlet.
Při připojení přes nekontrolovanou síť je třeba se zamyslet, protože kvalita této sítě může být zcela různá, až do rychlostí v desítkách kilobit a nepředvídatelných zpoždění. Tyto faktory jsou klíčové pro organizaci skutečné vzdálené práce z chat, domova, letišť a kaváren.
Terminálové servery vs klientské VM
Když se objevil VDI, vypadalo to, že je čas se rozloučit s terminálovými servery. Proč by byly potřeba, když má každý svou osobní VM?
Nicméně z pohledu čisté ekonomiky se ukázalo, že pro typické masové pracovní místa, která jsou si až příliš podobná, zatím neexistuje nic efektivnějšího než terminálové servery v poměru cena / relace. I se všemi svými výhodami přístup "1 uživatel = 1 VM" spotřebovává výrazně více zdrojů na virtuální hardware a plnohodnotný operační systém, což zhoršuje ekonomiku na typických pracovních místech.
V případě pracovních míst manažerů, netradičních a zatížených pracovních míst, kde je potřeba mít vysoká práva (až po administrátorská), má výhodu vyhrazená VM na uživatele. V rámci této VM lze individuálně přidělovat zdroje, udělovat práva libovolné úrovně a vyvažovat VM mezi hostiteli virtualizace při vysoké zátěži.
VDI a ekonomika
Leckdy slyším stejnou otázku — a jak, VDI je levnější než prostě rozdat všem notebooky? A léta odpovídám stále to samé: v případě běžných kancelářských zaměstnanců není VDI levnější, pokud počítáme čisté náklady na zajištění vybavení. Ať chceme, notebooky zlevňují, zatímco servery, úložné systémy a systémový software stojí poměrně vysoké částky. Pokud nadešel čas na modernizaci parku a snažíte se ušetřit pomocí VDI — ne, neušetříte.
Dříve jsem zmiňoval hrozivé tři písmena GRC — takže, VDI je o GRC. Je to o řízení rizik, o bezpečnosti a pohodlném řízeném přístupu k datům. A to vše obvykle stojí poměrně dost peněz na implementaci na pestré technice. Pomocí VDI se kontrola usnadňuje, bezpečnost se zvyšuje a vlasy jsou jemné a hedvábné.
Řešení HPE pro vzdálenou práci
Vzdálené a cloudové řízení
iLO
Společnost HPE není nováčkem v oblasti vzdáleného řízení serverové infrastruktury; v březnu oslavil legendární iLO (Integrated Lights Out) 18 let. Když vzpomínám na své administrátorské časy v nultých letech, byl jsem velmi spokojen. Primární montáž do stojanů a připojení kabelů – to bylo vše, co bylo potřeba udělat v hlučném a chladném datovém centru. Vše ostatní, včetně instalace operačního systému, se dalo realizovat z pracovního místa s dvěma monitory a šálkem horké kávy. A to už je to 13 let zpátky!
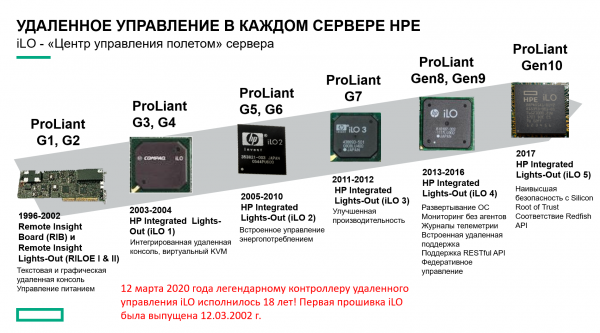
Dnes jsou servery HPE právem považovány za nepochybný letitý standard kvality – a zlato v systému vzdáleného řízení – iLO hraje v tomto nepochybně důležitou roli.
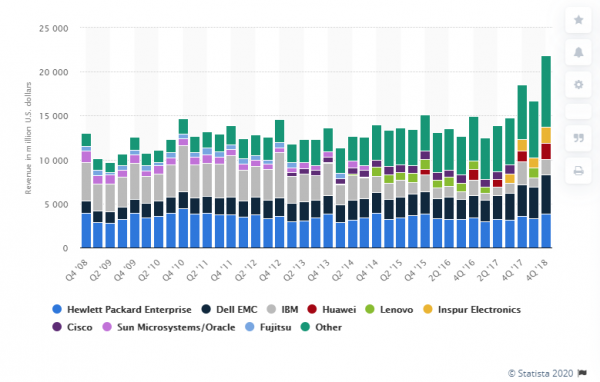
Je třeba zvlášť vyzdvihnout kroky HPE k udržení kontroly lidstva nad koronavirem. , že do konce roku 2020 (alespoň) je licence iLO Advanced k dispozici všem zdarma.
Infosight
Pokud máte více než 10 serverů v infrastruktuře a administrátor se nenudí, rozhodně skvělým doplňkem ke standardním monitorovacím nástrojům bude cloudový systém HPE Infosight založený na umělé inteligenci. Systém nejen monitoruje stav a vytváří grafy, ale také doporučuje další kroky na základě aktuální situace a trendů.
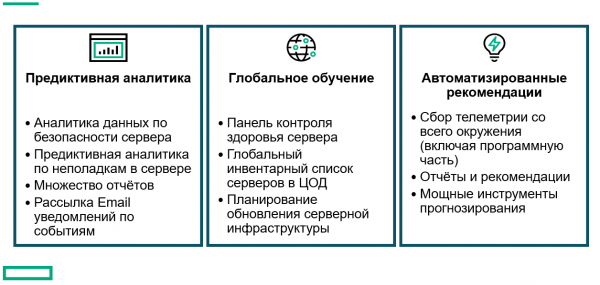
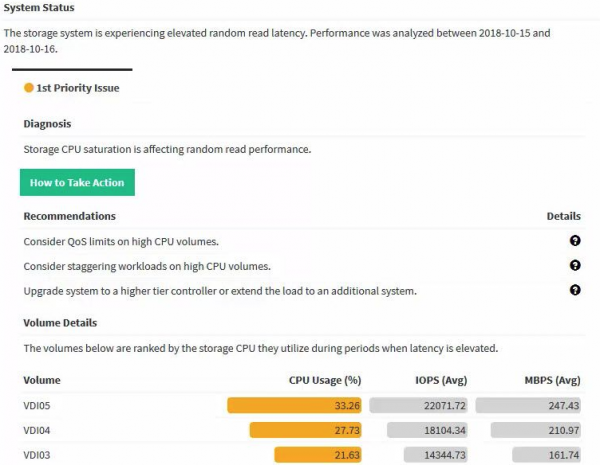
Buďte chytří, , vyzkoušejte Infosight!
OneView
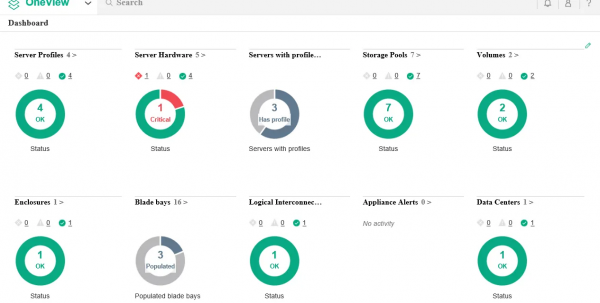
Na závěr, ale nikoli nic méně důležité, chci zmínit HPE OneView – celou produktovou řadu s obrovskými možnostmi monitorování a řízení celé infrastruktury. A to vše bez zvednutí se od pracovního stolu, který možná v současnosti máte vůbec na chalupě.
Úložiště také nejsou pozadu!
Samozřejmě, všechny úložiště jsou vzdáleně řízena, monitorována – tak tomu bylo už před mnoha lety. Dnes se tedy chci věnovat něčemu jinému, konkrétně metroklastrům.
Metroklastry nejsou na trhu žádnou novinkou, ale právě proto, že tomu tak je, nejsou příliš populární – projevuje se zde setrvačnost myšlení a prvotní dojmy. Samozřejmě, před 10 lety už existovaly, ale stály jako železobetonový most. Roky, které uplynuly od prvních metroklastrů, změnily průmysl a dostupnost technologie široké veřejnosti.
Pamatuji si projekty, kde byly části úložišť rozloženy - zvlášť pro vysoce kritické služby v metroklastru a zvlášť na synchronní replikaci (podstatně levnější).
V podstatě, v roce 2020 vás metroklastr nic nestojí, pokud dokážete zorganizovat dvě lokace a kanály. A kanály pro synchronní replikaci jsou identické s těmi, které potřebujete pro metroklastry. Licencování softwaru už dávno probíhá v balících - a synchronní replikace již přichází jako součást metroklastru, a jediné, co dosud chrání jednosměrnou replikaci, je nutnost organizace roztažené L2 sítě. A i to, L2 over L3 již plně kráčí po zemi.
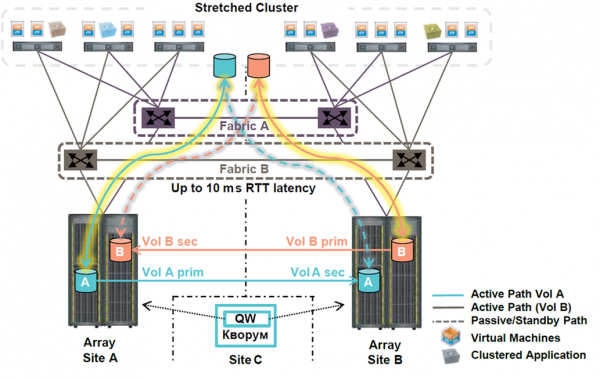
Jaký je tedy zásadní rozdíl mezi synchronní replikací a metroklastrem z pohledu vzdálené práce?
Všechno je velmi jednoduché. Metroklastr funguje sám, automaticky, vždy, prakticky okamžitě.
Jak probíhá proces přepínání zátěže na synchronní replikaci na infrastruktuře alespoň několika stovek VM?
- Přichází signál o havárii.
- Pohotovostní směna analyzuje situaci - můžete si s klidem naplánovat od 10 do 30 minut pouze na přijetí signálu a přijetí rozhodnutí.
- V případě absence pravomocí pohotovostních inženýrů pro samostatný start přepínání - dalších 30 minut na kontakt s osobou, která má pravomoci, a formální potvrzení začátku přepínání.
- Stisknutí Velkého Červeného Tlačítka.
- 10-15 minut na časové timeouty a přehození svazků, přehlášení VM.
- 30 minut na změnu IP adresace - optimistické hodnocení.
- A konečně start VM a spuštění produktivních služeb.
Celkově lze RTO (čas do obnovy obchodních procesů) s klidem odhadnout na 4 hodiny.
Porovnejme to se situací na metroklastru.
- Úložiště chápe, že spojení s ramenem metroklastru je ztraceno - 15-30 sekund.
- Hostitelé virtualizace chápu, že první datové centrum je ztraceno - 15-30 sekund (současně s bodem 1).
- Automatické restartování od poloviny do třetiny VM ve druhém datovém centru - 10-15 minut do načtení služeb.
- Zhruba v tuto dobu pohotovostní směna chápe, co se stalo.
Celkově: RTO = 0 pro jednotlivé služby, 10-15 minut ve všeobecném případě.
Proč je restart jen od poloviny do třetiny VM? Koukněte se, v čem je problém:
- Vy všechno děláte chytře a zapínáte automatickou vyváženost VM. V průměru tedy běží pouze polovina VM v jednom z datových center. Vždyť celým smyslem metroklastru je minimalizace prostojů, tudíž je ve vašem zájmu minimalizovat i počet VM pod hrozbou.
- Některé služby lze clusterizovat na úrovni aplikace, rozložením na různé VM. Odpovídající tyto párové VM jsou buď přišroubovány nebo přivázány páskem k různým datovým centrům, aby služba vůbec nečekala na restart VM v případě havárie.
Při správně postavené infrastruktuře s rozloženými metroklastry obchodní uživatelé pracují s minimálními prodlevami z jakéhokoli místa, i v případě havárie na úrovni datového centra. V nejhorším případě bude prodleva trvat stejně dlouho jako na jeden šálek kávy.
A samozřejmě, metroklastry skvěle fungují jak na odcházejících HPE 3Par, tak na úplně nových Primera!
Infrastruktura vzdálených pracovních míst
Terminálové servery
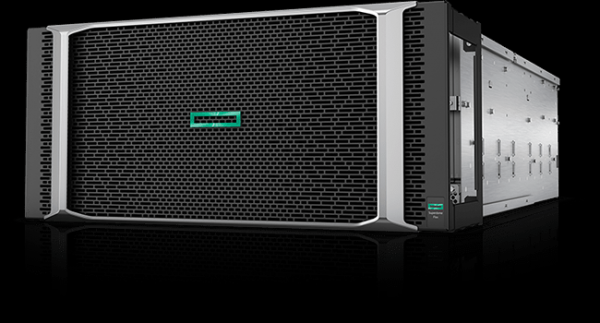
Pro terminálové servery není potřeba vymýšlet nic nového, HPE už mnoho let dodává jedny z nejlepších serverů na světě pro ně. Nestárnoucí klasika — DL360 (1U) nebo DL380 (2U) či pro milovníky AMD — DL385. Samozřejmě, k dispozici jsou i blade servery, jak klasické C7000, tak nová modulární platforma Synergy.
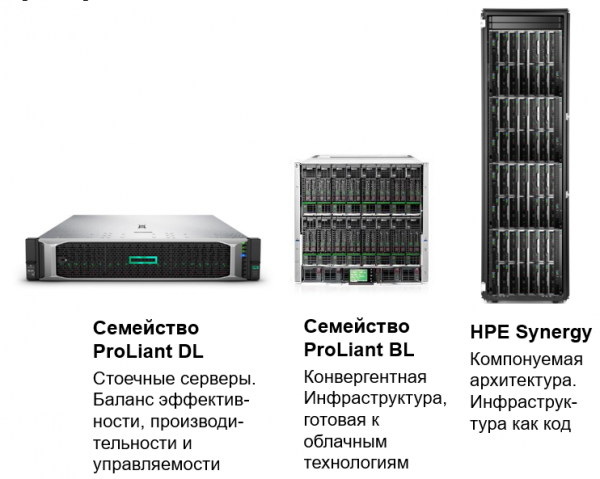
Na jakoukoli chuť, na jakoukoli barvu, maximum sezení na server!
„Klasický“ VDI + HPE Simplivity
V tomto případě, když říkám „klasický VDI“, mám na mysli koncept 1 uživatel = 1 VM s klientským Windows. A samozřejmě, není nic bližšího a příbuznějšího VDI zátěži pro hyperkonvergentní systémy, tím spíše s deduplikací a kompresí.
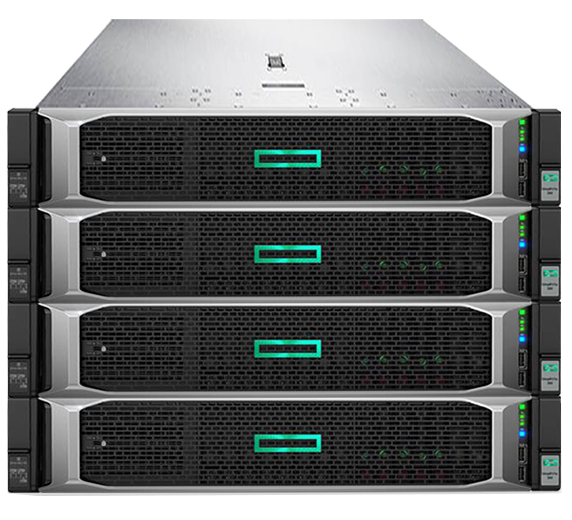
Zde může HPE nabídnout jak svou vlastní hyperkonvergentní platformu Simplivity, tak servery / certifikované uzly pro řešení partnerů, jako například VSAN Ready Nodes pro vytvoření VDI na infrastruktuře VMware VSAN.
Pojďme si povídat o našem vlastním řešení Simplivity. V popředí, jak nám jemně naznačuje název, je jednoduchost (angl. simple — jednoduchý). Jednoduchost nasazení, jednoduchost správy, jednoduchost škálování.
Hiperkonvergované systémy jsou v současnosti jedním z nejžhavějších témat v IT a počet různých dodavatelů se pohybuje kolem 40. Podle magického kvadrantu Gartner se společnost HPE řadí mezi Top 5 na globální úrovni a nachází se v kvadrantu lídrů — chápe, kam se průmysl rozvíjí, a je schopna tuto vizi zrealizovat v hardwaru.
Architektura Simplivity je klasickým příkladem hiperkonvergovaného systému s virtuálními stroji na řízení, což znamená, že může podporovat různé hypervizory, na rozdíl od systémů integrovaných do hypervizoru. K dubnu 2020 jsou skutečně podporovány VMware vSphere a Microsoft Hyper-V, a byly avizovány plány na podporu KVM. Klíčovým prvkem Simplivity od jejího uvedení na trh bylo hardwarové urychlení komprese a deduplikace pomocí speciální akcelerační karty.
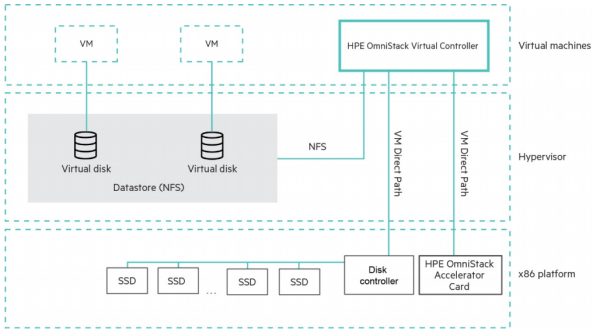
Je třeba zdůraznit, že komprese s deduplikací je globální a neustále aktivní, takže to není volitelná funkce, ale architektura řešení.
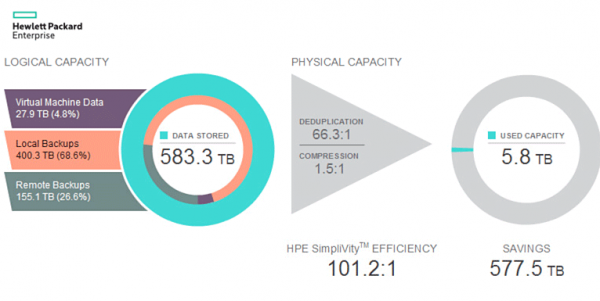
HPE samozřejmě trochu přehání, když tvrdí efektivitu 100:1, přičemž ji počítají určitým způsobem, ale efektivita využití prostoru je skutečně velmi vysoká. Číslo 100:1 je prostě příliš krásné. Pojďme se podívat, jak je Simplivity technicky realizovaná, abychom ukázali taková čísla.
Snímek. Snímky (instantní snímky) jsou 100% správně realizovány jako RoW (Redirect-on-Write), a proto se provádějí okamžitě a nezpůsobují penalizaci výkonu. Například se liší od některých jiných systémů. Proč potřebujeme lokální snímky bez penalizací? To je velmi jednoduché, pro snížení RPO z 24 hodin (průměrné RPO pro zálohování) na desítky nebo dokonce jednotky minut.
Záloha. Snímek se od zálohy liší pouze tím, jak ho vnímá systém správy virtuálních strojů. Pokud je při odstranění stroje odstraněno i všechno ostatní — znamená to, že šlo o snímek. Pokud zůstalo — pak jde o zálohu. Tímto způsobem může být jakýkoli snímek považován za plnou zálohu, pokud je označen v systému a není odstraněn.
Samozřejmě, mnozí namítnou – jak může být záloha, když je uložena na tomtéž systému? A zde je velmi jednoduchá odpověď v podobě protik otázce: řekněte, máte formální model hrozeb, který určuje pravidla pro ukládání záloh? Je to absolutně legitimní záloha proti odstranění souboru uvnitř VM, je to záloha proti odstranění samotného VM. V případě potřeby uchování zálohy výhradně na samostatném systému je na výběr: replikace tohoto snímku do druhého clustera Simplivity nebo na HPE StoreOnce.
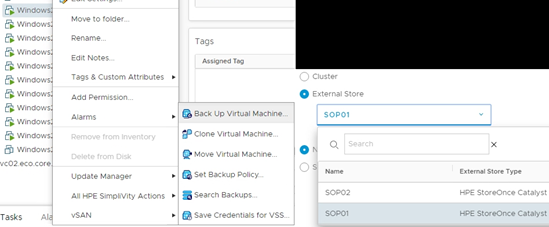
A právě zde se ukazuje, že taková architektura je naprosto ideální pro jakýkoli typ VDI. VDI jsou totiž stovky nebo dokonce tisíce velmi podobných strojů se stejným operačním systémem a stejnými aplikacemi. Globální deduplikace to vše zpracuje a zmenší dokonce i více než 100:1. Nasadit 1000 VM z jedné šablony? Vůbec žádný problém, tyto stroje se budou registrovat v vCenter déle než se klonují.
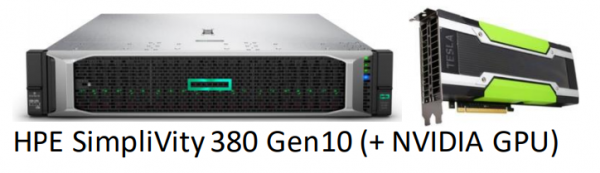
Speciálně pro uživatele s mimořádnými požadavky na výkon, a pro ty, kdo potřebují 3D akcelerátory, byla vytvořena řada Simplivity G.
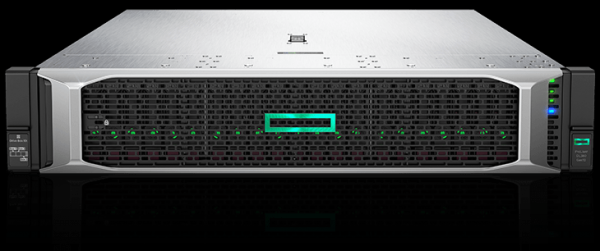
V této řadě se nepoužívá hardwarový akcelerátor deduplikace, a proto je sníženo množství disků na uzel, aby kontroller zvládl zpracování softwarově. Díky tomu se uvolňují sloty PCIe pro jakékoli jiné akcelerátory. Také byla zdvojnásobena dostupná paměť na uzel až na 3 TB pro nejnáročnější zátěže.
Simplivity je ideální pro organizaci geograficky distribuovaných VDI infrastruktur s replikací dat do centrálního datového centra.
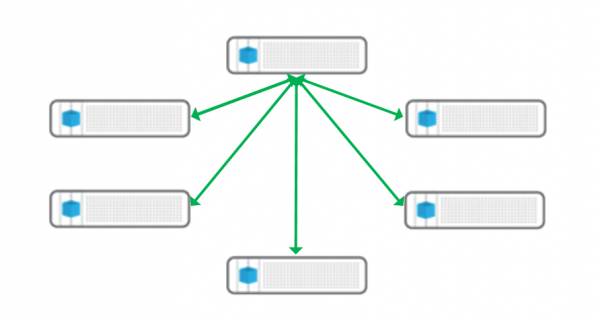
Taková architektura VDI (a nejen VDI) je zvlášť zajímavá v podmínkách ruských realit – obrovské vzdálenosti (a tím pádem zpoždění) a rozhodně neideální kanály. Jsou vytvářena regionální centra (nebo dokonce jen 1-2 uzly Simplivity v zcela vzdálené kanceláři), kam se připojují místní uživatelé přes rychlé kanály, zachovává se plná kontrola a správa z centra, a do centra se replikují pouze nepatrné množství skutečných, cenných údajů, nikoli odpadních.
Samozřejmě, Simplivity se plně propojuje s OneView a InfoSight.
Tenčí a nuloví klienti
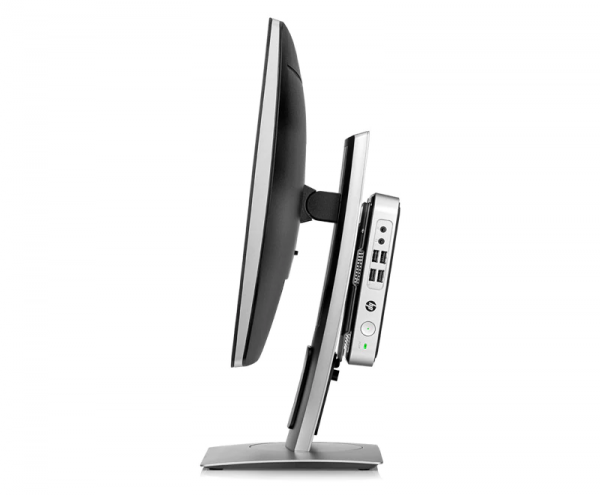
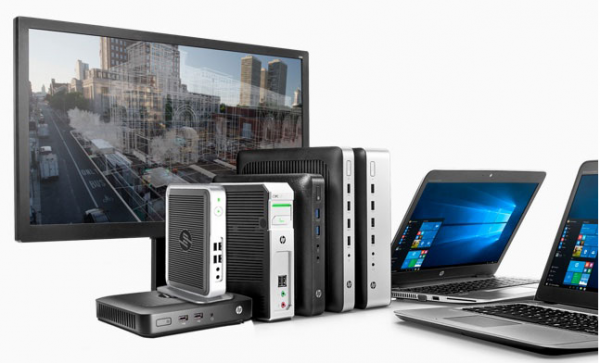
Tenčí klienti jsou specializovaná řešení určená výhradně pro použití jako terminály. Protože na klienta prakticky není žádné zatížení kromě udržování kanálu a dekódování videa, téměř vždy je zde procesor s pasivním chlazením a malé spouštěcí disky určené pouze pro start speciální vestavěné operační soustavy, a v podstatě to vše. V podstatě se v něm není co pokazit a krást je zbytečné. Cena je nízká a žádná data se v něm nesmějí uchovávat.
Existuje zvláštní kategorie tenkých klientů, takzvaní nuloví klienti. Jejich hlavním rozdílem od tenkých klientů je absence jakéhokoli vestavěného operačního systému obecného určení a práce výhradně s mikročipem s firmwarem. Často mají speciální hardwarové akcelerátory pro dekódování video streamu v terminálových protokolech, jako jsou PCoIP nebo HDX.
I přes rozdělení velkého Hewlett Packardu na samostatné HPE a HP, nelze opomenout tenké klienty vyráběné společností HP.
Výběr je široký, pro každého a pro jakékoli potřeby — až po více monitorová pracovní místa s hardwarovou akcelerací video streamu.
Služba HPE pro vaši domácí kancelář
A jako poslední, ale nikoli méně důležité, chci zmínit službu HPE. Bylo by příliš dlouhé vyjmenovávat všechny úrovně služby HPE a její možnosti, ale jistě zde existuje jedna velmi důležitá nabídka pro práci na dálku. A to totiž — servisní technik od HPE/autorizovaného servisního střediska. Pokračujete v práci na dálku, se svých oblíbených chalup, posloucháte bzučení včel, zatímco technik od HPE přijede do datového centra a vymění vaše servery disky nebo porouchaný napájecí blok.
HPE CallHome
V dnešní době, kdy jsou pohyby omezené, se funkce Call Home stává aktuálnější než kdy jindy. Jakýkoli systém HPE s touto funkcí může sám nahlásit hardwarovou nebo softwarovou poruchu do podpůrného centra HPE. Je velmi pravděpodobné, že díl na výměnu a/nebo servisní technik k vám dorazí ještě dávno předtím, než si všimnete závad a problémů s produktivními službami.
Osobně tuto funkci důrazně doporučuji aktivovat.
Zdroj: habr.com
