

As we all know, last year was a year of significant changes for Apache Hadoop. The merger of Cloudera and Hortonworks took place, essentially absorbing the latter, while MapR was sold to Hewlett Packard due to severe financial issues. If a few years ago, the choice for on-premises installations mostly lay between Cloudera and Hortonworks, currently we unfortunately have no choice left. Another surprise was that Cloudera announced in February this year that it would stop releasing binary distributions of its software in the public repository, making them available only through a paid subscription. Of course, there is still an option to download the latest versions of CDH and HDP released before the end of 2019, and support for them is expected for one to two years. But what to do next? For those who previously paid for a subscription, nothing has changed. For those who do not want to switch to a paid version of the distribution but want to have access to the latest versions of cluster components, as well as patches and other updates, we have prepared this article. We will explore possible options for addressing the current situation.
This article is more of an overview. It will not compare distributions or discuss them in detail, nor will it provide recipes for their installation and configuration. So what will it cover? We will briefly talk about a distribution called Arenadata Hadoop, which rightfully deserves our attention due to its accessibility, a rarity these days. Then we will discuss Vanilla Hadoop, focusing mainly on how to 'prepare' it using Apache Bigtop. Ready? Then welcome!
Arenadata Hadoop
This is a completely new and, for now, still little-known distribution of domestic development. Unfortunately, currently on Habr, there is only .
More detailed information can be found on the official project. The latest versions of the distribution are based on Hadoop 3.1.2 for version 3, and 2.8.5 for version 2.
Information about the roadmap can be found .
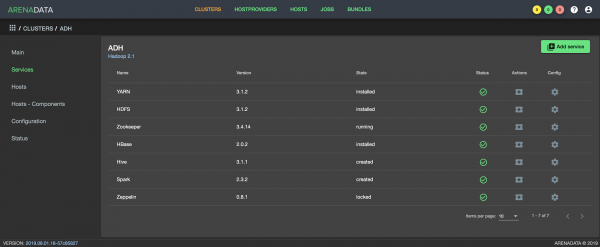
The Arenadata Cluster Manager interface
The key product of Arenadata is , který se používá k instalaci, konfiguraci a monitorování různých softwarových řešení společnosti. ADCM se šíří zdarma a jeho funkce se rozšiřují přidáním balíčků, které představují sadu ansible-playbooků. Balíčky se dělí na dvě kategorie: enterprise a community. Ty druhé jsou k dispozici ke stažení zdarma na webových stránkách Arenadata. Také existuje možnost vyvinout si vlastní balíček a připojit ho k ADCM.
Pro nasazení a správu Hadoop 3 je nabízena community-verze balíčku ve spojení s ADCM, zatímco pro Hadoop 2 je dostupná pouze jako alternativa. Co se týče repozitářů s balíčky, ty jsou otevřeny pro veřejný přístup, lze je stáhnout a nainstalovat obvyklým způsobem pro všechny komponenty clustera. Celkově se distribuce jeví jako velmi zajímavá. Jsem si jistý, že se najdou ti, kteří jsou zvyklí na taková řešení jako Cloudera Manager a Ambari, a kteří si ADCM oblíbí. Pro někoho bude velkým plusem i to, že distribuce pro importní substituci.
Pokud se hovoří o nevýhodách, ty budou stejné jako u všech ostatních distribucí Hadoop. A to konkrétně:
- Takzvaný „vendor lock-in“. Na příkladech Cloudera a Hortonworks jsme již pochopili, že vždy existuje riziko změny politiky společnosti.
- Významné zpoždění za upstreamem Apache.
Vanilla Hadoop
Jak víte, Hadoop není monolitní produkt, ale v podstatě soubor služeb kolem jeho distribuovaného souborového systému HDFS. Málokomu bude stačit pouze jeden souborový cluster. Někteří potřebují Hive, jiní Presto, někteří HBase a Phoenix, stále častěji se používá Spark. Pro orchestraci a načítání dat se někdy používají Oozie, Sqoop a Flume. A pokud se dostaneme k otázce zajištění bezpečnosti, okamžitě vzpomeneme na Kerberos ve spojení s Ranger.
Binární verze komponent Hadoop jsou k dispozici na stránkách jednotlivých projektů ekosystému ve formě tarballů. Můžete je stáhnout a začít instalaci, ale za jedné podmínky: kromě vlastního sestavení balíčků z "neodborných" binárek, které pravděpodobně budete chtít provést, nebudete mít žádnou jistotu o kompatibilitě stažených verzí komponent mezi sebou. Preferovanější možností je sestavení pomocí Apache Bigtop. Bigtop umožní provést sestavení z maven repozitářů Apache, spustit testy a vytvořit balíčky. Což je pro nás velmi důležité, Bigtop sestaví ty verze komponent, které budou mezi sebou kompatibilní. O něm si podrobněji povíme dále.
Apache Bigtop
Apache Bigtop je nástroj pro sestavování, balení a testování řady
open source projektů, jako jsou například Hadoop a Greenplum. Bigtop má mnoho
verzí. V době psaní článku byla poslední stabilní verzí verze 1.4,
a v master byla 1.5. V různých verzích se používají různé verze
komponent. Například pro 1.4 jsou core komponenty Hadoop ve verzi 2.8.5, zatímco v master
je to 2.10.0. Mění se také složení podporovaných komponent. Něco zastaralého a
neaktualizovatelného odchází, a na jeho místo přichází něco nového, poptávanějšího, a
to nemusí být nutně něco z rodiny samotného Apache.
Kromě toho má Bigtop mnoho .
Když jsme začali poznávat Bigtop, nejprve nás překvapila jeho skromná, ve srovnání s jinými projekty Apache, rozšířenost a známost, a také velmi malé komunitě. Z toho vyplývá, že informací o produktu je minimum a hledání řešení vzniklých problémů na fórech a mailing listech může nakonec přinést nic. Zpočátku pro nás bylo obtížné provést úplné sestavení distribuce kvůli vlastnostem samotného nástroje, ale o tom si povíme trochu později.
Jako teaser — těm, kteří si v minulosti užili takové projekty v Linuxovém vesmíru, jako jsou Gentoo a LFS, se možná nostalgicky příjemně vzpomíná na práci s tímto nástrojem a na ty "legendární" časy, kdy jsme sami hledali (a také psali) ebuildy a pravidelně přestavovali s novými patchemi Mozillu.
Velkým plusem Bigtopu lze považovat otevřenost a univerzálnost nástrojů, na nichž je založen. V jeho základech stojí Gradle a Apache Maven. Gradle je dobře známý jako nástroj, kterým Google sestavuje Android. Je flexibilní a, jak se říká, "prověřený v boji". Maven je přidružený nástroj pro sestavení projektů v samotném Apache, a protože většina jeho produktů je vydávána právě přes Maven, bez něj se také neobejdeme. Stojí za to věnovat pozornost POM (model objektu projektu) – "základní" xml soubor s popisem všeho potřebného pro práci Mavenu s vaším projektem, kolem něhož se staví veškerá práce. Právě v
části Mavenu se vyskytují některé překážky, na které obvykle narazí noví uživatelé Bigtopu.
Praxe
Takže, kde začít? Přejděte na stránku ke stažení a stáhněte si poslední stabilní verzi ve formátu archivu. Tam najdete i binární artefakty, které sestavil Bigtop. Mimochodem, z běžných správce balíčků jsou podporovány YUM a APT.
Alternativním způsobem je stáhnout poslední stabilní vydání přímo z
github:
$ git clone --branch branch-1.4 https://github.com/apache/bigtop.gitKlonování do "bigtop"...
remote: Sčítání objektů: 46, hotovo.
remote: Počet objektů: 100% (46/46), hotovo.
remote: Komprese objektů: 100% (41/41), hotovo.
remote: Celkem 40217 (delta 14), znovu použito 10 (delta 1), balení znovu použito 40171
Získávání objektů: 100% (40217/40217), 43.54 MiB | 1.05 MiB/s, hotovo.
Stanovení změn: 100% (20503/20503), hotovo.
Aktualizace souborů: 100% (1998/1998), hotovo.
Nově vytvořený adresář ./bigtop vypadá přibližně takto:
./bigtop-bigpetstore — demonstrační aplikace, syntetické příklady
./bigtop-ci — nástroje CI, jenkins
./bigtop-data-generators — generování dat, syntetika, pro smoke testy atd.
./bigtop-deploy — nástroje pro nasazení
./bigtop-packages — konfigurace, skripty, patche pro sestavení, hlavní část nástroje
./bigtop-test-framework — testovací rámec
./bigtop-tests — samotné testy, zátěžové a smoke
./bigtop_toolchain — prostředí pro sestavení, příprava prostředí pro práci nástroje
./build — pracovní adresář sestavení
./dl — adresář pro stažené zdrojové kódy
./docker — sestavení v docker obrazech, testování
./gradle — konfigurace gradle
./output – adresář, do kterého se ukládají artefakty sestavení
./provisioner — providenci
Nejzajímavějším bodem v této fázi pro nás je hlavní konfigurace ./bigtop/bigtop.bom, ve kterém vidíme všechny podporované komponenty s verzemi. Právě zde můžeme uvést jinou verzi produktu (pokud bychom ji chtěli vyzkoušet) nebo verzi sestavení (pokud jsme například přidali významný patch).
Také velký zájem vzbuzuje podadresář .\/bigtop\/bigtop-packages, který má přímou souvislost s procesem sestavování komponent a balíčků s nimi.
Takže jsme stáhli archiv, rozbalili ho nebo vytvořili klon z githubu, můžeme začít se sestavováním?
Ne, nejprve připravíme prostředí.
Příprava prostředí
A zde bude potřeba malé odbočení. Pro sestavu téměř jakéhokoliv více či méně složitého produktu je nutné určité prostředí – v našem případě jde o JDK, stejná sdílená knihovna, hlavičkové soubory atd., nástroje, například ant, ivy2 a mnoho dalších. Jednou z možností, jak získat potřebné pro Bigtop prostředí, je instalace potřebných komponent na hostiteli pro sestavení. Můžu se mýlit v chronologii, ale zdá se, že od verze 1.0 se objevila také možnost sestavení v předem nakonfigurovaných a dostupných dockerových obrazech, které si můžete prohlédnout zde.
Co se týče přípravy prostředí, k tomu je zde pomocník – Puppet.
Můžete použít následující příkazy, spuštění se provádí z kořenového adresáře
nástroje, .\/bigtop:
.\/gradlew toolchain\n.\/gradlew toolchain-devtools\n.\/gradlew toolchain-puppetmodules
Nebo přímo přes puppet:
puppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::installer"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::deployment-tools"\npuppet apply --modulepath=<path_to_bigtop> -e "include bigtop_toolchain::development-tools"Bohužel, již v této fázi mohou nastat komplikace. Obecná rada je zde – použít podporovanou distribuci, která je aktuální na hostiteli pro sestavení, nebo zkusit cestu s dockerem.
Sestavení
Co můžeme zkusit sestavit? Odpověď na tuto otázku dá výstup příkazu
.\/gradlew tasks V části Package tasks je celý řada produktů, které jsou konečnými artefakty Bigtop.
Lze je identifikovat podle přípony -rpm nebo -pkg-ind (v případě sestavení
v dockeru). V našem případě je nejzajímavější Hadoop.
Zkusíme provést sestavení v prostředí našeho buildserveru:
.\/gradlew hadoop-rpmBigtop si stáhne všechny potřebné zdrojové kódy potřebné pro konkrétní komponentu a začne sestavování. Tímto způsobem je funkce nástroje závislá na repozitářích Maven a dalších zdrojích, což znamená, že potřebuje přístup k internetu.
Během práce se generuje standardní výstup. Někdy podle něj a chybových hlášení můžete pochopit, co se pokazilo. A někdy je třeba získat další informace. V takovém případě je dobré přidat argumenty --info nebo --debug, a také může být užitečný –stacktrace. Existuje pohodlný způsob, jak vytvořit soubor dat pro následné oslovení v mailing listech, klíč --scan.
S jeho pomocí bigtop shromáždí všechny informace a uloží je do gradle, poté vydá odkaz,
po jehož kliknutí může kompetentní osoba pochopit, proč se sestavení nezdařilo.
Je třeba mít na paměti, že tato možnost může udělat veřejnými nežádoucí informace, jako jsou uživatelská jména, uzly, proměnné prostředí atd., buďte tedy opatrní.
Chyby často vyplývají z neschopnosti získat některé potřebné komponenty pro sestavení. Obvykle je problém možné vyřešit vytvořením záplaty na opravu něčeho ve zdrojových kódech, například adresy v pom.xml v kořenovém adresáři zdrojových kódů. To se provádí vytvořením a umístěním do odpovídajícího adresáře .\/bigtop\/bigtop-packages\/src\/common\/oozie\/ záplaty, například ve formě patch2-fix.diff.
--- a\/pom.xml
+++ b\/pom.xml
@@ -136,7 +136,7 @@
<repositories>
<repository>
<id>central<\/id>
- <url>http:\/\/repo1.maven.org\/maven2<\/url>
+ <url>https:\/\/repo1.maven.org\/maven2<\/url>
<snapshots>
<enabled>false<\/enabled>
<\/snapshots>
Pravděpodobně, v době čtení tohoto článku, nebudete muset tento opravu provádět sami.
Při implementaci jakýchkoli záplat a oprav v mechanismu sestavení může být nutné "resetovat" sestavení pomocí příkazu pro čištění:
.\/gradlew hadoop-clean
> Task :hadoop_vardefines
> Task :hadoop-clean
BUILD SUCCESSFUL in 5s
2 actionable tasks: 2 executed
Tato operace vrátí všechny změny provedené na sestavení této komponenty, po čemž bude sestavení provedeno znovu. Tentokrát se pokusíme sestavit projekt v dockerovém obraze:
.\/gradlew -POS=centos-7 -Pprefix=1.2.1 hadoop-pkg-ind
> Úkol :hadoop-pkg-ind
Sestavení 1.2.1 hadoop-pkg na centos-7 v Dockeru...
+++ dirname .\/bigtop-ci\/build.sh
++ cd .\/bigtop-ci\/..
++ pwd
+ BIGTOP_HOME=\/tmp\/bigtop
+ '[' 6 -eq 0 ']'
+ [[ 6 -gt 0 ]]
+ key=--prefix
+ case $key in
+ PREFIX=1.2.1
+ shift
+ shift
+ [[ 4 -gt 0 ]]
+ key=--os
+ case $key in
+ OS=centos-7
+ shift
+ shift
+ [[ 2 -gt 0 ]]
+ key=--target
+ case $key in
+ TARGET=hadoop-pkg
+ shift
+ shift
+ [[ 0 -gt 0 ]]
+ '[' -z x ']'
+ '[' -z x ']'
+ '[' '' == true ']'
+ IMAGE_NAME=bigtop\/slaves:1.2.1-centos-7
++ uname -m
+ ARCH=x86_64
+ '[' x86_64 '!=' x86_64 ']'
++ docker run -d bigtop\/slaves:1.2.1-centos-7 \/sbin\/init
+
CONTAINER_ID=0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8
+ trap 'docker rm -f
0ce5ac5ca955b822a3e6c5eb3f477f0a152cd27d5487680f77e33fbe66b5bed8' EXIT
....
velké množství výstupu
....
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-namenode-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-secondarynamenode-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-zkfc-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-journalnode-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-datanode-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-httpfs-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-resourcemanager-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-nodemanager-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-proxyserver-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-yarn-timelineserver-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-mapreduce-historyserver-2.8.5-
1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-client-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-conf-pseudo-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-doc-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-libhdfs-devel-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-hdfs-fuse-2.8.5-1.el7.x86_64.rpm
Zapsáno: \/bigtop\/build\/hadoop\/rpm\/RPMS\/x86_64\/hadoop-debuginfo-2.8.5-1.el7.x86_64.rpm
+ umask 022
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ cd hadoop-2.8.5-src
+ \/usr\/bin\/rm -rf \/bigtop\/build\/hadoop\/rpm\/BUILDROOT\/hadoop-2.8.5-1.el7.x86_64
Provádím (%clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.uQ2FCn
+ exit 0
+ umask 022
Provádím (--clean): \/bin\/sh -e \/var\/tmp\/rpm-tmp.CwDb22
+ cd \/bigtop\/build\/hadoop\/rpm\/\/BUILD
+ rm -rf hadoop-2.8.5-src
+ exit 0
[ant:touch] Vytvářím \/bigtop\/build\/hadoop\/.rpm
:hadoop-rpm (Thread[Úkol pracovníka pro ':',5,main]) dokončeno. Trvalo to 38 minut 1.151 sekund.
:hadoop-pkg (Thread[Úkol pracovníka pro ':',5,main]) začalo.
> Úkol :hadoop-pkg
Úkol ':hadoop-pkg' není aktuální, protože:
Úkol nevyhlásil žádné výstupy, i když vykonal akce.
:hadoop-pkg (Thread[Úkol pracovníka pro ':',5,main]) dokončeno. Trvalo to 0.0 sekund.
STAVBA ÚSPĚŠNÁ za 40m 37s
6 akčních úkolů: 6 provedeno
+ VÝSLEDEK=0
+ mkdir -p output
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/build .
+ docker cp
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb:\/bigtop\/output .
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
+ '[' 0 -ne 0 ']'
+ docker rm -f ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
Chyba: Žádný takový kontejner:
ac46014fd9501bdc86b6c67d08789fbdc6ee46a2645550ff6b6712f7d02ffebb
STAVBA ÚSPĚŠNÁ za 41m 24s
1 akční úkol: 1 proveden
Sestavení proběhlo pod CentOS, ale je možné provést i pod Ubuntu:
.\/gradlew -POS=ubuntu-16.04 -Pprefix=1.2.1 hadoop-pkg-indKromě sestavení balíčků pro různé distribuce Linuxu, nástroj umí vytvářet repozitář se sestavenými balíčky, například:
.\/gradlew yumTaké je dobré vzpomenout na smoke testy a nasazení v dockeru.
Vytvořit klastr ze tří uzlů:
.\/gradlew -Pnum_instances=3 docker-provisionerSpustit smoke testy v klastru ze tří uzlů:
.\/gradlew -Pnum_instances=3 -Prun_smoke_tests docker-provisionerOdstranit klastr:
.\/gradlew docker-provisioner-destroyZískat příkazy pro připojení dovnitř docker kontejnerů:
.\/gradlew docker-provisioner-sshZobrazit stav:
.\/gradlew docker-provisioner-statusO Deployment tasks se můžete dočíst podrobněji v dokumentaci.
Co se týče testů, je jich značné množství, převážně smoke a integrační. Jejich analýza přesahuje rámec tohoto článku. Mohu však říci, že sestavení distribuce není tolik složitý úkol, jak by se na první pohled mohlo zdát. Všechny komponenty, které používáme v produkci, se podařilo sestavit a úspěšně otestovat, a také jsme nenarazili na problémy s jejich nasazením a prováděním základních operací v testovacím prostředí.
Kromě stávajících komponent v Bigtop je možné přidat i něco dalšího, dokonce i vlastní softwarový vývoj. Všechny tyto procesy se skvěle automatizují a zapadají do konceptu CI/CD.
Závěr
Je zřejmé, že takto sestavená distribuce by neměla být okamžitě odeslána do produkce. Je třeba chápat, že pokud existuje reálná potřeba sestavit a podporovat vlastní distribuci, je nutné do toho investovat čas a finance.
Nicméně, s správným přístupem a profesionálním týmem je zcela možné obejít se i bez komerčních řešení.
Je důležité poznamenat, že samotný projekt Bigtop potřebuje rozvoj a zdá se, že v současnosti se v něm aktivně nevyvíjí. Také není jasná perspektiva vzniku Hadoop 3. Mimochodem, pokud máte reálnou potřebu pro sestavení Hadoop 3, můžete se podívat na od Arenadata, kde kromě standardních
komponent najdete také celou řadu dalších (Ranger, Knox, NiFi).
Pokud jde o Ростелеком, Bigtop je pro nás jednou z možností, které zvažujeme. Zda se na něm rozhodneme nebo ne, ukáže čas.
Příloha
Chcete-li zahrnout nový komponent do sestavení, musíte přidat jeho popis do bigtop.bom a ./bigtop-packages. Můžete to zkusit udělat podle stávajících komponent. Zkuste to pochopit. Není to tak složité, jak to na první pohled vypadá.
A co si o tom myslíte? Budeme rádi za vaše názory v komentářích a děkujeme za pozornost!
Článek připravila data management tým "Rostelecomu"
Zdroj: habr.com
