

Všem dobro!
Jmenuji se Nikita, jsem vedoucí týmu inženýrů v Cian. Jednou z mých povinností ve společnosti je snížit počet incidentů souvisejících s infrastrukturou v produkci na nulu.
Téma, o kterém se bude nyní hovořit, nám přineslo mnoho bolesti, a cílem tohoto článku je zabránit ostatním lidem opakovat naše chyby nebo alespoň minimalizovat jejich dopad.
Úvod
Když bylo Cian založeno jako monolit a žádné náznaky mikroslužeb ještě neexistovaly, měřili jsme dostupnost prostřednictvím kontroly 3–5 stránek.
Pokud odpovídají — je vše v pořádku, pokud neodpovídají po delší dobu — spouští se upozornění. Jak dlouho musí nefungovat, aby to bylo považováno za incident, rozhodovali lidé na schůzkách. Tým inženýrů vždy účinkoval v vyšetřování incidentu. Po dokončení vyšetřování jsme psali postmortem — jakýsi report na e-mail ve formátu: co se stalo, jak dlouho to trvalo, co jsme udělali v tu chvíli a co uděláme v budoucnu.
Hlavní stránky webu nebo jak chápeme, že jsme dosáhli dna
Abychom mohli nějakým způsobem chápat prioritu chyby, vymezili jsme nejkritičtější stránky webu pro obchodní funkce. Podle nich počítáme počet úspěšných/neudělaných požadavků a časových limitů. Takto měříme uptime.
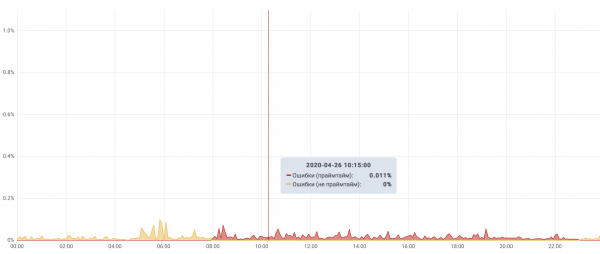
Představme si, že jsme zjistili, že existuje řada superdůležitých sekcí webu, které zajišťují hlavní službu — vyhledávání a podávání inzerátů. Pokud počet požadavků, které skončily chybou, překročí 1 %, je to kritický incident. Pokud během 15 minut v hlavním čase procento chyb překročí 0,1 %, považuje se to také za kritický incident. Tato kritéria pokrývají většinu incidentů, ostatní přesahují rámec tohoto článku.
Top nejlepších incidentů Cian
Takže jsme se určitě naučili určit, že incident se stal.
Nyní je každý incident detailně popsán a zaznamenán v epiku Jira. Mimochodem: pro to jsme založili samostatný projekt, nazvali jsme ho FAIL — v něm lze vytvářet pouze epiky.
Pokud shromáždíme všechny chyby za posledních několik let, vedou:
- incidenty spojené s mssql;
- incidenty způsobené vnějšími faktory;
- chyby administrátorů.
Podrobněji se zastavíme u chyb administrátorů a také u dalších zajímavých selhání.
Páté místo — „Uklízíme v DNS“
Byla to deštivá úterý. Rozhodli jsme se uklidit v DNS clusteru.
Chcelo se nám přejít interní dns servery z bind na powerdns, přičemž jsme vyhradili zcela samostatné servery, kde kromě dns nic není.
Rozmístili jsme po jednom dns serveru v každé lokalitě našich datových center a nastal čas přesunout zony z bind do powerdns a přepnout infrastrukturu na nové servery.
V největším rozmachu přesunu zůstala ze všech servery, které byly uvedeny v lokálních cache bind na všech serverech, pouze jedna, která byla v datovém centru v Petrohradě. Toto datové centrum bylo původně deklarováno jako pro nás nekritické, ale náhle se stalo single point of failure.
Právě v takovém období přesunu spadl kanál mezi Moskvou a Petrohradem. Fakticky jsme zůstali bez DNS na pět minut a znovu jsme se dostali online, když hoster prováděl opravy.
Závěry:
Pokud jsme dříve zanedbávali vnější faktory během přípravy na práce, nyní jsou také zahrnuty do seznamu toho, na co se připravujeme. A nyní se snažíme, aby byly všechny komponenty rezervovány n-2, a na dobu prací můžeme snižovat tuto úroveň na n-1.
- Při sestavování plánu činností zaznamenávejte body, kde může služba selhat, a promýšlejte scénář, kde vše šlo "hůře není" předem.
- Rozdělujte interní dns servery do různých geografických lokalit/datových center/racků/přepínačů/vstupů.
- Na každém serveru nainstalujte lokální cache dns server, který přesměrovává dotazy na hlavní dns servery, a v případě jeho nedostupnosti odpovídá z cache.
Čtvrté místo — „Uklidíme v Nginxu“
Jednoho krásného dne se náš tým rozhodl, že „dost bylo trpění“, a spustil se proces refaktorování konfigurací nginx. Hlavním cílem je přivést konfigurace k intuitivně srozumitelné struktuře. Dříve bylo vše „historicky dané“ a neneslo v sobě žádnou logiku. Nyní jsme každý server_name vyjmuli do jednoho pojmenovaného souboru a rozložili všechny konfigurace do složek. Mimochodem — konfigurace obsahuje 253949 řádků nebo 7836520 znaků a zabírá téměř 7 megabajtů. Horní úroveň struktury:
Struktura Nginxu
├── access
│   ├── allow.list
...
│   └── whitelist.conf
├── geobase
│   ├── exclude.conf
...
│   └── geo_ip_to_region_id.conf
├── geodb
│   ├── GeoIP.dat
│   ├── GeoIP2-Country.mmdb
│   └── GeoLiteCity.dat
├── inc
│   ├── error.inc
...
│   └── proxy.inc
├── lists.d
│   ├── bot.conf
...
│   ├── dynamic
│   └── geo.conf
├── lua
│   ├── cookie.lua
│   ├── log
│   │   └── log.lua
│   ├── logics
│   │   ├── include.lua
│   │   ├── ...
│   │   └── utils.lua
│   └── prom
│       ├── stats.lua
│       └── stats_prometheus.lua
├── map.d
│   ├── access.conf
│   ├── ..
│   └── zones.conf
├── nginx.conf
├── robots.txt
├── server.d
│   ├── cian.ru
│   │   ├── cian.ru.conf
│   │   ├── ...
│   │   └── my.cian.ru.conf
├── service.d
│   ├── ...
│   └── status.conf
└── upstream.d
    ├── cian-mcs.conf
    ├── ...
    └── wafserver.conf
Bylo to značně lepší, ale během přejmenovávání a rozdělování konfigurací měly některé z nich nesprávnou příponu a nedostaly se do direktivy include *.conf. V důsledku toho se některé hosty staly nedostupnými a vracely 301 na hlavní stránku. Protože kód odpovědi nebyl 5xx/4xx, nebylo to hned vidět, ale až brzy ráno. Po tomto jsme začali psát testy na kontrolu infrastrukturních komponentů.
Závěry:
- Správně strukturovat konfigurace (nejen nginx) a promýšlet strukturu už v rané fázi projektu. Tak je učiníte srozumitelnějšími pro tým, což zase sníží TTM.
- Pro některé infrastrukturní komponenty pište testy. Například: kontrola, že všechny klíčové server_name vracejí správný status a + tělo odpovědi. Stačí mít po ruce jen několik skriptů, které ověřují základní funkce komponentu, abychom si v 3 ráno nevybavovali, co ještě je třeba zkontrolovat.
Třetí místo — „Najednou došel prostor v Cassandra“
Data postupně rostla a vše bylo v pořádku, dokud v clusteru Cassandra nezačaly selhávat opravy velkých keyspace, protože na ně nemůže proběhnout compaction.
Jednoho deštivého dne se cluster téměř proměnil v dýni a sice:
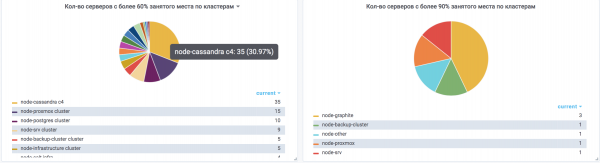
- v clusteru zbývalo přibližně 20 % celkového prostoru;
- nelze plně přidat nody, protože po přidání nody neproběhne cleanup pro nedostatek místa na oddílech;
- výkon postupně klesá, protože nefunguje compaction;
- cluster pracuje v havarijním režimu.
Výstup – přidali jsme dalších 5 uzlů bez údržby, po čemž jsme začali systematicky vyřazovat z clusteru a znovu přidávat jako prázdné uzly, na kterých došlo místo. Času jsme strávili mnohem více, než bychom si přáli. Existovalo riziko částečné nebo úplné nedostupnosti clusteru.
Závěry:
- Na všech serverech Cassandra by nemělo být obsazeno více než 60 % místa na každém oddílu.
- Měly by být zatíženy maximálně na 50 % podle CPU.
- Neměli bychom zanedbávat plánování kapacity a je třeba ho promyslet pro každou komponentu, vycházející z její specifiky.
- Čím více uzlů v clusteru, tím lépe. Servery obsahující menší objem dat se rychleji přenáší a takový cluster se snadněji obnovuje.
Druhé místo – „Data zmizela z úložiště konzolu key-value“
Pro objevování služeb používáme consul stejně jako mnozí ostatní. Ale naše key-value se využívá také pro blue-green nasazení monolitu. Tam se uchovává informace o aktivních a neaktivních upstream, které se během nasazení mění. Byl napsán nasazovací servis, který komunikoval s KV. V určitém okamžiku data z KV zmizela. Obnovili jsme je podle paměti, ale s řadou chyb. V důsledku toho se při nasazení zátěž na upstreamy rozdělila nerovnoměrně a obdrželi jsme mnoho chyb 502 z důvodu přetížení backendů podle CPU. Nakonec jsme přešli z consul KV na postgres, odkud je již nelze tak snadno odstranit.
Závěry:
- Služby bez jakékoli autorizace by neměly obsahovat kritická data pro fungování webu. Například, pokud nemáte autorizaci v ES – bylo by lepší zakázat přístup na úrovni sítě ze všech míst, kde není potřeba, ponechat pouze nezbytné, a také nastavit action.destructive_requires_name: true.
- Vypracujte mechanismus zálohování a obnovy předem. Například si předem vytvořte skript (například na python), který umí zálohovat i obnovovat.
První místo – „Kapitán očividnost“
V určitém okamžiku jsme si všimli nerovnoměrného rozložení zátěže na upstreamy nginx v případech, kdy bylo v backendu více než 10 serverů. Protože round-robin směroval požadavky od prvního k poslednímu upstreamu v pořadí a každý reload nginx začínal znovu, na první upstreamy vždy připadalo více požadavků než na ostatní. V důsledku toho pracovaly pomaleji a celý web tím trpěl. To bylo čím dál tím více patrné s rostoucím množstvím provozu. Prostě aktualizovat nginx pro zahrnutí random nestačilo – bylo potřeba přepracovat spoustu lua kódu, který na verzi 1.15 nefungoval. Museli jsme patchovat náš nginx 1.14.2, abychom do něj implementovali podporu random. To vyřešilo problém. Tato chyba je vítězem v kategorii „kapitán neviditelnost“.
Závěry:
Bylo to velmi zajímavé a vzrušující zkoumat tuto chybu).
- Nastavte monitorování tak, aby pomáhalo rychle najít podobné fluktuace. Například můžete použít ELK k sledování rps pro každý backend každého upstreamu a sledovat jejich dobu odezvy z pohledu nginx. V tomto případě nám to pomohlo odhalit problém.
Většinu selhání by bylo možné předejít při pečlivějším přístupu k tomu, co děláte. Musíte si vždy pamatovat Murphyho zákon: Vše, co může jít špatně, půjde špatně, a stavět komponenty podle něj.
Zdroj: habr.com
