

Ahoj všichni. Vyvíjíme produkt pro analýzu offline provozu. V projektu máme úkol spojený se statistickou analýzou cest návštěvníků po oblastech.
V rámci tohoto úkolu mohou uživatelé klást systému dotazy následujícího typu:
- kolik návštěvníků prošlo z oblasti "A" do oblasti "B";
- kolik návštěvníků prošlo z oblasti "A" do oblasti "B" přes oblast "C" a poté přes oblast "D";
- kolik času zabralo přežití návštěvníka určitého typu z oblasti "A" do oblasti "B".
a také řadu podobných analytických dotazů.
Pohyb návštěvníka po oblastech představuje orientovaný graf. Po pročtení internetu jsem zjistil, že grafové DB se používají i pro analytické zprávy. Měl jsem chuť se podívat, jak si s takovými dotazy poradí grafové DB (TL;DR; špatně).
Vybral jsem k použití DB , jako vynikajícího zástupce grafových open-source DB, která se opírá o stack vyspělých technologií, které (podle mého názoru) by měly zajistit slušné provozní vlastnosti:
- backend úložiště BerkeleyDB, Apache Cassandra, Scylla;
- složené indexy lze uložit do Lucene, Elasticsearch, Solr.
Autoři JanusGraph uvádějí, že je vhodná jak pro OLTP, tak pro OLAP.
Pracoval jsem s BerkeleyDB, Apache Cassandra, Scylla a ES, navíc tyto produkty se často používají v našich systémech, takže jsem s optimismem čekal na testování této grafové DB. Podivoval jsem se výběru BerkeleyDB namísto RocksDB, ale pravděpodobně to souvisí s požadavky na transakce. V každém případě se pro škálovatelné produktové použití doporučuje používat backend na Cassandře nebo Scyle.
Neo4j jsem nezvažoval, protože pro clustering je vyžadována komerční verze, což znamená, že produkt není otevřený.
Grafové DB říkají: "Pokud něco vypadá jako graf — zpracovávejte to jako graf!" — krása!
Nejprve jsem nakreslil graf, který je přesně podle kanonů grafových DB:
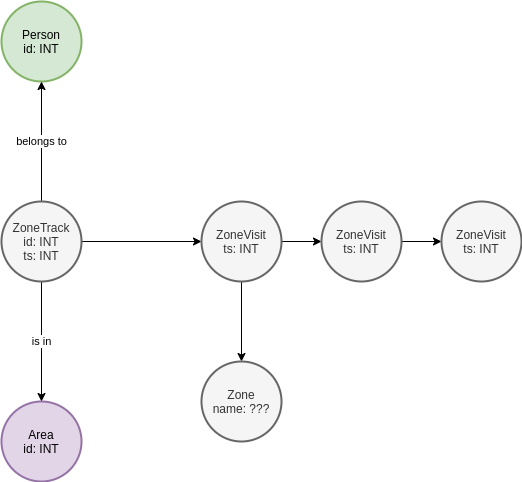
Existuje entita Zone, odpovídající oblasti. Pokud ZoneStep náleží k této Zone, odkazuje na ni. Na entitě Area, ZoneTrack, Person Pozor, nevšímejte si jich, patří k doméně a v rámci testu nejsou brány v úvahu. Celkově by takový dotaz pro grafovou strukturu vypadal takto:
g.V().hasLabel('Zone').has('id',0).in_()
       .repeat(__.out()).until(__.out().hasLabel('Zone').has('id',19)).count().next()
Což v češtině znamená: najdi Zone s ID=0, vezmi všechny vrcholy, ze kterých na ni vede hrana (ZoneStep), pokračuj bez návratu zpět, dokud nenajdeš takové ZoneStep, ze kterých vede hrana na Zone s ID=19, spočítej počet takových řetězců.
Netvrdím, že znám všechny nuance vyhledávání v grafech, ale tento dotaz byl vygenerován na základě této knihy ().
Nahrál jsem 50 tisíc stop o délce od 3 do 20 bodů do grafové databáze JanusGraph, která využívá backend BerkeleyDB, vytvořil indexy podle .
Skripty pro nahrávání v Pythonu:
from random import random
from time import time

from init import g, graph

if __name__ == '__main__':

    points = []
    max_zones = 19
    zcache = dict()
    for i in range(0, max_zones + 1):
        zcache[i] = g.addV('Zone').property('id', i).next()

    startZ = zcache[0]
    endZ = zcache[max_zones]

    for i in range(0, 10000):

        if not i % 100:
            print(i)

        start = g.addV('ZoneStep').property('time', int(time())).next()
        g.V(start).addE('belongs').to(startZ).iterate()

        while True:
            pt = g.addV('ZoneStep').property('time', int(time())).next()
            end_chain = random()
            if end_chain < 0.3:
                g.V(pt).addE('belongs').to(endZ).iterate()
                g.V(start).addE('goes').to(pt).iterate()
                break
            else:
                zone_id = int(random() * max_zones)
                g.V(pt).addE('belongs').to(zcache[zone_id]).iterate()
                g.V(start).addE('goes').to(pt).iterate()

            start = pt

    count = g.V().count().next()
    print(count)
Použila se VM se 4 jádry a 16 GB RAM na SSD. JanusGraph byl nasazen pomocí tohoto příkazu:
docker run --name janusgraph -p8182:8182 janusgraph/janusgraph:latestV tomto případě se data a indexy, které se používají k vyhledávání podle přesné shody, ukládají do BerkeleyDB. Po provedení výše uvedeného dotazu jsem získal čas v řádu několika desítek sekund.
Když jsem spustil 4 výše uvedené skripty paralelně, podařilo se mi proměnit DBMS v dýni s veselým proudem stekových tras Java (a všichni máme rádi čtení stekových tras Java) v logách Docker.
Po zamyšlení jsem se rozhodl zjednodušit strukturu grafu na následující:
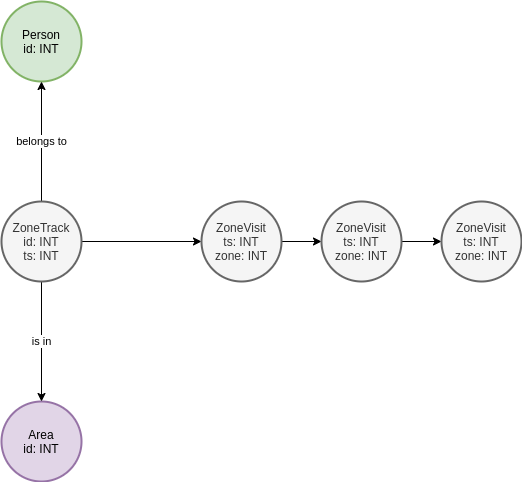
Rozhodl jsem se, že vyhledávání podle atributů entity bude rychlejší než vyhledávání podle hran. Nakonec se můj dotaz přetvořil na následující:
g.V().hasLabel('ZoneStep').has('id',0).repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',19)).count().next()Což v češtině znamená: najdi ZoneStep s ID=0, pokračuj bez návratu zpět, dokud nenajdeš ZoneStep s ID=19, spočítej počet takových řetězců.
Skript pro nahrávání, který jsem uvedl výše, jsem také zjednodušil, abych se vyhnul zbytečným vazbám, a omezil se pouze na atributy.
Dotaz stále trval několik sekund, což bylo naprosto nepřijatelné pro náš úkol, protože pro ad hoc dotazy libovolného typu to rozhodně nebylo vhodné.
Zkusil jsem nasadit JanusGraph s použitím Scylla jako nejrychlejší implementace Cassandry, ale to také nepřineslo žádné podstatné zlepšení výkonu.
Takže, přestože to "vypadá jako graf", nepodařilo se mi donutit grafovou DBMS, aby to zpracovala rychle. Docela předpokládám, že něco nevím a lze donutit JanusGraph provádět toto hledání během zlomků sekund, nicméně já toho nebyl schopen.
Protože bylo třeba i tak úkol vyřešit, začal jsem přemýšlet o JOINech a pivot tabulkách, což nevzbuzovalo optimismus z hlediska elegance, ale mohl by to být zcela funkční způsob v praxi.
V našem projektu už používáme Apache ClickHouse, takže jsem se rozhodl ověřit své výzkumy na této analytické DBMS.
Nasadil jsem ClickHouse podle jednoduchého receptu:
sudo docker run -d --name clickhouse_1
     --ulimit nofile=262144:262144
     -v /opt/clickhouse/log:/var/log/clickhouse-server
     -v /opt/clickhouse/data:/var/lib/clickhouse
     yandex/clickhouse-server
Vytvořil jsem v něm databázi a tabulku následujícího typu:
CREATE TABLE
db.steps (`area` Int64, `when` DateTime64(1, 'Europe/Moscow') DEFAULT now64(), `zone` Int64, `person` Int64)
ENGINE = MergeTree() ORDER BY (area, zone, person) SETTINGS index_granularity = 8192
Naplnil jsem ji daty následujícím skriptem:
from time import time

from clickhouse_driver import Client
from random import random

client = Client('vm-12c2c34c-df68-4a98-b1e5-a4d1cef1acff.domain',
                database='db',
                password='secret')

max = 20

for r in range(0, 100000):

    if r % 1000 == 0:
        print("CNT: {}, TS: {}".format(r, time()))

    data = [{
            'area': 0,
            'zone': 0,
            'person': r
        }]

    while True:
        if random() < 0.3:
            break

        data.append({
                'area': 0,
                'zone': int(random() * (max - 2)) + 1,
                'person': r
            })

    data.append({
            'area': 0,
            'zone': max - 1,
            'person': r
        })

    client.execute(
        'INSERT INTO steps (area, zone, person) VALUES',
        data
    )
Protože jsou vkládání prováděna v dávkách, bylo vyplnění mnohem rychlejší než pro JanusGraph.
Sestavil jsem dva dotazy pomocí JOIN. Pro přechod z bodu A do bodu B:
SELECT s1.person AS person,
       s1.zone,
       s1.when,
       s2.zone,
       s2.when
FROM
  (SELECT *
   FROM steps
   WHERE (area = 0)
     AND (zone = 0)) AS s1 ANY INNER JOIN
  (SELECT *
   FROM steps AS s2
   WHERE (area = 0)
     AND (zone = 19)) AS s2 USING person
WHERE s1.when <= s2.when
Pro přechod přes 3 body:
VYBERTE s3.osobu,
       s1z,
       s1w,
       s2z,
       s2w,
       s3.zóna,
       s3.kdy
Z FROM
  (VYBERTE s1.osobu JAKO osoba,
          s1.zóna JAKO s1z,
          s1.kdy JAKO s1w,
          s2.zóna JAKO s2z,
          s2.kdy JAKO s2w
   Z
     (VYBERTE *
      Z kroky
      KDE (oblast = 0)
        A (zóna = 0)) JAKO s1 JAKO INNER JOIN
     (VYBERTE *
      Z kroky JAKO s2
      KDE (oblast = 0)
        A (zóna = 3)) JAKO s2 POUŽÍVÁ osobu
   KDE s1.kdy <= s2.kdy) p JAKO INNER JOIN
  (VYBERTE *
   Z kroky
   KDE (oblast = 0)
     A (zóna = 19)) JAKO s3 POUŽÍVÁ osobu
KDE p.s2w <= s3.kdy
Dotazy samozřejmě vypadají dost strašidelně, pro reálné použití je potřeba udělat programový wrapper-generátor. Nicméně, fungují a fungují rychle. Oba dotazy se provádějí za méně než 0,1 sekundy. Zde je příklad doby provádění dotazu pro count(*) přes 3 body:
VYBERTE count(*)
Z
(
    VYBERTE
        s1.osobu JAKO osoba,
        s1.zóna JAKO s1z,
        s1.kdy JAKO s1w,
        s2.zóna JAKO s2z,
        s2.kdy JAKO s2w
    Z
    (
        VYBERTE *
        Z kroky
        KDE (oblast = 0) A (zóna = 0)
    ) JAKO s1
    JAKO INNER JOIN
    (
        VYBERTE *
        Z kroky JAKO s2
        KDE (oblast = 0) A (zóna = 3)
    ) JAKO s2 POUŽÍVÁ (osobu)
    KDE s1.kdy <= s2.kdy
) JAKO p
JAKO INNER JOIN
(
    VYBERTE *
    Z kroky
    KDE (oblast = 0) A (zóna = 19)
) JAKO s3 POUŽÍVÁ (osobu)
KDE p.s2w <= s3.kdy

┌─count()─┐
│   11592 │
└─────────┘
1 řádek v sadě. Doba: 0.068 sek. Zpracováno 250,03 tisíc řádků, 8,00 MB (3,69 milionu řádků/s., 117,98 MB/s.)Poznámka o IOPS. Při plnění dat, JanusGraph generoval poměrně vysoké množství IOPS (1000-1300 pro čtyři vlákna plnění dat), a IOWAIT byl poměrně vysoký. Zatímco ClickHouse generoval minimální zatížení diskového subsystému.
Závěr
Rozhodli jsme se použít ClickHouse pro obsluhu dotazů tohoto typu. Vždy můžeme dále optimalizovat dotazy pomocí materializovaných pohledů a paralelizace, prováděním předběžného zpracování toku událostí pomocí Apache Flink před jejich načtením do ClickHouse.
Výkon je tak dobrý, že pravděpodobně ani nebudeme muset přemýšlet o pivech tabulek programovými prostředky. Dříve jsme museli dělat pivoty dat získaných z Vertica prostřednictvím exportu do Apache Parquet.
Bohužel, další pokus o použití grafové databáze nebyl úspěšný. Nenašel jsem, že by JanusGraph měl přátelské prostředí, které by umožnilo rychlé osvojení produktu. Pro konfiguraci serveru se používá tradiční Java-cesta, která způsobí, že lidé, kteří nejsou obeznámeni s Javou, budou plakat krvavými slzami:
host: 0.0.0.0
port: 8182
threadPoolWorker: 1
gremlinPool: 8
scriptEvaluationTimeout: 30000
channelizer: org.janusgraph.channelizers.JanusGraphWsAndHttpChannelizer

graphManager: org.janusgraph.graphdb.management.JanusGraphManager
graphs: {
  ConfigurationManagementGraph: conf/janusgraph-cql-configurationgraph.properties,
  airlines: conf/airlines.properties
}

scriptEngines: {
  gremlin-groovy: {
    plugins: { org.janusgraph.graphdb.tinkerpop.plugin.JanusGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.server.jsr223.GremlinServerGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.tinkergraph.jsr223.TinkerGraphGremlinPlugin: {},
               org.apache.tinkerpop.gremlin.jsr223.ImportGremlinPlugin: {classImports: [java.lang.Math], methodImports: [java.lang.Math#*]},
               org.apache.tinkerpop.gremlin.jsr223.ScriptFileGremlinPlugin: {files: [scripts/airline-sample.groovy]}}}}

serializers:
# GraphBinary je zde k nahrazení Gryo a Graphson
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphBinaryMessageSerializerV1, config: { serializeResultToString: true }}
  # Gryo a Graphson, nejnovější verze
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV3d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV3d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  # Starší verze serializace pro zpětnou kompatibilitu:
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoMessageSerializerV1d0, config: { serializeResultToString: true }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GryoLiteMessageSerializerV1d0, config: {ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV2d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistry] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerGremlinV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}
  - { className: org.apache.tinkerpop.gremlin.driver.ser.GraphSONMessageSerializerV1d0, config: { ioRegistries: [org.janusgraph.graphdb.tinkerpop.JanusGraphIoRegistryV1d0] }}

processors:
  - { className: org.apache.tinkerpop.gremlin.server.op.session.SessionOpProcessor, config: { sessionTimeout: 28800000 }}
  - { className: org.apache.tinkerpop.gremlin.server.op.traversal.TraversalOpProcessor, config: { cacheExpirationTime: 600000, cacheMaxSize: 1000 }}

metrics: {
  consoleReporter: {enabled: false, interval: 180000},
  csvReporter: {enabled: false, interval: 180000, fileName: /tmp/gremlin-server-metrics.csv},
  jmxReporter: {enabled: false},
  slf4jReporter: {enabled: true, interval: 180000},
  gangliaReporter: {enabled: false, interval: 180000, addressingMode: MULTICAST},
  graphiteReporter: {enabled: false, interval: 180000}}
threadPoolBoss: 1
maxInitialLineLength: 4096
maxHeaderSize: 8192
maxChunkSize: 8192
maxContentLength: 65536
maxAccumulationBufferComponents: 1024
resultIterationBatchSize: 64
writeBufferHighWaterMark: 32768
writeBufferHighWaterMark: 65536
ssl: {
  enabled: false}
Náhodou jsem "položil" BerkeleyDB verzi JanusGraph.
Dokumentace je v oblasti indexů poměrně křivá, protože při správě indexů je třeba provádět poněkud podivné rituály v Groovy. Například vytvoření indexu musí být provedeno pomocí psaní kódu v konzoli Gremlin (která, mimochodem, nefunguje hned po vybalení). Z oficiální dokumentace JanusGraph:
graph.tx().rollback()
// Nikdy nevytvářejte nové indexy, když je aktivní transakce
mgmt = graph.openManagement()
name = mgmt.getPropertyKey('name')
age = mgmt.getPropertyKey('age')
mgmt.buildIndex('byNameComposite', Vertex.class).addKey(name).buildCompositeIndex()
mgmt.buildIndex('byNameAndAgeComposite', Vertex.class).addKey(name).addKey(age).buildCompositeIndex()
mgmt.commit()

// Počkejte, až bude index k dispozici
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameComposite').call()
ManagementSystem.awaitGraphIndexStatus(graph, 'byNameAndAgeComposite').call()
// Znovu indexujte existující data
mgmt = graph.openManagement()
mgmt.updateIndex(mgmt.getGraphIndex("byNameComposite"), SchemaAction.REINDEX).get()
mgmt.updateIndex(mgmt.getGraphIndex("byNameAndAgeComposite"), SchemaAction.REINDEX).get()
mgmt.commit()
Poznámka na závěr
V jistém smyslu je výše uvedený experiment srovnáním horkého se změkčeným. Pokud se zamyslíte, grafová DB vykonává jiné operace k dosažení stejných výsledků. Nicméně, v rámci testů jsem provedl také experiment s dotazem typu:
g.V().hasLabel('ZoneStep').has('id',0)
    .repeat(__.out().simplePath()).until(__.hasLabel('ZoneStep').has('id',1)).count().next()
, který odráží krokovou dostupnost. Nicméně i na takových datech grafová DB ukázala výsledek, který překročil několik sekund... To, samozřejmě, souvisí s tím, že existovaly cesty typu 0 -> X -> Y ... -> 1, které grafový engine také kontroloval.
Dokonce i pro dotaz typu:
g.V().hasLabel('ZoneStep').has('id',0).out().has('id',1)).count().next()se mi nepodařilo získat výkonnou odpověď s dobou zpracování pod jednu sekundu.
Morálka této bajky je taková, že krásná idea a paradigmatické modelování nevedou k požadovanému výsledku, který se s výrazně vyšší efektivitou demonstruje na příkladu ClickHouse. Uvedený příklad použití v tomto článku je zcela jasný antipatern pro grafové DB, i když se tváří jako vhodný pro modelování v jejich paradigmatice.
Zdroj: habr.com
