

Hned vysvětlím název článku. Původně bylo plánováno poskytnout dobrý, spolehlivý tip na zrychlení používání reflexe na jednoduchém, ale realistickém příkladu, ale během benchmarkingu se ukázalo, že reflexe nepracuje tak pomalu, jak jsem si myslel, a LINQ funguje pomaleji, než jsem snil ve svých nočních můrách. Nakonec se ukázalo, že jsem také udělal chybu v měřeních… Podrobnosti tohoto životního příběhu pod katem a v komentářích. Protože příklad je dost běžný a realizovaný v podstatě tak, jak se obvykle dělá v enterprise, vznikla dost zajímavá, jak si myslím, demonstrace života: vliv na rychlost práce hlavního předmětu článku nebyl znatelný kvůli vnější logice: Moq, Autofac, EF Core a další „obaly“.
Začal jsem práci pod dojmem z tohoto článku:
Jak je vidět, autor navrhuje používat zkompilované delegáty místo přímého volání metod typů reflexe jako skvělý způsob, jak výrazně zrychlit práci aplikace. Samozřejmě je tam ještě IL emise, ale té bych se chtěl vyhnout, protože je to nejnáročnější způsob provádění úkolu, který nese riziko chyb.
Vzhledem k tomu, že jsem vždy zastával podobný názor na rychlost reflexe, nijak jsem nepochyboval o závěrech autora.
Často se setkávám s naivním používáním reflexe v enterprise. Vezme se typ. Vezme se informace o vlastnosti. Zavolá se metoda SetValue a všichni se radují. Hodnota přišla do cílového pole, všichni jsou spokojeni. Lidé jsou velmi inteligentní — senioři a teamleadeři — píší své rozšíření na object na základě takové naivní implementace „univerzální“ mapy jednoho typu na jiný. Podstata obvykle je: vezmeme všechna pole, vezmeme všechny vlastnosti, iterujeme přes ně: při shodě názvů členů typu vykonáme SetValue. Občas zachytíme výjimky na chybách tam, kde jsme nenašli nějakou vlastnost u jednoho z typů, ale i zde je řešení, které zvyšuje výkon. Try/catch.
Viděl jsem, jak lidé znovu vynalézají parsery a mapery, aniž by měli úplné informace o tom, jak fungují kola vynalezená před nimi. Viděl jsem, jak lidé skrývají své naivní implementace za strategiemi, za rozhraními, za injekcemi, jako by to omlouvalo následnou chaos. Od takových implementací jsem se odvrátil. Ve skutečnosti jsem skutečný únik výkonu měřit neměřil a v případě potřeby jsem jednoduše měnil implementaci na „optimálnější“, pokud na to přišlo. Proto mě první měření, o kterých je řeč níže, vážně zaskočila.
Myslím, že mnozí z vás, když četli Ríchtera nebo jiné ideologické vůdce, narazili na zcela oprávněné tvrzení, že reflexe v kódu je jev, který má extrémně negativní vliv na výkon aplikace.
Vyvolání reflexe nutí CLR procházet sestavení a hledat požadované, stahovat jejich metadata, parsovat je atd. Kromě toho reflexe při procházení sekvencí vede k alokaci velkého objemu paměti. Vydáváme paměť, CLR odhaluje GC a začínají zpoždění. To by mělo být znatelně pomalé, věřte. Obrovské objemy paměti moderních produkčních serverů nebo cloudových strojů nechrání před vysokými latencemi ve zpracování. Ve skutečnosti, čím více paměti, tím vyšší pravděpodobnost, že ZAZNAMENÁTE, jak funguje GC. Reflexe je v zásadě zbytečná červená hadra pro něj.
Nicméně všichni používáme jak IoC kontejnery, tak datové mapery, jejichž principy práce jsou také založeny na reflexi, avšak otázky k jejich výkonu obvykle nevznikají. Ne, není to proto, že by závislosti a abstrahování od modelů vnějšího omezeného kontextu byly tak nezbytné, že s výkonem musíme obětovat v každém případě. Je to jednodušší – to ve skutečnosti nemá velký vliv na výkon.
Jde o to, že nejrozšířenější frameworky, které jsou založeny na technologii reflexe, používají různé triky pro optimálnější práci s ní. Obvykle jde o cache. Obvykle – to jsou Expressions a zkompilované z výrazu delegáty. Ten samý automapper má pod sebou konkurenční slovník, který mapuje typy na funkce, které mohou jeden do druhého převést již bez volání reflexe.
Jak se to dosahuje? V podstatě se to neliší od logiky, kterou používá samotná platforma pro generování kódu JIT. Při prvním volání metody je ta zkompilována (a ano, tento proces není rychlý), při dalších voláních se již předává řízení zkompilované metodě, a zde nedojde k výraznému poklesu výkonu.
V našem případě také můžeme využít JIT kompilaci a poté použít zkompilované chování s podobným výkonem jako jeho AOT protějšky. Na pomoc nám v tomto případě přijdou výrazy.
Krátce lze shrnout princip, o kterém je řeč, následujícím způsobem:
Je třeba cachovat konečný výsledek práce reflexe ve formě delegáta, který obsahuje zkompilovanou funkci. Všechny potřebné objekty se znalostmi o typech má také smysl cachovat v udržovaných polích vašich typů – pracovníků.
Logika v tom je. Zdravý rozum nám říká, že pokud je něco možné zkompilovat a cachovat, pak to má smysl udělat.
Předbíhajícím by bylo dobré říci, že cache při práci s reflexí má své výhody, i když se nepoužije navrhovaná metoda kompilace výrazů. V této věci vlastně jen zopakuji teze autora článku, na který se odkazují výše.
Teď kód. Pojďme se podívat na příklad, který vychází z mé nedávné bolesti, se kterou jsem se musel potýkat ve vážné produkci vážné úvěrové organizace. Všechny entity jsou fiktivní, aby si nikdo nic nevšiml.
Existuje určitá entita. Řekněme, že to bude Kontakt. Existují e-maily se standardizovaným tělem, ze kterých parser a hydrátor vytvářejí tyto kontakty. Přišel e-mail, přečetli jsme ho, rozdělili na páry klíč-hodnota, vytvořili kontakt, uložili do db.
Je to elementární. Předpokládejme, že kontakt má vlastnosti Jméno, Věk a kontaktní telefon. Tyto údaje jsou předávány v e-mailu. Také by podnik chtěl, aby podpůrné týmy mohly rychle přidávat nové klíče pro mapování vlastností entity na páry v těle e-mailu. V případě, že někdo udělal chybu v šabloně nebo pokud by bylo nutné rychle spustit mapování od nového partnera přizpůsobením se novému formátu. Pak novou korelaci mapování můžeme přidat jako levný datový fix. To znamená, že je to životní příklad.
Realizujeme, vytváříme testy. Funguje.
Kód nezveřejním: zdrojového kódu vzniklo hodně a je k dispozici na GitHubu na odkazu na konci článku. Můžete si je stáhnout, upravit k nepoznání a změřit, jak by to ovlivnilo váš případ. Uvedu pouze kód dvou šablonových metod, kterými se liší hydrátor, který měl být rychlý, od hydrátoru, který měl být pomalý.
Logika je následující: šablonová metoda přijímá páry vytvořené základní logikou parseru. Úroveň LINQ je parser a základní logika hydrátoru, která dělá dotaz na kontext databáze a přiřazuje klíče k párům od parseru (pro tyto funkce je kód bez LINQ pro srovnání). Pary jsou pak předány do hlavní metody hydratace a hodnoty párů jsou nastaveny na odpovídající vlastnosti entity.
„Rychlý“ (Předpona Fast v benchmarku):
 protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var setterMapItem in _propertySettersMap)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == setterMapItem.Key);
                setterMapItem.Value(contact, correlation?.Value);
            }
            return contact;
        }
Jak vidíme, používá se statická kolekce se settery vlastností – zkompilovanými lambdami, které volají setter entity. Jsou vytvořeny následujícím kódem:
        static FastContactHydrator()
        {
            var type = typeof(Contact);
            foreach (var property in type.GetProperties())
            {
                _propertySettersMap[property.Name] = GetSetterAction(property);
            }
        }

        private static Action GetSetterAction(PropertyInfo property)
        {
            var setterInfo = property.GetSetMethod();
            var paramValueOriginal = Expression.Parameter(property.PropertyType, "value");
            var paramEntity = Expression.Parameter(typeof(Contact), "entity");
            var setterExp = Expression.Call(paramEntity, setterInfo, paramValueOriginal).Reduce();

            var lambda = (Expression<Action>)Expression.Lambda(setterExp, paramEntity, paramValueOriginal);

            return lambda.Compile();
        }
Celkově je to jasné. Obcházíme vlastnosti, vytváříme podle nich delegáty, které volají settery, a ukládáme je. Pak je voláme, když je potřeba.
„Pomalý“ (Předpona Slow v benchmarku):
        protected override Contact GetContact(PropertyToValueCorrelation[] correlations)
        {
            var contact = new Contact();
            foreach (var property in _properties)
            {
                var correlation = correlations.FirstOrDefault(x => x.PropertyName == property.Name);
                if (correlation?.Value == null)
                    continue;

                property.SetValue(contact, correlation.Value);
            }
            return contact;
        }
Zde ihned obcházíme vlastnosti a přímo voláme SetValue.
Pro názornost a jako vzor jsem implementoval naivní metodu, která zapisuje hodnoty jejich korelačních párů přímo do polí entit. Prefix – Manual.
Teď vezmeme BenchmarkDotNet a prozkoumáme výkon. A najednou... (spoiler – tohle není správný výsledek, podrobnosti níže)
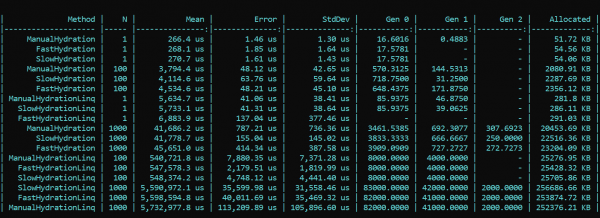
Co zde vidíme? Metody, které hrdě nesou prefix Fast, se téměř ve všech průchodech ukazují jako pomalejší než metody s prefixem Slow. To platí jak pro alokaci, tak pro rychlost běhu. Na druhou stranu, krásná a elegantní implementace mapování, která využívá všude, kde to jde, určené metody LINQ, naopak výrazně snižuje výkon. Rozdíl je obrovský. Trend se nemění s různým počtem průchodů. Rozdíl je pouze v měřítkách. S LINQ je to 4 – 200krát pomalejší, odpadu je více přibližně ve stejných měřítkách.
AKTUALIZOVÁNO
Nevěřil jsem svým očím, ale co je důležitější, ani našemu kolegovi - ani mému kódu nevěřil náš kolega - . Při ověřování mého řešení brilantně objevil a upozornil na chybu, kterou jsem kvůli řadě změn v implementaci od počáteční po konečnou opomněl. Po opravě nalezené chyby v nastavení Moq se všechny výsledky vrátily na své místo. Podle výsledků retestu hlavní trend zůstává nezměněn – LINQ má na výkon stále větší vliv než reflexe. Nicméně je potěšující, že práce s kompilací výrazu není marná a výsledky jsou viditelné jak v alokaci, tak v době běhu. První spuštění, kdy se inicializují statická pole, je zákonitě pomalejší u „rychlé“ metody, ale později se situace mění.
Tady je výsledek retestu:
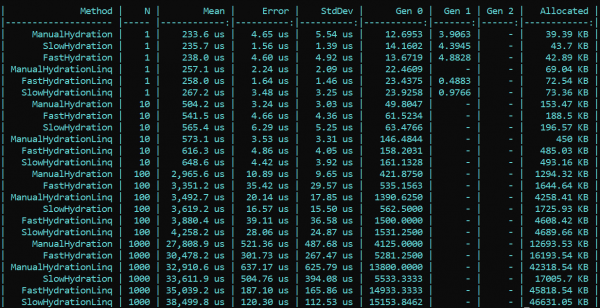
Závěr: Při použití reflexe v enterprise není třeba příliš ohýbat pravidla — LINQ sní výkon výrazněji. Nicméně, v silně zatížených metodách, které vyžadují optimalizaci, lze zachovat reflexi ve formě inicializátorů a kompilátorů delegátů, které pak zajistí „rychlou“ logiku. Tak můžete zachovat jak flexibilitu reflexe, tak rychlost běhu aplikace.
Kód s benchmarkem je k dispozici zde. Všichni zájemci si mohou ověřit má slova:
PS: Kód v testech používá IoC, zatímco v benchmarkích – explicitní konstrukci. Důvodem je, že jsem v konečné implementaci odstranil všechny faktory, které by mohly ovlivnit výkon a zašumět výsledek.
PPS: Děkuji uživateli za odhalení mé chyby v nastavení Moq, která ovlivnila první měření. Pokud má někdo z čtenářů dostatečnou karmu, prosím, dejte mu like. Člověk se zastavil, četl, zkontroloval a upozornil na chybu. Považuji to za chvályhodné a zaslouží si respekt.
PPPS: Děkuji tomu pečlivému čtenáři, který se zaměřil na stylistiku a formátování. Jsem pro jednotnost a pohodlí. Diplomatičnost prezentace by mohla být lepší, ale kritiku jsem vzal na vědomí. Prosím, pokračujte.
Zdroj: habr.com
