

Ve složitých ERP systémech mnohé entity mají hierarchickou povahu, když se homogenní objekty uspořádávají do stromu vztahů „předek – potomek“ — to zahrnuje organizační strukturu podniku (všechny tyto pobočky, oddělení a pracovní skupiny), katalog produktů, oblasti práce a geografii prodejních míst,…
Ve skutečnosti neexistuje žádná , kde by nebyla nějaká hierarchie. Ale i když nepracujete „na byznys“, můžete se snadno setkat s hierarchickými vazbami. Například vaše rodokmen nebo schéma poschodí v nákupním centru — to je stejná struktura.
Existuje mnoho způsobů, jak ukládat takový strom v DBMS, ale dnes se zastavíme pouze u jednoho variantu:
CREATE TABLE hier(
  id
    integer
      PRIMARY KEY
, pid
    integer
      REFERENCES hier
, data
    json
);

CREATE INDEX ON hier(pid); -- nezapomínejte, že FK nezahrnuje automatické vytvoření indexu, na rozdíl od PK
A zatímco se díváte do hloubky hierarchie, ona trpělivě čeká, jak neefektivní budou vaše „naivní“ způsoby práce s takovou strukturou.
Pojďme si rozebrat typické úkoly, které vznikají, jejich realizaci v SQL a pokusíme se zlepšit jejich výkon.
#1. Насколько глубока кроличья нора?
Pro určité určení přijměme, že tato struktura bude odrážet podřízenost oddělení v organizační struktuře: oddělení, divize, sektory, pobočky, pracovní skupiny,… — ať už je nazveme jakkoli.
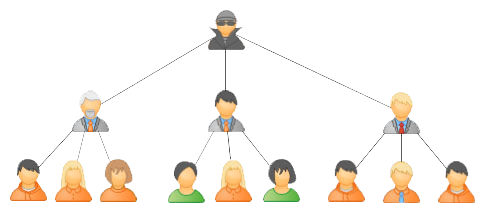
Nejprve vygenerujeme naše 'strom' z 10K prvků
INSERT INTO hier
WITH RECURSIVE T AS (
  SELECT
    1::integer id
  , '{1}'::integer[] pids
UNION ALL
  SELECT
    id + 1
  , pids[1:(random() * array_length(pids, 1))::integer] || (id + 1)
  FROM
    T
  WHERE
    id < 10000
)
SELECT
  pids[array_length(pids, 1)] id
, pids[array_length(pids, 1) - 1] pid
FROM
  T;
Začněme s nejjednodušším úkolem — najít všechny zaměstnance, kteří pracují v konkrétní sektoru, nebo v termínech hierarchie — najít všechny potomky uzlu. A také by nebylo špatné získat „hloubku“ potomka… Vše to může být potřeba, například pro vytvoření nějakého .
Vše by bylo v pořádku, pokud by těchto potomků bylo jen pár úrovní a množství v řádu desítek, ale pokud je úrovní více než 5 a potomků už desítky — mohou nastat problémy. Pojďme se podívat na to, jak se píšou (a fungují) tradiční varianty vyhledávání „dolů po stromě“. Nejprve si však ujasníme, které z uzlů budou pro naše výzkumy nejzajímavější.
Nejhlubší podstromy: WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id  | pid  | path
---------------------------------------------
7624 | 7623 | {7615,7620,7621,7622,7623,7624}
4995 | 4994 | {4983,4985,4988,4993,4994,4995}
4991 | 4990 | {4983,4985,4988,4989,4990,4991}
... ŠirokéNejhlubší ... SELECT path[1] id , count(*) FROM T GROUP BY 1 ORDER BY 2 DESC; WITH RECURSIVE T AS ( SELECT id , pid , ARRAY[id] path FROM hier WHERE pid IS NULL UNION ALL SELECT hier.id , hier.pid , T.path || hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T ORDER BY array_length(path, 1) DESC;
id   | count
------------
5300 |   30
 450 |   28
1239 |   27
1573 |   25
Pro tyto dotazy jsme použili typický
rekurzivní JOIN Zjevně, při takovém modelu dotazu:
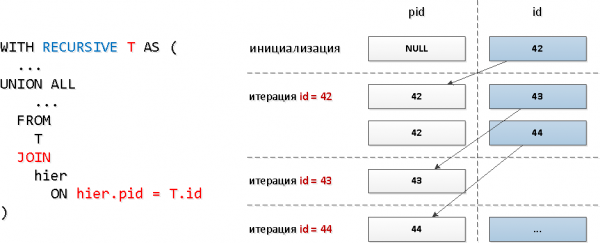
bude počet iterací odpovídat celkovému počtu potomků (a těch je přece několik desítek), a to může zabírat poměrně značné zdroje a tím i čas. Otestujeme na nejširším podstromě:
WITH RECURSIVE T AS ( SELECT id FROM hier WHERE id = 5300 UNION ALL SELECT hier.id FROM T JOIN hier ON hier.pid = T.id ) TABLE T;
[podívat se na explain.tensor.ru] 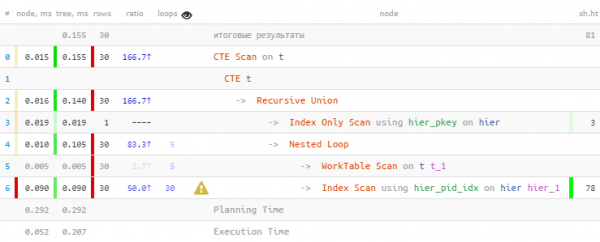
Hromadné čtení z indexu
A potřebujeme pro každý uzel provádět zvláštní dotaz na index? Odpověď zní ne — můžeme číst z indexu
najednou podle několika klíčů v jednom požadavku = ANY(array) prostřednictvím A do každé takové skupiny identifikátorů můžeme vzít všechny ID nalezené v předchozím kroku podle „uzlů“. To znamená, že v každém dalším kroku budeme.
hledat hned všechny potomky určité úrovně. Jenže, je tu problém,.
v rekurzivním výběru nemůžeme odkázat na sebe sama v vnořeném dotazu , a my přece potřebujeme nějakým způsobem vybrat právě jen to, co bylo nalezeno na předchozí úrovni… Ukazuje se, že provést vnořený dotaz na celý výběr — nelze, ale na jeho konkrétní pole — to jde. A to pole může být i pole — což přesně potřebujeme pro použitíANY Zní to poněkud šíleně, ale na schématu — je to jednoduché..
Zní to možná šíleně, ale na schématu je to všechno jednoduché.
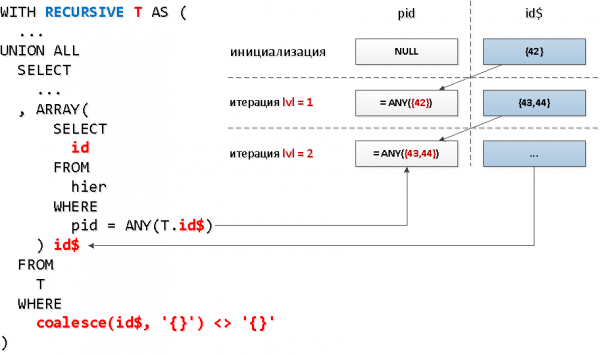
S REKURZIVNÍM T JAKO (
  VYBERTE
    ARRAY[id] id$
  Z
    hier
  KDE
    id = 5300
UNION ALL
  VYBERTE
    ARRAY(
      VYBERTE
        id
      Z
        hier
      KDE
        pid = ANY(T.id$)
    ) id$
  Z
    T
  KDE
    coalesce(id$, '{}')  '{}' -- podmínka pro ukončení cyklu - prázdné pole
)
VYBERTE
  unnest(id$) id
Z
T; 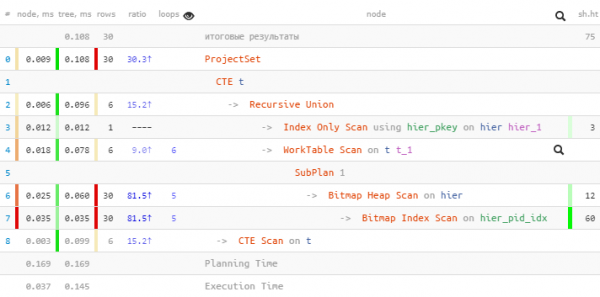
A tady není nejdůležitější ani zisk 1,5násobku času, ale že jsme načetli méně buffers, protože máme jen 5 přístupů k indexu místo 30!
Další výhodou je, že po konečném unnestu zůstanou identifikátory seřazeny podle "úrovní".
Znak uzlu
Další úvaha, která pomůže zlepšit výkon — u „listů“ nemohou být děti, tedy pro ně není vůbec potřeba hledat „dolů“. Naše úloha znamená, že pokud jsme šli po řetězci oddělení a dorazili k zaměstnanci, není už potřeba hledat dále po této větvi.
Zadejme do naší tabulky další boolean-pole, které nám hned řekne, zda je tato konkrétní položka v našem stromě „uzlem“ — tedy zda mohou mít vůbec potomky.
ALTER TABLE hier
  ADD COLUMN branch boolean;

UPDATE
  hier T
SET
  branch = TRUE
KDE
  EXISTS(
    VYBERTE
      NULL
    Z
      hier
    KDE
      pid = T.id
    LIMIT 1
);
-- Dotaz byl úspěšně proveden: 3033 řádků změněno za 42 ms.
Skvěle! Ukazuje se, že pouze něco přes 30% všech prvků stromu má potomky.
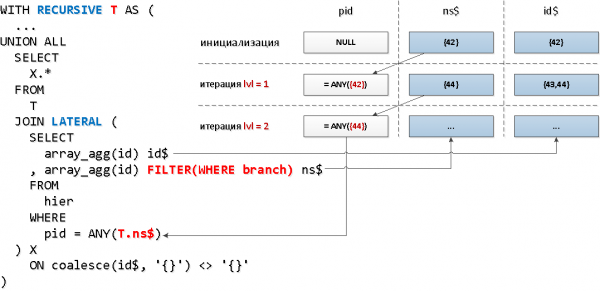
Nyní použijme trochu jinou mechaniku — spojení s rekurzivní částí pomocí LATERAL, což nám umožní okamžitě přistoupit k polím rekurzivní „tabulky“, a agregátní funkci s podmínkou filtrování podle znaku uzlu použijeme pro zmenšení množství klíčů:
S REKURZIVNÍM T JAKO (
  VYBERTE
    array_agg(id) id$
  , array_agg(id) FILTER(KDE branch) ns$
  Z
    hier
  KDE
    id = 5300
UNION ALL
  VYBERTE
    X.*
  Z
    T
  JOIN LATERAL (
    VYBERTE
      array_agg(id) id$
    , array_agg(id) FILTER(KDE branch) ns$
    Z
      hier
    KDE
      pid = ANY(T.ns$)
  ) X
    ON coalesce(T.ns$, '{}')  '{}'
)
VYBERTE
  unnest(id$) id
Z
T; 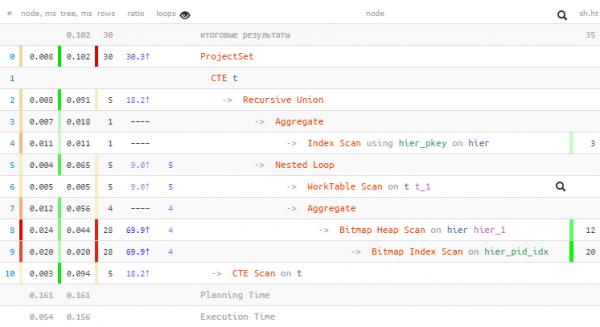
Podařilo se nám zkrátit další přístup k indexu a získali jsme více než 2násobek objemu načítaného.
#2. Вернемся к корням
Tento algoritmus bude užitečný, pokud potřebujete shromáždit záznamy pro všechny prvky „nahoru po stromě“, přičemž si zachováte informace o tom, který původní list (a s jakými ukazateli) vyvolal jeho zařazení do výběru — například pro vytváření souhrnné zprávy s agregací na uzly.
Další informace je třeba vnímat výhradně jako důkaz konceptu, protože dotaz je příliš objemný. Pokud však dominuje ve vaší databázi, je třeba zvážit použití podobných metodik.
Začneme několika jednoduchými tvrzeními:
- Stejný záznam z databáze je lepší číst jen jednou.
- Záznamy z databáze je efektivnější číst „v balíku“, než jednotlivě.
Nyní se pokusíme sestavit požadovaný dotaz.
Krok 1
Je zřejmé, že při inicializaci rekurze (kam by bez ní!) budeme muset přečíst záznamy samých listů podle souboru počátečních identifikátorů:
WITH RECURSIVE tree AS (
  SELECT
    rec -- to je celistvý záznam tabulky
  , id::text chld -- to je "soubor" přivedených zde výchozích listů
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  ...
Pokud se někomu zdálo divné, že „soubor“ je uložen jako řetězec, a ne jako pole, má to jednoduché vysvětlení. Pro řetězce existuje vestavěná agregační „spojovací“ funkce string_agg, a pro pole — ne. Ačkoliv ji je .
Krok 2
Nyní bychom potřebovali získat soubor ID sekcí, které bude třeba dále přečíst. Téměř vždy se budou duplikovat v různých záznamech výchozí sady — proto bychom je měli seskupit, přičemž bychom zachovali informace o zdrojových listech.
Ale tady nás čekají tři nepříjemnosti:
- „Podrekurzivní“ část dotazu nemůže obsahovat agregační funkce s
GROUP BY. - Odkaz na rekurzivní „tabulku“ nemůže být ve vnořeném poddotazu.
- Dotaz v rekurzivní části nemůže obsahovat CTE.
Naštěstí se všechny tyto problémy dají snadno obejít. Začněme od konce.
CTE v rekurzivní části
Takto ne to funguje:
WITH RECURSIVE tree AS (
  ...
UNION ALL
  WITH T (...)
  SELECT ...
)
A takto — funguje, závorky to vyřeší!
WITH RECURSIVE tree AS (
  ...
UNION ALL
  (
    WITH T (...)
    SELECT ...
  )
)
Vnořený dotaz k rekurzivní „tabulce“
Hmm… Odkaz na rekurzivní CTE nemůže být ve vnořeném dotazu. Ale může být uvnitř CTE! A vnořený dotaz může odkazovat již na tuto CTE!
GROUP BY uvnitř rekurze
Nepříjemné, ale… Máme přece jednoduchý způsob, jak simulovat GROUP BY pomocí DISTINCT ON a oknových funkcí!
SELECT
  (rec).pid id
, string_agg(chld::text, ',') chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
GROUP BY 1 -- nefunguje!
A takto — funguje!
SELECT DISTINCT ON((rec).pid)
  (rec).pid id
, string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
FROM
  tree
WHERE
  (rec).pid IS NOT NULL
A teď vidíme, proč se číselný ID převáděl na text — aby je bylo možné spojovat čárkou!
Krok 3
Na finále nám zbývá jen málo:
- kontrolujeme záznamy „sekcí“ podle sady seskupených ID
- porovnáváme přečtené sekce s „sadami“ původních listů
- „rozbalujeme“ řetězec-sadu pomocí
unnest(string_to_array(chld, ',')::integer[])
WITH RECURSIVE tree AS (
  SELECT
    rec
  , id::text chld
  FROM
    hier rec
  WHERE
    id = ANY('{1,2,4,8,16,32,64,128,256,512,1024,2048,4096,8192}'::integer[])
UNION ALL
  (
    WITH prnt AS (
      SELECT DISTINCT ON((rec).pid)
        (rec).pid id
      , string_agg(chld::text, ',') OVER(PARTITION BY (rec).pid) chld
      FROM
        tree
      WHERE
        (rec).pid IS NOT NULL
    )
    , nodes AS (
      SELECT
        rec
      FROM
        hier rec
      WHERE
        id = ANY(ARRAY(
          SELECT
            id
          FROM
            prnt
        ))
    )
    SELECT
      nodes.rec
    , prnt.chld
    FROM
      prnt
    JOIN
      nodes
        ON (nodes.rec).id = prnt.id
  )
)
SELECT
  unnest(string_to_array(chld, ',')::integer[]) leaf
, (rec).*
FROM
tree; 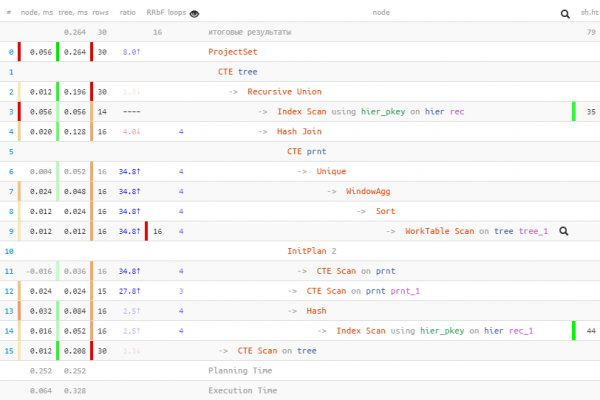
Zdroj: habr.com
