

Jmenuji se Denis Rožkov, jsem vedoucí vývoje software ve společnosti „Gazinformservis“, v produktovém týmu . Legislativní a korporátní normy ukládají určité požadavky na bezpečnost uchovávání dat. Nikdo si nepřeje, aby třetí strany získaly přístup k důvěrným informacím, proto jsou pro každý projekt důležité následující otázky: identifikace a autentifikace, řízení přístupu k datům, zajištění integrity informací v systému, registrace bezpečnostních událostí. Proto bych chtěl hovořit o některých zajímavých aspektech týkajících se bezpečnosti databázových systémů.
Článek byl připraven podle vystoupení na organizovaném . Pokud nechcete číst, můžete se podívat na:
V článku budou tři části:
- Jak chránit připojení.
- Co je audit akcí a jak zaznamenávat, co se děje z pohledu databáze a připojení k ní.
- Jak chránit data v samotné databázi a jaké technologie k tomu existují.
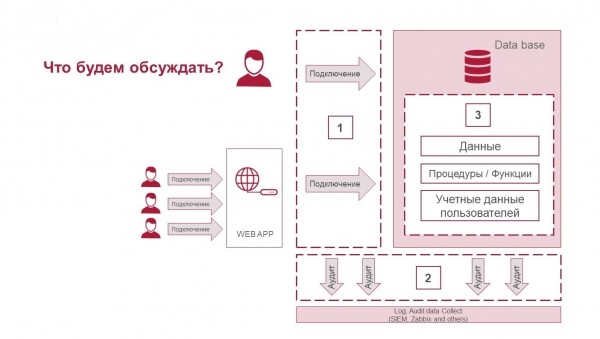
Tři složky bezpečnosti databázových systémů: ochrana připojení, audit akcí a ochrana dat
Ochrana připojení
K databázi se lze připojit buď přímo, nebo nepřímo přes webové aplikace. Obvykle uživatel z obchodní sféry, tedy osoba, která pracuje s databází, s ní nekomunikuje přímo.
Než budeme mluvit o ochraně spojení, je nezbytné zodpovědět na důležité otázky, od nichž závisí, jak budou bezpečnostní opatření nastavena:
- je ekvivalentní jeden business uživatel jednomu uživateli databáze;
- je zajištěn přístup k datům databáze pouze přes API, které ovládáte, nebo je možné přistupovat k tabulkám přímo;
- je databáze umístěna v samostatném zabezpečeném segmentu, kdo a jak s ní interaguje;
- je používán pooling/proxy a mezičlánky, které mohou měnit informace o tom, jak je připojení uspořádáno a kdo používá databázi.
Nyní se podívejme na nástroje, které lze použít k ochraně připojení:
- Použijte řešení třídy database firewall. Dodatečná ochranná vrstva alespoň zvýší průhlednost toho, co se děje v databázi, v nejlepším případě pak budete moci zajistit dodatečnou ochranu dat.
- Používejte politiky hesel. Jejich použití závisí na tom, jak je navržena vaše architektura. V každém případě — jedno heslo v konfiguračním souboru webové aplikace, která se připojuje k DBMS, nestačí na ochranu. Existuje řada nástrojů DBMS, které umožňují kontrolovat, že uživatel a heslo vyžadují aktualizaci.
Více informací o funkcích hodnocení uživatelů si můžete přečíst , také o MS SQL Vulnerability Assessment se můžete dozvědět .
- Obohacujte kontext relace potřebnými informacemi. Pokud je relace neprůhledná, nemáte přehled o tom, kdo pracuje v rámci DBMS, je možné v rámci prováděné operace doplnit informace o tom, kdo, co a proč dělá. Tyto informace lze vidět v auditu.
- Nastavte SSL, pokud nemáte síťové oddělení DBMS od koncových uživatelů, není v samostatném VLAN. V takových případech je nutné chránit kanál mezi spotřebitelem a samotným DBMS. Ochranné nástroje existují i mezi open source.
Jak to ovlivní výkon DBMS?
Podíváme se na příklad PostgreSQL, jak SSL ovlivňuje zatížení CPU, zvýšení časování a snížení TPS, nebude se příliš mnoho prostředků plýtvat, pokud jej zapneme.
Zatěžujeme PostgreSQL pomocí pgbench — je to jednoduchý program pro spuštění testů výkonu. Opakovaně provádí jednu sekvenci příkazů, možná v paralelních relacích databáze, a poté vypočítává průměrnou rychlost transakcí.
Test 1 bez SSL a s použitím SSL — připojení se vytváří při každé transakci:
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe --connect -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Test 2 bez SSL a s použitím SSL — všechny transakce se provádějí v jednom připojení:
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres sslmode=require
sslrootcert=rootCA.crt sslcert=client.crt sslkey=client.key"
vs
pgbench.exe -c 10 -t 5000 "host=192.168.220.129 dbname=taskdb user=postgres"Ostatní nastavení:
scaling factor: 1
query mode: simple
number of clients: 10
number of threads: 1
number of transactions per client: 5000
number of transactions actually processed: 50000/50000
Výsledky testování:
BEZ SSL
SSL
Připojení se vytváří při každé transakci
průměrná latence
171.915 ms
187.695 ms
tps včetně vytváření připojení
58.168112
53.278062
tps bez vytváření připojení
64.084546
58.725846
CPU
24%
28%
Všechny transakce se provádějí v jednom připojení
průměrná latence
6.722 ms
6.342 ms
tps včetně vytváření připojení
1587.657278
1576.792883
tps bez vytváření připojení
1588.380574
1577.694766
CPU
17%
21%
Při nízkém zatížení je vliv SSL srovnatelný s chybou měření. Pokud je objem přenášených dat velmi velký, situace může být jiná. Pokud navazujeme jedno spojení na každou transakci (což se stává zřídka, obvykle se spojení dělí mezi uživateli), máte velké množství připojení/odpojení, vliv může být o něco větší. To znamená, že rizika snížení výkonu mohou existovat, nicméně rozdíl není natolik velký, abyste se vyhýbali používání zabezpečení.
Všimněte si — silný rozdíl existuje, pokud porovnáváte režimy práce: v rámci jedné relace pracujete nebo v různých. Je to jasné: na vytvoření každého spojení se vynakládají zdroje.
Měli jsme případ, kdy jsme připojili Zabbix v režimu trust, tedy jsme neprováděli kontrolu md5, autentizace nebyla nutná. Poté klient požádal o zapnutí režimu md5-autentizace. To zvýšilo zátěž na CPU a výkon klesl. Začali jsme hledat cesty optimalizace. Jedno z možných řešení problému — realizovat síťové omezení, vytvořit pro DB oddělené VLAN, přidat nastavení, aby bylo jasné, kdo a odkud se připojuje, a odstranit autentizaci. Také je možné optimalizovat nastavení autentizace, aby se snížily náklady při zapnutí autentizace, ale celkově aplikace různých metod autentizace má vliv na výkon a je třeba tyto faktory zohlednit při návrhu výpočetních kapacit serverů (hardware) pro DB.
Závěr: v některých řešeních mohou i malé detaily v autentizaci výrazně ovlivnit projekt a je špatné, když se to stane jasným pouze při implementaci do produkce.
Audit činnosti
Audit nemusí být pouze na DB. Audit — to je získávání informací o tom, co se děje v různých segmentech. Může to být i databázový firewall, i operační systém, na kterém je DB postavena.
V komerčních DB úrovně Enterprise je audit v pořádku, v open source — ne vždy. Zde je to, co existuje v PostgreSQL:
- default log — vestavěné logování;
- extensions: pgaudit — pokud vám chybí defaultní logování, můžete využít samostatná nastavení, která řeší část úkolů.
Doplňky k přednášce ve videu:
Základní registrace operátorů může být zajištěna standardním sledovacím nástrojem s log_statement = all.
To je přijatelné pro monitorování a jiné účely použití, avšak neposkytuje úroveň podrobností, která je běžně potřebná pro audit.
Není dostatečné mít pouze seznam všech operací prováděných s databází.
Musí být rovněž možné najít konkrétní tvrzení, která jsou pro auditora zajímavá.
Standardní sledovací nástroj ukazuje to, co uživatel požadoval, zatímco pgAudit se soustředí na detaily toho, co se odehrálo, když databáze prováděla dotaz.
Například auditor může chtít zajistit, že konkrétní tabulka byla vytvořena v zdokumentovaném okně údržby.
To se může zdát jako jednoduchý úkol pro základní audit a grep, ale co když narazíte na něco jako tento (úmyslně zmatený) příklad:
DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Standardní sledování vám poskytne toto:
LOG: příkaz: DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;
Zdá se, že pro nalezení zajímavé tabulky může být potřeba určité znalosti kódu v případech, kdy jsou tabulky vytvářeny dynamicky.
To není ideální, protože by bylo lepší hledat jednoduše podle názvu tabulky.
Zde bude pgAudit užitečný.
Pro stejný vstup vygeneruje tento výstup do logu:
AUDIT: SESSION,33,1,FUNCTION,DO,,,„DO $$
BEGIN
EXECUTE ‘CREATE TABLE import’ || ‘ant_table (id INT)’;
END $$;"
AUDIT: SESSION,33,2,DDL,CREATE TABLE,TABLE,public.important_table,CREATE TABLE important_table (id INT)
Registrováno není jen blok DO, ale i plný text CREATE TABLE s typem operace, typem objektu a plným jménem, což usnadňuje hledání.
Při sledování operátorů SELECT a DML lze pgAudit nakonfigurovat k registraci jednotlivého záznamu pro každou tabulku, na kterou se v operaci odkazuje.
Není zapotřebí syntaktické analýzy pro nalezení všech operací, které se týkají konkrétní tabulky ()».
Jak to ovlivní výkon DBMS?
Pojďme provést testy s aktivací úplného auditu a podívat se, co se stane s výkonem PostgreSQL. Aktivujme maximální logování DB ve všech parametrech.
V konfiguračním souboru prakticky nic neměníme, z důležitých věcí aktivujeme režim debug5, abychom získali co nejvíce informací.
postgresql.conf
log_destination = ‘stderr’
logging_collector = on
log_truncate_on_rotation = on
log_rotation_age = 1d
log_rotation_size = 10MB
log_min_messages = debug5
log_min_error_statement = debug5
log_min_duration_statement = 0
debug_print_parse = on
debug_print_rewritten = on
debug_print_plan = on
debug_pretty_print = zapnuto
log_checkpoints = zapnuto
log_connections = zapnuto
log_disconnections = zapnuto
log_duration = zapnuto
log_hostname = zapnuto
log_lock_waits = zapnuto
log_replication_commands = zapnuto
log_temp_files = 0
log_timezone = 'Evropa/Moskva'
Na databázovém systému PostgreSQL s parametry 1 CPU, 2,8 GHz, 2 GB RAM, 40 GB HDD provádíme tři zátěžové testy pomocí příkazů:
$ pgbench -p 3389 -U postgres -i -s 150 benchmark
$ pgbench -p 3389 -U postgres -c 50 -j 2 -P 60 -T 600 benchmark
$ pgbench -p 3389 -U postgres -c 150 -j 2 -P 60 -T 600 benchmark
Výsledky testování:
Bez logování
S logováním
Celkový čas naplnění databáze
43,74 sek
53,23 sek
RAM
24%
40%
CPU
72%
91%
Test 1 (50 připojení)
Počet transakcí za 10 min
74169
32445
Transakcí/s
123
54
Průměrné zpoždění
405 ms
925 ms
Test 2 (150 připojení při 100 možných)
Počet transakcí za 10 min
81727
31429
Transakcí/s
136
52
Průměrné zpoždění
550 ms
1432 ms
O velikostech
Velikost databáze
2251 MB
2262 MB
Velikost logů databáze
0 MB
4587 MB
V důsledku: úplný audit není příliš dobrý. Podle objemu vznikne dat od auditu stejně tolik, jako je dat v samotné databázi, ba i více. Takový objem logování, který se generuje při práci s databázovým systémem, je běžný problém v produkci.
Podíváme se na další parametry:
- Rychlost se příliš nemění: bez logování — 43,74 sek, s logováním — 53,23 sek.
- Výkon RAM a CPU bude klesat, protože je třeba vytvořit soubor s auditem. To je také znatelné v produkci.
Při zvýšení počtu připojení se samozřejmě ukazatele mírně zhorší.
Ve firmách s auditem je to ještě složitější:
- dat je hodně;
- audit je potřebný nejen přes syslog do SIEM, ale i do souborů: kdyby s syslog došlo k něčemu, musí být blízko k databázi soubor, ve kterém se ukládají data;
- pro audit je potřeba samostatná police, aby nedošlo k poklesu I/O disků, protože zabírá hodně místa;
- někdy je třeba, aby zaměstnanci IT potřebovali všude normy, požadují identifikaci podle norem.
Omezení přístupu k datům
Podíváme se na technologie, které se používají k ochraně dat a přístupu k nim v komerčních databázových systémech a open source.
Co lze obecně použít:
- Šifrování a obfuskace procedur a funkcí (Wrapping) — to znamená oddělené nástroje a utility, které z čitelného kódu dělají nečitelný. Práva ho pak nelze měnit, ani refaktorovat zpět. Takový přístup je někdy vyžadován alespoň na straně databázového systému — logika licenčních omezení nebo logika autorizace je šifrována právě na úrovni procedury a funkce.
- Omezení viditelnosti dat na úrovni řádků (RLS) znamená, že různí uživatelé vidí jednu tabulku, ale různé řádky v ní, což znamená, že někomu něco nelze ukázat na úrovni řádků.
- Úprava zobrazených dat (Masking) je situace, kdy uživatelé ve sloupci tabulky vidí buď data, nebo pouze hvězdičky, což znamená, že pro některé uživatele bude informace skryta. Technologie určuje, co se kterému uživateli zobrazí s ohledem na úroveň přístupu.
- Oddělení přístupu Security DBA/Application DBA/DBA se spíše týká omezení přístupu k samotné DBMS, tedy zaměstnance bezpečnostní složky lze oddělit od databázových administrátorů a administrátorů aplikací. V open source technologiích je jich málo, v komerčních DBMS jich je dostatek. Tyto technologie jsou nezbytné, když je mnoho uživatelů s přístupem k samotným serverům.
- Omezení přístupu k souborům na úrovni souborového systému. Můžete udělovat práva, privilegium přístupu k adresářům tak, aby každý administrátor měl přístup pouze k potřebným datům.
- Mandátový přístup a vymazání paměti jsou technologie, které se používají zřídka.
- End-to-end šifrování přímo v DBMS znamená šifrování na straně klienta s řízením klíčů na serveru.
- Šifrování dat. Například sloupcové šifrování znamená, že používáte mechanismus, který šifruje jednotlivý sloupec databáze.
Jak to ovlivňuje výkon DBMS?
Podívejme se na příklad sloupcového šifrování v PostgreSQL. Je tam modul pgcrypto, který umožňuje ukládat vybraná pole v zašifrované podobě. To je užitečné, když má hodnotu pouze některá data. Aby bylo možné přečíst zašifrovaná pole, klient předává dešifrovací klíč, server data dešifruje a vrací je klientovi. Bez klíče si s vašimi daty nikdo nic nepočíná.
Provedeme test s pgcrypto. Vytvoříme tabulku se zašifrovanými daty a s běžnými daty. Níže jsou příkazy pro vytvoření tabulek, v první řadě užitečný příkaz – vytvoření samotné extension s registrací DBMS:
CREATE EXTENSION pgcrypto;
CREATE TABLE t1 (id integer, text1 text, text2 text);
CREATE TABLE t2 (id integer, text1 bytea, text2 bytea);
INSERT INTO t1 (id, text1, text2)
VALUES (generate_series(1,10000000), generate_series(1,10000000)::text, generate_series(1,10000000)::text);
INSERT INTO t2 (id, text1, text2) VALUES (
generate_series(1,10000000),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'),
encrypt(cast(generate_series(1,10000000) AS text)::bytea, 'key'::bytea, 'bf'));
Dále se pokusíme provést výběr dat z každé tabulky a podíváme se na časy provádění.
Výběr z tabulky bez šifrovací funkce:
psql -c "timing" -c "select * from t1 limit 1000;" "host=192.168.220.129 dbname=taskdb
user=postgres sslmode=disable" > 1.txt
Stopky byly zapnuty.
id | text1 | text2
——+——-+——-
1 | 1 | 1
2 | 2 | 2
3 | 3 | 3
…
997 | 997 | 997
998 | 998 | 998
999 | 999 | 999
1000 | 1000 | 1000
(1000 řádků)
Čas: 1,386 ms
Výběr z tabulky se šifrovací funkcí:
psql -c "timing" -c "select id, decrypt(text1, 'key'::bytea, 'bf'),
decrypt(text2, 'key'::bytea, 'bf') from t2 limit 1000;"
"host=192.168.220.129 dbname=taskdb user=postgres sslmode=disable" > 2.txt
Stopky byly zapnuty.
id | decrypt | decrypt
——+—————+————
1 | x31 | x31
2 | x32 | x32
3 | x33 | x33
…
999 | x393939 | x393939
1000 | x31303030 | x31303030
(1000 řádků)
Čas: 50,203 ms
Výsledky testování:
Bez šifrování
Pgcrypto (decrypt)
Výběr 1000 řádků
1,386 ms
50,203 ms
CPU
15%
35%
RAM
+5%
Šifrování má výrazný dopad na výkon. Je vidět, že doba běhu vzrostla, protože operace dešifrování zašifrovaných dat (a dešifrování je obvykle ještě obaleno ve vaší logice) vyžadují značné prostředky. To znamená, že myšlenka zašifrovat všechny sloupce obsahující nějaká data může být spojena se snížením výkonu.
Šifrování však není stříbrná kulka, která by vyřešila všechny problémy. Dešifrovaná data a dešifrovací klíč jsou během dešifrování a přenosu dat na serveru. Klíče tedy mohou být odcizeny těmi, kdo mají plný přístup k databázovému serveru, například administrátorem systému.
Když má celou kolonku pro všechny uživatele jeden klíč (i když ne pro všechny, ale pro klienty omezené skupiny), není to vždy dobré a správné. Právě proto začali zavádět end-to-end šifrování, v databázových systémem se začaly zvažovat možnosti šifrování dat ze strany klienta a serveru, objevily se tzv. úložiště klíčů - samostatné produkty, které zajišťují správu klíčů na straně databázového systému.

Bezpečnostní nástroje v komerčních a open source databázových systémech
Funkce
Typ
Politika hesel
Audit
Ochrana zdrojového kódu procedur a funkcí
RLS
Šifrování
Oracle
Komerční
+
+
+
+
+
MsSql
Komerční
+
+
+
+
+
Komerční
+
+
+
+
rozšíření
PostgreSQL
Free
rozšíření
rozšíření
—
+
rozšíření
MongoDb
Free
—
+
—
—
Dostupné pouze v MongoDB Enterprise
Tabulka rozhodně není úplná, ale situace je taková: v komerčních produktech se úkoly bezpečnosti řeší dávno, v open source se obvykle pro bezpečnost využívají nějaké nadstavby, mnoha funkcím chybí, někdy je nutné něco dopisovat. Například politiky hesel - v PostgreSQL je mnoho různých rozšíření., , , , ), které implementují politiky hesel, ale podle mého názoru žádný z nich nepokrývá veškeré potřeby domácího firemního segmentu.
Co dělat, pokud nikde není to, co potřebuji? Например, хочется использовать определенную СУБД, в которой нет функций, которые требует заказчик.
V takovém případě je možné použít externí řešení, která pracují s různými SŘBD, například „Krypto DB“ nebo „Garda DB“. Pokud jde o řešení z domácího segmentu, znají lépe normy GOST než v open source.
Druhou možností je napsat si to, co potřebujete, a provést na úrovni procedur přístup k datům a šifrování v aplikaci. Pravda, s GOST to bude složitější. Ale celkově můžete skrýt data, jak potřebujete, uložit je do SŘBD a poté je vytáhnout a dešifrovat, jak je třeba, přímo na úrovni aplikace. Přitom myslete na to, jak tyto algoritmy zabezpečíte na úrovni aplikace. Podle našeho názoru by to mělo být provedeno na úrovni SŘBD, protože to tak bude fungovat rychleji.
Tento referát byl poprvé představen na by Mail.ru Cloud Solutions. Podívejte sedalší vystoupení a přihlaste se k oznámením akcí na Telegramu .
Co dalšího si přečíst na toto téma:
- .
- .
Zdroj: habr.com
