

Ve Sitimobil používáme databázi MySQL jako hlavní úložiště trvalých dat. Máme několik databázových clusterů pro různé služby a účely.
Trvalá dostupnost hlavního uzlu je kritickým ukazatelem funkčnosti celého systému a jeho jednotlivých částí. Automatické zotavení clusteru v případě selhání hlavního uzlu výrazně snižuje čas reakce na incident a prostoje systému. V tomto článku se budu zabývat schématem zajištění vysoké dostupnosti (HA) clusteru MySQL na základě a virtuálních IP adres (VIP).
HA řešení na základě VIP
Nejprve se krátce zmíním o tom, jaký je náš systém ukládání dat.
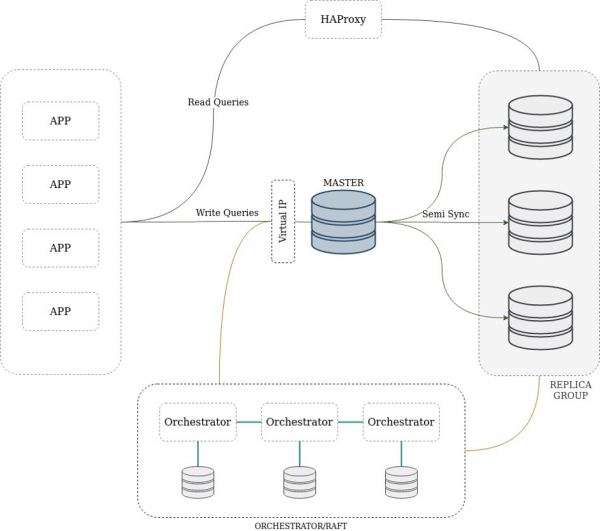
Používáme klasické schéma replikace s jedním hlavním uzlem, který je dostupný pro zápis, a mnoha replikami, které se používají pouze pro čtení. Cluster může obsahovat mezilehlý hlavní uzel – uzel, který je současně replika i hlavní uzel pro jiné. Klienti se obracejí na repliky prostřednictvím HAProxy, což umožňuje vyrovnávat zátěž a snadno škálovat. Použití HAProxy má historické důvody a nyní jsme v procesu migrace na ProxySQL.
Replikace se provádí v polosesynchronním režimu na základě GTID. To znamená, že alespoň jedna replika musí zapsat transakci do protokolu, než bude uznána za úspěšnou. Tento režim replikace zajišťuje optimální rovnováhu mezi výkonem a zachováním dat v případě selhání hlavního uzlu. Všechny změny se obvykle přenášejí od hlavního uzlu k replikám prostřednictvím Row Based Replication (RBR), ale některé uzly mohou mít mixed binlog format.
Orkestrátor pravidelně aktualizuje stav topologie clusteru, analyzuje získané informace a v případě problémů může spustit proceduru automatického zotavení. O samotnou proceduru se stará vývojář, neboť ji lze implementovat různými způsoby: na základě VIP, DNS, pomocí služeb pro objevování služeb (service discovery) nebo vlastních mechanismů.
Jedním z jednoduchých způsobů, jak obnovit hlavní uzel v případě jeho selhání, je použití plovoucích VIP adres.
Co je třeba vědět o tomto řešení, než budeme pokračovat:
- VIP je IP adresa, která není vázána na konkrétní fyzické síťové rozhraní. Při selhání uzlu nebo plánovaných pracích můžeme přepnout VIP na jiný zdroj s minimálním výpadkem.
- Uvolnění a přidělení virtuální IP adresy jsou levné a rychlé operace.
- Pro práci s VIP je potřeba přístup k serveru přes SSH nebo použití speciálních utilit, například,
keepalived.
Zvážíme možné problémy s naším mistrem a představíme si, jak by měl fungovat mechanismus automatického obnovení.
Ztratila se síťová konektivita k mistrovi, nebo došlo k problému na úrovni 'hardwaru', a server není dostupný.
- Orkestrátor aktualizuje topologii clustera, každá replikant hlásí nedostupnost mistra. Orkestrátor zahajuje proces výběru repliky vhodné pro roli nového mistra a začíná obnovu.
- Snažíme se odebrat VIP ze starého mistra — bez úspěchu.
- Replika se přepíná na roli mistra. Topologie se přestavuje.
- Přidáváme nové síťové rozhraní s VIP. Protože se nepodařilo odebrat VIP, na pozadí spouštíme periodické odesílání požadavku gratuitous ARP. Tento typ požadavku/odpovědi umožňuje aktualizovat na připojených přepínačích tabulku shody mezi IP a MAC adresami, čímž informuje o přesunu našeho VIP. To minimalizuje pravděpodobnost
split brainpři návratu starého mistra. - Všechny nové spojení jsou okamžitě přesměrovány na nového mistra. Staré spojení končí neúspěšně, probíhají opakované požadavky na DB na úrovni aplikace.
Server pracuje v normálním režimu, nastala porucha na úrovni DBMS.
Algoritmus je podobný předchozímu případu: aktualizace topologie a zahájení procesu obnovy. Protože je server dostupný, úspěšně uvolňujeme VIP na starém mistrovi, převádíme ho na nový a posíláme několik ARP požadavků. Možný návrat starého mistra by neměl ovlivnit přestavěný cluster a provoz aplikace.
Další problémy
Selhání replik nebo mezičlánkových mistrů nevede k automatickým akcím a vyžaduje manuální zásah.
Virtuální síťové rozhraní je vždy přidáváno dočasně, což znamená, že po restartu serveru VIP není automaticky přiděleno. Každá instance databáze je ve výchozím nastavení spuštěna v režimu pouze pro čtení, orchestrátor automaticky přepíná nového mastera na zápis a pokouší se nastavit pouze pro čtení na starém masteru. Tyto akce jsou zaměřeny na snížení pravděpodobnosti split brain.
Během obnovy mohou nastat problémy, o kterých je také dobré informovat prostřednictvím uživatelského rozhraní orchestrátoru vedle standardních monitorovacích nástrojů. Rozšířili jsme REST API o tuto možnost ( nyní je v posuzování).
Celková schéma HA řešení je uvedena níže.
Výběr nového mastera
Orchestrátor je dost inteligentní a snaží se vybrat jako nový master podle následujících kritérií:
- zpoždění repliky za masterem;
- verze MySQL mastera a repliky;
- typ replikace (RBR, SBR nebo smíšený);
- umístění v jednom nebo různých datových centrech;
- přítomnost
chybějící GTID— transakce, které byly provedeny na replikaci a na masteru chybí; - také se zohledňují uživatelské pravidla výběru.
Ne každá replikace je ideálním kandidátem na roli mastera. Například replikace může být používána pro zálohování dat, nebo server má slabší konfiguraci 'hardwaru'. Orchestrátor ruční pravidla, pomocí nichž můžete nastavit své preference pro výběr kandidáta od nejvíce preferovaných po ignorované.
Doba reakce a obnovení
V případě incidentu je důležité minimalizovat dobu výpadku systému, proto zvažte parametry MySQL, které ovlivňují budování a aktualizaci topologie clusteru orchestrátorem:
- — počet sekund, po které replikace čeká na příjem nových dat nebo heartbeat signálu od mastera, než je spojení považováno za ztracené a proběhne opětovné připojení. Čím menší je hodnota, tím rychleji replikace zjistí, že spojení s masterem bylo přerušeno. Nastavujeme tuto hodnotu na 5 sekund.
- — počet sekund mezi pokusy o obnovení připojení. V případě síťových problémů nízká hodnota tohoto parametru umožní rychlé připojení a zabrání spuštění procesu obnovy klastru. Doporučená hodnota je 1 sekunda.
MASTER_RETRY_COUNT— maximální počet pokusů o obnovení připojení.MASTER_HEARTBEAT_PERIOD— interval v sekundách, po kterém master posílá heartbeat signál. Výchozí hodnota je polovina hodnotyslave_net_timeout.
Parametry orchestrátoru:
DelayMasterPromotionIfSQLThreadNotUpToDate— pokud je roventrue, role master nebude aplikována na kandidátní repliku, dokud SQL vlákno repliky neprovedlo všechny neaplikované transakce z Relay Log. Tuto možnost používáme, abychom neztratili transakce v podmínkách zpoždění všech kandidátských replik.InstancePollSeconds— frekvence vytváření a aktualizace topologie.RecoveryPollSeconds— frekvence analýzy topologie. Při zjištění problému se spustí obnova topologie. To je, rovna 1 sekundě.
Každý uzel klastru je orchestrátorem dotazován jednou za InstancePollSeconds sekund. Při zjištění problému se stav klastru vynutí, a poté se přijme konečné rozhodnutí o provedení obnovy. Experimentováním s různými parametry DB a orchestrátoru se nám podařilo snížit dobu reakce a obnovy na 30 sekund.
Testovací stanice
Testování HA schématu jsme začali vytvořením místního a jeho následným nasazením do testovacího a výrobního prostředí. Místní stend je plně automatizován na základě Dockeru a umožňuje experimentovat s konfigurací orchestrátoru a sítě, škálovat klastr od 2-3 serverů na několik desítek a provádět cvičení v bezpečném prostředí.
Během cvičení si vybíráme jednu z metod simulace problému: okamžitě zastavit master pomocí kill -9, jemně ukončit proces a zastavit server (docker-compose stop), simulovat problémy se sítí pomocí iptables -j REJECT nebo iptables -j DROP. Očekáváme takové výsledky:
- orchestrátor zjistí problémy s masterem a aktualizuje topologii za méně než 10 sekund;
- automaticky se spustí postup obnovy: změní se síťová konfigurace, role master přejde na repliku, topologie se přestaví;
- nový master bude dostupný pro zápis, živé repliky nebudou během přestavby ztraceny;
- data začnou být zapisována do nového masteru a replikována;
- celkový čas obnovení nepřesáhne 30 sekund.
Jak víte, systém se může chovat různě v testovacím a produkčním prostředí kvůli různým konfiguracím „hardwaru“ a sítě, rozdílům v syntetickém a reálném zatížení atd. Proto periodicky provádíme cvičení v reálných podmínkách, abychom ověřili, jak systém reaguje na ztrátu síťové konektivity nebo degradaci některých jeho částí. V budoucnu bychom chtěli vybudovat zcela identickou infrastrukturu pro obě prostředí a automatizovat její testování.
Závěry
Fungování hlavního uzlu systému ukládání dat je jedním z hlavních úkolů týmu SRE a provozu. Zavedení orchestrátoru a HA řešení na bázi VIP umožnilo dosáhnout následujících výsledků:
- spolehlivé odhalení problémů s topologií DB clusteru;
- automatická a rychlá reakce na incidenty týkající se masteru, což snižuje prostoje systému.
Nicméně řešení má svá omezení a nevýhody:
- škálování HA schématu na několik datových center vyžaduje existenci jednotné L2 sítě mezi nimi;
- před přidělením VIP na novém masteru musíme uvolnit starý. Proces je sekvenční, což zvyšuje čas obnovy;
- uvolnění VIP vyžaduje SSH přístup k serveru nebo jiný způsob volání vzdálených procedur. Vzhledem k tomu, že server nebo DB má problémy, které vedly k procesu obnovy, nemůžeme si být jisti, že zrušení VIP proběhne úspěšně. To může vést k situaci, kdy existují dva servery se stejnou virtuální IP adresou a problémem.
split brain.
Abychom se vyhnuli split brain, můžeme použít metodu („Shoot The Other Node In The Head“), která zcela izoluje nebo odpojuje problémový uzel. Existují i jiné způsoby, jak realizovat vysokou dostupnost clusteru: kombinace VIP a DNS, detekce služeb a proxy služby, synchronní replikace a další metody, které mají své nedostatky a výhody.
Hovořil jsem o našem přístupu k vytváření odolného MySQL clusteru. Je snadno realizovatelný a poskytuje přijatelnou úroveň spolehlivosti v aktuálních podmínkách. Jak celý systém, tak i infrastruktura se vyvíjejí, tento přístup se nepochybně vyvine.
Zdroj: habr.com
