

Důležitým aspektem práce distribuovaných systémů je zpracování selhání. Kubernetes v tom pomáhá pomocí kontrolerů, které sledují stav vašeho systému a znovu spouští služby, které přestaly fungovat. Nicméně, Kubernetes může vynutit zastavení vašich aplikací, aby zajistil celkovou životaschopnost systému. V této sérii se podíváme na to, jak můžete Kubernetes pomoci vykonávat svou práci efektivněji a snižovat prostoje aplikací.
Před zavedením kontejnerů většina aplikací běžela na virtuálních nebo fyzických strojích. Pokud aplikace selhala nebo se zasekla, trvalo hodně času, než bylo možné zastavit běžící úlohu a znovu načíst program. V nejhorším případě se někdo musel s tímto problémem vypořádat ručně v noci, v nejméně vhodnou dobu. Pokud důležitou úlohu vykonávalo jen 1-2 pracovní stroje, takové selhání bylo naprosto nepřijatelné.
Proto místo ručního restartování začali používat monitorování na úrovni procesů pro automatické restartování aplikace v případě jejího nečekaného ukončení. Pokud program selhal, monitorovací proces zachytí exit kód a restartuje server. S příchodem systémů, jako je Kubernetes, byl tento způsob reakce na selhání systému prostě integrován do infrastruktury.
Kubernetes používá smyčku událostí „sledování – záznam rozdílů – provedení akce“, aby zajistil, že prostředky zůstávají funkční na cestě od kontejnerů ke samotným uzlům.
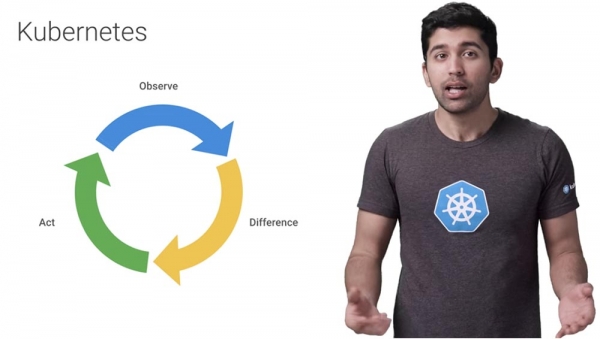
To znamená, že už nemusíte ručně spouštět sledování procesů. Pokud zdroj neprošel kontrolou zdraví Health Check, Kubernetes mu jednoduše automaticky poskytne náhradu. Přitom Kubernetes dělá mnohem víc než jen sledování selhání vašich aplikací. Může vytvářet více kopií aplikace pro provoz na několika strojích, aktualizovat aplikaci nebo současně spouštět několik verzí vaší aplikace.
Existuje mnoho důvodů, proč Kubernetes může přerušit práci zcela zdravého kontejneru. Například pokud aktualizujete své nasazení, Kubernetes pomalu zastaví staré pody, zatímco současně spouští nové. Pokud vypnete uzel, Kubernetes ukončí všechny pody na tomto uzlu. A nakonec, pokud na uzlu dojdou prostředky, Kubernetes deaktivuje všechny pody, aby uvolnil tyto prostředky.
Je proto velmi důležité, aby vaše aplikace přestala fungovat s minimálním dopadem na koncového uživatele a co nejkratší dobou obnovy. To znamená, že před vypnutím musí uložit všechna potřebná data, uzavřít všechna síťová spojení, dokončit zbývající úkoly a stihnout provést další naléhavé úkoly.
V praxi to znamená, že vaše aplikace by měla být schopna zpracovat signál SIGTERM – signál pro ukončení procesu, který je výchozím signálem pro utilitu kill v unixových operačních systémech. Po obdržení tohoto signálu by se aplikace měla vypnout.
Jakmile se Kubernetes rozhodne ukončit pod, nastává celá řada událostí. Podívejme se na každý krok, který Kubernetes provede při vypnutí kontejneru nebo podu.
Představme si, že chceme ukončit jeden z podů. V tuto chvíli přestane přijímat nový provoz – běžící kontejnery v podu nebudou ovlivněny, ale veškerý nový provoz bude zablokován.
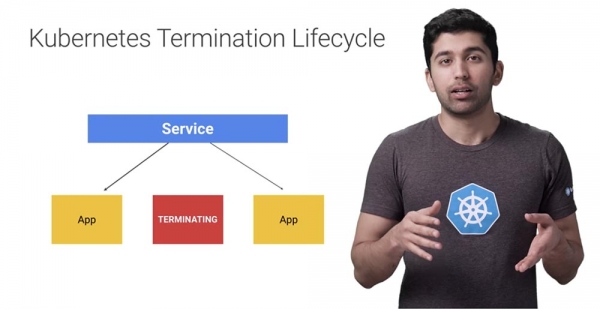
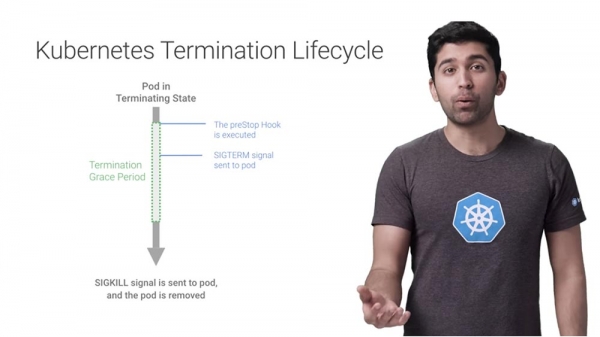
Podívejme se na hook preStop – to je speciální příkaz nebo HTTP požadavek, který je zasílán kontejnerům v podu. Pokud vaše aplikace při obdržení SIGTERM nevypíná správně, můžete použít preStop pro správné ukončení.
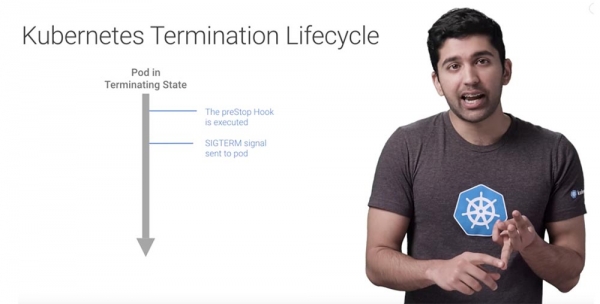
Většina programů při obdržení signálu SIGTERM správně končí svůj běh, ale pokud používáte externí kód nebo systém, který nemůžete úplně kontrolovat, hook preStop je skvělý způsob, jak vyvolat elegantní vypnutí bez změny aplikace.
Po provedení tohoto hooku Kubernetes zašle kontejnerům v podu signál SIGTERM, který je informuje, že brzy budou vypnuty. Po obdržení tohoto signálu váš kód přejde k procesu vypnutí. Tento proces může zahrnovat zastavení jakýchkoliv dlouhodobých připojení, jako je připojení k databázi nebo WebSocket, uložení aktuálního stavu a podobně.
I když používáte hook preStop, je velmi důležité zkontrolovat, co se děje s vaší aplikací, když jí pošlete signál SIGTERM, jak se při tom chová, aby události nebo změny v chodu systému, způsobené vypnutím podu, nebyly pro vás překvapením.
V tomto okamžiku, než podniknete další kroky, Kubernetes počká po stanovenou dobu, známou jako terminationGracePeriodSecond, což je doba pro správné vypnutí po obdržení signálu SIGTERM.
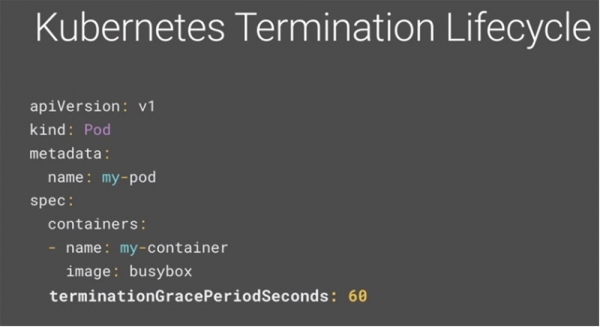
Ve výchozím nastavení je tato doba 30 sekund. Je důležité poznamenat, že probíhá paralelně s hookem preStop a signálem SIGTERM. Kubernetes nebude čekat, až skončí preStop hook a SIGTERM — pokud vaše aplikace skončí dříve, než uplyne doba terminationGracePeriod, Kubernetes okamžitě přejde k dalšímu kroku. Proto zkontrolujte, že hodnota této doby v sekundách není menší než čas potřebný pro správné vypnutí podu, a pokud překračuje 30s, prodlužte tuto dobu na potřebnou hodnotu v YAML. V uvedeném příkladu je to 60s.
A nakonec, poslední krok — pokud kontejnery stále běží po uplynutí terminationGracePeriod, zašlou signál SIGKILL a budou nuceně odstraněny. V tomto okamžiku Kubernetes také vyčistí všechny ostatní objekty podu.
Kubernetes ukončuje běh podů z mnoha důvodů, proto se ujistěte, že vaše aplikace bude v každém případě ukončena správně, aby byla zajištěna stabilita služby.
Malá reklama 🙂
Děkujeme, že s námi zůstáváte. Líbí se vám naše články? Chcete vidět více zajímavých materiálů? Podpořte nás objednávkou nebo doporučením známým, , unikátní alternativa entry-level serverů, kterou jsme pro vás vymysleli: (k dispozici varianty s RAID1 a RAID10, až 24 jader a až 40GB DDR4).
Dell R730xd je dvakrát levnější v datovém centru Equinix Tier IV v Amsterdamu? Jen u nás v Nizozemsku! Dell R420 — 2x E5-2430 2.2GHz 6C 128GB DDR3 2x960GB SSD 1Gbps 100TB — od 99 $! Čtěte o tom
Zdroj: habr.com
