

Ahoj, nedávno jsem se setkal se zajímavým úkolem nastavit úložiště pro zálohování velkého množství blokových zařízení.
Každý týden provádíme zálohování všech virtuálních strojů v našem cloudu, a proto musíme umět spravovat tisíce záloh a dělat to co nejrychleji a nejefektivněji.
Bohužel standardní konfigurace RAID5, RAID6 v tomto případě nebudou vyhovovat, protože proces obnovy na tak velkých discích, jako máme my, bude nesmírně dlouhý a pravděpodobně nikdy neskončí.
Podívejme se na alternativy:
— analog RAID5, RAID6, ale s nastavovatelnou úrovní paritní kontroly. Zálohování se provádí nikoli po blocích, ale pro každý objekt zvlášť. Nejsnazší způsob, jak vyzkoušet erasure coding, je nasadit .
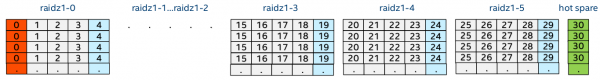
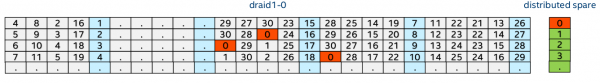
— je to v současnosti ještě nevydaná funkce ZFS. Na rozdíl od RAIDZ má DRAID distribuovaný paritní blok a při obnově se okamžitě zapojí všechny disky v poli, což lépe odolává chybám disků a rychleji se obnovuje po výpadku.
K dispozici je server Fujitsu Primergy RX300 S7 s procesorem Intel Xeon CPU E5-2650L 0 @ 1.80GHz, devíti moduly operační paměti Samsung DDR3-1333 8Gb PC3L-10600R ECC Registered (M393B1K70DH0-YH9), disková schránka Supermicro SuperChassis 847E26-RJBOD1, připojená přes Dual LSI SAS2X36 Expander a 45 disků Seagage ST6000NM0115-1YZ110 o 6TB každý.
Než něco rozhodneme, musíme nejprve vše řádně otestovat.
K tomu jsem se připravil a provedl testování různých konfigurací. K tomu jsem použil minio, které sloužilo jako S3 backend a spouštěl jsem ho v různých režimech s různým počtem cílů.
Hlavně jsem testoval případ minio v erasure coding vs software raid se stejným počtem disků a paritních disků, totiž: RAID6, RAIDZ2 a DRAID2.
Pro informaci: když spustíte minio s jediným cílem, pak minio pracuje v režimu S3 brány a poskytuje vaše lokální souborový systém jako S3 úložiště. Pokud však spustíte minio s několika cíli, automaticky se aktivuje režim Erasure Coding, který rozprostře data mezi vašimi cíli a zajistí odolnost vůči chybám.
Minio standardně rozděluje cíle do skupin po 16 discích, kde na každou skupinu připadnou 2 parity. To znamená, že současně mohou selhat dva disky bez ztráty dat.
Pro testování výkonu jsem použil 16 disků po 6TB každý a zapisoval na ně malé objekty o velikosti 1MB, což co nejpřesněji odráželo naši budoucí zátěž, protože všechny moderní nástroje pro zálohování dělí data na bloky o několika megabajtech a zapisují je tímto způsobem.
Pro provedení benchmarku byla použita utilita s3bench spuštěná na vzdáleném serveru, která do Minio posílala desítky tisíc takových objektů ve stovkách vláken. Poté se stejným způsobem snažila je získat zpět.
Výsledky benchmarku jsou uvedeny v následující tabulce:
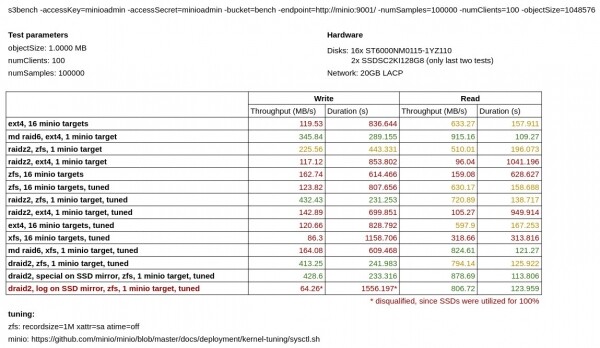
Jak vidíme, Minio v režimu vlastního erasure coding funguje výrazně hůře při zápisu než Minio spuštěné nad softwarovým RAID6, RAIDZ2 a DRAID2 ve stejné konfiguraci.
Zvlášť mě o testování Minio na ext4 vs XFS. Úžasné je, že pro můj typ zátěže byla XFS výrazně pomalejší než ext4.
V první sadě testů Mdadm prokázal převahu nad ZFS, ale později , že lze zlepšit výkon ZFS nastavením následujících možností:
xattr=sa atime=off recordsize=1Ma po tomto testy s ZFS byly mnohem lepší.
Také je možné si všimnout, že DRAID nenabízí významné zvýšení výkonu oproti RAIDZ, ale teoreticky by měl být mnohem bezpečnější.
V posledních dvou testech jsem také zkusil vyvést metadata (special) a ZIL (log) na zrcadlo z SSD. Ale vyvedení metadat nepřineslo významné zvýšení rychlosti zápisu, a při vyvádění ZIL jsem se dostal na strop se 100% využitím, takže tento test považuji za neúspěšný. Nevylučuji, že kdybych měl rychlejší SSD disky, mohlo by to významně zlepšit mé výsledky, ale bohužel je nemám.
Nakonec jsem se rozhodl zůstat u DRAID a i přes jeho beta status je to nejrychlejší a nejefektivnější řešení pro naše potřeby.
Vytvořil jsem jednoduchý DRAID2 v konfiguraci se třemi skupinami a dvěma distribuovanými náhradami:
# zpool status data
  pool: data
 state: ONLINE
  scan: none requested
config:

    NAME                 STATE     READ WRITE CKSUM
    data                 ONLINE       0     0     0
      draid2:3g:2s-0     ONLINE       0     0     0
        sdy              ONLINE       0     0     0
        sdam             ONLINE       0     0     0
        sdf              ONLINE       0     0     0
        sdau             ONLINE       0     0     0
        sdab             ONLINE       0     0     0
        sdo              ONLINE       0     0     0
        sdw              ONLINE       0     0     0
        sdak             ONLINE       0     0     0
        sdd              ONLINE       0     0     0
        sdas             ONLINE       0     0     0
        sdm              ONLINE       0     0     0
        sdu              ONLINE       0     0     0
        sdai             ONLINE       0     0     0
        sdaq             ONLINE       0     0     0
        sdk              ONLINE       0     0     0
        sds              ONLINE       0     0     0
        sdag             ONLINE       0     0     0
        sdi              ONLINE       0     0     0
        sdq              ONLINE       0     0     0
        sdae             ONLINE       0     0     0
        sdz              ONLINE       0     0     0
        sdan             ONLINE       0     0     0
        sdg              ONLINE       0     0     0
        sdac             ONLINE       0     0     0
        sdx              ONLINE       0     0     0
        sdal             ONLINE       0     0     0
        sde              ONLINE       0     0     0
        sdat             ONLINE       0     0     0
        sdaa             ONLINE       0     0     0
        sdn              ONLINE       0     0     0
        sdv              ONLINE       0     0     0
        sdaj             ONLINE       0     0     0
        sdc              ONLINE       0     0     0
        sdar             ONLINE       0     0     0
        sdl              ONLINE       0     0     0
        sdt              ONLINE       0     0     0
        sdah             ONLINE       0     0     0
        sdap             ONLINE       0     0     0
        sdj              ONLINE       0     0     0
        sdr              ONLINE       0     0     0
        sdaf             ONLINE       0     0     0
        sdao             ONLINE       0     0     0
        sdh              ONLINE       0     0     0
        sdp              ONLINE       0     0     0
        sdad             ONLINE       0     0     0
    spares
      s0-draid2:3g:2s-0  AVAIL
      s1-draid2:3g:2s-0  AVAIL

errors: No known data errors
Dobrá, co se úložiště týče, máme to vyřešené; nyní k tomu, čím budeme zálohovat. Zde bych chtěl hned zmínit tři řešení, která jsem měl možnost vyzkoušet, a to jsou:
— fork , specializované řešení pro zálohování blokových zařízení, má úzkou integraci s Ceph. Umí získávat diffy mezi snímky a vytvářet z nich inkrementální zálohu. Podporuje velké množství backendů pro ukládání, mezi kterými je jak místní, tak S3. Vyžaduje samostatnou databázi pro ukládání hašovací tabulky deduplikace. Mezi nevýhody patří: je napsán v Pythonu a má poněkud nefunkční CLI.
— fork , dlouho známý a osvědčený nástroj pro zálohování, umí zálohovat data a dobře je deduplikovat. Umí ukládat zálohy jak místně, tak na vzdálený server prostřednictvím SCP. Může zálohovat bloková zařízení, pokud je spuštěn s přepínačem --special, mezi nevýhodami: při vytváření zálohy je repozitář zcela zablokován, takže pro každou virtuální mašinu se doporučuje vytvořit samostatný repozitář, což v podstatě není problém, protože se vytvářejí velmi snadno.
— aktivně vyvíjený projekt, napsaný v Go, poměrně rychlý a podporuje velké množství backendů pro ukládání, mezi kterými je jak místní úložiště, tak SCP, S3 a mnoho dalšího. Zvlášť je třeba zmínit, že existuje speciálně vytvořený pro Restic, který umožňuje nejrychlejší export úložiště pro použití na dálku. Ze všech uvedených mi nejvíce vyhovoval. Umí zálohovat ze stdin. Skoro žádné znatelné nevýhody nemá, ale má několik specifik:
Za prvé, pokusil jsem se ho použít v režimu sdíleného repozitáře pro všechny virtuální mašiny (jako Benji) a to fungovalo docela dobře, ale operace obnovení trvaly poměrně dlouho, protože se vždy před obnovením Restic pokouší přečíst metadata všech záloh. Tento problém se snadno vyřešil, stejně jako u Borg, vytvořením samostatného repozitáře pro každou virtuální mašinu. Tento přístup se ukázal být velmi efektivní také pro správu záloh. Oddělené repozitáře mohou mít samostatné heslo pro přístup k datům, a tak se nemusíme bát, že globální repozitář se nějak poškodí. Nové repozitáře lze také vytvářet stejně snadno jako v Borg Backup.
V každém případě se deduplikace provádí pouze vzhledem k předchozí verzi zálohy, přičemž předchozí záloha je určena podle cesty pro uvedenou zálohu. Takže pokud zálohujete různé objekty z stdin do společného úložiště, nezapomeňte uvést možnost
--stdin-filename, nebo každý čas explicitně uvádět možnost--parent.
Za druhé, obnovení do stdout trvá výrazně déle než obnovení na souborový systém kvůli jeho paralelnosti. V budoucnu plánujeme přidat těsnější podporu záloh pro bloková zařízení.
Za třetí, v současné době se doporučuje používat , protože verze 0.9.6 má chybu s dlouhým obnovením velkých souborů.
Abych otestoval účinnost zálohování a rychlost zápisu / obnovení ze zálohy, vytvořil jsem samostatné úložiště a pokusil se zálohovat malý obraz virtuálního stroje (21 GB). Byly provedeny dvě zálohy bez změny originálu, přičemž byla použita každá z uvedených možností, abych zjistil, jakým tempem se deduplikovaná data kopírují.
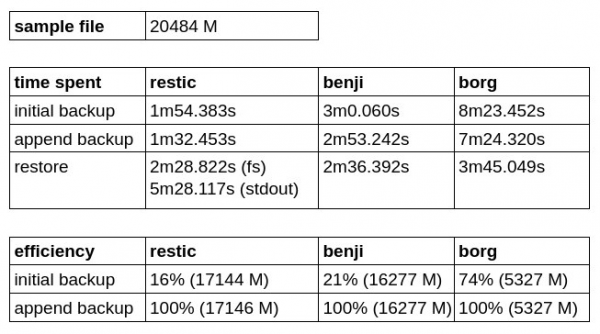
Jak můžeme vidět, Borg Backup má nejlepší poměr efektivity při počáteční záloze, ale zaostává jak rychlostí zápisu, tak obnovy.
Restic se ukázal být rychlejší než Benji Backup, ale déle obnovuje do stdout a bohužel zatím neumí zapisovat přímo do blokového zařízení.
Zvážil jsem všechny pro a proti a rozhodl jsem se zůstat u restic s rest-server jako nejpohodlnějším a perspektivním řešení pro zálohování.
V tomto screencastu můžete vidět, jak je 10gigabitový kanál plně utilizován při několika současně spuštěných zálohovacích operacích. Je třeba poznamenat, že využití disků ve stejnou dobu nevystoupí nad 30%.
S dosaženým řešením jsem byl více než spokojen!
Zdroj: habr.com
