

Ahoj, Habr! Poslední pár měsíců jsme žili v opravdu zajímavé situaci, a rád bych se podělil o náš příběh o škálování infrastruktury. Během této doby SberMarket zvýšil objednávky čtyřikrát a spustil službu ve 17 nových městech. Explozivní růst poptávky po dodání potravin si vyžádal od nás rozšíření infrastruktury. O těch nejzajímavějších a užitečných závěrech čtěte pod katem.
Jmenuji se Dima Bobyljev, jsem technický ředitel SberMarketu. Protože je to první příspěvek v našem blogu, rád bych řekl několik slov o sobě a o společnosti. Minulou podzim jsem se účastnil soutěže mladých lídrů Runetu. Pro soutěž jsem o tom, jak my v SberMarketu vidíme vnitřní kulturu a přístup k rozvoji služby. A i když jsme v soutěži nevyhráli, dokázal jsem si výstižně formulovat hlavní principy rozvoje IT ekosystému.
Při řízení týmu je důležité chápat a nacházet rovnováhu mezi potřebami byznysu a potřebami každého konkrétního vývojáře. V současnosti SberMarket roste 13krát rok od roku a to ovlivňuje produkt, což vyžaduje neustálé zvyšování objemů a rychlosti vývoje. I přesto vyčleňujeme dostatek času vývojářům na předběžnou analýzu a kvalitní psaní kódu. Stanovený přístup pomáhá nejen při vytváření fungujícího produktu, ale také při jeho dalším rozšiřování a rozvoji. V důsledku takového růstu se SberMarket již stal lídrem mezi službami dodání potravin: denně doručujeme přibližně 18 tisíc objednávek, i když na začátku února jich bylo asi 3500.
Jednou klient požádal kurýra SberMarketu, aby mu potraviny dodal bezkontaktně — přímo na balkon.
Ale pojďme k detailům. V posledních několika měsících jsme aktivně rozšiřovali infrastrukturu naší společnosti. Tato potřeba byla vysvětlena vnějšími a vnitřními faktory. Současně s rozšiřováním klientské základny vzrostl počet připojených obchodů z 90 na začátku roku na více než 200 do poloviny května. Připravili jsme se na to, rezervovali jsme hlavní infrastrukturu a počítali jsme s možností vertikálního a horizontálního škálování všech virtuálních strojů umístěných v cloudu Yandex. Avšak praxe ukázala: „Všechno, co se může pokazit, se pokazí.“ A dnes se chci podělit o nejzajímavější situace, které nastaly v těchto týdnech. Doufám, že naše zkušenosti budou pro vás užitečné.
Slave je plně připraven.
Ještě před začátkem pandemie jsme se setkali s rostoucím počtem požadavků na naše backend servery. Trend objednávat produkty s doručením domů začal získávat na síle, a s přijetím prvních opatření sebezádržného chování v souvislosti s COVID-19 se zátěž dramaticky zvyšovala po celý den. Objevila se potřeba rychle uvolnit master servery hlavní databáze a přesunout část čtecích požadavků na replikové servery (slave).
Na tento krok jsme se předem připravili a pro takový manévr už byly spuštěny 2 slave servery. Na těchto serverech se převážně prováděly dávkové úkoly generování informačních feedů pro výměnu dat s partnery. Tyto procesy vytvářely zbytečné zatížení a zcela oprávněně byly vyřazeny "z počítání" o pár měsíců dříve.
Protože na Slave probíhala replikace, drželi jsme se koncepce, že aplikace mohou pracovat s nimi pouze v režimu pouze pro čtení. Plán obnovy po havárii předpokládal, že v případě katastrofy budeme moci jednoduše připojit Slave místo Master a přepnout všechny požadavky na zápis a čtení na Slave. Nicméně jsme také chtěli používat repliky pro potřeby analytického oddělení, a proto servery nebyly zcela převedeny do stavu pouze pro čtení, a na každém hostiteli byl vlastní soubor uživatelů, z nichž někteří měli práva zápisu pro uchování mezivýsledků výpočtů.
Do určité úrovně zatížení nám stačil master jak pro zápis, tak pro čtení při zpracování http požadavků. V polovině března, právě když Sbermarket se rozhodl přejít na plně vzdálenou práci, začal u nás mnohonásobný nárůst RPS. Čím dál víc našich klientů přešlo do izolace nebo na home office, což se odrazilo na ukazatelích zatížení.
Výkon mastera přestal stačit, a proto jsme začali přesouvat část nejvytíženějších čtecích požadavků na replikaci. Pro transparentní směrování zápisových požadavků na master a čtecích na slave jsme použili ruby gem „“. Vytvořili jsme speciálního uživatele s postfixem _readonly bez zápisových práv. Ale kvůli chybě v konfiguraci jednoho z hostitelů část zápisových požadavků odešla na slave server pod jménem uživatele, který měl odpovídající práva.
Problém se neprojevil hned, protože zvýšené zatížení zvýšilo zpoždění slaves. Nekonzistence dat byla odhalena ráno, když po nočních importech slaves „nedohnaly“ master. Připsali jsme to na vysoké zatížení samotné služby a importy spojené s otevřením nových obchodů. Ale poskytovat data se několikahodinovým zpožděním bylo nepřípustné, a tak jsme přepnuli procesy na druhého analytického slave, protože měl větší zdroje a nebyl zatížen čtecími požadavky (což jsme si vysvětlili jako nepřítomnost zpoždění replikace).oKdyž jsme se vypořádali s příčinami „rozpínání“ hlavního slave, analytický už byl mimo provoz ze stejného důvodu. I když jsme měli dva další servery, na které jsme plánovali přesunout zátěž v případě havárie mastera, kvůli otravné chybě se ukázalo, že v kritickém okamžiku není žádný.
Ale protože jsme dělali nejen dump databáze (obnova v tu chvíli trvala asi 5 hodin), ale také snapshot master serveru, podařilo se nám spustit replikaci během 2 hodin. I když nás po tom čekalo nahrávání replikace po dlouhou dobu (protože proces probíhá v jednovláknovém režimu, ale to je už úplně jiný příběh).
Jelikož jsme prováděli nejen dump databáze (obnova na ten okamžik trvala přibližně 5 hodin), ale i snapshot master serveru, podařilo se nám spustit replikaci během 2 hodin. Pravda, po tom nás čekalo několikahodinové přehrávání replikace (protože proces probíhá v jednovláknovém režimu, ale to už je úplně jiný příběh).
Výstup: Po takovém incidentu bylo jasné, že je potřeba vzdát se praxe omezování zápisu pro uživatele a vyhlásit celý server jako pouze pro čtení. Při takovém přístupu si můžete být jisti, že repliky budou k dispozici v kritickýchmomentech.
Optimalizace i jednoho náročného dotazu může "vrátit k životu" databázi.
I když neustále aktualizujeme katalog na webu, dotazy, které jsme směřovali na Slave servery, vykazovaly mírné zpoždění za Masterem. Čas, za který jsme objevili a odstranili problém "náhle poodstupujících" slaves, byl delší než "psychologická bariéra" (během této doby mohlo dojít k aktualizaci cen a klienti by viděli zastaralé údaje), a byli jsme nuceni přepnout všechny dotazy na hlavní databázový server. Výsledkem bylo, že web fungoval pomalu... ale alespoň fungoval. A zatímco se Slave zotavoval, nic jiného nám nezbylo než optimalizace.
Zatímco se Slave servery zotavovaly, minuty se táhly pomalu, Master byl přetížen a my jsme soustředili všechny síly na optimalizaci aktivních úloh podle "Pravidla Paretova": vybrali jsme TOP dotazy, které způsobovaly většinu zátěže, a začali ladit. To se dělalo přímo "za letu".
Zajímavý efekt spočíval v tom, že MySQL, které bylo přeplněné, reagovalo na i sebemenší zlepšení procesů. Optimalizace pár dotazů, které způsobovaly pouze 5 % celkové zátěže, už prokázala viditelné uvolnění CPU. V důsledku toho jsme byli schopni zajistit přijatelnou rezervu zdrojů pro práci Mastera s databází a získat potřebný čas pro obnovení replik.
Výstup: I malé optimalizace umožňují "přežít" při přetížení po dobu několika hodin. To nám přesně stačilo na čas potřebný k obnovení serverů s replikami. Mimochodem, technickou stránku optimalizace dotazů probereme v jednom z následujících příspěvků. Tak se přihlaste k našemu blogu, pokud by to pro vás mohlo být užitečné.
Zajistěte monitoring funkčnosti partnerských služeb.
Zabýváme se zpracováním objednávek od klientů, a proto naše služby neustále spolupracují s externími API – což jsou brány pro odesílání SMS, platební platformy, systémy routování, geokodery, služby FNS a mnoho dalších systémů. A když zatížení začalo rychle růst, začali jsme narážet na limity API našich partnerů, o kterých jsme předtím ani neuvažovali.
Nečekané překročení kvót partnerských služeb může vést k výpadkům vašich vlastních. Mnohá API blokují klienty, kteří překračují limity, a v některých případech může přebytek požadavků přetížit produkci u partnera.
Například v době růstu počtu dodávek provázející služby nezvládaly úkoly jejich rozdělení a určování tras. Výsledkem bylo, že objednávky byly uskutečněny, ale služba vytvářející trasu nefungovala. Je třeba říct, že naši logistici udělali prakticky nemožné za těchto podmínek, a jasná spolupráce týmu pomohla kompenzovat dočasné výpadky služeb. Ale takové množství žádostí není možné neustále zpracovávat ručně, a po nějaké době bychom se setkali s nepřijatelným rozpor mezi objednávkami a jejich plněním.
Byl přijat celkový sled organizačních opatření a součinná práce kolektivu pomohla získat čas, zatímco jsme vyjednávali o nových podmínkách a čekali na modernizaci služeb od některých partnerů. Existují také jiná API, která potěší vysokou odolností a neuvěřitelnými sazbami v případě vysokého provozu. Například zpočátku jsme používali jedno známé mapové API pro určování adresy místa dodání. Ale na konci měsíce jsme dostali účet téměř na 2 miliony rublů. Po tom jsme se rozhodli jej rychle nahradit. Nebudu se věnovat reklamě, ale řeknu, že naše náklady se výrazně snížily.
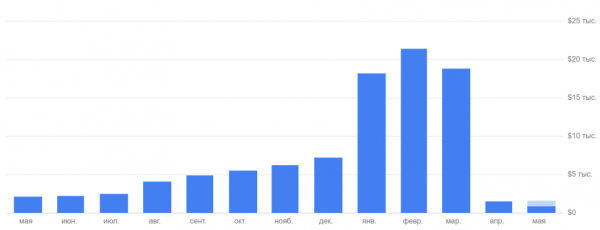
Výstup: Je nutné neustále monitorovat podmínky práce všech partnerských služeb a mít je na paměti. I když se může dnes zdát, že mají "velkou rezervu", to neznamená, že zítra se nestanou překážkou růstu. A samozřejmě, je lepší domluvit se na finančních podmínkách zvýšených požadavků na službu předem.
Někdy se stává, že "" (c) nepomáhá
Jsme zvyklí na „úzká místa“ v hlavní databázi nebo na aplikačních serverech, ale při škálování se problémy mohou projevit i tam, kde je neočekáváme. Pro fulltextové vyhledávání na našem webu používáme engine Apache Solr. S nárůstem zátěže jsme zaznamenali pokles doby odezvy a zatížení procesoru serveru dosáhlo 100 %. Co může být jednodušší — dáme kontejneru s Solr více prostředků.
Místo očekávaného nárůstu výkonu server jednoduše „umřel“. Okamžitě se zatížil na 100 % a reagoval ještě pomaleji. Původně jsme měli 2 jádra a 2 GB RAM. Rozhodli jsme se udělat to, co obvykle pomáhá — dali jsme serveru 8 jader a 32 GB. Všechno se stalo mnohem horší (jak a proč, vysvětlíme v samostatném příspěvku).
Během několika dní jsme pronikli do detailů této věci a dosáhli optimálního výkonu při 8 jádrech a 32 GB. Tato konfigurace nám umožňuje i nadále zvyšovat zátěž, což je velmi důležité, protože růst probíhá nejen u klientů, ale i u počtu připojených obchodů — během 2 měsíců se jejich počet zdvojnásobil.
Výstup: Standardní metody jako „přidání více hardwaru“ nefungují vždy. Takže při škálování jakéhokoli služby je důležité dobře rozumět, jak využívá zdroje, a předem testovat její fungování v nových podmínkách.
Stateless — klíč k jednoduchému horizontálnímu škálování
Celkově se náš tým drží známého přístupu: služby by neměly mít vnitřní stav (stateless) a měly by být nezávislé na prostředí, ve kterém běží. To nám umožnilo snášet nárůst zátěže jednoduchým horizontálním škálováním. Měli jsme však jednu výjimku – zpracovatele dlouhých pozadí úloh. Ten se zabýval odesíláním e-mailů a SMS, zpracováním událostí, generováním feedů, importem cen a skladů a zpracováním obrázků. Tak se stalo, že byl závislý na lokálním souborovém úložišti a existoval v jediné instanci.
Když vzrostl počet úloh ve frontě zpracovatele (což se přirozeně stalo s růstem počtu objednávek), výkon hostitele, na kterém běžel zpracovatel a úložiště souborů, se stal limitujícím faktorem. V důsledku toho se zastavilo aktualizování sortimentu a cen, odesílání notifikací uživatelům a mnoho dalších kritických funkcí, které uvízly ve frontě. Tým ops rychle migroval úložiště souborů do S3-podobného síťového úložiště, což nám umožnilo nasadit několik výkonných strojů pro škálování zpracovatele pozadí.
Výstup: Pravidlo Stateless je nutné dodržovat pro všechny komponenty bez výjimky, i když se zdá, že 'se tu určitě nezasekneme'. Raději investujte trochu času do správné organizace práce všech systémů, než abyste pak ve spěchu přepisovali kód a opravovali službu, která zažívá přetížení.
7 principů pro intenzivní růst
Navzdory dostupnosti dalších kapacit jsme v průběhu růstu narazili na několik problémů. Počet objednávek se za tuto dobu zvýšil více než čtyřikrát. Nyní už denně doručujeme více než 17 000 objednávek v 62 městech a plánujeme ještě více rozšířit naše geografické pokrytí - v první polovině roku 2020 očekáváme spuštění služby po celé Evropě. Abyste se vyrovnali se rostoucím zatížením, a to i s ohledem na již nabyté zkušenosti, stanovili jsme si 7 základních principů fungování v podmínkách stálého růstu:
- Incident management. Vytvořili jsme desku v Jira, kde je každý incident zaznamenán jako tiket. To pomůže fakticky prioritizovat a vykonávat úkoly související s incidentem. V podstatě není děsivé udělat chybu - děsivé je udělat stejnou chybu dvakrát. Pro případy, kdy se incidenty opakují dříve, než se podaří odstranit příčinu, by měla být připravena instrukce k akci, protože během vysoké zátěže je důležité reagovat bleskově.
- Monitoring je vyžadován pro všechny prvky infrastruktury bez výjimky. Právě díky němu jsme byli schopni předpovědět nárůst zatížení a správně vybrat "úzká místa" pro priorizaci odstranění. Při vysokém zatížení se pravděpodobně rozbije nebo začne zpomalovat všechno, co by vás vůbec nenapadlo. Proto je nejlepší vytvářet nové alarmy hned po prvních incidentech, abychom je monitorovali a předvídali.
- Správné alarmy jsou naprosto nezbytné při rychlém nárůstu zatížení. Za prvé, měly by hlásit, co přesně se rozbilo. Za druhé, alarmů by nemělo být mnoho, protože přemíra nekritických alarmů vede k ignorování všech upozornění obecně.
- Aplikace by měly být stateless. Ujistili jsme se, že pro toto pravidlo by neměly existovat žádné výjimky. Je nutná úplná nezávislost na běhovém prostředí. Pro to můžete uchovávat sdílená data v DB nebo například přímo v S3. Ještě lépe je řídit se pravidly. Během rychlého nárůstu není čas na optimalizaci kódu a s nákladem se musíte vypořádat přímým zvýšením výpočetních zdrojů a horizontálním škálováním.
- Kvóty a výkon externích služeb. Při rychlém nárůstu může problém vzniknout nejen ve vaší infrastruktuře, ale i v externí službě. Nejděsivější je, když k tomu dojde ne kvůli selhání, ale kvůli dosažení kvót nebo limitů. Externí služby by se měly škálovat stejně dobře, jak se škálujete vy sami.
- Dělení procesů a front. To velmi pomáhá, když se na jednom z bran stane zaseknutí. Nebyli bychom čelili zpožděním v přenosu dat, kdyby zaplněné fronty pro odesílání SMS nebránily výměně oznámení mezi informačními systémy. A také by bylo snazší zvýšit počet pracovníků, kdyby pracovali odděleně.
- Finanční realita. Když dochází k explozivnímu nárůstu datových toků, není čas přemýšlet o tarifech a předplatných. Ale je potřeba na ně myslet, zejména pokud jste malá společnost. Vysoký účet může vystavit vlastník jakéhokoli API, stejně jako váš poskytovatel hostingu. Takže je důležité číst smlouvy pečlivě.
Závěr
Nebyli jsme bez ztrát, ale tento fázi jsme překonali a dnes se snažíme držet všech nalezených zásad, přičemž každé zařízení má možnost snadného zvýšení výkonu až 4x, abychom zvládli některé nečekané situace.
V příštích příspěvcích se podělíme o své zkušenosti s vyšetřováním poklesu výkonu v Apache Solr a také se zaměříme na optimalizaci dotazů a na to, jak spolupráce s FNS pomáhá firmě šetřit peníze. Sledujte náš blog, abyste nic nezmeškali, a podělte se v komentářích o vaše podobné nepříjemnosti během růstu provozu.
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Setkali jste se někdy s zpomalením / výpadkem služby při náhlém nárůstu zátěže kvůli:
55,6%Nemožnosti rychle přidat výpočetní zdroje10
16,7%Limitům infrastruktury hostingového poskytovatele3
33,3%Limitům externích API6
27,8%Porušení principů stateless vašich aplikací5
88,9%Neoptimizovanosti kódu vlastních služeb16
Hlasovalo 18 uživatelů. Zdrželo se 6 uživatelů.
Zdroj: habr.com
