

Měli jsme 2 pytle trávy, 75 tablet meskalinu, unixové prostředí, docker repozitář a úkol realizovat příkazy docker pull a docker push bez docker klienta.
UPD:
Otázka: K čemu je to všechno?
Odpověď: Zátěžové testování produktu (NE prostředky bash, skripty jsou uvedeny pro vzdělávací účely). Rozhodli jsme se nepoužívat docker klienta, abychom snížili další vrstvy (v rozumných mezích) a tím pádem emulovali vyšší zátěž. V důsledku toho jsme odstranili všechny systémové prodlevy docker klienta. Získali jsme relativně čistou zátěž přímo na produktu.
V článku byly použity nástroje GNU verzí.
Nejprve se podívejme, co tyto příkazy dělají.
Takže, k čemu se používá docker pull? Podle :
"Pull an image or a repository from a registry."
Tam také nacházíme odkaz na .
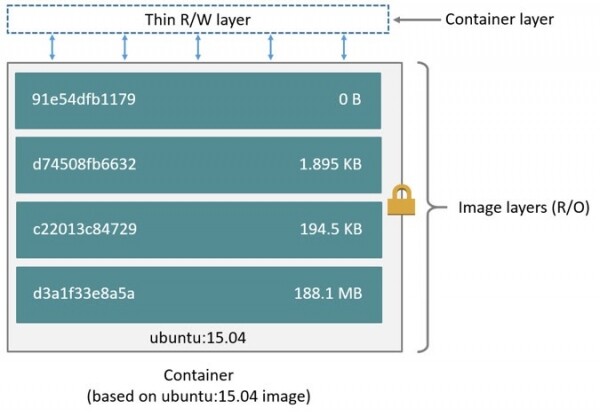
Odtud můžeme pochopit, že docker image je soubor určitých vrstev, které obsahují informace o posledních změnách v obraze, které samozřejmě potřebujeme. Dále se díváme na .
Tady se říká následující:
"An “image” is a combination of a JSON manifest and individual layer files. The process of pulling an > image centers around retrieving these two components."
Prvním krokem podle dokumentace je “Pulling an Image Manifest”.
Stahovat ho samozřejmě nebudeme, ale data z něj potřebujeme. Dále je uveden příklad dotazu: GET /v2/{name}/manifests/{reference}
"The name and reference parameter identify the image and are required. The reference may include a tag or digest."
Náš docker repozitář je rozvinut lokálně, pokusíme se provést dotaz:
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/manifests/1.1.1" -H "header_if_needed"
V odpovědi dostáváme json, z něhož nás v tuto chvíli zajímají pouze vrstvy, přesněji jejich hash. Po jejich získání můžeme pro každý provést následující dotaz: "GET /v2/{name}/blobs/{digest}"
“Access to a layer will be gated by the name of the repository but is identified uniquely in the registry by digest.”
digest v tomto případě a je hash, který jsme získali.
Zkoušíme
curl -s -X GET "http://localhost:8081/link/to/docker/registry/v2/centos-11-10/blobs/sha256:f972d139738dfcd1519fd2461815651336ee25a8b54c358834c50af094bb262f" -H "header_if_needed" --output firstLayer
podíváme se, jaký soubor jsme nakonec získali jako první vrstvu.
file firstLayer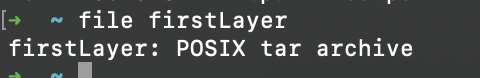
tj. vrstvy představují tar archivy, jejichž rozbalením v odpovídajícím pořadí získáme obsah obrazu.
Napišeme malý bash skript, abychom to všechno mohli automatizovat.
#!/bin/bash -eu

downloadDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
imageName=$3
tag=$4

# array of layers
layers=($(curl -s -X GET "$url/v2/$imageName/manifests/$tag" | grep -oP '(?<=blobSum" : ").+(?=")'))

# download each layer from array
for layer in "${layers[@]}"; do
    echo "Downloading ${layer}"
    curl -v -X GET "$url/v2/$imageName/blobs/$layer" --output "$downloadDir/$layer.tar"
done

# find all layers, untar them and remove source .tar files
cd "$downloadDir" && find . -name "sha256:*" -exec tar xvf {} ;
rm sha256:*.tar
exit 0
Nyní ho můžeme spustit s požadovanými parametry a získat obsah požadovaného image.
./script.sh dirName "http://localhost:8081/link/to/docker/registry" myAwesomeImage 1.0Část 2 – docker push
Tady to bude trochu složitější.
Začněme znovu s . Takže musíme nahrát každou vrstvu, sestavit odpovídající manifest a také ho nahrát. Zní to jednoduše.
Studováním dokumentace můžeme rozdělit proces nahrávání na několik kroků:
- Inicializace procesu – "POST /v2/{repoName}/blobs/uploads/"
- Nahrávání vrstvy (budeme používat monolitické nahrávání, tj. každou vrstvu posíláme celou) – "PUT /v2/{repoName}/blobs/uploads/{uuid}?digest={digest}"
Content-Length: {size of layer}
Content-Type: application/octet-stream
Data binárního formátu vrstvy". - Nahrávání manifestu – "PUT /v2/{repoName}/manifests/{reference}".
Ale v dokumentaci je opomenut jeden krok, bez kterého nic nefunguje. Před monolitickým nahráváním, stejně jako před částečným (chunked), je potřeba provést PATCH požadavek:
"PATCH /v2/{repoName}/blobs/uploads/{uuid}"
Content-Length: {size of chunk}
Content-Type: application/octet-stream
{Layer Chunk Binary Data}".
Jinak se nebudete moci posunout dál než k prvnímu bodu, protože místo očekávaného kódu odpovědi 202 budete dostávat 4xx.
Nyní algoritmus vypadá takto:
- Inicializace
- Patch vrstvy
- Nahrávání vrstvy
- Nahrávání manifestu
Bod 2 a 3 budou následovány tolikrát, kolik vrstev je potřeba nahrát.
Pro začátek potřebujeme jakýkoli image. Použiji archlinux:latest.
docker pull archlinux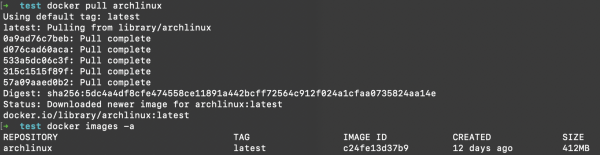
Nyní si ho uložíme lokálně pro další zpracování.
docker save c24fe13d37b9 -o savedArch
Rozbalíme získaný archiv do aktuálního adresáře.
tar xvf savedArch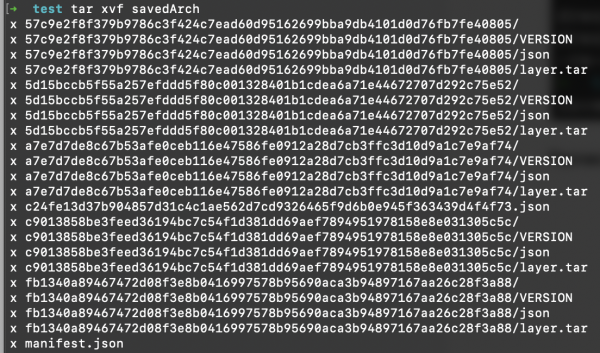
Jak vidíme, každá vrstva je v samostatné složce. Podíváme se nyní na strukturu manifestu, který jsme získali.
cat manifest.json | json_pp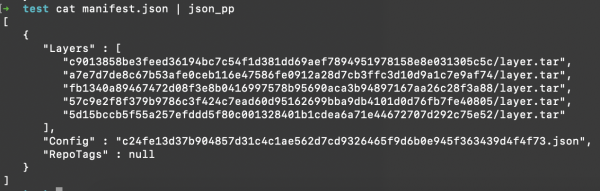
Není toho moc. Podíváme se, jaký manifest je potřeba nahrát, podle .
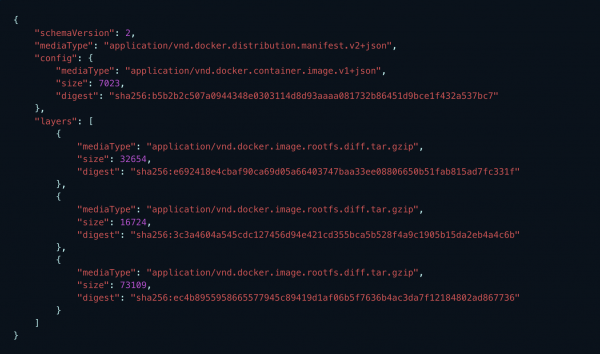
Zřejmé, že stávající manifest nám nevyhovuje, takže si vytvoříme svůj s blackjackem a kurtižankami vrstvami a konfiguracemi.
Vždy budeme mít minimálně jeden konfigurační soubor a pole vrstev. Verze schématu 2 (aktuální k datu napsání článku), mediaType necháme beze změny:
echo ‘{
   "schemaVersion": 2,
   "mediaType": "application/vnd.docker.distribution.manifest.v2+json",
   "config": {
      "mediaType": "application/vnd.docker.container.image.v1+json",
      "size": config_size,
      "digest": "config_hash"
   },
   "layers": [
      ’ > manifest.json
Po vytvoření základního manifestu je potřeba ho naplnit platnými daty. K tomu použijeme šablonu json objektu vrstvy:
{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      },
ten přidáme do manifestu pro každou vrstvu.
Dále musíme zjistit velikost konfiguračního souboru a nahradit zástupné znaky v manifestu skutečnými daty.
sed -i "s/config_size/[1m$configSize[0m/g; s/config_hash/[1m$configName[0m/g" $manifestFileNyní můžeme zahájit proces nahrávání a uložit si uuid, který musí doprovázet všechny následné požadavky.
Celý skript vypadá přibližně takto:
#!/bin/bash -eux

imageDir=$1
# url as http://localhost:8081/link/to/docker/registry
url=$2
repoName=$3
tag=$4
manifestFile=$(readlink -f ${imageDir}/manifestCopy)
configFile=$(readlink -f $(find $imageDir -name "*.json" ! -name "manifest.json"))

# calc layers sha 256 sum, rename them accordingly, and add info about each to manifest file
function prepareLayersForUpload() {
  info_file=$imageDir/info
  # lets calculate layers sha256 and use it as layers names further
  layersNames=($(find $imageDir -name "layer.tar" -exec shasum -a 256 {} ; | cut -d" " -f1))

  # rename layers according to shasums. !!!Set required amount of fields for cut command!!!
  # this part definitely can be done easier but i didn't found another way, sry
  find $imageDir -name "layer.tar" -exec bash -c 'mv {} "$(echo {} | cut -d"/" -f1,2)/$(shasum -a 256 {} | cut -d" " -f1)"' ;

  layersSizes=($(find $imageDir -name "*.tar" -exec ls -l {} ; | awk '{print $5}'))

  for i in "${!layersNames[@]}"; do
    echo "{
         "mediaType": "application/vnd.docker.image.rootfs.diff.tar.gzip",
         "size": ${layersSizes[$i]},
         "digest": "sha256:${layersNames[$i]}"
      }," >> $manifestFile
  done
  # remove last ','
  truncate -s-2 $manifestFile
  # add closing brakets to keep json consistent
  printf "nt]n}" >> $manifestFile
}

# calc config sha 256 sum and add info about it to manifest
function setConfigProps() {
  configSize=$(ls -l $configFile | awk '{print $5}')
  configName=$(basename $configFile | cut -d"." -f1)

  sed -i "s/config_size/$configSize/g; s/config_hash/$configName/g" $manifestFile
}

#prepare manifest file
prepareLayersForUpload
setConfigProps
cat $manifestFile

# initiate upload and get uuid
uuid=$(curl -s -X POST -I "$url/v2/$repoName/blobs/uploads/" | grep -oP "(?<=Docker-Upload-Uuid: ).+")

# patch layers
# in data-binary we're getting absolute path to layer file
for l in "${!layersNames[@]}"; do
  pathToLayer=$(find $imageDir -name ${layersNames[$l]} -exec readlink -f {} ;)
    curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: ${layersSizes[$i]}"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$pathToLayer"

# put layer
  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:${layersNames[$i]}"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: ${layersSizes[$i]}"
  --data-binary "@$pathToLayer"
done

# patch and put config after all layers
curl -v -X PATCH "$url/v2/$repoName/blobs/uploads/$uuid"
  -H "Content-Length: $configSize"
  -H "Content-Type: application/octet-stream"
  --data-binary "@$configFile"

  curl -v -X PUT "$url/v2/$repoName/blobs/uploads/$uuid?digest=sha256:$configName"
  -H 'Content-Type: application/octet-stream'
  -H "Content-Length: $configSize"
  --data-binary "@$configFile"

# put manifest
curl -v -X PUT "$url/v2/$repoName/manifests/$tag"
  -H 'Content-Type: application/vnd.docker.distribution.manifest.v2+json'
  --data-binary "@$manifestFile"

exit 0
můžeme použít hotový skript:
./uploadImage.sh "~\/path\/to\/saved\/image" "http:\/\/localhost:8081\/link\/to\/docker\/registry" myRepoName 1.0UPD:
Co jsme získali jako výsledek?
Za prvé, reálná data pro analýzu, protože testy se spouštějí v blazemeter a data o požadavcích docker klienta jsou velmi neinformativní ve srovnání s čistými HTTP požadavky.
Za druhé, přechod nám umožnil zvýšit počet virtuálních uživatelů pro docker upload asi o 150 % a přitom získat průměrnou dobu odpovědi o 20-25 % rychleji. Pro docker download se podařilo zvýšit počet uživatelů o 500 %, průměrná doba odpovědi se přitom snížila přibližně o 60 %.
Děkuji za pozornost.
Zdroj: habr.com
