

Toto jaro jsme již probrali některá úvodní témata, například, a . V druhém z nich jsme dokonce slíbili pokračovat ve zkoumání výkonu různých vícirdiskových topologií v ZFS. To je souborový systém nové generace, který se nyní zavádí všude: od do .
No co, dnes je ten nejvhodnější den pro seznámení s ZFS, zvídaví čtenáři. Jen vězte, že podle skromného odhadu vývojáře OpenZFS Matta Arense, "to je opravdu složité".
Ale než se dostaneme k číslům – a ta přijdou, slibuji – pro všechny varianty osmnáctiskladové konfigurace ZFS, musíme si promluvit o tom, jak jak ZFS obecně uchovává data na disku.
Zpool, vdev a device
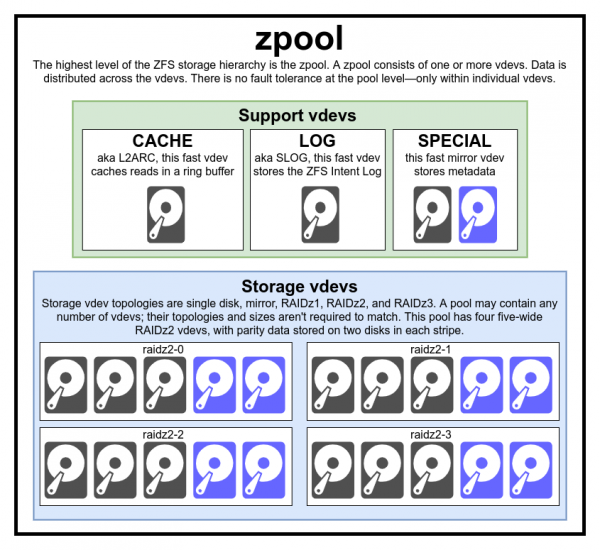
Tento diagram celého poolu zahrnuje tři pomocné vdevy, po jednom z každé třídy, a čtyři pro RAIDz2
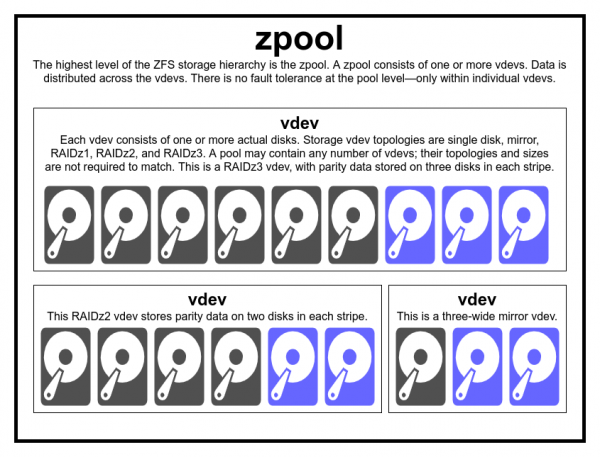
Obvykle není důvod vytvářet pool z nesourodých typů a velikostí vdevu – ale pokud chcete, nic vám v tom nebrání
Abychom skutečně porozuměli souborovému systému ZFS, musíme se podívat na jeho skutečnou strukturu. Za prvé, ZFS kombinuje tradiční úrovně správy svazků a souborového systému. Za druhé, používá transakční mechanismus kopírování při zápisu. Tyto rysy znamenají, že systém je strukturálně velmi odlišný od běžných souborových systémů a RAID polí. První sada základních stavebních bloků pro pochopení: to je pool úložiště (zpool), virtuální zařízení (vdev) a skutečné zařízení (device).
zpool
Pool úložiště zpool – nejvyšší struktura ZFS. Každý pool obsahuje jedno nebo více virtuálních zařízení. Každé z nich zase obsahuje jedno nebo více skutečných zařízení (device). Virtuální pooly jsou samostatné bloky. Jeden fyzický počítač může obsahovat dva nebo více samostatných poolů, ale každý je zcela nezávislý na ostatních. Pooly nemohou společně používat virtuální zařízení.
Redundance ZFS je na úrovni virtuálních zařízení, nikoli na úrovni poolů. Na úrovni poolů není žádná redundance – pokud jakýkoli disk vdev nebo speciální vdev ztratíte, ztratíte i celý pool.
Moderní úložné pooly mohou přežít ztrátu cache nebo žurnálu virtuálního zařízení – ačkoli mohou ztratit malé množství zašpiněných dat, pokud během výpadku energie nebo selhání systému ztratí žurnál vdev.
Existuje rozšířené mylné přesvědčení, že „datové pruhy“ (stripe) ZFS jsou zapisovány přes celý pool. To není pravda. Zpool rozhodně není zábavný RAID0, je to spíše zábavný. se složitým proměnlivým mechanismem rozdělení.
Ve většině případů jsou zápisy rozloženy mezi dostupná virtuální zařízení podle volného prostoru, takže teoreticky budou všechna naplněna současně. V novějších verzích ZFS se bere v úvahu aktuální využití (utilizaci) vdev – pokud je jedno virtuální zařízení výrazně zatíženo více než jiné (například kvůli zátěži na čtení), bude dočasně vynecháno pro zápis, navzdory tomu, že má nejvyšší poměr volného prostoru.
Mechanismus pro určení využití, zabudovaný v moderních metodách rozdělení zápisu ZFS, může snížit latenci a zvýšit propustnost v obdobích neobvykle vysokého zatížení – ale to není blanket na neúmyslné smíšení pomalých HDD a rychlých SSD v jednom poolu. Takový nevyvážený pool bude stále fungovat rychlostí nejpomalejšího zařízení, tedy jako by byl zcela složen z takových zařízení.
vdev
Každý úložný pool se skládá z jednoho nebo více virtuálních zařízení (virtual device, vdev). Každé vdev zase zahrnuje jedno nebo více skutečných zařízení. Většina virtuálních zařízení se používá pro jednoduché ukládání dat, ale existuje několik pomocných tříd vdev, včetně CACHE, LOG a SPECIAL. Každý z těchto typů vdev může mít jednu z pěti topologií: jediné zařízení (single-device), RAIDz1, RAIDz2, RAIDz3 nebo zrcadlo (mirror).
RAIDz1, RAIDz2 a RAIDz3 jsou speciální varianty toho, co by starší generace nazvala RAID s dvojitou (diagonální) paritou. Čísla 1, 2 a 3 označují kolik bloků parity je vyhrazeno pro každý datový pruh. Místo jednotlivých disků pro zabezpečení parity virtuální zařízení RAIDz rozdělují tuto paritu rovnoměrně mezi disky. Pole RAIDz může ztratit tolik disků, kolik má bloků parity; pokud ztratí další, je mimo provoz a vezme s sebou úložiště.
V zrcadlových virtuálních zařízeních (mirror vdev) je každý blok uložen na každém zařízení ve vdev. Ačkoliv jsou nejběžnější dvojité zrcadla (two-wide), v zrcadle může být libovolný počet zařízení — ve velkých instalacích se často používají trojité pro zvýšení výkonnosti čtení a odolnosti proti chybám. Zrcadlo vdev může přežít jakékoli selhání, pokud alespoň jedno zařízení ve vdev stále funguje.
Jednotlivé vdev jsou v podstatě nebezpečné. Takové virtuální zařízení nepřežije žádné selhání — a pokud se používá jako úložiště nebo speciální vdev, jeho selhání povede k zničení celého úložiště. Buďte zde velmi, velmi opatrní.
Virtuální zařízení CACHE, LOG a SPECIAL mohou být vytvořena podle jakékoli z výše uvedených topologií — ale pamatujte, že ztráta virtuálního zařízení SPECIAL znamená ztrátu úložiště, proto se důrazně doporučuje redundantní topologie.
zařízení
To je pravděpodobně nejjednodušší pojem v ZFS — doslovně to znamená blokové zařízení s náhodným přístupem. Pamatujte, že virtuální zařízení se skládají z jednotlivých zařízení a úložiště je vytvořeno z virtuálních zařízení.
Disky — magnetické nebo SSD — jsou nejběžnější bloková zařízení, která se používají jako stavební bloky vdev. Jakékoli zařízení s popisem v /dev je však také vhodné — takže jako jednotlivá zařízení mohou být použity celé hardwarové RAID pole.
Jednoduchý raw soubor je jedním z nejdůležitějších alternativních blokových zařízení, ze kterých může být postaven vdev. Testovací pole z je velmi pohodlný způsob, jak testovat příkazy úložiště a sledovat, kolik místa je k dispozici v úložišti nebo virtuálním zařízení dané topologie.
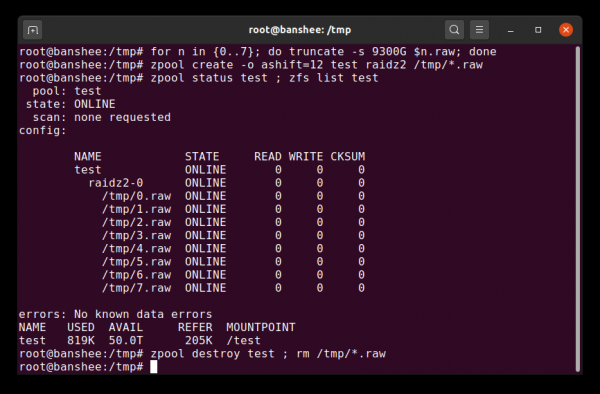
Můžete vytvořit zkušební pool se sparsenými soubory během několika sekund — ale nezapomeňte poté celý pool a jeho komponenty odstranit.
Představte si, že chcete nasadit server na osm disků a plánujete použít disky o velikosti 10 TB (~9300 GiB) — ale nejste si jisti, která topologie nejlépe vyhovuje vašim potřebám. V uvedeném příkladu rychle stavíme zkušební pool ze sparsených souborů — a nyní víme, že RAIDz2 vdev ze šesti disků o 10 TB poskytuje 50 TiB využitelné kapacity.
Další zvláštní třída zařízení je SPARE (náhradní). Hot-swap zařízení se na rozdíl od běžných zařízení připojují k celému poolu, nikoli k jednomu virtuálnímu zařízení. Pokud nějaký vdev v poolu selže a náhradní zařízení je připojeno k poolu a k dispozici, připojí se automaticky k postiženému vdev.
Jakmile se náhradní zařízení připojí k postiženému vdev, začne přijímat kopie nebo rekonstrukce dat, které by měly být na chybějícím zařízení. V tradičním RAID se tomu říká obnovení (rebuilding), a v ZFS se to nazývá "obnova redundantnosti" (resilvering).
Je důležité poznamenat, že náhradní zařízení nenahrazují trvale selhávaná zařízení. Jsou to pouze dočasné náhrady pro zkrácení doby, po kterou je pozorována degradace vdevu. Jakmile správce nahradí selhané zařízení vdevu, dojde k obnovení redundantnosti na tomto trvalém zařízení a SPARE se odpojí od vdevu a vrací se k práci jako náhradní na celý pool.
Sady dat, bloky a sektory
Další sada stavebních bloků, které je třeba pochopit během naší cesty po ZFS, se týká spíše toho, jak jsou organizována a uchovávána samotná data, než hardwaru. Přeskakujeme zde několik úrovní — jako například metaslab — abychom nezaplnili detaily, přičemž zachováváme porozumění celkové struktuře.
Sada dat (dataset)
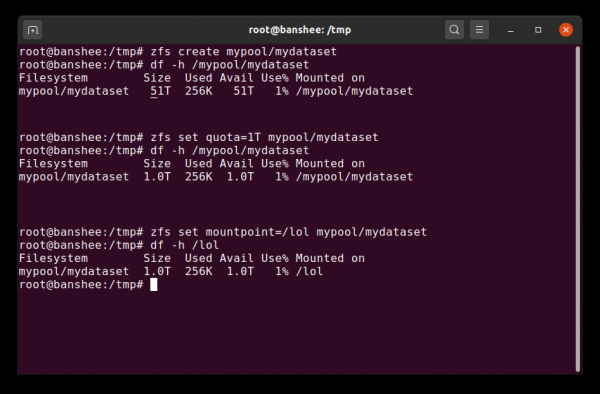
Když poprvé vytvoříme sadu dat, ukáže veškerý dostupný prostor poolu. Pak nastavíme kvótu — a změníme montážní bod. Kouzlo!
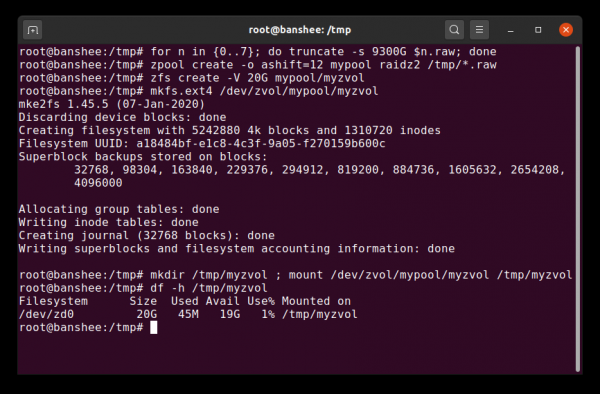
Zvol je většinou pouze sada dat, která nemá svůj vrstvu souborového systému, kterou zde nahrazujeme zcela normálním souborovým systémem ext4.
Sada dat ZFS je přibližně totožná s běžným namontovaným souborovým systémem. Na první pohled se jeví jako „prostě další složka“. Ale stejně jako u běžných montovaných souborových systémů má každý dataset ZFS svou vlastní sadu základních vlastností.
Nejdůležitější je, že dataset může mít přidělenou kvótu. Pokud nastavíte zfs set quota=100G poolname/datasetname, nebudete moci zapsat do namontované složky /poolname/datasetname více než 100 GiB.
Všimli jste si přítomnosti – a absence – lomítek na začátku každého řádku? Každý dataset má své místo jak v hierarchii ZFS, tak v hierarchii systémového montování. V hierarchii ZFS není úvodní lomítko – začínáte názvem poolu a poté postupujete cestou od jednoho datasetu k dalšímu. Například, pool/parent/child pro dataset s názvem child pod rodičovským datovým souborem parent v poolu s kreativním názvem pool.
Ve výchozím nastavení bude bod připojení datasetu odpovídat jeho názvu v hierarchii ZFS, s lomítkem na začátku – pool s názvem pool bude připojen jako /pool, dataset parent je připojen v /pool/parent, a podřízený dataset child je připojen v /pool/parent/child. Můžete však změnit systémový bod připojení datasetu.
Pokud uvedeme zfs set mountpoint=/lol pool/parent/child, dataset pool/parent/child bude připojen v systému jako /lol.
Kromě datasetů musíme zmínit také svazky (zvols). Svazek je přibližně podobný datasetu, s tím rozdílem, že v něm vlastně neexistuje souborový systém – je to prostě blokové zařízení. Například můžete vytvořit zvol s názvem mypool/myzvol, poté ho naformátovat se souborovým systémem ext4 a pak tento souborový systém připojit – nyní máte souborový systém ext4, ale se všemi funkcemi zabezpečení ZFS! To se může zdát hloupé na jednom počítači, ale má to mnohem větší smysl jako backend při exportu iSCSI zařízení.
Bloky
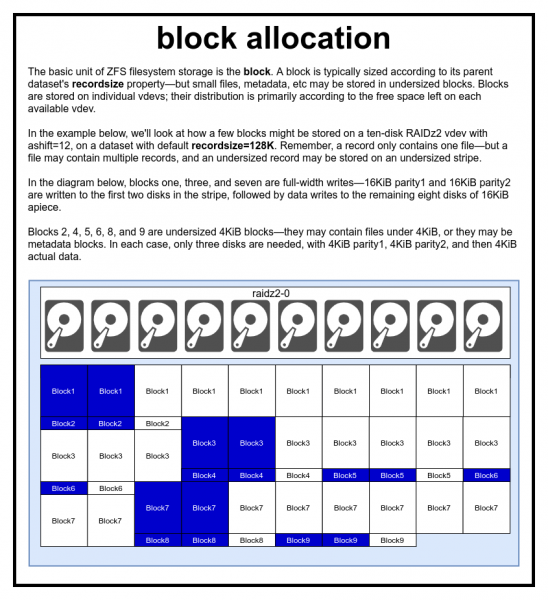
Soubor je reprezentován jedním nebo více bloky. Každý blok je uložen na jednom virtuálním zařízení. Velikost bloku je obvykle rovna parametru recordsize, ale může být snížena na 2^ashift, pokud obsahuje metadata nebo malý soubor.
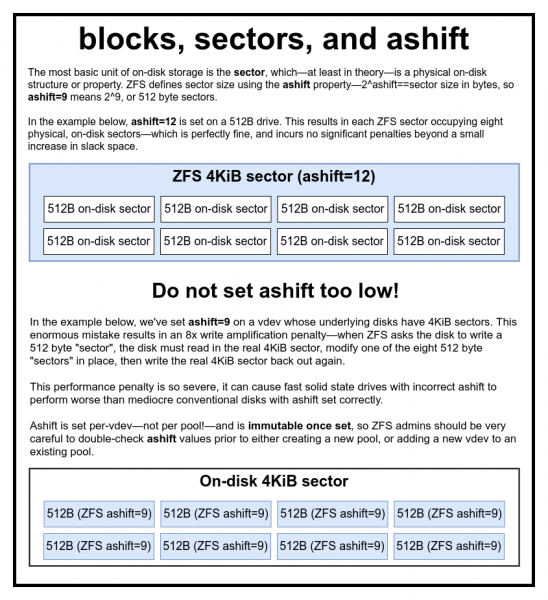
Opravdu, opravdu si s ohromnou ztrátou výkonu neděláme legraci, pokud nastavíte příliš malý ashift.
V ZFS poolu jsou všechna data, včetně metadat, uložena v blocích. Maximální velikost bloku pro každou datovou sadu je určena v vlastnosti recordsize (velikost záznamu). Velikost záznamu lze měnit, ale toto nezmění velikost ani umístění jakýchkoli bloků, které již byly zapsány do datové sady – vztahuje se pouze na nové bloky při jejich zápisu.
Pokud není stanoveno jinak, aktuální velikost záznamu je ve výchozím nastavení nastavena na 128 KiB. Toto je jakýsi složitý kompromis, kde výkon nebude ideální, ale ani hrozný ve většině případů. Velikost záznamu může být nastavena na jakoukoli hodnotu od 4K do 1M (s dodatečnými nastaveními recordsize může být nastavena ještě větší, ale to bývá vzácně dobrý nápad).
Každý blok odkazuje na data pouze jednoho souboru – nemůžete vměstnat dva různé soubory do jednoho bloku. Každý soubor se skládá z jednoho nebo více bloků, v závislosti na velikosti. Pokud je velikost souboru menší než velikost záznamu, bude uložen v bloku menší velikosti – například blok se souborem 2 KiB zabere pouze jeden sektor 4 KiB na disku.
Pokud je soubor dostatečně velký a vyžaduje více bloků, všechny záznamy s tímto souborem budou mít velikost recordsize – včetně posledního záznamu, jehož hlavní část může být .
Objemy zvolu nemají vlastnost recordsize – místo toho mají ekvivalentní vlastnost velikost bloku objemu.
Sektory
Poslední, nejzákladnější stavební blok – sektor. To je nejmenší fyzická jednotka, která může být zapsána nebo přečtena z základního zařízení. Během několika desetiletí byly ve většině disků používány sektory o velikosti 512 bytů. V poslední době většina disků podporuje sektory 4 KiB, a na některých, zejména SSD, sektory 8 KiB nebo dokonce více.
V systému ZFS existuje vlastnost, která umožňuje ručně nastavit velikost sektoru. Tato vlastnost ashift. Je poněkud matoucí, že ashift je mocninou dvojky. Například, ashift=9 znamená velikost sektoru 2^9, nebo 512 bytů.
ZFS dotazuje operační systém na podrobné informace o každém blokovém zařízení při přidání do nového vdev a teoreticky automaticky nastavuje ashift správně na základě těchto informací. Bohužel, mnoho disků lhát o své velikosti sektoru, aby zachovalo kompatibilitu s Windows XP (které nebyly schopny rozpoznat disky s jinými velikostmi sektorů).
To znamená, že administrátor ZFS by měl být důkladně obeznámen s skutečnou velikostí sektoru svých zařízení a manuálně nastavit ashift. Pokud je nastaven příliš malý ashift, astronomicky se zvyšuje počet operací čtení/zápisu. Tak zápis 512-bytových „sektorů“ do skutečného sektoru 4 KiB znamená, že je třeba nejprve zapsat první „sektor“, pak přečíst sektor 4 KiB, změnit ho druhým 512-bytovým „sekretorem“, zapsat ho zpět do nového 4 KiB sektoru a tak dále pro každý zápis.
Ve skutečném světě takový trest dopadá na SSD disky Samsung EVO, pro které by se měl řídit ashift=13, ale tyto SSD lžou o své velikosti sektoru a proto je implicitně nastavena ashift=9. Pokud zkušený systémový administrátor tento parametr nezmění, tento SSD pracuje pomaleji obvyklého magnetického HDD.
Na srovnání, za příliš velkou velikost ashift skoro žádný trest není. Skutečné snížení výkonu neexistuje a nárůst neužitkového prostoru je zanedbatelný (nebo nulový při zapnutém kompresi). Proto důrazně doporučujeme dokonce i těm diskům, které skutečně využívají 512-bytové sektory, nastavit ashift=12 nebo dokonce ashift=13, abyste si mohli s určitostí vystačit do budoucnosti.
Vlastnost ashift se nastavuje pro každé virtuální zařízení vdev, a ne pro pool, jak si mnoho lidí mylně myslí – a nezmění se po nastavení. Pokud omylem nastavíte ashift při přidání nového vdev do poolu, pak jste nevratně znečistili tento pool zařízením s nízkým výkonem a obvykle neexistuje jiná možnost, než pool zničit a začít znovu. Dokonce ani odstranění vdev vás nezachrání od špatného nastavení. ashift!
Mechanismus kopírování při zápisu
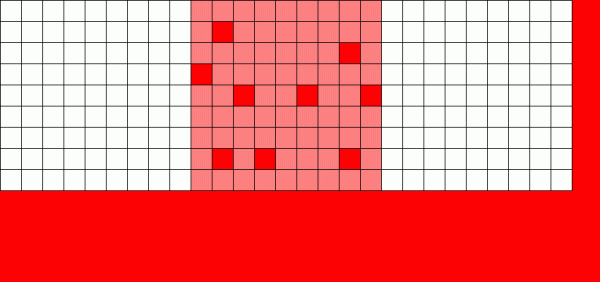
Pokud běžnému souborovému systému potřebuje přepsat data – mění každý blok tam, kde se nachází.
Souborový systém s kopírováním při zápisu ukládá novou verzi bloku a poté uvolňuje starou verzi.
Ve zjednodušené podobě, pokud ignorujeme skutečné fyzické umístění bloků, se naše 'datová kometa' zjednoduší na 'datového červa', který se pohybuje zleva doprava po mapě dostupného prostoru.
Nyní máme dobrou představu, jak fungují snímky kopírování při zápisu — každý blok může patřit několika snímkům a přežije, dokud nebudou zničeny všechny související snímky.
Mechanismus kopírování při zápisu (Copy on Write, CoW) je zásadní základem toho, co dělá ZFS tak úžasným systémem. Základní koncept je jednoduchý — pokud požádáte tradiční souborový systém, aby změnil soubor, udělá to, co jste žádali. Pokud požádáte souborový systém s kopírováním při zápisu, aby udělal totéž, řekne 'dobře' — ale lže vám.
Místo toho souborový systém s kopírováním při zápisu ukládá novou verzi změněného bloku a poté aktualizuje metadata souboru, aby přerušil vazbu se starým blokem a spojil ho s novým blokem, který jste právě zapsali.
Odpojení starého bloku a spojení nového probíhá v jedné operaci, takže ji nelze přerušit — pokud vypnete napájení poté, co to proběhne, máte novou verzi souboru, a pokud vypnete napájení dřív, máte starou verzi. V každém případě se v souborovém systému nevyskytnou konflikty.
Kopírování při zápisu v ZFS probíhá nejen na úrovni souborového systému, ale i na úrovni správy disků. To znamená, že ZFS není náchylná k problému se zápisem () — jevem, kdy se pásma stihla pouze částečně zapsat před selháním systému, což způsobilo poškození pole po restartu. Zde je pásmo zapisováno atomicky, vdev je vždy konzistentní, a .
ZIL: deník záměrů ZFS.
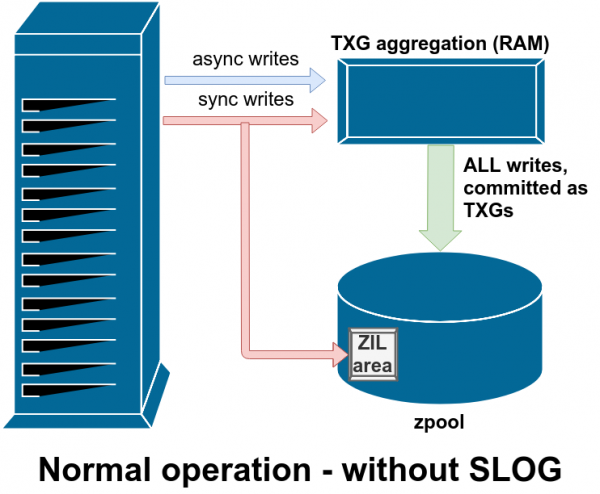
Systém ZFS zpracovává synchronní zápisy zvláštním způsobem — dočasně, ale okamžitě je ukládá do ZIL, než je později trvale zapíše spolu s asynchronními zápisy.
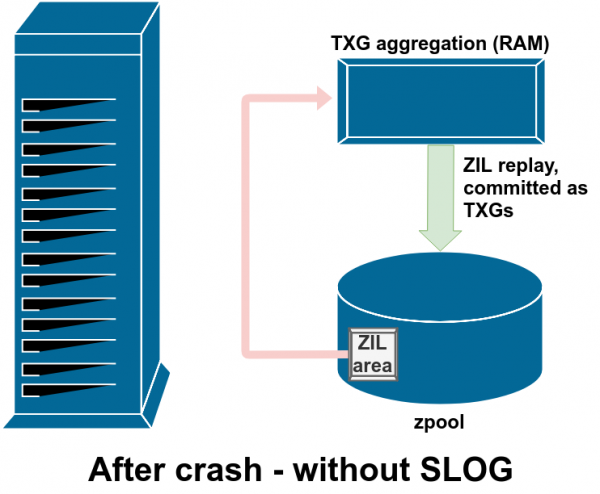
Obvykle se data zapisovaná na ZIL již nikdy nepřečtou. Ale je to možné po selhání systému.
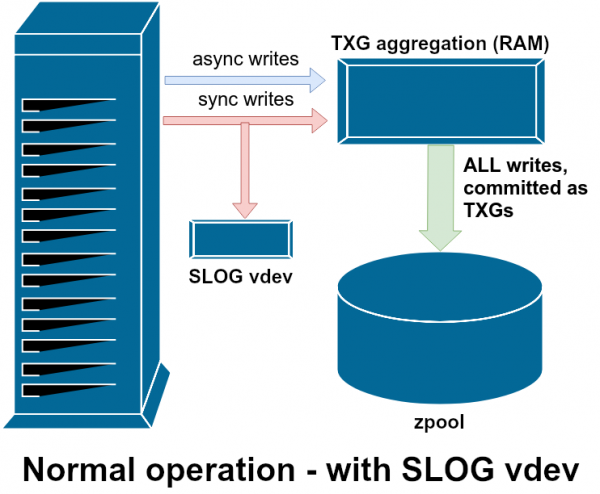
SLOG, nebo sekundární LOG zařízení, je prostě speciální — a ideálně velmi rychlý — vdev, kde může být ZIL uchováván odděleně od hlavního úložiště.
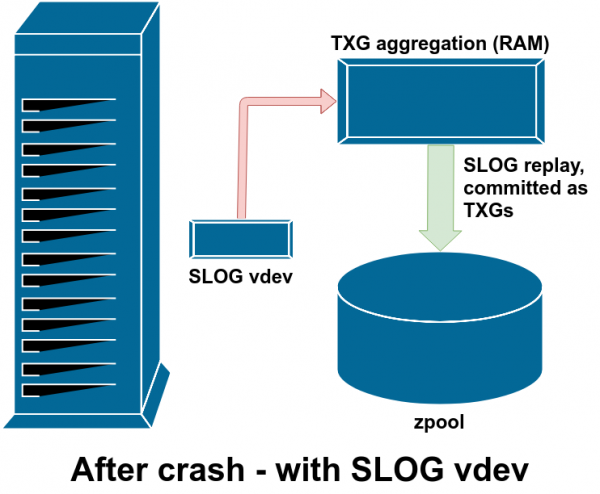
Po havárii jsou všechny neúplné údaje v ZIL obnoveny — v tomto případě je ZIL umístěn na SLOG, takže jsou obnoveny právě odtud.
Existují dvě základní kategorie operací zápisu — synchronní (sync) a asynchronní (async). Pro většinu pracovních zátěží je naprostá většina operací zápisu asynchronní — souborový systém umožňuje jejich agregaci a vydávání v balících, což snižuje fragmentaci a významně zvyšuje propustnost.
Synchronní zápisy jsou zcela jiná věc. Když aplikace požaduje synchronní zápis, říká souborovému systému: „Musíš to uložit do trvalé paměti, hned teď, a do té doby nemohu dělat nic jiného.“ Proto musí být synchronní zápisy okamžitě uloženy na disk — a pokud to zvyšuje fragmentaci nebo snižuje propustnost, tak tomu jednoduše je.
ZFS zpracovává synchronní zápisy jinak než běžné souborové systémy — místo toho, aby je okamžitě naléval do běžného úložiště, ZFS je ukládá do speciální oblasti úložiště, která se nazývá žurnál záměrů ZFS — ZFS Intent Log, nebo ZIL. Finta je v tom, že tyto zápisy také zůstávají v paměti a jsou agregovány spolu s běžnými asynchronními zápisy, aby byly později vyprázdněny do úložiště jako zcela normální TXG (skupiny transakcí, Transaction Groups).
V normálním provozním režimu se ZIL zapisuje a nikdy se znovu nečte. Když jsou za několik okamžiků zápisy z ZIL uloženy do hlavního úložiště v běžných TXG z operační paměti, jsou odpojeny od ZIL. Jediné, kdy je něco čteno z ZIL, je při importu poolu.
Pokud dojde k selhání ZFS — k selhání operačního systému nebo k výpadku napájení — když jsou v ZIL data, budou tato data přečtena při dalším importu poolu (například po restartování havarijního systému). Všechno, co se nachází v ZIL, bude přečteno, sloučeno do skupin TXG, uloženo do hlavního úložiště a poté odpojeno od ZIL během importního procesu.
Jedna z pomocných tříd vdev se nazývá LOG nebo SLOG, sekundární zařízení LOG. Jeho úkolem je poskytnout poolu samostatné a ideálně mnohem rychlejší, s velmi vysokou odolností proti zápisu, zařízení vdev pro uchovávání ZIL, místo uchovávání ZIL na hlavním úložišti vdev. Samotný ZIL se chová stejně bez ohledu na místo ukládání, ale pokud má vdev s LOG velmi vysoký výkon zápisu, budou synchronní zápisy probíhat rychleji.
Přidání vdev s LOG do poolu nijak nemůže zlepšit výkon asynchronního zápisu - i když všechny zápisy do ZIL vynutíte pomocí zfs set sync=always, stále budou vázány na hlavní úložiště v TXG stejným způsobem a stejným tempem, jako bez žurnálu. Jediným přímým zlepšením výkonu je zpoždění synchronního zápisu (protože větší rychlost žurnálu zrychluje provádění operací sync).
Nicméně v prostředí, které již vyžaduje velké množství synchronních zápisů, může vdev LOG nepřímo urychlit asynchronní zápis a nekorelované čtení. Vyložení zápisů ZIL do samostatného vdev LOG znamená menší konkurenci o IOPS v primárním úložišti, což do jisté míry zvyšuje výkon všech operací čtení a zápisu.
Snapshoty
Mechanismus kopírování při zápisu je také nezbytným základem pro atomické okamžité snímky ZFS a inkrementální asynchronní replikaci. V aktivním souborovém systému existuje strom ukazatelů, který označuje všechny zápisy s aktuálními daty - když vytváříte snímek, pouze kopírujete tento strom ukazatelů.
Když se v aktivním souborovém systému přepisuje zápis, ZFS nejprve zapíše novou verzi bloku do nevyužitého prostoru. Poté odpojí starou verzi bloku od aktuálního souborového systému. Ale pokud nějaký snímek odkazuje na starý blok, ten zůstává nezměněn. Starý blok ve skutečnosti nebude obnoven jako volné místo, dokud nebudou zničeny všechny snímky, které na tento blok odkazují!
Replikace
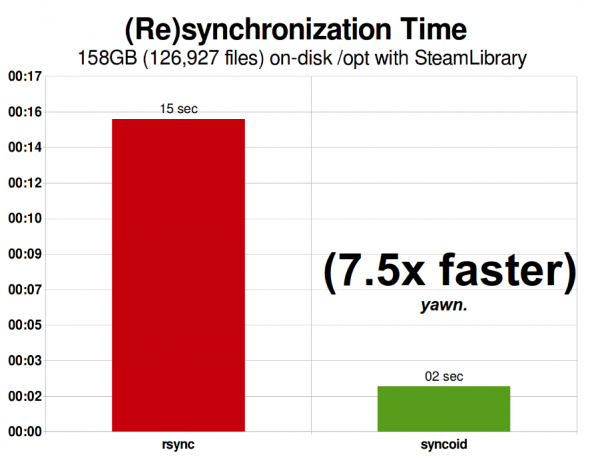
Mé Steam knihovna v roce 2015 zabírala 158 GiB a obsahovala 126 927 souborů. To je poměrně blízko optimální situaci pro rsync - replikace ZFS přes síť byla „pouze“ o 750% rychlejší.
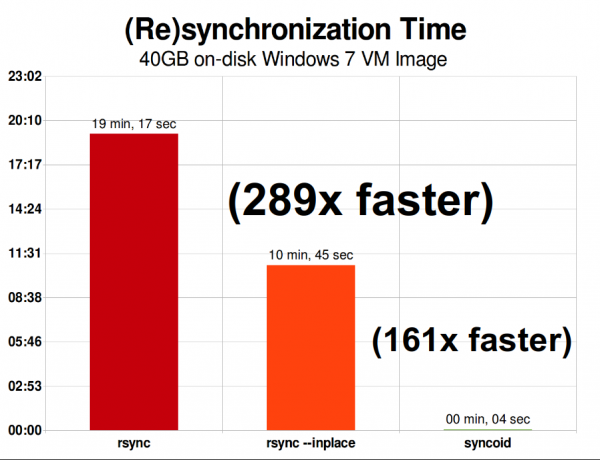
Ve stejné síti je replikace jednoho 40gigabajtového souboru obrazu virtuálního stroje Windows 7 zcela jiný příběh. Replikace ZFS probíhá 289krát rychleji než rsync — nebo „pouze“ 161krát rychleji, pokud jste dostatečně zběhlí, abyste spustili rsync s parametrem —inplace.
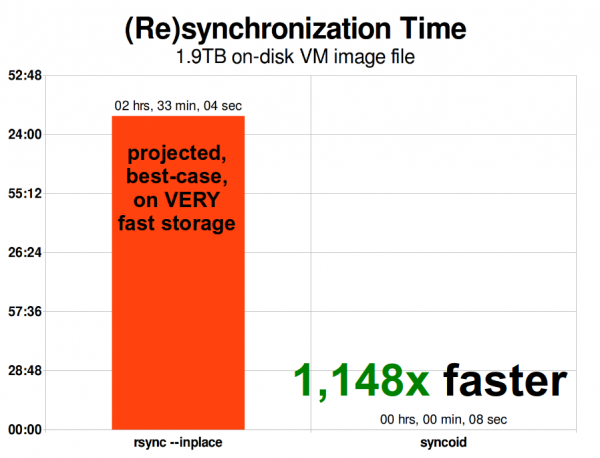
Když se obraz virtuálního stroje škáluje, problémy rsync se škálují společně s ním. Velikost 1,9 TiB není pro současný obraz virtuálního stroje tak velká — ale je dostatečně velká, abychom zjistili, že replikace ZFS je 1148krát rychlejší než rsync, i s argumentem rsync —inplace.
Jakmile pochopíte, jak fungují snímky, nebude obtížné uchopit podstatu replikace. Protože snímek je pouze strom ukazatelů na záznamy, vyplývá z toho, že když děláme zfs send snímku, posíláme jak tento strom, tak všechny související záznamy. Když ho předáváme pomocí zfs send v zfs receive cílovému objektu, zapíše jak skutečný obsah bloku, tak strom ukazatelů, které odkazují na bloky, do cílové datové sady.
Všechno se stává ještě zajímavějším na druhém zfs send. Nyní máme dva systémy, z nichž každý obsahuje poolname/datasetname@1, zatímco vy pořizujete nový snímek poolname/datasetname@2. Proto ve zdrojovém poolu máte datasetname@1 a datasetname@2, zatímco v cílovém poolu má zatím pouze první snímek. datasetname@1.
Protože mezi zdrojem a cílem máme společný snímek datasetname@1, můžeme provést inkrementální zfs send replikaci k němu. Když říkáme systému zfs send -i poolname/datasetname@1 poolname/datasetname@2, porovnává dvě stromy ukazatelů. Jakékoli ukazatele, které existují pouze v @2, odkazují na nové bloky — proto potřebujeme obsah těchto bloků.
V dálkovém systému je zpracování inkrementálního send také stejně jednoduché. Nejprve zapíšeme všechny nové záznamy zahrnuté v toku send, a pak přidáme ukazatele na tyto bloky. Voilà, máme @2 v novém systému!
Asynchronní inkrementální replikace ZFS je obrovské zlepšení oproti dřívějším metodám, které nejsou založeny na snímcích, jako je rsync. V obou případech se přenášejí pouze změněná data — ale rsync musí nejprve přečíst ze diskem všechny údaje z obou stran, abychom zkontrolovali součet a porovnali ho. Na rozdíl od toho replikace ZFS nečte nic jiného než stromy ukazatelů — a jakékoli bloky, které nejsou zastoupeny ve společném snímku.
Vestavěné komprese
Mechanismus kopírování při zápisu také zjednodušuje systém vestavěného komprese. V tradičním souborovém systému je komprese problematická — jak stará verze, tak nová verze změněných dat se nacházejí ve stejném prostoru.
Pokud zvážíme fragment dat uprostřed souboru, který začíná život jako megabajt nul od 0x00000000 a tak dále — velmi snadno se zmenší na jeden sektor na disku. Ale co se stane, když nahradíme tento megabajt nul megabajtem nekomprimovaných dat, jako je JPEG nebo pseudonáhodný šum? Najednou tento megabajt dat vyžaduje ne jeden, ale 256 sektorů po 4 KiB, a na tomto místě disku je rezervován pouze jeden sektor.
U ZFS není tento problém, protože změněné záznamy jsou vždy zapisovány do nevyužitého prostoru — původní blok zabírá pouze jeden sektor 4 KiB, a nová záznam zabere 256, ale to není problém — nedávno změněný fragment z "prostředka" souboru by byl zaznamenán do nevyužitého prostoru bez ohledu na to, zda se jeho velikost změnila nebo ne, takže pro ZFS je to docela běžná situace.
Vestavěné komprese ZFS je ve výchozím nastavení vypnuto, a systém nabízí připojitelné algoritmy — nyní mezi nimi LZ4, gzip (1-9), LZJB a ZLE.
- LZ4 — je to streamovací algoritmus, který nabízí extrémně rychlé komprese a dekomprese a zisk v výkonu pro většinu použití — i na docela pomalých CPU.
- GZIP — vážený algoritmus, který znají a milují všichni uživatelé systémů Unix. Může být realizován s úrovněmi komprese 1-9, s narůstající mírou komprese a využitím CPU, jak se blíží úrovni 9. Algoritmus se dobře hodí pro všechna textová (nebo jiná extrémně komprimovatelná) použití, ale jinak často způsobuje problémy s CPU — používejte ho opatrně, zejména na vyšších úrovních.
- LZJB — původní algoritmus v ZFS. Je zastaralý a již by se neměl používat, LZ4 ho překonává ve všech ohledech.
- ZLE — kódování nula úrovně, Zero Level Encoding. Opravu neovlivňuje normální data, ale komprimuje velké sekvence nul. Je užitečné pro úplně nekomprimovatelné soubory dat (například JPEG, MP4 nebo jiné již komprimované formáty), protože ignoruje nekomprimovatelná data, ale komprimuje nevyužitý prostor v konečných záznamech.
Doporučujeme kompresi LZ4 prakticky pro všechny případy použití; penalizace za výkon při setkání s nekomprimovatelnými daty je velmi malá, a nárůst výkon pro typická data je značný. Kopírování obrazu virtuálního stroje pro novou instalaci operačního systému Windows (čerstvě nainstalovaný OS, žádná data uvnitř ještě nejsou) s compression=lz4 proběhlo o 27 % rychleji než s compression=none, v .
ARC — adaptivní systém náhrady cache
ZFS — je jediné moderní souborový systém, který používá vlastní mechanismus pro čtení cache, a nespoléhá se na stránkovou cache operačního systému pro uchovávání kopií nedávno načtených bloků v paměti RAM.
Ačkoli má vlastní cache své problémy — ZFS nemůže reagovat na nové požadavky na alokaci paměti tak rychle jako jádro, takže nový požadavek malloc() na alokaci paměti může selhat, pokud potřebuje RAM, která je aktuálně obsazena v ARC. Ale existují závažné důvody pro používání vlastní cache, alespoň nyní.
Všechny známé moderní operační systémy, včetně MacOS, Windows, Linux a BSD, používají pro implementaci stránky cache algoritmus LRU (Least Recently Used). Je to primitivní algoritmus, který posunuje cacheovaný blok „nahoru v řadě“ po každém čtení a vytlačuje bloky „dolů v řadě“, jak je potřeba, aby nahral nové cache miss (bloky, které měly být načteny z disku, a ne z cache) nahoru.
Obvykle algoritmus funguje dobře, ale v systémech s velkými pracovními sadami LRU snadno vede k thrashing — vytlačení často potřebných bloků, aby se uvolnilo místo pro bloky, které už nikdy nebudou přečteny z cache.
— mnohem méně naivní algoritmus, který lze považovat za „váženou“ cache. Po každém přečtení vyrovnaného bloku se stává o něco „těžší“ a je obtížnější jej vytěsnit – a dokonce i po vytěsnění. je sledováno po určitém časovém období. Blok, který byl vytěsněn, se však také stane „těžším“, pokud musí být znovu přečten do cache.
Konečným výsledkem všeho je vyrovnaná paměť s mnohem vyšší mírou zásahu (hit ratio) – poměr mezi zásahy do vyrovnání (čtení prováděné z cache) a missy (čtení z disku). To je nesmírně důležitá statistika – nejenže jsou samotné zásahy do cache obsluhovány mnohem rychleji, ale missy cache mohou být také obsluhovány rychleji, protože čím více zásahů do cache – tím méně paralelních požadavků na disk a tím menší zpoždění pro ty zbývající missy, které musí být obsluhovány z disku.
Závěr
Po prostudování základní sémantiky ZFS – jak funguje kopírování při zápisu a také vztahů mezi úložnými pooly, virtuálními zařízeními, bloky, sektory a soubory – jsme připraveni se podívat na skutečný výkon s konkrétními čísly.
V následující části se podíváme na skutečný výkon poolů se zrcadlovými vdev a RAIDz, jeden ve srovnání s druhým, a také ve srovnání s tradičními RAID topologiemi jádra Linux, které jsme prozkoumali. .
Zpočátku jsme chtěli prozkoumat pouze základy – samotné topologie ZFS – ale po takové budeme připraveni mluvit o pokročilém nastavení a ladění ZFS, včetně použití pomocných typů vdev, jako jsou L2ARC, SLOG a Special Allocation.
Zdroj: habr.com
