

SQL, co může být jednodušší? Každý z nás může napsat jednoduchý dotaz – zadáme select, uvedeme potřebné sloupce, pak from, jméno tabulky, trochu podmínek v where a je to – užitečná data máme v kapse, a to (téměř) nezávisle na tom, jaká SŘBD je právě pod kapotou (nebo to možná není ). Výsledkem je, že práci prakticky s jakýmkoliv zdrojem dat (relačním i ne tak docela) lze považovat z pohledu běžného kódu (se všemi důsledky – verze řízení, revize kódu, statická analýza, automatizované testy a to vše). A to se týká nejen samotných dat, schémat a migrací, ale vůbec celé činnosti úložiště. V tomto článku se budeme bavit o každodenních úlohách a problémech práce s různými DB pod zorným úhlem "database as code".
A začneme hned s . První bitvy typu "SQL vs ORM" byly zaznamenány už v .
Objektově-relační mapování
Zastánci ORM tradičně oceňují rychlost a jednoduchost vývoje, nezávislost na SŘBD a čistotu kódu. Pro mnohé z nás kód práce s DB (a často i samotná DB)
většinou vypadá přibližně takto…
@Entity
@Table(name = "stock", catalog = "maindb", uniqueConstraints = {
        @UniqueConstraint(columnNames = "STOCK_NAME"),
        @UniqueConstraint(columnNames = "STOCK_CODE") })
public class Stock implements java.io.Serializable {

    @Id
    @GeneratedValue(strategy = IDENTITY)
    @Column(name = "STOCK_ID", unique = true, nullable = false)
    public Integer getStockId() {
        return this.stockId;
    }
  ...
Model je obohacen chytrými anotacemi, a někde v zákulisí statečné ORM generuje a vykonává tuny nějakého SQL kódu. Mimochodem, vývojáři se snaží za každou cenu oddělit od své DB kilometry abstrakcí, což svědčí o jisté .
Na druhé straně barikády zastánci čistého "handmade"-SQL zdůrazňují možnost vytěžit maximum ze své SŘBD bez dodatečných vrstev a abstrakcí. V důsledku toho vznikají "data-centric" projekty, kde se databází zabývají speciálně vyškolení lidé (také známí jako "databázisté", "bázovíci", "bázodějci" atd.), a vývojáři se už jen "tahají" hotové pohledy a uložené procedury, aniž by se podrobně zabývali detaily.
A co kdybychom vzali to nejlepší z obou světů? Jak je to uděláno ve skvělém nástroji s povzbudivým názvem . Uvedu pár řádků z obecné koncepce ve svém volném překladu, a podrobněji se s ní můžete seznámit .
Clojure je skvělý jazyk pro vytváření DSL, ale SQL už samo o sobě je skvělý DSL a nepotřebujeme další. S-výrazy jsou nádherné, ale tady nic nového nepřidávají. Nakonec dostáváme závorky jen pro závorky. Nesouhlasíte? Pak si počkejte, až se abstrakce nad databází pokazí a vy začnete bojovat s funkcí. (raw-sql)
A co teď? Ponechme SQL jako běžné SQL — jeden soubor na jeden dotaz:
-- name: users-by-country
select *
  from users
 where country_code = :country_code
… a poté si tento soubor přečtěte a převeďte ho na běžnou funkci v Clojure:
(defqueries "some/where/users_by_country.sql"
   {:connection db-spec})

;;; Funkce s názvem `users-by-country` byla vytvořena.
;;; Použijme ji:
(users-by-country {:country_code "GB"})
;=> ({:name "Kris" :country_code "GB" ...} ...)
Dodržováním principu "SQL odděleně, Clojure odděleně" získáte:
- Žádné syntaktické překvapení. Vaše databáze (stejně jako každá jiná) není 100% v souladu se standardem SQL — ale pro Yesql to není důležité. Nikdy nebudete ztrácet čas hledáním funkcí s ekvivalentní syntaxi SQL. Nikdy nebudete muset vrátit se k funkci (raw-sql "some (‘funky’ :: SYNTAX)")).
- Nejlepší podpora editoru. Váš editor již má skvělou podporu SQL. Pokud uchováte SQL jako SQL, můžete ho prostě použít.
- Kompatibilita pro týmy. Vaši DBA mohou číst a psát SQL, které používáte ve svém projektu Clojure.
- Jednodušší nastavení výkonu. Potřebujete vytvořit plán pro problematický dotaz? To není problém, když je váš dotaz běžné SQL.
- Opětovné použití dotazů. Přetáhněte tyto stejné SQL soubory do jiných projektů, protože je to prostě starý dobrý SQL — stačí je sdílet.
Podle mě je myšlenka velmi cool a zároveň velmi jednoduchá, což způsobilo, že projekt získal mnoho v nejrůznějších jazycích. A my se dále pokusíme uplatnit podobnou filozofii oddělování SQL kódu od všeho ostatního daleko za hranice ORM.
IDE & DB manažeři
Začněme jednoduchým každodenním úkolem. Často musíme hledat objekty v databázi, například najít tabulku ve schématu a prozkoumat její strukturu (jaké sloupce, klíče, indexy, omezení a další se používají). A od jakékoliv grafické IDE nebo alespoň průměrného DB manažera čekáme především tyto schopnosti. Aby to bylo rychlé a nemuseli jsme čekat půl hodiny, než se objeví okno s potřebnými informacemi (zejména při pomalém připojení k vzdálené databázi), a přitom aby informace byly čerstvé a aktuální, a ne zastaralé z cache. Čím složitější a větší je databáze a čím více jich je, tím obtížnější toto udělat.
Ale obvykle myš odložím stranou a jednoduše píšu kód. Řekněme, že potřebuji zjistit, které tabulky (a s jakými vlastnostmi) jsou ve schématu "HR". V většině DBMS lze požadovaného výsledku dosáhnout jednoduchým dotazem z information_schema:
select table_name
     , ...
  from information_schema.tables
 where schema = 'HR'
Obsah těchto tabulek referencí se od databáze k databázi liší v závislosti na schopnostech každého DBMS. Například pro MySQL lze z této referenční tabulky získat specifické pro tuto databázi parametry tabulky:
select table_name
     , storage_engine -- Používaný "motor" ("MyISAM", "InnoDB" atd.)
     , row_format     -- Formát řádku ("Fixed", "Dynamic" atd.)
     , ...
  from information_schema.tables
 where schema = 'HR'
Oracle nezná information_schema, ale má , a nastávají tak velké problémy:
select table_name
     , pct_free       -- Minimální volné místo v bloku dat (%)
     , pct_used       -- Minimální používané místo v bloku dat (%)
     , last_analyzed  -- Datum posledního získání statistik
     , ...
  from all_tables
 where owner = 'HR'
Nejste výjimkou ani ClickHouse:
select name
     , engine -- Používaný "motor" ("MergeTree", "Dictionary" atd.)
     , ...
  from system.tables
 where database = 'HR'
Podobné lze udělat i v Cassandra (kde existují columnfamilies místo tabulek a keyspace místo schémat):
select columnfamily_name
     , compaction_strategy_class  -- Strategie pro údržbu dat
     , gc_grace_seconds           -- Doba života nepotřebných dat
     , ...
  from system.schema_columnfamilies
 where keyspace_name = 'HR'
Pro většinu ostatních databází lze vymyslet podobné dotazy (i v Mongo existuje , která obsahuje informace o všech kolekcích v systému).
Samozřejmě, tímto způsobem lze získat informace nejen o tabulkách, ale vlastně o jakémkoliv objektu. Pravidelně lidé sdílejí takový kód pro různé databáze, například v sérii článků na Habr "Funkce pro dokumentaci databází PostgreSQL" (, , ). Samozřejmě, mít v hlavě všechny tyto dotazy a neustále je zadávat není příliš příjemné, proto ve své oblíbené IDE/editoru mám připravenou sadu snippetů pro často používané dotazy, a stačí jen zadávat názvy objektů do šablony.
Výsledkem je, že takový způsob navigace a vyhledávání objektů je mnohem flexibilnější, šetří spoustu času a umožňuje získat přesně ty informace a v tom formátu, jaký je právě potřeba (jak je popsáno v příspěvku ).
Operace s objekty
Po tom, co jsme našli a prozkoumali potřebné objekty, je čas s nimi udělat něco užitečného. Samozřejmě, také bez odtržení prstů od klávesnice.
Není tajemstvím, že jednoduché odstranění tabulky vypadá téměř stejně ve všech databázích:
drop table hr.personsAle s vytvořením tabulky je to už zajímavější. Prakticky každá SŘBD (včetně mnoha NoSQL) umí v nějaké podobě "create table", a jeho hlavní část se bude málo lišit (název, seznam sloupců, typy dat), ale další detaily se mohou výrazně lišit a závisí na vnitřním uspořádání a schopnostech konkrétní SŘBD. Můj oblíbený příklad — v dokumentaci Oracle jsou pouze "holé" BNF pro syntaxi "create table" . Jiná SŘBD mají skromnější možnosti, ale každá z nich také nabízí spoustu zajímavých a jedinečných funkcí pro vytváření tabulek (, , , ). Pravděpodobně žádný grafický "wizard" z nějaké další IDE (zejména univerzální) nebude schopen zcela pokrýt všechny tyto schopnosti, a pokud ano, bude to zážitek nejen pro slabší povahy. Na druhé straně správně a včas napsaný příkaz create table umožní bez potíží využít všechny z nich, učinit ukládání a přístup k vašim datům spolehlivými, optimálními a maximálně pohodlnými.
Také mnoho databázových systémů má své specifické typy objektů, které chybí v jiných databázových systémech. Můžeme provádět operace nejen nad objekty databáze, ale i nad samotným databázovým systémem, například "zabít" proces, uvolnit určitou oblast paměti, zapnout trasování, přepnout do režimu "jen ke čtení" a mnoho dalšího.
A teď si trochu nakreslíme.
Jedním z nejčastějších úkolů je vytvořit diagram s objekty databáze, na krásném obrázku vidět objekty a vazby mezi nimi. To umí prakticky jakákoli grafická IDE, jednotlivé "command line" utility, specializované grafické nástroje a modelovací aplikace. Které vám něco namalují "jak umí", a mírně ovlivnit tento proces lze pouze pomocí několika parametrů v konfiguračním souboru nebo zaškrtávacích políček v rozhraní.
Ale tento problém lze vyřešit mnohem jednodušeji, flexibilněji a elegantněji, a samozřejmě pomocí kódu. Pro vytváření diagramů jakékoli složitosti máme hned několik specializovaných značkovacích jazyků (DOT, GraphML atd.), a k nim celou řadu aplikací (GraphViz, PlantUML, Mermaid), které umí číst takové instrukce a vizualizovat v nejrůznějších formátech. No a informace o objektech a vazbách mezi nimi už víme, jak získat.
Uvedeme malý příklad toho, jak by to mohlo vypadat, s použitím PlantUML a (nalevo SQL dotaz, který vygeneruje potřebnou instrukci pro PlantUML, a napravo výsledek):
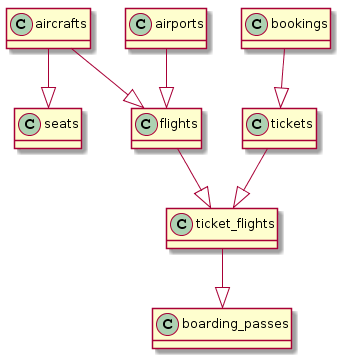
select '@startuml'||chr(10)||'hide methods'||chr(10)||'hide stereotypes' union all
select distinct ccu.table_name || ' --|> ' ||
       tc.table_name as val
  from table_constraints as tc
  join key_column_usage as kcu
    on tc.constraint_name = kcu.constraint_name
  join constraint_column_usage as ccu
    on ccu.constraint_name = tc.constraint_name
 where tc.constraint_type = 'FOREIGN KEY'
   and tc.table_name ~ '.*' union all
select '@enduml'
A pokud se trochu snažíte, můžete na základě získat něco, co se velmi podobá skutečné ER diagramu:
SQL dotaz je o něco složitější.
-- Hlavička
select '@startuml
!define Table(name,desc) class name as "desc" << (T,#FFAAAA) >>
!define primary_key(x) <b>x</b>
!define unique(x) <color:green>x</color>
!define not_null(x) <u>x</u>
hide methods
hide stereotypes'
union all
-- Tabulky
select format('Table(%s, "%s n informace o %s") {'||chr(10), table_name, table_name, table_name) ||
(select string_agg(column_name || ' ' || upper(udt_name), chr(10))
from information_schema.columns
where table_schema = 'public'
and table_name = t.table_name) || chr(10) || '}'
from information_schema.tables t
where table_schema = 'public'
union all
-- Vazby mezi tabulkami
select distinct ccu.table_name || ' "1" --> "0..N" ' || tc.table_name || format(' : "A %s může mít mnoho %s"', ccu.table_name, tc.table_name)
from information_schema.table_constraints as tc
join information_schema.key_column_usage as kcu on tc.constraint_name = kcu.constraint_name
join information_schema.constraint_column_usage as ccu on ccu.constraint_name = tc.constraint_name
where tc.constraint_type = 'FOREIGN KEY'
and ccu.constraint_schema = 'public'
and tc.table_name ~ '.*'
union all
-- Zápatí
select '@enduml' 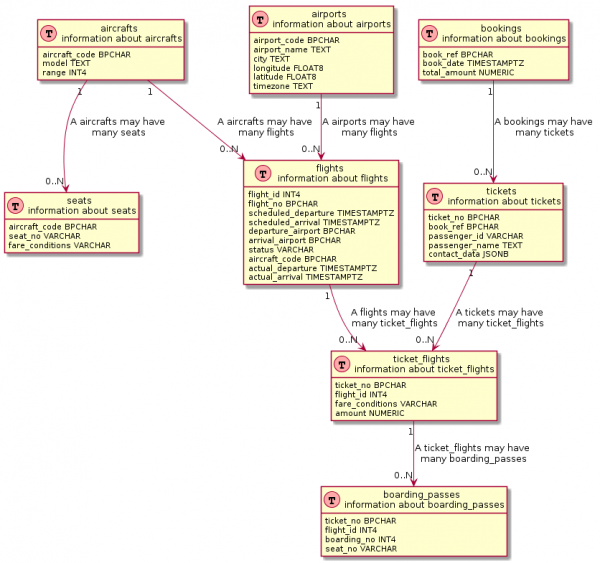
Pokud se pečlivě podíváte, mnoho vizualizačních nástrojů pod kapotou používá podobné dotazy. Pravda, tyto dotazy jsou obvykle hluboko , nemluvě o jejich jakékoliv modifikaci.
Metрики a monitorování.
Přejdeme k tradičně složitému tématu - monitoring výkonu databáze. Vzpomenu si na malou pravdivou story, kterou mi vyprávěl "jeden můj přítel". Na dalším projektu žil a byl mocný DBA, a málokdo z vývojářů ho znalo osobně, ba dokonce ho kdy vidělo (i když údajně pracoval někde v sousední budově). V hodině "X", kdy produkční systém velkého maloobchodníka opět začínal "špatně se cítit", tiše posílal screenshoty grafů z Oracle Enterprise Manageru, na kterých pečlivě zvýrazňoval kritická místa červeným markerem pro "přehlednost" (což, mírně řečeno, málo pomáhalo). A takto bylo nutné léčit podle této "fotografie". Přitom přístup ke vzácnému (v obou významech tohoto slova) Enterprise Manageru nikdo neměl, protože systém je složitý a drahý, aby "vývojáři náhodou na něco nenarazili a všechno nezlomili". Vývojáři tedy "empiricky" hledali místo a příčinu zpomalení a vydávali opravy. Pokud hrozivý dopis od DBA nepřicházel znovu v blízké době, všichni si s úlevou vydechli a vrátili se k svým aktuálním úkolům (až do nového dopisu).
Ale proces monitoringu může vypadat mnohem veselěji a přívětivěji, a hlavně - přístupně a průhledně pro všechny. Alespoň základní část, jako doplněk k hlavním monitorovacím systémům (které jsou bezesporu užitečné a v mnoha případech nenahraditelné). Jakákoli SDB je ochotna bezplatně sdílet informace o svém aktuálním stavu a výkonu. Ve stejné "krvavé" Oracle DB prakticky jakékoli informace o výkonu lze získat ze systémových pohledů, počínaje procesy a relacemi a konče stavem buffer cache (například, , sekce "Monitoring"). V PostgreSQL je také celá řada systémových pohledů pro , zejména takové, které jsou neocenitelné v každodenním životě každého DBA, jakými jsou , , . V MySQL k tomu byla určena dokonce samostatná schéma . A v Mongo je zabudovaný , který agreguje data o výkonu do systémové kolekce .
Takže, ozbrojeni nějakým sběračem metrik (Telegraf, Metricbeat, Collectd), který umí provádět vlastní sql dotazy, úložištěm těchto metrik (InfluxDB, Elasticsearch, Timescaledb) a vizualizátorem (Grafana, Kibana), lze získat dostatečně jednoduchý a flexibilní monitorovací systém, který bude úzce integrován s dalšími systémovými metrikami (získanými například ze serveru aplikací, z OS atd.). Jak je to například uděláno v pgwatch2, kde se používá spojení InfluxDB + Grafana a soubor dotazů na systémové pohledy, ke kterým lze také .
Celkem
A to je jen přibližný seznam toho, co lze s naší DB pomocí běžného SQL kódu udělat. Jsem si jistý, že lze najít ještě spoustu využití, napište v komentářích. A o tom, jak (a co je nejdůležitější, proč) to všechno automatizovat a zahrnout do svého CI/CD pipeline, si promluvíme příště.
Zdroj: habr.com
